

En poursuivant le sujet de l'enregistrement de grands flux de données, soulevé , examinons les moyens de réduire la taille « physique » des données stockées dans PostgreSQL, et leur impact sur les performances du serveur.
Il sera question de réglages TOAST et d'alignement des données. En moyenne, ces méthodes permettront d'économiser relativement peu de ressources, mais — sans aucune modification du code de l'application.
Cependant, notre expérience s'est révélée assez productive à cet égard, car le stockage de pratiquement toute surveillance est par nature principalement en mode ajout en ce qui concerne les données enregistrées. Et si vous vous demandez comment enseigner à la base à écrire sur le disque à la place de 200MB/s deux fois moins — je vous invite à lire la suite.
Petits secrets des grandes données
En raison du profil de travail , il reçoit régulièrement des paquets de texte en provenance des journaux des paquets de texte.
Et comme , dont nous surveillons les bases de données, est un produit multifonctionnel avec des structures de données complexes, les requêtes visent à obtenir des performances maximales sont donc tout à fait Ainsi, le volume de chaque requête distincte ou du plan d'exécution résultant dans le journal que nous recevons se révèle « en moyenne » assez important.
Voyons la structure d'une des tables dans lesquelles nous écrivons des données « brutes » — c'est-à-dire le texte original des entrées du journal :
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- clé de section
    date
, data -- le plus important
    text
, PRIMARY KEY(pack, recno)
);
C'est un tableau typique (déjà partitionné, bien sûr, c'est donc un modèle de section), où le plus important est le texte. Parfois, il est assez volumineux.
Rappelons que la taille « physique » d'un enregistrement dans PG ne peut pas dépasser une page de données, mais la taille « logique » est une affaire totalement différente. Pour enregistrer une valeur volumineuse (varchar/text/bytea) dans un champ, on utilise :
PostgreSQL utilise une taille de page fixe (généralement 8 Ko) et n'autorise pas les tuples à occuper plusieurs pages. Il est donc impossible de stocker directement des valeurs de champ très volumineuses. Pour contourner cette limitation, les grandes valeurs de champ sont compressées et/ou divisées en plusieurs lignes physiques. Cela se produit de manière transparente pour l'utilisateur et a peu d'impact sur la majeure partie du code du serveur. Cette méthode est connue sous le nom de TOAST …
En réalité, pour chaque table avec des champs « potentiellement grands », une créée pour « découper »
chaque enregistrement « important » en segments de 2 Ko : TOAST( chunk_id integer , chunk_seq integer , chunk_data bytea , PRIMARY KEY(chunk_id, chunk_seq) ); dataAutrement dit, si nous devons enregistrer une ligne avec une valeur « importante » , alors l'enregistrement réel se fera.
non seulement dans la table principale et son PK, mais aussi dans TOAST et son PK
Réduire l'impact de TOAST Mais la plupart des enregistrements ne sont pas si grands, ils devraient tenir dans 8 Ko.
— comment économiser là-dessus ? STORAGE
- de la colonne de la table nous vient en aide : EXTENDED permet à la fois la compression et le stockage séparé. C'est la variante standard
- pour la plupart des types de données compatibles avec TOAST. Une tentative de compression est d'abord réalisée, puis le stockage en dehors de la table est effectué si la ligne est toujours trop grande. MAIN permet la compression, mais pas le stockage séparé. (En réalité, le stockage séparé sera toutefois effectué pour de telles colonnes, mais uniquementen dernier recours
, lorsque d'autres méthodes ne peuvent pas réduire la ligne pour qu'elle tienne dans la page.) En fait, c'est exactement ce dont nous avons besoin pour le texte —comprimer au maximum, et si cela ne fonctionne vraiment pas — le faire sortir dans TOAST.
Cela peut être fait directement « à la volée », en une seule commande :ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;
Comment évaluer l'effet Étant donné que le flux de données change chaque jour, nous ne pouvons pas comparer des chiffres absolus, mais en termes relatifs, moins nous enregistrons dans TOAST — mieux c'est. Mais il y a un danger — plus notre volume « physique » de chaque enregistrement individuel est important, plus l'index devient « large », car il faut couvrir un plus grand nombre de pages de données.
Section avant les modifications:
heap  = 37 Go (39%)
TOAST = 54 Go (57%)
PK    =  4 Go ( 4%)
Section après les modifications:
heap  = 37 Go (67%)
TOAST = 16 Go (29%)
PK    =  2 Go ( 4%)
En fait, nous nous écrivons dans TOAST deux fois moins souvent, ce qui a libéré non seulement le disque, mais aussi le CPU :
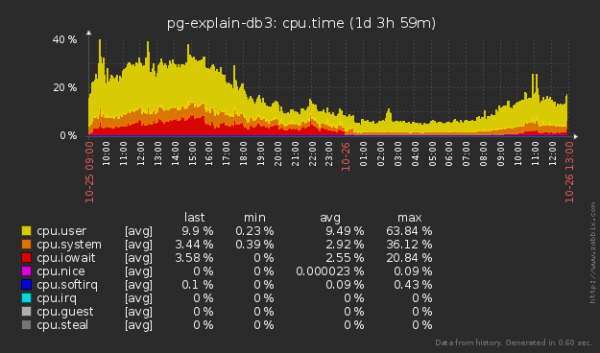
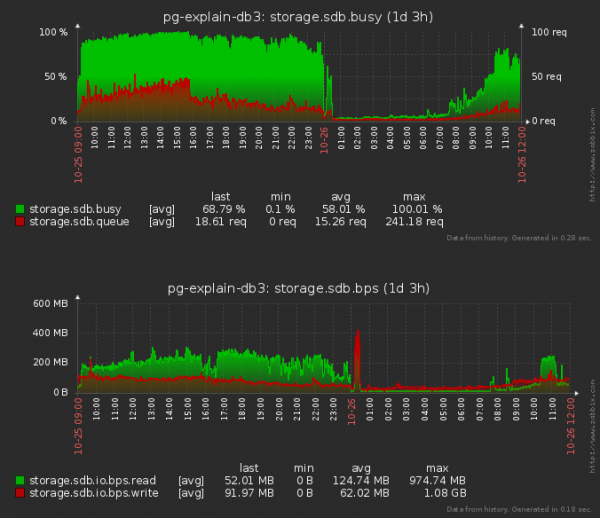
Je remarque que nous avons également commencé à « lire » le disque moins souvent, pas seulement à « écrire » — car lors de l'insertion d'un enregistrement dans une table, il faut aussi « lire » une partie de l'arbre de chaque index pour déterminer sa future position.
À qui fait bon vivre sur PostgreSQL 11
Après la mise à jour vers PG11, nous avons décidé de continuer le « tuning » de TOAST et avons remarqué qu'à partir de cette version, un paramètre est devenu configurable :
Le code de traitement de TOAST ne s'active que lorsque la taille de la chaîne, qui doit être stockée dans la table, dépasse TOAST_TUPLE_THRESHOLD octets (généralement 2 Ko). Le code TOAST va compresser et/ou déplacer les valeurs de champ en dehors de la table jusqu'à ce que la taille de la chaîne devienne inférieure à TOAST_TUPLE_TARGET octets (variable, généralement également 2 Ko) ou que le volume ne puisse pas être réduit.
Nous avons décidé que nos données étaient généralement soit « très courtes », soit immédiatement « très longues », donc nous avons décidé de nous limiter à la valeur minimale possible :
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Voyons comment les nouveaux paramètres ont affecté la charge du disque après la reconfiguration :
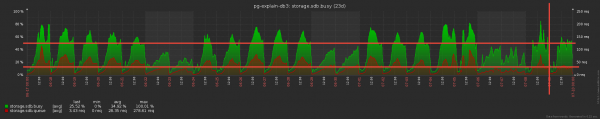
Pas mal ! La moyenne de la file d'attente du disque a diminué d'environ 1,5 fois, et le « taux d'occupation » du disque — de 20 % ! Mais cela a-t-il eu un impact sur le CPU ?
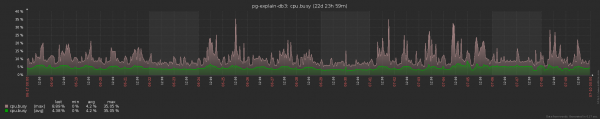
Du moins, cela n'a pas empiré. Cependant, il est difficile d'en juger, car même ces volumes ne peuvent pas augmenter la moyenne de charge CPU au-delà 5%.
Changer l'ordre des termes dans une somme… change le résultat !
Comme on le sait, chaque sou est un rouble économisé, et avec nos volumes de stockage d'environ 10 To/mois , même une petite optimisation peut apporter un bon profit. Ainsi, nous avons prêté attention à la structure physique de nos données — comment précisément les champs sont « placés » à l'intérieur de l'enregistrement de chaque table.
Parce qu'à cause de cela affecte directement :
De nombreuses architectures prévoient un alignement des données sur les frontières des mots machine. Par exemple, sur un système x86 32 bits, les entiers (type entier, occupant 4 octets) seront alignés sur la frontière des mots de 4 octets, tout comme les nombres à virgule flottante double précision (type double precision, 8 octets). Et sur un système 64 bits, les valeurs double seront alignées sur la frontière des mots de 8 octets. C'est encore une autre raison d'incompatibilité.
En raison de l'alignement, la taille de la ligne de la table dépend de l'ordre des champs. En général, cet effet n'est pas très perceptible, mais dans certains cas, il peut entraîner une augmentation significative de la taille. Par exemple, si l'on mélange des champs de types char(1) et integer, il y aura généralement 3 octets perdus entre eux.
Commençons par des modèles synthétiques :
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 octets

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 octets
D'où proviennent les quelques octets supplémentaires dans le premier cas ? C'est simple : un smallint de 2 octets est aligné sur une frontière de 4 octets avant le champ suivant, et quand il se trouve en dernier, il n'y a rien à aligner et pas besoin de le faire.
En théorie, tout est bon et l'on peut déplacer les champs autant que l'on veut. Vérifions avec des données réelles à partir de l'un des tableaux, dont la section journalière occupe entre 10 et 15 Go.
Structure d'origine :
CREATE TABLE public.plan_20190220
(
-- Hérité de la table plan :  pack uuid NOT NULL,
-- Hérité de la table plan :  recno smallint NOT NULL,
-- Hérité de la table plan :  host uuid,
-- Hérité de la table plan :  ts timestamp with time zone,
-- Hérité de la table plan :  exectime numeric(32,3),
-- Hérité de la table plan :  duration numeric(32,3),
-- Hérité de la table plan :  bufint bigint,
-- Hérité de la table plan :  bufmem bigint,
-- Hérité de la table plan :  bufdsk bigint,
-- Hérité de la table plan :  apn uuid,
-- Hérité de la table plan :  ptr uuid,
-- Hérité de la table plan :  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
La section après changement d'ordre des colonnes — exactement les mêmes champs, juste l'ordre est différent:
CREATE TABLE public.plan_20190221
(
-- Hérité de la table plan :  dt date NOT NULL,
-- Hérité de la table plan :  ts timestamp with time zone,
-- Hérité de la table plan :  pack uuid NOT NULL,
-- Hérité de la table plan :  recno smallint NOT NULL,
-- Hérité de la table plan :  host uuid,
-- Hérité de la table plan :  apn uuid,
-- Hérité de la table plan :  ptr uuid,
-- Hérité de la table plan :  bufint bigint,
-- Hérité de la table plan :  bufmem bigint,
-- Hérité de la table plan :  bufdsk bigint,
-- Hérité de la table plan :  exectime numeric(32,3),
-- Hérité de la table plan :  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Le volume total de la section est déterminé par le nombre de «faits» et dépend uniquement des processus externes, donc divisons la taille de l'espace heap (pg_relation_size) sur le nombre d'enregistrements qu'il contient — nous obtiendrons la taille moyenne de l'enregistrement stocké:
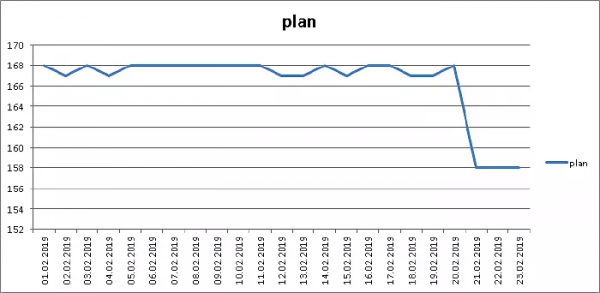
moins 6 % du volume, excellent !
Mais tout n'est pas aussi rose, car nous ne pouvons pas changer l'ordre des champs dans les index, c'est pourquoi « en général » (pg_total_relation_size)…
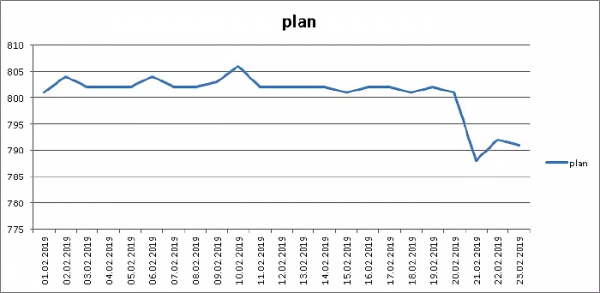
… en fait, même ici nous avons économisé 1,5 %, sans changer une seule ligne de code. C'est vrai !
Je remarque que la configuration des champs mentionnée ci-dessus n'est pas nécessairement la plus optimale. Car certains blocs de champs ne doivent pas être « déchirés » pour des raisons esthétiques — par exemple, une paire (pack, recno), qui est la clé primaire pour cette table.
Dans l'ensemble, définir une « disposition minimale » des champs est une tâche relativement simple de « recherche » . Donc, vous pourriez obtenir de meilleurs résultats avec vos propres données que nous — essayez !
Source : habr.com
