

S'inspirant de mes interventions lors de Highload++ et DataFest Minsk 2019.
Pour beaucoup aujourd'hui, le courrier électronique est une partie intégrante de la vie en ligne. Grâce à lui, nous menons des correspondances professionnelles, stockons diverses informations importantes liées aux finances, aux réservations d'hôtels, aux commandes et bien plus encore. Au milieu de l'année 2018, nous avons formulé une stratégie produit pour le développement du courrier électronique. À quoi devrait ressembler le courrier électronique moderne ?
Le courrier électronique doit être intelligent, c'est-à-dire aider les utilisateurs à naviguer dans le volume croissant d'informations : filtrer, structurer et fournir celles-ci de la manière la plus conviviale possible. Il doit être utile, permettant de résoudre diverses tâches directement dans la boîte mail, par exemple, payer des amendes (une fonctionnalité que je, regrettablement, utilise). Et bien sûr, le courrier électronique doit garantir la protection des informations, filtrant le spam et protégeant contre les piratages, c'est-à-dire être sécurisé.
Ces orientations déterminent un certain nombre de tâches clés, dont beaucoup peuvent être efficacement résolues par l'apprentissage automatique. Voici des exemples de fonctionnalités déjà en place, développées dans le cadre de la stratégie - une pour chaque orientation.
- Réponse intelligente. Le courrier électronique dispose d'une fonction de réponse intelligente. Le réseau neuronal analyse le texte du message, comprend son sens et son objectif, et propose ainsi trois réponses les plus appropriées : positive, négative et neutre. Cela permet de gagner beaucoup de temps pour répondre aux e-mails, tout en étant souvent créatif et amusant dans les réponses.
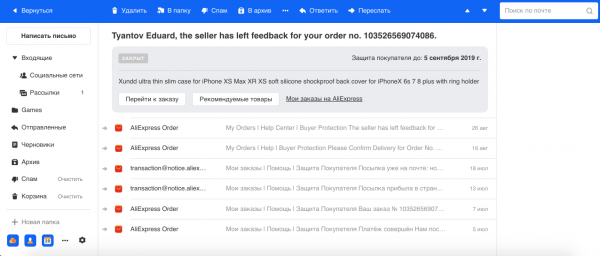
- Regroupement d'e-mails, liés aux commandes dans les boutiques en ligne. Nous effectuons souvent des achats en ligne, et en général, les magasins peuvent envoyer plusieurs e-mails pour chaque commande. Par exemple, AliExpress, le plus grand service, envoie beaucoup d'e-mails pour une seule commande, et nous avons constaté qu'en situation terminale, leur nombre peut atteindre jusqu'à 29. C'est pourquoi, grâce à un modèle de reconnaissance d'entités nommées, nous extrayons le numéro de commande et d'autres informations à partir du texte et regroupons tous les e-mails dans une seule conversation. Nous affichons également les informations principales sur la commande dans un encadré séparé, ce qui facilite la gestion de ce type d'e-mails.

- Anti-phishing. Le phishing est un type de fraude particulièrement dangereux, par lequel des malfaiteurs tentent de s'emparer d'informations financières (y compris des données de cartes bancaires des utilisateurs) et de leurs identifiants. Ces courriers imitent les véritables messages envoyés par des services, y compris visuellement. Grâce à la vision par ordinateur, nous reconnaissons les logos et le style des courriers des grandes entreprises (comme Mail.ru, Sber, Alfa) et prenons cela en compte avec le texte et d'autres signes dans nos classificateurs de spam et de phishing.
Apprentissage automatique
Un peu sur l'apprentissage automatique dans les courriers en général. Les courriers sont un système à forte charge : en moyenne, environ 1,5 milliard de messages transitent par nos serveurs chaque jour pour 30 millions d'utilisateurs actifs quotidiens. Environ 30 systèmes d'apprentissage automatique gèrent toutes les fonctions et fonctionnalités nécessaires.
Chaque message passe par un véritable processus de classification. D'abord, nous filtrons le spam et conservons les bons messages. Les utilisateurs ne remarquent souvent pas le fonctionnement de l'anti-spam, car 95 à 99 % du spam ne parvient même pas dans le dossier approprié. La détection du spam est une partie très importante de notre système, et la plus complexe, car dans le domaine de l'anti-spam, il y a une adaptation constante entre les systèmes de protection et d'attaque, ce qui présente un défi technique continu pour notre équipe.
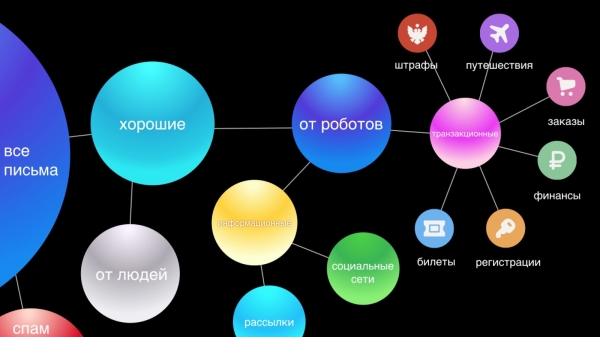
Ensuite, nous séparons les courriers des humains et des robots. Les courriers des humains sont les plus importants, c'est pourquoi nous leur proposons des fonctionnalités telles que la réponse intelligente. Les courriers des robots se divisent en deux catégories : transactionnels — ce sont des messages importants de services, par exemple, des confirmations d'achats ou de réservations d'hôtel, des finances, et informatifs — ce sont des publicités commerciales, des réductions.
Nous pensons que les courriers transactionnels sont aussi importants que les correspondances personnelles. Ils doivent être facilement accessibles, car il est souvent nécessaire de retrouver rapidement des informations sur une commande ou une réservation de vol, et nous perdons du temps à chercher ces messages. C'est pourquoi, pour plus de commodité, nous les classons automatiquement en six catégories principales : voyages, commandes, finances, billets, inscriptions et, enfin, amendes.
Les courriers d'information représentent le groupe le plus nombreux et probablement le moins important, n'exigeant pas de réaction immédiate, car rien de substantiel ne changera dans la vie de l'utilisateur s'il ne lit pas un tel message. Dans notre nouvelle interface, nous les regroupons en deux fils : les réseaux sociaux et les newsletters, nettoyant visuellement la boîte de réception et n'affichant que les courriers importants.
Exploitation
Un grand nombre de systèmes entraîne de nombreuses difficultés d'exploitation. En effet, les modèles se dégradent avec le temps, tout comme tout logiciel : les fonctionnalités échouent, les machines tombent en panne, et du code défectueux s'accumule. De plus, les données évoluent constamment : de nouvelles données sont ajoutées, le comportement des utilisateurs se transforme, etc. C'est pourquoi un modèle sans le soutien approprié fonctionnera de moins en moins bien avec le temps.
Il ne faut pas non plus oublier que plus l'apprentissage automatique pénètre dans la vie des utilisateurs, plus ces derniers influencent l'écosystème, et par conséquent, plus les pertes financières ou les bénéfices peuvent être importants pour les acteurs du marché. Ainsi, de plus en plus de secteurs s'adaptent au fonctionnement des algorithmes de ML (des exemples classiques incluent la publicité, la recherche et le filtrage anti-spam déjà mentionné).
Les tâches liées à l'apprentissage automatique ont également une particularité : même un changement minime dans le système peut entraîner beaucoup de travail sur le modèle : manipulation des données, réentraînement, déploiement, ce qui peut prendre des semaines ou des mois. Donc, plus l'environnement dans lequel vos modèles opèrent change rapidement, plus leur support nécessite d'efforts. L'équipe peut créer de nombreux systèmes et s'en réjouir, puis dépenser presque toutes ses ressources pour les soutenir, sans possibilité de créer quelque chose de nouveau. Une fois, nous avons fait face à une telle situation dans l'équipe anti-spam. Et nous en sommes venus à la conclusion évidente que l'accompagnement doit être automatisé.
Automatisation
Que peut-on automatiser ? En réalité, presque tout. J'ai identifié quatre domaines définissant l'infrastructure de l'apprentissage automatique :
- collecte de données ;
- réentraînement ;
- déploiement ;
- test & monitoring.
Si l'environnement est instable et en constante évolution, alors toute l'infrastructure autour du modèle devient bien plus importante que le modèle lui-même. Cela peut être un ancien et bon vieux classificateur linéaire, mais si les caractéristiques sont correctement intégrées et qu'un bon retour d'information des utilisateurs est établi, il fonctionnera beaucoup mieux que des modèles à la pointe de la technologie avec tous les accessoires.
Cycle de rétroaction
Ce cycle réunit la collecte de données, le réentraînement et le déploiement — en gros, tout le cycle de mise à jour du modèle. Pourquoi est-ce important ? Regardez le graphique des inscriptions par e-mail :
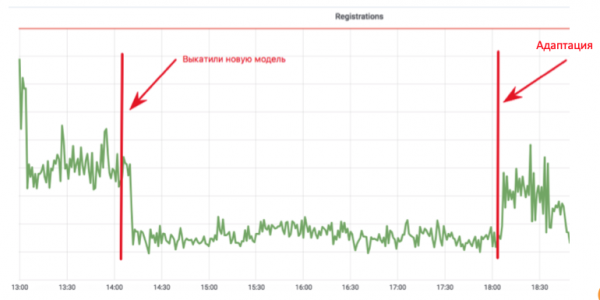
Le développeur d'apprentissage automatique a implémenté un modèle anti-bot qui empêche les bots de s'inscrire par e-mail. Le graphique chute à un niveau où seuls les utilisateurs réels restent. Tout va bien ! Mais au bout de quatre heures, les spammeurs ajustent leurs scripts, et tout revient comme avant. Dans cette implémentation, le développeur a passé un mois à ajouter des caractéristiques et à réentraîner le modèle, mais le spammeur a pu s'adapter en quatre heures.
Pour que cela ne devienne pas si douloureux et qu'il ne faille pas tout recommencer, il faut penser dès le départ à la manière dont le cycle de rétroaction sera conçu et ce que nous ferons si l'environnement change. Commençons par la collecte de données — c'est le carburant de nos algorithmes.
Collecte des données
Il est clair qu'aux réseaux neuronaux modernes, plus de données il y a, mieux c'est, et elles sont, en fait, générées par les utilisateurs du produit. Les utilisateurs peuvent nous aider en annotant des données, mais il ne faut pas en abuser, car à un moment donné, les utilisateurs en auront assez de former vos modèles et passeront à un autre produit.
Une des erreurs les plus fréquentes (ici, je fais référence à Andrew Ng) est une trop forte orientation sur les métriques sur le jeu de test, et non sur le retour d'information des utilisateurs, qui est en réalité la principale mesure de la qualité du travail, car nous créons un produit pour l'utilisateur. Si l'utilisateur ne comprend pas ou n'aime pas le fonctionnement du modèle, cela signifie que tout est vain.
Ainsi, l'utilisateur doit toujours avoir la possibilité de voter, il faut lui donner un outil pour le retour d'information. Si nous pensons qu'un e-mail reçu concerne les finances, il doit être étiqueté « finances », et nous devons dessiner un bouton que l'utilisateur peut cliquer pour dire que ce n'est pas des finances.
Qualité du retour d'information
Discutons de la qualité des retours utilisateurs. Tout d'abord, vous et l'utilisateur pouvez avoir des significations différentes pour le même concept. Par exemple, vous et les chefs de produit considérez que « finances » signifie des courriers de la banque, alors que l'utilisateur considère qu'une lettre de sa grand-mère au sujet de la pension appartient aussi aux finances. Deuxièmement, certains utilisateurs cliquent sans réfléchir sur des boutons sans aucune logique. Troisièmement, l'utilisateur peut avoir de fausses conclusions. Un exemple frappant de notre expérience est l'implémentation d'un classificateur , un type de spam plutôt amusant, où l'utilisateur se voit proposer de récupérer plusieurs millions de dollars d'un lointain parent soudainement trouvé en Afrique. Après l'implémentation de ce classificateur, nous avons vérifié les clics sur « Non spam » pour ces courriers, et il s'est avéré que 80 % d'entre eux étaient du véritable spam nigérian, ce qui indique que les utilisateurs peuvent être extrêmement naïfs.
Et n'oublions pas que les boutons peuvent être cliqués non seulement par des humains, mais aussi par des bots qui se font passer pour des navigateurs. Par conséquent, un retour brut n'est pas acceptable pour l'apprentissage. Que peut-on faire avec ces informations ?
Nous appliquons deux approches :
- Le retour d'un ML associé. Par exemple, nous avons un système anti-bot en ligne qui, comme je l'ai déjà mentionné, prend des décisions rapides sur la base d'un nombre limité de caractéristiques. Et il existe un deuxième système, plus lent, qui fonctionne a posteriori. Il a plus de données sur l'utilisateur, son comportement, etc. Par conséquent, il prend la décision la plus réfléchie, ayant ainsi une meilleure précision et exhaustivité. On peut rediriger la différence de fonctionnement de ces systèmes vers le premier comme données d'apprentissage. Ainsi, le système plus simple cherchera toujours à se rapprocher de la performance du système plus complexe.
- Classification des clics. On peut simplement classer chaque clic utilisateur, évaluer sa validité et son potentiel d'utilisation. C'est ce que nous faisons dans l'anti-spam des e-mails, en utilisant des caractéristiques de l'utilisateur, son historique, des attributs de l'expéditeur, le texte lui-même et le résultat du travail des classificateurs. Au final, nous obtenons un système automatisé qui valide les retours d'expérience des utilisateurs. Et comme il doit être réentraîné beaucoup moins souvent, son fonctionnement peut devenir la base pour tous les autres systèmes. La priorité principale dans ce modèle est la précision, car entraîner le modèle sur des données inexactes peut avoir des conséquences.
Tant que nous nettoyons les données et que nous réentraînons nos systèmes de ML, nous ne devons pas oublier les utilisateurs, car pour nous des milliers, des millions d'erreurs sur le graphique représentent des statistiques, alors que pour l'utilisateur, chaque bug est une tragédie. En plus du fait que l'utilisateur doit vivre avec votre erreur dans le produit, il s'attend à ce qu'après un retour d'expérience, une telle situation soit évitée à l'avenir. Il est donc toujours important d'offrir aux utilisateurs non seulement la possibilité de voter, mais aussi de corriger le comportement des systèmes de ML, en créant, par exemple, des heuristiques personnalisées pour chaque clic de retour, dans le cas des emails, cela pourrait être la possibilité de filtrer de tels messages par expéditeur et par sujet pour cet utilisateur.
Il est également nécessaire, sur la base de certains rapports ou demandes au support, de bricoler le modèle de manière semi-automatique ou manuelle, afin que d'autres utilisateurs ne souffrent pas de problèmes similaires.
Heuristiques pour l'apprentissage
Avec ces heuristiques et bricolages, il existe deux problèmes. Le premier est que le nombre croissant de bricolages est difficile à maintenir, sans parler de leur qualité et de leur fonctionnement à long terme. Le deuxième problème est que l'erreur peut ne pas être fréquente, et quelques clics pour réentraîner le modèle peuvent ne pas suffire. Il semblerait que ces deux effets non liés pourraient être considérablement atténués en appliquant l'approche suivante.
- Créons un bricolage temporaire.
- Nous envoyons les données de celui-ci dans le modèle, il est régulièrement réentraîné, y compris sur les données obtenues. Ici, il est bien sûr important que l'heuristique ait une haute précision pour ne pas diminuer la qualité des données dans l'ensemble d'entraînement.
- Ensuite, nous mettons en place un suivi pour le contournement, et si après un certain temps le contournement ne fonctionne plus et est entièrement couvert par le modèle, alors nous pouvons le supprimer sans crainte. Il est peu probable que ce problème se reproduise maintenant.
Ainsi, l'armée de contournements est très utile. L'essentiel est que leur service soit temporaire et non permanent.
Apprentissage supplémentaire
L'apprentissage supplémentaire est le processus d'ajout de nouvelles données, obtenues grâce aux retours des utilisateurs ou d'autres systèmes, et d'apprentissage sur ces données à partir du modèle existant. L'apprentissage supplémentaire peut présenter plusieurs problèmes :
- Le modèle peut simplement ne pas supporter l'apprentissage supplémentaire et ne pouvoir apprendre que depuis le début.
- Nulle part dans la nature il n'est écrit que l'apprentissage supplémentaire améliorera nécessairement la qualité du travail en production. Il arrive souvent que ce soit le contraire qui se produise, c'est-à-dire qu'une dégradation soit possible.
- Les changements peuvent être imprévisibles. C'est un point assez délicat que nous avons identifié. Même si un nouveau modèle dans un test A/B montre des résultats similaires à ceux de l'actuel, cela ne signifie pas qu'il fonctionnera de la même manière. Leur fonctionnement peut différer d'un petit pourcentage, ce qui pourrait introduire de nouvelles erreurs ou ramener d'anciennes erreurs déjà corrigées. Avec les erreurs actuelles, nous, ainsi que les utilisateurs, savons déjà vivre, et lorsque de nombreuses nouvelles erreurs apparaissent, l'utilisateur peut également être perdu, car il s'attend à un comportement prévisible.
Ainsi, le plus important dans l'apprentissage supplémentaire est d'améliorer le modèle de manière garantie, ou au moins de ne pas le dégrader.
La première chose qui vient à l'esprit quand nous parlons d'apprentissage supplémentaire est l'approche de l'apprentissage actif. Que cela signifie-t-il ? Par exemple, un classificateur détermine si un e-mail concerne les finances, et autour de sa frontière de prise de décision, nous ajoutons un échantillon d'exemples annotés. Cela fonctionne bien, par exemple, en publicité, où il y a beaucoup de retours et où l'on peut former le modèle en ligne. Mais si les retours sont rares, nous obtenons un échantillon très biaisé par rapport à la distribution des données en production, sur lequel il est impossible d'évaluer le comportement du modèle en exploitation.
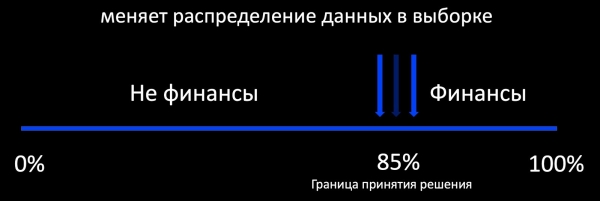
En réalité, notre objectif est de maintenir les anciens modèles déjà connus et d'en acquérir de nouveaux. La continuité est essentielle ici. Le modèle que nous avons souvent déployé avec beaucoup de difficulté est déjà opérationnel, donc nous pouvons nous baser sur ses performances.
Dans les emails, nous utilisons différents modèles : arbres, linéaires, réseaux de neurones. Pour chacun, nous développons notre propre algorithme de raffinement. Au cours de ce processus, nous acquérons non seulement de nouvelles données, mais souvent de nouvelles caractéristiques que nous prendrons en compte dans tous les algorithmes suivants.
Modèles linéaires
Prenons par exemple une régression logistique. Nous construisons la perte du modèle à partir des composants suivants :
- LogLoss sur de nouvelles données ;
- nous régularisons les poids des nouvelles caractéristiques (nous ne touchons pas aux anciennes) ;
- nous apprenons également sur les anciennes données pour conserver les anciens modèles ;
- et, sans doute, le plus important : nous appliquons l'Harmonique Regularization, qui garantit que les poids ne changent pas trop par rapport au modèle ancien selon la norme.
Puisque chaque composant de perte a des coefficients, nous pouvons choisir les valeurs optimales pour notre tâche lors de la validation croisée ou en fonction des exigences produit.
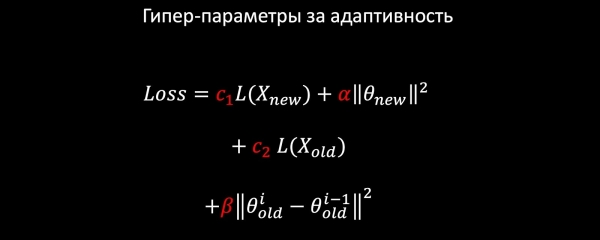
Arbres
Passons aux arbres de décision. Nous avons élaboré l'algorithme suivant pour le raffinement des arbres :
- En production, il y a une forêt de 100 à 300 arbres, entraînée sur l'ancien jeu de données.
- À la fin, nous en supprimons M = 5 et ajoutons 2M = 10 nouveaux, entraînés sur tout le jeu de données, mais avec un poids élevé sur les nouvelles données, ce qui garantit naturellement un changement incrémentiel du modèle.
Il est évident qu'avec le temps, le nombre d'arbres augmente considérablement, et il est nécessaire de les réduire périodiquement pour rester dans les délais. Pour cela, nous utilisons le désormais omniprésent Knowledge Distillation (KD). Un bref exposé sur son principe de fonctionnement.
- Nous avons le modèle « complexe » actuel. Nous le lançons sur le jeu de données d'entraînement et obtenons la distribution des probabilités des classes en sortie.
- Ensuite, nous enseignons au modèle élève (un modèle avec moins d'arbres dans ce cas) à reproduire les résultats du modèle en utilisant la distribution des classes comme variable cible.
- Il est important de noter que nous n'utilisons pas de structure de jeu de données, ce qui nous permet d'utiliser des données arbitraires. Évidemment, nous utilisons un échantillon de données du flux de production comme jeu d'entraînement pour le modèle apprenant. Ainsi, l'ensemble d'entraînement nous permet d'assurer la précision du modèle, tandis que l'échantillon du flux garantit une performance similaire en production, compensant le biais de l'ensemble d'entraînement.
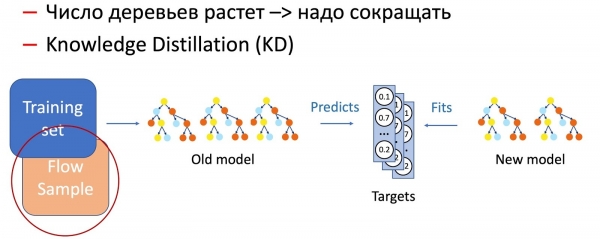
La combinaison de ces deux méthodologies (ajout d'arbres et réduction périodique de leur nombre grâce à la distillation des connaissances) assure l'introduction de nouveaux modèles et une continuité complète.
Grâce à la distillation des connaissances, nous effectuons également des opérations de distinction sur les caractéristiques du modèle, par exemple, la suppression de caractéristiques et le traitement des valeurs manquantes. Dans notre cas, nous avons un certain nombre de caractéristiques statistiques importantes (concernant les expéditeurs, les hachages de texte, les URL, etc.) qui sont stockées dans une base de données présentant des risques de refus. Naturellement, le modèle n'est pas préparé à cette situation, car il n'y a pas de cas de refus dans l'ensemble d'entraînement. Dans de tels cas, nous combinons les techniques de distillation des connaissances et d'augmentation : lors de l'entraînement, pour une partie des données, nous supprimons ou mettons à zéro les caractéristiques nécessaires, alors que les étiquettes (sorties du modèle actuel) restent initiales, le modèle apprenant apprend à reproduire cette distribution.
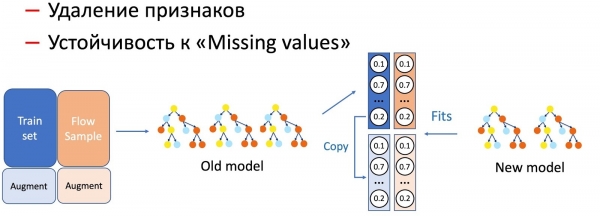
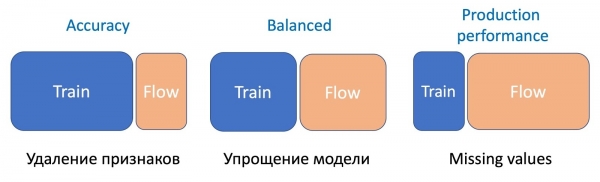
Nous avons remarqué que plus une manipulation des modèles est sérieuse, plus il est nécessaire d'avoir un échantillon de flux en pourcentage.
Pour la suppression de caractéristiques, l'opération la plus simple, il suffit d'une petite partie du flux, car seules quelques caractéristiques changent et le modèle actuel a été formé sur le même ensemble - la différence est minimale. Pour simplifier le modèle (réduire le nombre d'arbres de plusieurs fois), il faut déjà 50 pour 50. Et pour les valeurs manquantes des caractéristiques statistiques importantes, qui affectent sérieusement la performance du modèle, il faut encore plus de flux pour équilibrer le travail du nouveau modèle robuste face aux valeurs manquantes sur tous les types de courriers.
FastText
Passons à FastText. Je rappelle que la représentation (Embedding) d'un mot consiste en la somme de l'embedding du mot lui-même et de tous ses N-grams de lettres, généralement des trigrammes. Étant donné qu'il peut y avoir beaucoup de trigrammes, on utilise le Bucket Hashing, c'est-à-dire la transformation de tout l'espace en une certaine table de hachage fixe. En fin de compte, la matrice de poids obtient une dimension du nombre de mots + nombre de seaux pour la couche interne.
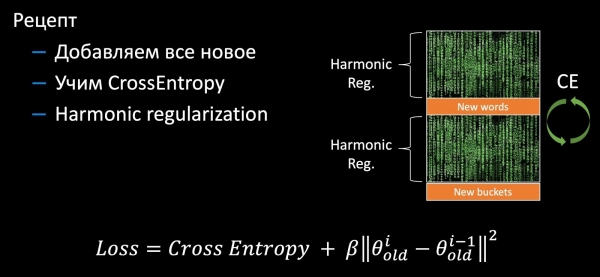
Lors du réentraînement, de nouvelles caractéristiques apparaissent : des mots et des trigrammes. Lors du réentraînement standard proposé par Facebook, rien de substantiel ne se passe. Seuls les anciens poids sont réentraînés avec la cross-entropy sur de nouvelles données. Ainsi, de nouvelles caractéristiques ne sont pas utilisées, ce qui, bien sûr, entraîne tous les inconvénients mentionnés ci-dessus, liés à l'imprévisibilité du modèle en production. C'est pourquoi nous avons légèrement amélioré FastText. Nous ajoutons tous les nouveaux poids (mots et trigrammes), nous réentraînons toute la matrice avec la cross-entropy et nous ajoutons une régularisation harmonique, en analogie avec le modèle linéaire, qui garantit un changement insignifiant des anciens poids.
CNN
Il est un peu plus complexe de travailler avec des réseaux de neurones convolutifs. Si dans les CNN les dernières couches sont réentraînées, alors bien sûr, on peut appliquer une régularisation harmonique et garantir la continuité. Cependant, si un réentraînement du réseau entier est nécessaire, il devient impossible d'appliquer cette régularisation à toutes les couches. Toutefois, il existe une option d'apprentissage d'embeddings complémentaires via Triplet Loss ().
Triplet Loss
Prenons l'exemple de la tâche d'anti-phishing pour discuter en termes généraux du Triplet Loss. Prenons notre logo, ainsi que des exemples positifs et négatifs de logos d'autres entreprises. Nous minimisons la distance entre les premiers et maximisons la distance entre les seconds, en laissant un léger écart pour assurer une plus grande compacité des classes.
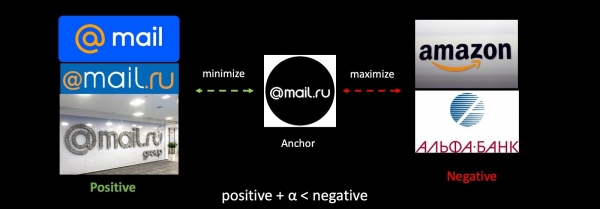
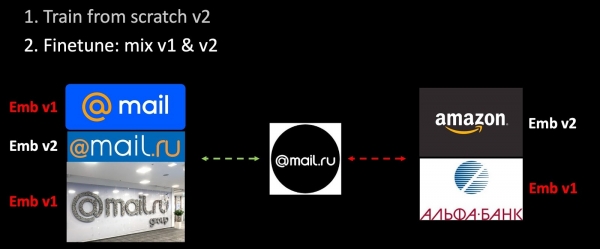
Si nous réentraînons le réseau, l'espace métrique change complètement, devenant complètement incompatible avec le précédent. C'est un problème sérieux dans les tâches utilisant des vecteurs. Pour contourner ce problème, nous allons mélanger les anciens embeddings pendant l'apprentissage.
Nous avons ajouté de nouvelles données au jeu d'entraînement et nous entraînons la deuxième version du modèle depuis le début. Lors de la deuxième étape, nous procédons au fine-tuning de notre réseau : d'abord, nous entraînons la dernière couche, puis nous dégelons tout le réseau. Dans le processus de création des triplets, seules certaines des embeddings sont calculées à l'aide du modèle entraîné, les autres le sont avec l'ancien modèle. Ainsi, lors du fine-tuning, nous assurons la compatibilité des espaces métriques v1 et v2. C'est une sorte de regularisation harmonique.
Architecture globale
Si l'on considère l'ensemble du système à travers l'exemple de l'anti-spam, les modèles ne sont pas isolés, mais imbriqués les uns dans les autres. Nous prenons des images, du texte et d'autres caractéristiques, puis nous obtenons des embeddings grâce à CNN et Fast Text. Ensuite, des classificateurs sont appliqués sur les embeddings, qui produisent des scores pour différentes classes (types de courriers, spam, présence de logo). Les scores et les caractéristiques sont ensuite passés dans une forêt d'arbres pour prendre la décision finale. Des classificateurs distincts dans ce schéma permettent une meilleure interprétation des résultats du système et un fine-tuning plus précis des composants en cas de problème, plutôt que de soumettre toutes les données brutes aux arbres de décision.
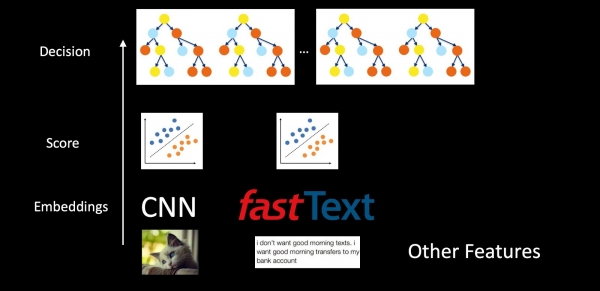
En fin de compte, nous garantissons la continuité à chaque niveau. Au niveau inférieur dans CNN et Fast Text, nous utilisons la regularisation harmonique, pour les classificateurs au milieu — également la regularisation harmonique et l'étalonnage des scores pour la compatibilité de la distribution des probabilités. Quant au boosting des arbres, il est entraîné de manière incrémentale ou par le biais de la distillation des connaissances.
Dans l'ensemble, le support d'un tel système de machine learning imbriqué pose généralement des problèmes, car tout composant au niveau inférieur entraîne la mise à jour de tout le système au-dessus. Cependant, comme dans notre configuration, chaque composant change légèrement et est compatible avec le précédent, l'ensemble du système peut être mis à jour par petits morceaux sans avoir besoin de ré-entraîner toute la structure, ce qui permet de le maintenir sans un sérieux overhead.
Déployer
Nous avons examiné la collecte de données et le fine-tuning de différents types de modèles, nous allons donc passer à leur déploiement en environnement de production.
A/B testing
Comme je l'ai mentionné précédemment, lors de la collecte des données, nous avons généralement un échantillon biaisé, ce qui rend impossible l'évaluation des performances en production du modèle. Par conséquent, lors du déploiement, il est impératif de comparer le modèle avec la version précédente pour comprendre comment les choses se passent réellement, c'est-à-dire de réaliser des tests A/B. En fait, le processus de déploiement et d'analyse des graphiques est assez routinier et se prête parfaitement à l'automatisation. Nous déployons nos modèles progressivement sur 5 %, 30 %, 50 % et 100 % des utilisateurs, tout en collectant toutes les métriques disponibles sur les réponses du modèle et les retours des utilisateurs. En cas d'explosions sérieuses, nous rétablissons automatiquement le modèle, et pour les autres cas, après avoir obtenu suffisamment de clics des utilisateurs, nous prenons la décision d'augmenter le pourcentage. Au final, nous amenons le nouveau modèle à 50 % des utilisateurs entièrement automatiquement, et le déploiement à l'ensemble du public est approuvé par une personne, bien que cette étape puisse également être automatisée.
Cependant, le processus des tests A/B représente un champ d'optimisation. En effet, chaque test A/B est assez long (dans notre cas, il dure entre 6 et 24 heures en fonction de la quantité de retours), ce qui le rend assez coûteux et avec des ressources limitées. De plus, un pourcentage élevé de flux est nécessaire pour le test, afin d'accélérer le temps total du test A/B (obtenir un échantillon statistiquement significatif pour évaluer les métriques avec un petit pourcentage peut prendre beaucoup de temps), ce qui rend le nombre de slots A/B extrêmement limité. Il est évident que nous devons uniquement tester les modèles les plus prometteurs, dont nous obtenons beaucoup lors du processus de réentraînement.
Pour résoudre ce problème, nous avons formé un classificateur distinct qui prédit le succès du test A/B. Pour cela, nous utilisons des statistiques de prise de décision, la précision, le rappel et d'autres métriques sur l'ensemble d'apprentissage, sur l'ensemble de validation et sur un échantillon du flux. Nous comparons également le modèle avec celui actuellement en production, avec des heuristiques, et prenons en compte la complexité du modèle. En utilisant toutes ces caractéristiques, le classificateur formé sur l'historique des tests évalue les modèles candidats, dans notre cas, ce sont des forêts d'arbres, et prend la décision de savoir lequel d'entre eux doit être inclus dans le test A/B.
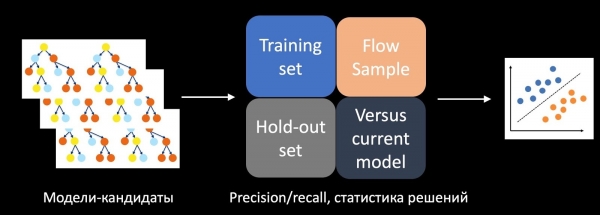
Grâce à cette approche, nous avons pu multiplier par plusieurs fois le nombre de tests A/B réussis.
Test et surveillance
Étonnamment, tester et surveiller ne nuisent pas à notre santé, au contraire, cela améliore les choses et réduit le stress. Les tests permettent de prévenir les pannes, tandis que la surveillance permet de les détecter à temps, minimisant ainsi leur impact sur les utilisateurs.
Il est important de comprendre qu'à un moment donné, votre système fera toujours des erreurs — cela fait partie du cycle de développement de tout logiciel. Au début du développement, de nombreux bogues affligent le système tant que la phase des innovations majeures n'est pas terminée. Cependant, avec le temps, l'entropie prend le dessus, et les erreurs réapparaissent — en raison de la dégradation des composants environnants et des changements dans les données, comme je l'ai mentionné au début.
Je voudrais souligner que tout système d'apprentissage automatique doit être évalué en termes de rentabilité sur l'ensemble de son cycle de vie. Le graphique ci-dessous montre un exemple du fonctionnement d'un système de détection d'un type rare de spam (la ligne est proche de zéro sur le graphique). À un moment donné, à cause d'une caractéristique mal mise en cache, le système a dysfonctionné. Malheureusement, il n'y avait pas de surveillance pour détecter l'activation anormale, ce qui a conduit le système à classer un grand nombre de courriers dans le dossier "spam" juste à la limite de prise de décision. Malgré la correction des conséquences, le système a déjà fait tant d'erreurs qu'il ne sera pas rentable même après cinq ans. C'est un échec total du point de vue du cycle de vie du modèle.
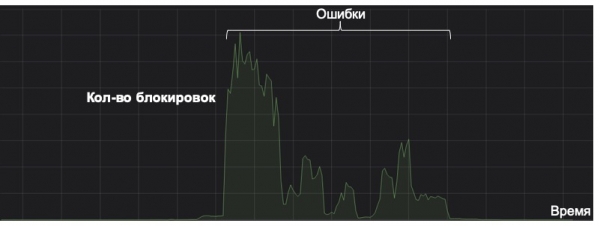
Ainsi, une chose aussi simple que la surveillance peut devenir cruciale pour la vie du modèle. En plus des métriques standard et évidentes, nous examinons la distribution des réponses et des scores du modèle, ainsi que la distribution des valeurs des caractéristiques clés. À l'aide de la divergence KL, nous pouvons comparer la distribution actuelle avec l'historique ou les valeurs d'un test A/B avec le reste du flux, ce qui permet de détecter des anomalies dans le modèle et de revenir en arrière sur les modifications en temps opportun.
Dans la plupart des cas, nous lançons nos premières versions de systèmes à l'aide d'heuristiques simples ou de modèles que nous utilisons ensuite pour la surveillance. Par exemple, nous surveillons un modèle NER par rapport aux expressions régulières pour des magasins en ligne spécifiques, et si la couverture du classificateur diminue par rapport à celles-ci, nous enquêtons sur les raisons. Une autre utilisation utile des heuristiques !
Résultats
Repassons sur les idées clés de l'article.
- Fibdéc. Nous pensons toujours à l'utilisateur : comment il vivra avec nos erreurs, comment il pourra les signaler. N'oublions pas que les utilisateurs ne sont pas une source de feedback pur pour l'apprentissage des modèles, et il est nécessaire de le filtrer à l'aide de systèmes ML auxiliaires. S'il n'est pas possible de recueillir de signaux de l'utilisateur, nous recherchons des sources alternatives de feedback, par exemple, des systèmes connexes.
- Apprentissage supplémentaire. Ici, l'essentiel est la continuité, donc nous nous appuyons sur le modèle de production actuel. Nous formons les nouveaux modèles de manière à ce qu'ils ne diffèrent pas trop de l'ancien grâce à la régularisation harmonique et à des astuces similaires.
- Déployer. L'auto-déploiement basé sur les métriques réduit considérablement le temps nécessaire à la mise en œuvre des modèles. La surveillance des statistiques et de la distribution des décisions, ainsi que le nombre de faux positifs de la part des utilisateurs, est indispensable pour votre tranquillité d'esprit et vos week-ends productifs.
Eh bien, j'espère que ce que vous avez lu vous aidera à améliorer plus rapidement vos systèmes ML, à accélérer leur mise sur le marché et à les rendre plus fiables, réduisant ainsi le stress lié au travail.
Source : habr.com
