

Comme vous le savez, la société SAP propose une gamme complète de logiciels, tant pour la gestion des données transactionnelles que pour le traitement de ces données dans les systèmes d'analyse et de reporting. En particulier, la plateforme SAP Business Warehouse (SAP BW) est un ensemble d'outils pour le stockage et l'analyse des données, doté de larges capacités techniques. Malgré tous ses avantages objectifs, le système SAP BW présente un inconvénient majeur : le coût élevé du stockage et du traitement des données, particulièrement notable lors de l'utilisation de SAP BW on Hana dans le cloud.
Et si, au lieu d'utiliser SAP, nous commencions à utiliser un produit Open Source non-SAP ? Nous, chez X5 Retail Group, avons choisi GreenPlum. Cela permet effectivement de résoudre le problème de coût, mais cela soulève immédiatement des questions qui étaient pratiquement résolues par défaut lors de l'utilisation de SAP BW.
En particulier, comment extraire des données provenant des systèmes sources, qui sont pour la plupart des solutions SAP ?
Le projet « HR-métriques » a été le premier à devoir résoudre ce problème. Notre objectif était de créer un entrepôt de données RH et de construire des rapports analytiques sur la gestion des employés. La principale source de données étant le système transactionnel SAP HCM, qui gère toutes les activités relatives au personnel, à l'organisation et à la paie.
Extraction de données
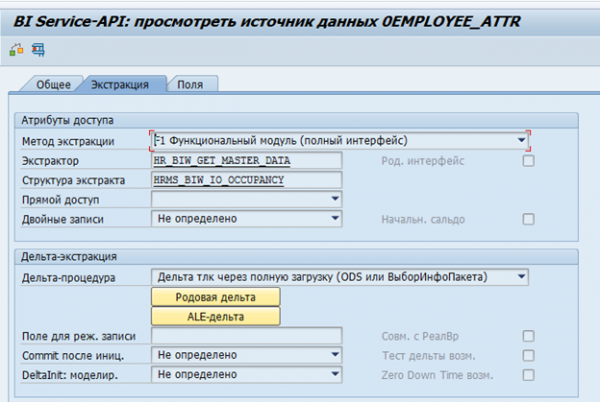
Dans SAP BW pour les systèmes SAP, il existe des extracteurs de données standard. Ces extracteurs peuvent collecter automatiquement les données nécessaires, surveiller leur intégrité et déterminer les delta de changements. Par exemple, voici une source de données standard concernant les attributs des employés 0EMPLOYEE_ATTR :
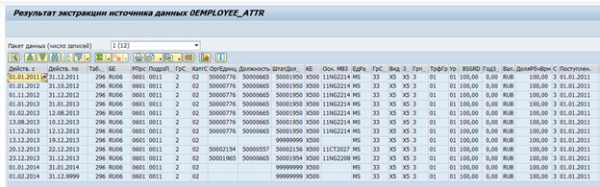
Résultat de l'extraction de données pour un employé :
Si nécessaire, cet extracteur peut être modifié selon les exigences propres ou un extracteur personnalisé peut être créé.
L'idée de réutiliser ces extracteurs est apparue en premier. Malheureusement, cela s'est avéré être une tâche irréalisable. La plupart de la logique est implémentée du côté de SAP BW, et il n'a pas été possible de dissocier facilement l'extracteur à la source de SAP BW.
Il est devenu évident qu'il serait nécessaire de développer un mécanisme propre d'extraction de données à partir des systèmes SAP.
Structure de stockage des données dans SAP HCM
Pour comprendre les exigences d'un tel mécanisme, il est d'abord nécessaire de déterminer quelles données nous seront nécessaires.
La plupart des données dans SAP HCM sont stockées dans des tables SQL plates. Sur la base de ces données, les applications SAP visualisent la structure organisationnelle, les employés et d'autres informations RH à l'utilisateur. Par exemple, voici à quoi ressemble la structure organisationnelle dans SAP HCM :
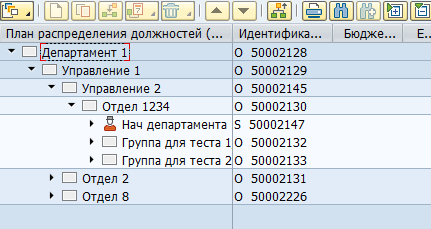
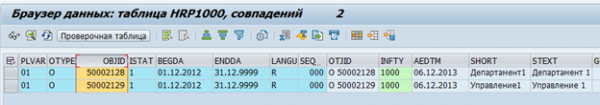
Physiquement, cet arbre est stocké dans deux tables — dans hrp1000 pour les objets et dans hrp1001 pour les relations entre ces objets.
Objets « Département 1 » et « Direction 1 » :
Relation entre les objets :
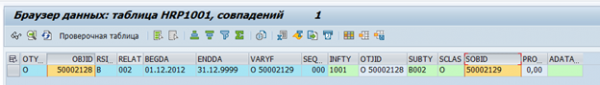
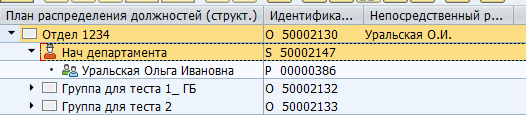
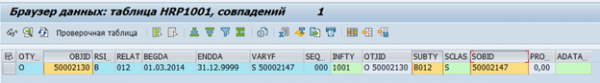
Il peut y avoir un grand nombre de types d'objets ainsi que de types de relations entre eux. Il existe à la fois des relations standard entre les objets et des relations personnalisées pour des besoins spécifiques. Par exemple, la relation standard B012 entre une unité organisationnelle et un poste indique le responsable de la division.
Affichage du responsable dans SAP :
Stockage dans la table de la base de données :
Les données des employés sont stockées dans des tables pa*. Par exemple, les données concernant les événements de personnel pour un employé sont stockées dans la table pa0000.
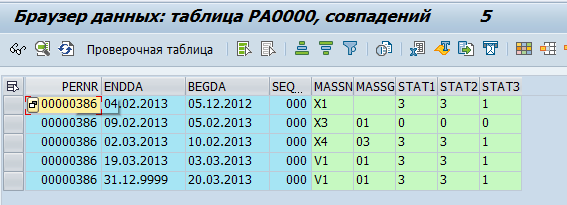
Nous avons décidé que GreenPlum récupérera les données « brutes », c'est-à-dire qu'il les copiera simplement à partir des tables SAP. Ensuite, directement dans GreenPlum, elles seront traitées et transformées en objets physiques (par exemple, Département ou Employé) et en métriques (par exemple, l'effectif moyen).
Environ 70 tables ont été identifiées, dont les données doivent être transmises à GreenPlum. Après cela, nous avons commencé à travailler sur le moyen de transmettre ces données.
SAP propose un nombre considérable de mécanismes d'intégration. Mais la manière la plus simple — l'accès direct à la base de données est interdit en raison de restrictions de licence. Ainsi, tous les flux d'intégration doivent être réalisés au niveau de serveurs des applications.
Le problème suivant était l'absence de données sur les enregistrements supprimés dans la base de données SAP. Lorsqu'une ligne est supprimée dans la base de données, elle est supprimée physiquement. Autrement dit, il n'était pas possible de former un delta des changements en fonction du temps de modification.
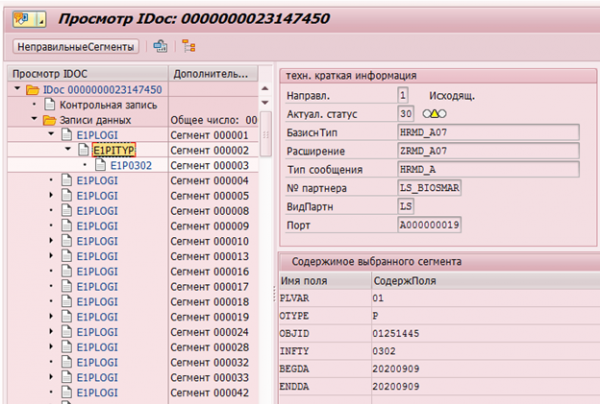
Bien sûr, dans SAP HCM, il existe des mécanismes pour fixer les modifications des données. Par exemple, pour le transfert ultérieur dans les systèmes récepteurs, des pointeurs de changement (change pointer) existent, qui enregistrent toute modification et sur la base desquelles des Idocs (objets pour le transfert vers des systèmes externes) sont formés.
Exemple d'IDoc pour le changement de type d'information 0302 d'un employé avec le numéro de personnel 1251445 :
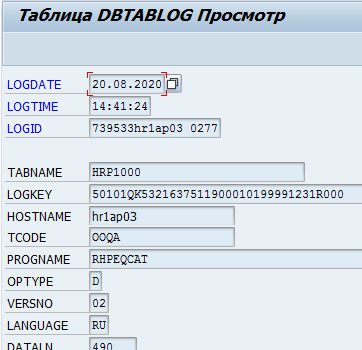
Ou la tenue des journaux des modifications de données dans la table DBTABLOG.
Exemple d'un journal de suppression d'une entrée avec la clé QK53216375 de la table hrp1000 :
Cependant, ces mécanismes ne sont pas accessibles pour toutes les données nécessaires, et leur traitement au niveau du serveur d'applications peut consommer beaucoup de ressources. Par conséquent, l'activation massive de la journalisation pour toutes les tables nécessaires peut entraîner une dégradation significative des performances du système.
Un autre problème majeur concernait les tables cluster. Les données de calcul des temps et des salaires dans la version RDBMS de SAP HCM sont stockées sous forme d'un ensemble de tables logiques pour chaque employé à chaque calcul. Ces tables logiques sont stockées sous forme de données binaires dans la table pcl2.
Cluster de calcul des salaires :
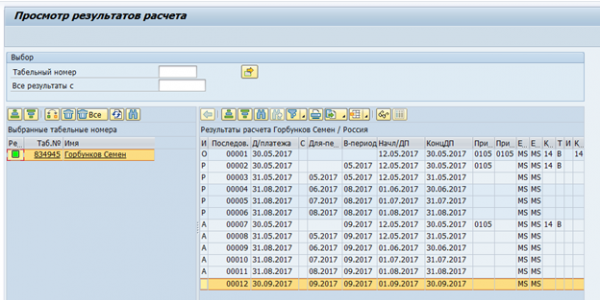
Les données des tables cluster ne peuvent pas être lues par une commande SQL, mais nécessitent l'utilisation de macros SAP HCM ou de modules fonctionnels spéciaux. En conséquence, la vitesse de lecture de telles tables sera relativement basse. D'autre part, ces clusters contiennent des données nécessaires seulement une fois par mois – le calcul final des salaires et l'évaluation du temps. Ainsi, la vitesse n'est pas si critique dans ce cas.
En évaluant les options pour la formation de la delta des changements de données, nous avons également décidé d'examiner l'option d'un export complet. L'option de transmettre des gigaoctets de données inchangées entre les systèmes chaque jour ne peut pas paraître attrayante. Cependant, elle présente également plusieurs avantages – pas besoin de mettre en œuvre la delta du côté de la source, ni d'implémenter cette delta du côté du destinataire. Ainsi, les coûts et les délais de mise en œuvre sont réduits, et la fiabilité de l'intégration est améliorée. Il a été déterminé que pratiquement tous les changements dans SAP HR se produisent dans un horizon de trois mois jusqu'à la date actuelle. Par conséquent, il a été décidé de s'arrêter sur l'exportation complète quotidienne des données SAP HR pendant N mois avant la date actuelle et sur l'exportation complète mensuelle. Le paramètre N dépend de la table spécifique.
et varie de 1 à 15.
Pour l'extraction des données, le schéma suivant a été proposé :
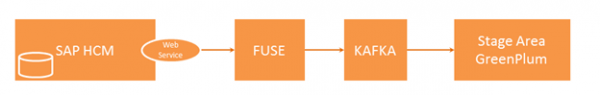
Le système externe génère une requête et l'envoie à SAP HCM, où cette requête est vérifiée pour l'intégralité des données et les autorisations d'accès aux tables. En cas de vérification réussie, un programme dans SAP HCM collecte les données nécessaires et les transmet à la solution d'intégration Fuse. Fuse détermine le topic nécessaire dans Kafka et y transfère les données. Ensuite, les données de Kafka sont envoyées dans la Zone de Stage GP.
Nous nous intéressons dans cette chaîne à la question de l'extraction des données de SAP HCM. Examinons cela plus en détail.
Schéma d'interaction entre SAP HCM et FUSE.
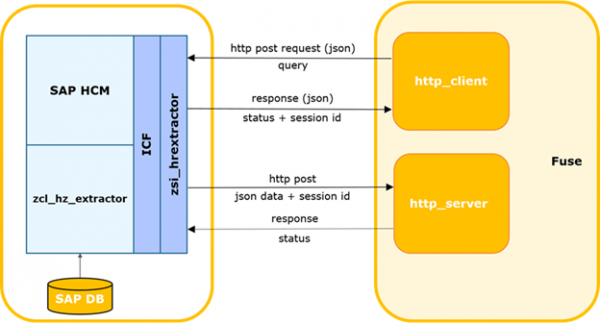
Le système externe détermine le moment de la dernière requête réussie dans SAP.
Le processus peut être lancé par un minuteur ou un autre événement, y compris un délai d'attente pour une réponse des données de SAP et l'initiation d'une nouvelle requête. Cela formate ensuite une requête de delta et l'envoie à SAP.
Les données de la requête sont transmises dans le corps au format json.
Méthode http : POST.
Exemple de requête :
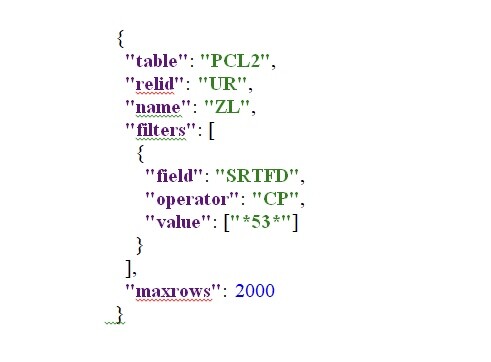
Le service SAP effectue un contrôle de la requête pour en vérifier l'intégralité, la conformité avec la structure actuelle de SAP et la présence d'une autorisation d'accès à la table demandée.
En cas d'erreurs, le service retourne une réponse avec le code correspondant et une description. En cas de contrôle réussi, il crée un processus en arrière-plan pour la création de l'échantillon, génère et retourne synchrone un id de session unique.
Le système externe en cas d'erreur l'enregistre dans le journal. En cas de réponse réussie, il transmet l'id de session et le nom de la table sur laquelle la requête a été faite.
Le système externe enregistre la session actuelle comme ouverte. Si d'autres sessions existent pour cette table, elles sont fermées avec un enregistrement d'avertissement dans le journal.
La tâche en arrière-plan SAP forme un curseur avec les paramètres spécifiés et un paquet de données de taille déterminée. La taille du paquet est le nombre maximum d'enregistrements que le processus lit de la base de données. Par défaut, elle est fixée à 2000. Si l'échantillon de base de données contient plus d'enregistrements que la taille de paquet utilisée, après la transmission du premier paquet, un nouveau bloc se forme avec l'offset correspondant et le numéro du paquet incrémenté. Les numéros sont incrémentés de 1 et envoyés de manière strictement séquentielle.
Ensuite, SAP envoie le paquet au service web du système externe. Ce dernier effectue des contrôles sur le paquet entrant. Une session avec l'ID reçu doit être enregistrée sur le système et être dans un statut ouvert. Si le numéro du paquet est > 1, le système doit enregistrer la réception réussie du paquet précédent (package_id-1).
En cas de contrôle réussi, le système externe analyse et enregistre les données du tableau.
De plus, si le paquet contient le drapeau final et que la sérialisation a réussi, le module d'intégration est informé de la fin réussie du traitement de la session et le module met à jour le statut de la session.
En cas d'erreur lors des contrôles/d'analyse, l'erreur est enregistrée et les paquets liés à cette session seront rejetés par le système externe.
Inversement, lorsque le système externe renvoie une erreur, celle-ci est enregistrée et la transmission des paquets est interrompue.
Pour la demande de données du côté de SAP HCM, un service d'intégration a été mis en place. Ce service est basé sur le cadre ICF (SAP Internet Communication Framework — ). Il permet de faire des demandes de données à partir du système SAP HCM pour certaines tables. Lors de la formation de la demande de données, il est possible de spécifier une liste de champs spécifiques et des paramètres de filtrage afin d'obtenir les données nécessaires. La mise en œuvre du service ne suppose aucune logique métier. Les algorithmes de calcul de la delta, des paramètres de requête, du contrôle de l'intégrité, etc. sont également réalisés du côté du système externe.
Ce mécanisme permet de collecter et de transmettre toutes les données nécessaires en quelques heures. Cette vitesse frôle l'acceptable, c'est pourquoi cette solution est considérée par nous comme temporaire, ayant permis de répondre à la nécessité d'un outil d'extraction pour le projet.
Dans la vision cible pour résoudre la tâche d'extraction des données, des options utilisant des systèmes CDC tels qu'Oracle Golden Gate ou des outils ETL comme SAP DS sont examinées.
Source : habr.com
