

Il existe de nombreuses solutions de sauvegarde, mais que faire si les serveurs gérés sont dispersés dans différentes régions et clients, et que nous devons nous contenter des moyens fournis par le système d'exploitation ?
Bonjour, Habr!
Je m'appelle Natalia. Je suis responsable de l'équipe des administrateurs d'applications chez NPO « Krysta ». Nous sommes l'équipe opérationnelle pour le groupe de projets de notre entreprise. Nous avons une situation assez particulière : nous installons et supportons notre logiciel à la fois sur des serveurs de notre entreprise et sur des serveurs situés chez des clients. Dans ce cas, il n'est pas nécessaire de sauvegarder le serveur en entier. Seules les « données essentielles » sont importantes : bases de données et certains répertoires du système de fichiers. Bien sûr, les clients ont (ou n'ont pas) leurs propres règlements de sauvegarde et fournissent souvent un espace de stockage externe pour y déposer les sauvegardes. Dans ce cas, après la création de la sauvegarde, nous assurons l'envoi vers l'espace de stockage externe.
Pendant un certain temps, nous avons utilisé un script bash pour les sauvegardes, mais à mesure que le nombre de configurations augmentait, la complexité de ce script grandissait également, et à un certain moment, nous avons ressenti le besoin de le « démolir pour recommencer ».
Les solutions prêtes à l'emploi ne convenaient pas pour différentes raisons : nécessité de décentraliser les sauvegardes, obligation de conserver les sauvegardes localement chez le client, complexité de configuration, substitution des importations, restrictions d'accès.
Nous avons pensé qu'il serait plus simple d'écrire quelque chose de notre propre cru. Nous souhaitions créer quelque chose qui suffise à notre situation pour les années à venir, tout en ayant la possibilité d'une extension potentielle de son domaine d'application.
Les conditions du projet étaient les suivantes :
- l'instance de sauvegarde de base est autonome, fonctionne localement
- le stockage des sauvegardes et des journaux est toujours à l'intérieur du réseau du client
- l'instance est composée de modules - une sorte de « constructeur »
- compatibilité requise avec les distributions Linux utilisées, y compris celles obsolètes, avec une souhaitable interopérabilité potentielle
- l'accès ssh est suffisant pour travailler avec l'instance, l'ouverture de ports supplémentaires n'est pas nécessaire
- simplicité maximale de configuration et d'exploitation
- il est possible (mais pas obligatoire) d'avoir une instance distincte permettant de consulter de manière centralisée l'état des sauvegardes de différents serveurs
Ce que nous avons réalisé peut être consulté ici :
Le logiciel est écrit en python3 ; il fonctionne sur Debian, Ubuntu, CentOS, AstraLinux 1.6.
La documentation est disponible dans le répertoire docs du dépôt.
Concepts de base utilisés par le système :
action – une action qui réalise une opération atomique (sauvegarde de la base de données, sauvegarde d'un répertoire, transfert du répertoire A au répertoire B, etc.). Les actions existantes se trouvent dans le répertoire core/actions
task – un ensemble d'actions décrivant une "tâche de sauvegarde" logique
schedule – un emploi du temps, un ensemble de tâches avec une option pour indiquer l'heure d'exécution de la tâche
La configuration de la sauvegarde est stockée dans un fichier yaml ; la structure générale de la configuration est :
- paramètres généraux
- section actions : description des actions utilisées sur ce serveur
- section schedule : description de toutes les tâches (ensembles d'actions) et leur emploi du temps de lancement via cron, si un tel lancement est requis
Ce que l'application peut faire actuellement :
- Prise en charge des opérations principales : sauvegarde de PostgreSQL via pg_dump, sauvegarde de répertoires du système de fichiers via tar ; opérations avec du stockage externe ; rsync entre répertoires ; rotation des sauvegardes (suppression des anciennes copies)
- appel d'un script externe
- exécution manuelle d'une tâche distincte
/opt/KristaBackup/KristaBackup.py run make_full_dump - vous pouvez ajouter (ou retirer) une tâche distincte ou tout l'emploi du temps dans la crontab
/opt/KristaBackup/KristaBackup.py enable all - génération d'un fichier de déclenchement basé sur les résultats de la sauvegarde. Cette fonction est utile en lien avec Zabbix pour le monitoring des sauvegardes
- peut fonctionner en arrière-plan en mode webapi ou web
/opt/KristaBackup/KristaBackup.py web start [--api]
Différence entre les modes : en webapi, il n'y a pas d'interface web propre à l'application, mais celle-ci répond aux requêtes d'une autre instance. Pour le mode web, il faut installer flask et plusieurs paquets supplémentaires, ce qui n'est pas toujours acceptable, par exemple sur l'AstraLinux SE certifié.
Via l'interface web, vous pouvez consulter l'état et les journaux des sauvegardes des serveurs connectés : « l'instance web » interroge les « instances de sauvegarde » via API. L'accès au web nécessite une authentification, tandis que l'accès au webapi ne le nécessite pas.
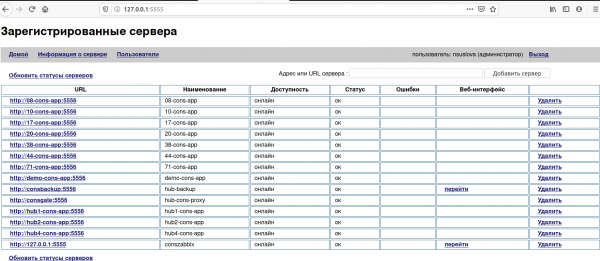
Les journaux des sauvegardes échouées sont marqués par couleur : avertissement – jaune, erreur – rouge.
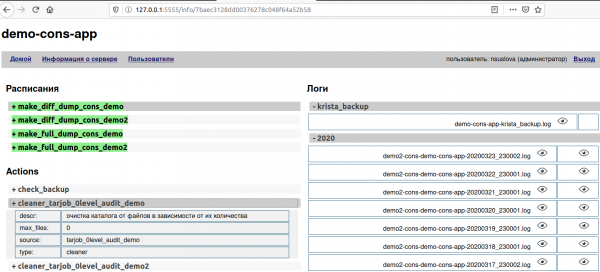
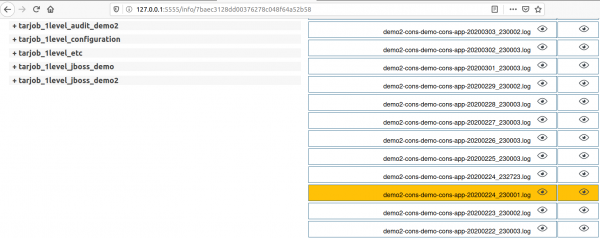
Si l'administrateur n'a pas besoin d'une fiche d'information sur les paramètres et que les systèmes d'exploitation des serveurs sont homogènes, il peut compiler le fichier et distribuer un paquet prêt à l'emploi.
Nous distribuons principalement cet outil via Ansible, en l'installant d'abord sur une partie des serveurs les moins critiques, puis après tests, sur tous les autres.
En fin de compte, nous avons obtenu un utilitaire de copie compact et autonome, qui peut être automatisé et utiliser même par des administrateurs peu expérimentés. C'est pratique pour nous – cela pourrait aussi vous intéresser ?
Source : habr.com
