

En s'inspirant de la discussion dans le chat
Ces derniers temps, de véritables batailles font rage sur la définition des concepts DevOps et SRE.
Bien que ces discussions soient déjà plutôt éculées, y compris pour moi, j'ai décidé de soumettre ma vision de ce sujet à la communauté Habr. Ceux que cela intéresse, bienvenue sous le kat. Que tout recommence !
Contexte
Donc, dans les temps anciens, il y avait une équipe distincte de développeurs de logiciels et d'administrateurs de serveurs. Les premiers écrivaient du code avec succès, les seconds, utilisant divers mots chaleureux et affectueux à l'égard des premiers, configuraient les serveurs, venant périodiquement voir les développeurs et recevant en retour la réponse exhaustive « ça fonctionne sur ma machine ». L'entreprise attendait le logiciel, tout stagnait, se cassait périodiquement, tout le monde était nerveux. Surtout celui qui payait pour ce désordre. La glorieuse époque des lampes. Mais vous savez déjà d'où viennent les racines du DevOps.
La naissance des pratiques DevOps
Puis sont arrivés des messieurs sérieux qui ont dit - cela ne peut pas être une industrie, cela ne peut pas fonctionner ainsi. Et ils ont apporté des modèles de cycle de vie. Voici, par exemple, le modèle en V.
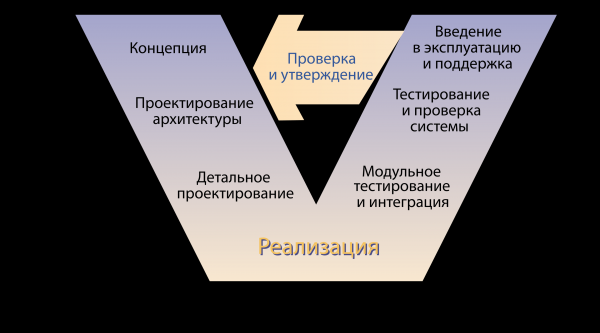
Alors, que voyons-nous ? L'entreprise arrive avec un concept, les architectes conçoivent des solutions, les développeurs écrivent du code, ensuite - c'est le néant. Quelqu'un teste le produit d'une manière ou d'une autre, quelqu'un le livre d'une manière ou d'une autre, et quelque part à la sortie de ce modèle miracle, un unique client commercial attend le temps favorable promis. On en a conclu qu'il fallait des méthodes pour rationaliser ce processus. Et il a été décidé de créer des pratiques pour les réaliser.
Une parenthèse lyrique sur ce qu'est une pratique
Par pratique, j'entends l'association de technologie et de discipline. Par exemple, la pratique de la description de l'infrastructure par code avec Terraform. La discipline est la manière de décrire l'infrastructure par code, elle est dans l'esprit du développeur, tandis que la technologie est justement Terraform.
Ils ont décidé de les appeler des pratiques DevOps — je pense qu'ils voulaient dire « de la Développement à l'Opération ». Ils ont inventé toutes sortes de concepts compliqués — des pratiques CI/CD, des pratiques basées sur le principe de l'IaC, des milliers d'entre elles. Et c'est parti, les développeurs écrivent du code, les ingénieurs DevOps transforment la description du système en code en systèmes fonctionnels (oui, le code est malheureusement juste une description, mais pas l'incarnation du système), la livraison s'active, et ainsi de suite. Les anciens administrateurs, ayant maîtrisé ces nouvelles pratiques, se sont fièrement requalifiés en ingénieurs DevOps, et tout a démarré. Et il y avait le soir, et il y avait le matin… pardon, je ne voulais pas dire cela.
Tout ne va pas non plus.
Tout juste calmé, et divers « méthodologues » rusés ont commencé à écrire de gros livres sur les pratiques DevOps, des débats silencieux ont commencé à éclater, qui est ce fameux ingénieur DevOps et que DevOps est une culture de production, une insatisfaction a de nouveau surgi. Il est soudainement apparu que la livraison de logiciels est une tâche absolument non triviale. Chaque infrastructure de développement a sa propre pile, parfois il faut assembler, parfois déployer un environnement, ici on a besoin de Tomcat, là d'une méthode astucieuse pour lancer — en gros, la tête explose. Et le problème, curieusement, se trouve d'abord dans l'organisation des processus — cette fonction de livraison, comme un goulot d'étranglement, bloque les processus. De plus, l’exploitation (Operations) n'a pas disparu. Elle n'est pas visible dans le modèle en V, et il reste tout le cycle de vie à droite. Au final, il faut également maintenir l'infrastructure, surveiller, gérer les incidents, et en plus s'occuper de la livraison. Autrement dit, il faut être d'un côté dans le développement, de l'autre dans l'exploitation — et cela a donné un développement & opérations. Et là encore est arrivé le grand engouement pour les microservices. De plus, le développement a commencé à migrer des machines locales vers le cloud — essayez de déboguer quelque chose en local s'il y a des dizaines ou des centaines de microservices, la livraison continue devient alors un moyen de survie. Pour une « petite entreprise modeste », ça pourrait passer, mais tout de même ? Et Google ?
SRE de Google
Google est arrivé, a mangé les plus grands cactus et a décidé que cela ne lui convenait pas, qu'il avait besoin de fiabilité. Et la fiabilité doit être gérée. Il a donc décidé qu'il avait besoin de spécialistes pour gérer la fiabilité. Il les a appelés ingénieurs SRE et a dit : "Voici tout ce dont vous avez besoin, faites comme d'habitude, bien. Voici votre SLI, voici votre SLO, voici votre surveillance." Et il les a dirigés vers les opérations. Il a appelé son "DevOps fiable" SRE. Tout semblait en ordre, mais il y a un hack sale que Google pouvait se permettre : engager à des postes d'ingénieurs SRE des personnes ayant les qualifications de développeurs et qui avaient un peu bricolé chez eux en comprenant le fonctionnement des systèmes en cours d'exploitation. D'ailleurs, même Google a des problèmes à recruter ces gens, principalement parce qu'il se retrouve en concurrence avec lui-même — il faut bien qu'il y ait quelqu'un pour décrire la logique métier. La livraison a été confiée aux ingénieurs de release, les ingénieurs SRE gèrent la fiabilité (évidemment, pas directement, mais en influençant l'infrastructure, en changeant l'architecture, en surveillant les modifications et les indicateurs, et en s'occupant des incidents). C'est joli, on peut . Que faire si vous n'êtes pas Google, mais que la fiabilité vous préoccupe quand même ?
Le développement des idées DevOps
C'est là que Docker est arrivé, issu de lxc, suivi de divers systèmes d'orchestration comme Docker Swarm et Kubernetes, et les ingénieurs DevOps ont poussé un soupir de soulagement — l'unification des pratiques a facilité la livraison. Au point qu'il est devenu même possible de confier la livraison aux développeurs — qu'est-ce que c'est que ce deployment.yaml ? La conteneurisation résout le problème. Et la maturité des systèmes CI/CD est telle que l'on peut écrire un fichier et tout se met en route — les développeurs s'en sortent tout seuls. Et ici, nous commençons à parler de la manière de créer notre propre SRE, avec… même n'importe qui.
SRE n'est pas chez Google
Eh bien, la livraison est terminée, nous pouvons sembler respirer un peu, retourner aux bons vieux temps où les administrateurs surveillaient les charges des processeurs, optimisaient les systèmes et sirotaient tranquillement des breuvages mystérieux dans le calme et la tranquillité… Attendez. Ce n'est pas pour cela que nous nous sommes lancés (et c'est dommage !). Il apparaît soudainement qu'avec l'approche de Google, nous pouvons adopter d'excellentes pratiques — ce n'est pas la charge des processeurs qui est importante, ni à quelle fréquence nous remplaçons les disques, ou même comment nous optimisons les coûts dans le cloud, mais les métriques commerciales — tous ces SLx tant discutés. La gestion de l'infrastructure reste de mise, il faut gérer les incidents, être de garde de temps à autre, et en général, être au fait des processus d'affaires. Les gars, commencez à programmer progressivement à un bon niveau, Google vous attend déjà.
En résumé. Soudain, mais vous êtes déjà fatigué de lire et vous avez hâte d'écrire un commentaire à l'auteur de l'article. DevOps en tant que pratique de livraison a été, est et sera toujours. Et cela ne disparaîtra pas. SRE en tant qu'ensemble de pratiques d'exploitation rend cette livraison réussie.
Source : habr.com
