

Introduction
Bonjour. Cela fait déjà six mois que nous avons un script (ou plutôt un ensemble de scripts) qui génère des rapports sur l'état des machines virtuelles (et pas seulement). J'ai décidé de partager mon expérience de création et le code lui-même. J'attends vos critiques et j'espère que ce matériel pourra être utile à quelqu'un.
Formation du besoin
Nous avons beaucoup de machines virtuelles (environ 1500 VM réparties sur 3 vCenter). De nouvelles sont créées et d'anciennes supprimées assez fréquemment. Pour maintenir l'ordre, plusieurs champs personnalisés ont été ajoutés dans vCenter pour séparer les VM en sous-systèmes, indiquer si elles sont de test, ainsi que qui et quand les a créées. Le facteur humain a fait que plus de la moitié des machines sont restées avec des champs non remplis, ce qui compliquait le travail. Une fois tous les six mois, quelqu'un s'énervait, lançait un travail de mise à jour de ces données, mais le résultat devenait obsolète dans les deux semaines.
Je précise tout de suite que tout le monde comprend qu'il doit y avoir des demandes de création de machines, un processus pour leur création, etc. Et tout le monde suit ce processus à la lettre et tout est en ordre. Malheureusement, ce n'est pas notre cas, mais ce n'est pas le sujet de l'article 🙂
En gros, il a été décidé d'automatiser la vérification de la conformité des champs.
Nous avons décidé qu'un e-mail quotidien avec une liste des machines mal remplies à tous les ingénieurs responsables et à leurs supérieurs serait un bon début.
À ce moment-là, un de mes collègues avait déjà mis en place un script PowerShell qui, chaque jour selon un calendrier, collectait des informations sur toutes les machines de tous les vCenters et générait 3 documents csv (chacun pour son vCenter), qui étaient placés sur un disque partagé. Il a été décidé de prendre ce script comme base et de l'enrichir avec des vérifications en utilisant le langage R, avec lequel il y avait une certaine expérience.
Au cours du développement, la solution a été enrichie d'une notification par e-mail, d'une base de données avec une table principale et historique (nous en parlerons plus tard), ainsi que de l'analyse des journaux vSphere pour rechercher les créateurs réels des VM et le moment de leur création.
Pour le développement, nous avons utilisé les IDE RStudio Desktop et PowerShell ISE.
Le script est lancé depuis une machine virtuelle Windows standard.
Description de la logique générale.
La logique générale des scripts est la suivante.
- Nous collectons des données sur les machines virtuelles à l'aide d'un script PowerShell que nous appelons via R, et nous combinons les résultats en un seul fichier csv. L'interaction inverse entre les langages est réalisée de la même manière. (Nous aurions pu transmettre les données directement de R à PowerShell sous forme de variables, mais c'est compliqué, et disposer de fichiers csv intermédiaires facilite le débogage et le partage des résultats intermédiaires avec d'autres personnes).
- Avec R, nous générons des paramètres valides pour les champs dont nous vérifions les valeurs. — Nous créons un document Word qui contiendra les valeurs de ces champs à insérer dans un message d'information, qui répondra aux questions des collègues : "Comment dois-je remplir cela ?".
- Nous chargeons les données de toutes les VM à partir du csv avec R, formons un dataframe, supprimons les champs inutiles et élaborons un document xlsx d'information qui contiendra un résumé sur toutes les VM, que nous mettons à disposition sur une ressource commune.
- Nous appliquons toutes les vérifications de la validité des champs au dataframe de toutes les VM et formons un tableau contenant uniquement les VM avec des champs mal remplis (et uniquement ces champs).
- La liste de VM obtenue est envoyée à un autre script PowerShell, qui examinera les journaux de vCenter à la recherche d'événements de création de VM, ce qui permettra d'indiquer l'heure prévisible de création de la VM et le créateur présumé. C'est au cas où personne ne se déclarerait comme étant le propriétaire de la machine. Ce script fonctionne lentement, surtout s'il y a beaucoup de journaux, c'est pourquoi nous ne regardons que les deux dernières semaines et utilisons également un workflow qui permet de rechercher des informations sur plusieurs VM en même temps. L'exemple de script contient des commentaires détaillés sur ce mécanisme. Nous stockons le résultat dans un csv que nous chargeons à nouveau dans R.
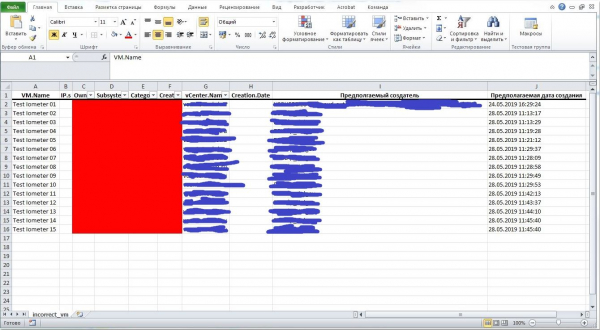
- Nous élaborons un document xlsx joliment formaté, dans lequel les champs mal remplis seront mis en évidence en rouge, des filtres seront appliqués à certaines colonnes, et des colonnes supplémentaires indiqueront les créateurs présumés et l'heure de création de la VM.
- Nous formons un e-mail dans lequel nous joignons un document décrivant les valeurs acceptables des champs, ainsi qu'un tableau avec les VM mal remplies. Dans le texte, nous indiquons le nombre total de VM mal créées, un lien vers la ressource générale et une image motivante. S'il n'y a pas de VM mal remplies, nous envoyons un autre e-mail avec une image motivante plus joyeuse.
- Nous enregistrons les données de toutes les VM dans une base de données SQL Server, en tenant compte du mécanisme des tables historiques (un mécanisme très intéressant – dont nous parlerons plus en détail ci-après).
En fait, les scripts.
Fichier principal avec le code en R.
# Путь к рабочей директории (нужно для корректной работы через виндовый планировщик заданий)
setwd("C:ScriptsgetVm")
#### Подгружаем необходимые пакеты ####
library(tidyverse)
library(xlsx)
library(mailR)
library(rmarkdown)
##### Определяем пути к исходным файлам и другие переменные #####
source(file = "const.R", local = T, encoding = "utf-8")
# Проверяем существование файла со всеми ВМ и удаляем, если есть.
if (file.exists(filenameVmCreationRules)) {file.remove(filenameVmCreationRules)}
#### Создаём вордовский документ с допустимыми полями
render("VM_name_rules.Rmd",
output_format = word_document(),
output_file = filenameVmCreationRules)
# Проверяем существование файла со всеми ВМ и удаляем, если есть
if (file.exists(allVmXlsxPath)) {file.remove(allVmXlsxPath)}
#### Забираем данные по всем машинам через PowerShell скрипт. На выходе получим csv.
system(paste0("powershell -File ", getVmPsPath))
# Полный df
fullXslx_df <- allVmXlsxPath %>%
read.csv2(stringsAsFactors = FALSE)
# Vérifions la validité des champs remplis
full_df <- fullXslx_df %>%
mutate(
# D'abord, supprimons tous les espaces et tabulations superflus, ensuite prenons en compte le séparateur virgule, puis vérifions la présence dans les valeurs acceptables,
isSubsystemCorrect = Subsystem %>%
gsub("[[:space:]]", "", .) %>%
str_split(., ",") %>%
map(function(x) (all(x %in% AllowedValues$Subsystem))) %>%
as.logical(),
isOwnerCorrect = Owner %in% AllowedValues$Owner,
isCategoryCorrect = Category %in% AllowedValues$Category,
isCreatorCorrect = (!is.na(Creator) & Creator != ''),
isCreation.DateCorrect = map(Creation.Date, IsDate)
)
# Vérifions l'existence du fichier avec toutes les VM et supprimons-le si nécessaire.
if (file.exists(filenameAll)) {file.remove(filenameAll)}
#### Formons un fichier xslx avec le rapport ####
# Données générales sur une feuille séparée
full_df %>% write.xlsx(file=filenameAll,
sheetName=names[1],
col.names=TRUE,
row.names=FALSE,
append=FALSE)
#### Formons un fichier xslx avec les champs mal remplis ####
# Formons df
incorrect_df <- full_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Creator,
Category,
Creation.Date,
isOwnerCorrect,
isSubsystemCorrect,
isCategoryCorrect,
isCreatorCorrect,
vCenter.Name) %>%
filter(isSubsystemCorrect == F |
isOwnerCorrect == F |
isCategoryCorrect == F |
isCreatorCorrect == F)
# Vérifions l'existence du fichier avec toutes les VM et supprimons-le si nécessaire.
if (file.exists(filenameIncVM)) {file.remove(filenameIncVM)}
# Sauvegardons la liste des VM avec des champs non remplis dans un csv
incorrect_df %>%
select(VM.Name) %>%
write_csv2(path = filenameIncVM, append = FALSE)
# Filtrons pour l'insertion dans l'e-mail
incorrect_df_filtered <- incorrect_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
)
# Comptons le nombre de lignes
numberOfRows <- nrow(incorrect_df)
#### Начало условия ####
# Дальше либо у нас есть неправильно заполненные поля, либо нет.
# Если есть - запускаем ещё один скрипт
if (numberOfRows > 0) {
# Vérifions l'existence du fichier avec les créateurs et supprimons-le si nécessaire.
if (file.exists(creatorsFilePath)) {file.remove(creatorsFilePath)}
# Exécutons le script PowerShell, qui trouvera les créateurs des VM trouvées. En sortie, nous aurons un csv.
system(paste0("powershell -File ", getCreatorsPath))
# Lisons le fichier avec les créateurs
creators_df <- creatorsFilePath %>%
read.csv2(stringsAsFactors = FALSE)
# Filtrons pour l'insertion dans l'e-mail, ajoutons les données du tableau avec les créateurs
incorrect_df_filtered <- incorrect_df_filtered %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
) %>%
left_join(creators_df, by = "VM.Name") %>%
rename(`Créateur présumé` = CreatedBy,
`Date de création présumée` = CreatedOn)
# Formons le corps de l'e-mail
emailBody <- paste0(
'<html>
<h3>Bonjour, chers collègues.</h3>
<p>Vous pouvez consulter l'ensemble des informations à jour sur les machines virtuelles sur le disque H : ici :<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Veuillez également trouver en pièce jointe la liste des machines virtuelles avec <strong>des champs remplis de manière incorrecte.</strong> Au total, il y en a <strong>',' + numberOfRows + '</strong>.</p>
<p>Deux colonnes supplémentaires ont été ajoutées à la table. <strong>Créateur présumé</strong> et <strong>Date de création présumée</strong>, qui sont extraites des journaux vCenter des deux dernières semaines.</p>
<p>Les créateurs des machines sont priés de vérifier les données et de remplir correctement les champs. Les règles de remplissage des champs se trouvent également en pièce jointe.</p>
<p><img src="data/meme.jpg"></p>
</html>'
)
# Vérifions l'existence du fichier
if (file.exists(filenameIncorrect)) {file.remove(filenameIncorrect)}
# Créons un tableau bien formaté avec les formats, etc.
source(file = "email.R", local = T, encoding = "utf-8")
#### Créons un e-mail avec les machines mal signées ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "VM avec des champs remplis de manière incorrecte",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
attach.files = c(filenameIncorrect, filenameVmCreationRules),
debug = FALSE)
#### Le bloc suivant se déroulera s'il n'y a pas de problèmes avec les VM ####
} else {
# Créons le corps de l'e-mail
emailBody <- paste0(
'<html>
<h3>Bonjour, chers collègues</h3>
<p>Vous pouvez consulter l'ensemble des informations à jour sur les machines virtuelles sur le disque H : ici :<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>De plus, à ce jour, tous les champs des VM sont correctement remplis.</p>
<p><img src="data/meme_correct.jpg"></p>
</html>'
)
#### Créons un e-mail sans VM mal remplies ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "Informations récapitulatives",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
debug = FALSE)
}
####### Enregistrons les données dans la base de données #####
source(file = "DB.R", local = T, encoding = "utf-8")
Script pour obtenir la liste des VM en PowerShell.
# Данные для подключения и другие переменные
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"

$filename = "C:ScriptsgetVmdataallvmall-vm-$(get-date -f yyyy-MM-dd).csv"

$destinationSMB = "server.rumyfolder$vm"
$IP0=""
$IP1=""
$IP2=""
$IP3=""
$IP4=""
$IP5=""

# Подключение ко всем vCenter, что содержатся в переменной. Будет работать, если логин и пароль одинаковые (например, доменные)
Connect-VIServer -Server $vCenterNames -User $vCenterUsername -Password $vCenterPassword

write-host ""

# Создаём функцию с циклом по всем vCenter-ам
function Get-VMinventory {

# В этой переменной будет списко всех ВМ, как объектов
$AllVM = Get-VM | Sort Name
$cnt = $AllVM.Count
$count = 1

# Начинаем цикл по всем ВМ и собираем необходимые параметры каждого объекта
   foreach ($vm in $AllVM) {
   $StartTime = $(get-date)

     $IP0 = $vm.Guest.IPAddress[0]
     $IP1 = $vm.Guest.IPAddress[1]
     $IP2 = $vm.Guest.IPAddress[2]
     $IP3 = $vm.Guest.IPAddress[3]
     $IP4 = $vm.Guest.IPAddress[4]
     $IP5 = $vm.Guest.IPAddress[5]

     If ($IP0 -ne $null) {If ($IP0.Contains(":") -ne 0) {$IP0=""}}
     If ($IP1 -ne $null) {If ($IP1.Contains(":") -ne 0) {$IP1=""}}
     If ($IP2 -ne $null) {If ($IP2.Contains(":") -ne 0) {$IP2=""}}
     If ($IP3 -ne $null) {If ($IP3.Contains(":") -ne 0) {$IP3=""}}
     If ($IP4 -ne $null) {If ($IP4.Contains(":") -ne 0) {$IP4=""}}
     If ($IP5 -ne $null) {If ($IP5.Contains(":") -ne 0) {$IP5=""}}

     $cluster = $vm | Get-Cluster | Select-Object -ExpandProperty name
     $Bootime = $vm.ExtensionData.Runtime.BootTime
     $TotalHDDs = $vm.ProvisionedSpaceGB -as [int]
     $CreationDate = $vm.CustomFields.Item("CreationDate") -as [string]
     $Creator = $vm.CustomFields.Item("Creator") -as [string]
     $Category = $vm.CustomFields.Item("Category") -as [string]
     $Owner = $vm.CustomFields.Item("Owner") -as [string]
     $Subsystem = $vm.CustomFields.Item("Subsystem") -as [string]

     $IPS = $vm.CustomFields.Item("IP") -as [string]

     $vCPU = $vm.NumCpu
     $CorePerSocket = $vm.ExtensionData.config.hardware.NumCoresPerSocket
     $Sockets = $vCPU/$CorePerSocket

     $Id = $vm.Id.Split('-')[2] -as [int]

     # Собираем все параметры в один объект
     $Vmresult = New-Object PSObject
     $Vmresult | add-member -MemberType NoteProperty -Name "Id" -Value $Id
     $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
     $Vmresult | add-member -MemberType NoteProperty -Name "Cluster" -Value $cluster
     $Vmresult | add-member -MemberType NoteProperty -Name "Esxi Host" -Value $VM.VMHost
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 1" -Value $IP0
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 2" -Value $IP1
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 3" -Value $IP2
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 4" -Value $IP3
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 5" -Value $IP4
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 6" -Value $IP5
     $Vmresult | add-member -MemberType NoteProperty -Name "vCPU" -Value $vCPU
     $Vmresult | Add-Member -MemberType NoteProperty -Name "CPU Sockets" -Value $Sockets
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Core per Socket" -Value $CorePerSocket
     $Vmresult | add-member -MemberType NoteProperty -Name "RAM (GB)" -Value $vm.MemoryGB
     $Vmresult | add-member -MemberType NoteProperty -Name "Total-HDD (GB)" -Value $TotalHDDs
     $Vmresult | add-member -MemberType NoteProperty -Name "Power State" -Value $vm.PowerState
     $Vmresult | add-member -MemberType NoteProperty -Name "OS" -Value $VM.ExtensionData.summary.config.guestfullname
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Boot Time" -Value $Bootime
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Status" -Value $vm.ExtensionData.Guest.ToolsStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version" -Value $vm.ExtensionData.Guest.ToolsVersion
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version Status" -Value $vm.ExtensionData.Guest.ToolsVersionStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Running Status" -Value $vm.ExtensionData.Guest.ToolsRunningStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "Creation Date" -Value $CreationDate
     $Vmresult | add-member -MemberType NoteProperty -Name "Creator" -Value $Creator
     $Vmresult | add-member -MemberType NoteProperty -Name "Category" -Value $Category
     $Vmresult | add-member -MemberType NoteProperty -Name "Owner" -Value $Owner
     $Vmresult | add-member -MemberType NoteProperty -Name "Subsystem" -Value $Subsystem
     $Vmresult | add-member -MemberType NoteProperty -Name "IP's" -Value $IPS
     $Vmresult | add-member -MemberType NoteProperty -Name "vCenter Name" -Value $vm.Uid.Split('@')[1].Split(':')[0]

# Считаем общее и оставшееся время выполнения и выводим на экран результаты. Использовалось для тестирования, но по факту оказалось очень удобно.
     $elapsedTime = $(get-date) - $StartTime
     $totalTime = "{0:HH:mm:ss}" -f ([datetime]($elapsedTime.Ticks*($cnt - $count)))

     clear-host
     Write-Host "Processing" $count "from" $cnt
     Write-host "Progress:" ([math]::Round($count/$cnt*100, 2)) "%"
     Write-host "You have about " $totalTime "for cofee"
     Write-host ""

     $count++

# Выводим результат, чтобы цикл "знал" что является результатом выполнения одного прохода
     $Vmresult
   }

}

# Вызываем получившуюся функцию и сразу выгружаем результат в csv
$allVm = Get-VMinventory | Export-CSV -Path $filename -NoTypeInformation -UseCulture -Force

# Пытаемся выложить полученный файл в нужное нам место и, в случае ошибки, пишем лог.
try
    {
        Copy-Item $filename -Destination $destinationSMB -Force -ErrorAction SilentlyContinue
    }
catch
    {
        $error | Export-CSV -Path $filename".error" -NoTypeInformation -UseCulture -Force
    }
Script en PowerShell, extrayant des journaux les créateurs de machines virtuelles et les dates de leur création.
# Путь к файлу, из которого будем доставать список VM
$VMfilePath = "C:ScriptsgetVmcreators_VMcreators_VM_$(get-date -f yyyy-MM-dd).csv"
# Путь к файлу, в который будем записывать результат
$filePath = "C:ScriptsgetVmdatacreatorscreators-$(get-date -f yyyy-MM-dd).csv"

# Создаём вокрфлоу
Workflow GetCreators-Wf
{
    # Параметры, которые можно будет передать при вызове скрипта
    param([string[]]$VMfilePath)

# Параметры, которые доступны только внутри workflow
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"
$daysToLook = 14
$start = (get-date).AddDays(-$daysToLook)
$finish = get-date
# Значения, которые будут вписаны в csv для машин, по которым не будет ничего найдено
$UnknownUser = "UNKNOWN"
$UnknownCreatedTime = "0000-00-00"

# Определяем параметры подключения и выводной файл, которые будут доступны во всём скрипте.
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )

# Получаем список VM из csv и загружаем соответствующие объекты
$list = Import-Csv $VMfilePath -UseCulture | select -ExpandProperty VM.Name

# Цикл, который будет выполняться параллельно (по 5 машин за раз)
foreach -parallel ($row in $list)
  {
    # Это скрипт, который видит только свои переменные и те, которые ему переданы через $Using
    InlineScript {

    # Время начала выполнения отдельного блока
        $StartTime = $(get-date)

        Write-Host ""
        Write-Host "Processing $Using:row started at $StartTime"
        Write-Host ""

        # Подключение оборачиваем в переменную, чтобы информация о нём не мешалась в консоли
        $con = Connect-VIServer -Server $Using:vCenterNames -User $Using:vCenterUsername -Password $Using:vCenterPassword

        # Получаем объект vm
        $vm = Get-VM -Name $Using:row

      # Ниже 2 одинаковые команды. Одна с фильтром по времени, вторая - без. Можно пользоваться тем,
      $Event = $vm | Get-VIEvent -Start $Using:start -Finish $Using:finish -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}
      # $Event = $vm | Get-VIEvent -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}

      # Заполняем параметры в зависимости от того, удалось ли в логах найти что-то
      If (($Event | Measure-Object).Count -eq 0){
         $User = $Using:UnknownUser
         $Created = $Using:UnknownCreatedTime
         $CreatedFormat = $Using:UnknownCreatedTime
      } Else {
         If ($Event.Username -eq "" -or $Event.Username -eq $null) {
            $User = $Using:UnknownUser
         } Else {
         $User = $Event.Username
         } # Else
            $CreatedFormat = $Event.CreatedTime
            # Один из коллег отдельно просил, чтобы время было в таком формате, поэтому дублируем его. А в БД пойдёт нормальный формат.
            $Created = $Event.CreatedTime.ToString('yyyy-MM-dd')
         } # Else

      Write-Host "Creator for $vm is $User. Creating object."

      # Создаём объект. Добавляем параметры.
      $Vmresult = New-Object PSObject
      $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedBy" -Value $User
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOn" -Value $CreatedFormat
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOnFormat" -Value $Created
      # Выводим результаты
      $Vmresult

    } # Inline

} # ForEach

}

$Creators = GetCreators-Wf $VMfilePath
# Записываем результат в файл
$Creators | select 'VM Name', CreatedBy, CreatedOn | Export-Csv -Path $filePath -NoTypeInformation -UseCulture -Force

Write-Host "CSV generetion finisghed at $(get-date). PROFIT"
Une attention particulière doit être accordée à la bibliothèque. , qui a permis de rendre la pièce jointe à l'e-mail visuellement formatée (comme le management aime), et non simplement un tableau csv.
Génération d'un joli document xlsx avec la liste des machines mal remplies.
# Создаём новую книгу
# Возможные значения : "xls" и "xlsx"
wb<-createWorkbook(type="xlsx")

# Стили для имён рядов и колонок в таблицах
TABLE_ROWNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE)
TABLE_COLNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE) +
  Alignment(wrapText=TRUE, horizontal="ALIGN_CENTER") +
  Border(color="black", position=c("TOP", "BOTTOM"),
         pen=c("BORDER_THIN", "BORDER_THICK"))

# Создаём новый лист
sheet <- createSheet(wb, sheetName = names[2])

# Добавляем таблицу
addDataFrame(incorrect_df_filtered,
             sheet, startRow=1, startColumn=1,  row.names=FALSE, byrow=FALSE,
             colnamesStyle = TABLE_COLNAMES_STYLE,
             rownamesStyle = TABLE_ROWNAMES_STYLE)

# Меняем ширину, чтобы форматирование было автоматическим
autoSizeColumn(sheet = sheet, colIndex=c(1:ncol(incorrect_df)))

# Добавляем фильтры
addAutoFilter(sheet, cellRange = "C1:G1")

# Определяем стиль
fo2 <- Fill(foregroundColor="red")
cs2 <- CellStyle(wb,
                 fill = fo2,
                 dataFormat = DataFormat("@"))

# Находим ряды с неверно заполненным полем Владельца и применяем к ним определённый стиль
rowsOwner <- getRows(sheet, rowIndex = (which(!incorrect_df$isOwnerCorrect) + 1))
cellsOwner <- getCells(rowsOwner, colIndex = which( colnames(incorrect_df_filtered) == "Owner" ))
lapply(names(cellsOwner), function(x) setCellStyle(cellsOwner[[x]], cs2))

# Находим ряды с неверно заполненным полем Подсистемы и применяем к ним определённый стиль
rowsSubsystem <- getRows(sheet, rowIndex = (which(!incorrect_df$isSubsystemCorrect) + 1))
cellsSubsystem <- getCells(rowsSubsystem, colIndex = which( colnames(incorrect_df_filtered) == "Subsystem" ))
lapply(names(cellsSubsystem), function(x) setCellStyle(cellsSubsystem[[x]], cs2))

# Аналогично по Категории
rowsCategory <- getRows(sheet, rowIndex = (which(!incorrect_df$isCategoryCorrect) + 1))
cellsCategory <- getCells(rowsCategory, colIndex = which( colnames(incorrect_df_filtered) == "Category" ))
lapply(names(cellsCategory), function(x) setCellStyle(cellsCategory[[x]], cs2))

# Создатель
rowsCreator <- getRows(sheet, rowIndex = (which(!incorrect_df$isCreatorCorrect) + 1))
cellsCreator <- getCells(rowsCreator, colIndex = which( colnames(incorrect_df_filtered) == "Creator" ))
lapply(names(cellsCreator), function(x) setCellStyle(cellsCreator[[x]], cs2))

# Сохраняем файл
saveWorkbook(wb, filenameIncorrect)
En sortie, cela ressemble à ceci :
Il y avait aussi un point intéressant concernant la configuration du planificateur Windows. Il était impossible de trouver les bons paramètres de droits et de configuration pour que tout fonctionne comme prévu. Finalement, une bibliothèque R a été trouvée, qui crée elle-même une tâche pour exécuter le script R et n'oublie même pas le fichier pour les journaux. Ensuite, il est possible de corriger manuellement la tâche.
Un extrait de code en R avec deux exemples, qui crée une tâche dans le planificateur Windows.
library(taskscheduleR)
myscript <- file.path(getwd(), "all_vm.R")

## exécute le script dans 62 secondes
taskscheduler_create(taskname = "getAllVm", rscript = myscript,
                     schedule = "ONCE", starttime = format(Sys.time() + 62, "%H:%M"))

## exécute le script tous les jours à 09:10
taskscheduler_create(taskname = "getAllVmDaily", rscript = myscript,
                     schedule = "WEEKLY",
                     days = c("MON", "TUE", "WED", "THU", "FRI"),
                     starttime = "02:00")

## supprime les tâches
taskscheduler_delete(taskname = "getAllVm")
taskscheduler_delete(taskname = "getAllVmDaily")

# Consultez les journaux (les 4 dernières lignes)
tail(readLines("all_vm.log"), sep ="n", n = 4)
À propos de la base de données.
Après la configuration du script, d'autres questions ont commencé à se poser. Par exemple, je voulais trouver la date à laquelle VM a été supprimée, alors que les journaux dans vCenter avaient déjà disparu. Puisque le script dépose des fichiers dans un dossier chaque jour et ne les nettoie pas (nous nettoyons à la main quand nous y pensons), il est possible de consulter les anciens fichiers et de trouver le premier fichier dans lequel cette VM n'existe pas. Mais ce n'est pas idéal.
J'ai voulu créer une base de données historique.
La fonctionnalité de MS SQL SERVER a aidé — la table temporelle versionnée. Cela se traduit généralement par des tables temporelles (et non des tables temps).
Vous pouvez lire en détail dans .
En résumé, nous créons une table, nous indiquons qu'elle sera versionnée et SQL Server crée deux colonnes datetime supplémentaires dans cette table (la date de création de l'enregistrement et la date de fin de vie de l'enregistrement) ainsi qu'une table supplémentaire où les modifications seront enregistrées. En conséquence, nous obtenons des informations actuelles et, par des requêtes simples, dont des exemples sont fournis dans la documentation, nous pouvons voir soit le cycle de vie d'une machine virtuelle spécifique, soit l'état de toutes les VM à un moment donné.
En termes de performance, la transaction d'écriture dans la table principale ne sera pas terminée tant que la transaction d'écriture dans la table temporelle ne sera pas terminée. Cela signifie que sur des tables avec un grand nombre d'opérations d'écriture, cette fonctionnalité doit être implémentée avec prudence, mais dans notre cas, c'est vraiment quelque chose de très intéressant.
Pour que le mécanisme fonctionne correctement, j'ai dû écrire un petit morceau de code en R qui comparerait la nouvelle table avec les données de toutes les VM avec celle stockée dans la BD et n'écrirait que les lignes modifiées. Le code n'est pas très complexe, utilise la bibliothèque compareDF, mais je le fournirai aussi ci-dessous.
Code en R pour écrire des données dans la BD
# Подцепляем пакеты
library(odbc)
library(compareDF)

# Формируем коннект
con <- dbConnect(odbc(),
                 Driver = "ODBC Driver 13 for SQL Server",
                 Server = DBParams$server,
                 Database = DBParams$database,
                 UID = DBParams$UID,
                 PWD = DBParams$PWD,
                 Port = 1433)

#### Проверяем есть ли таблица. Если нет - создаём. ####

if (!dbExistsTable(con, DBParams$TblName)) {
  #### Создаём таблицу ####
  create <- dbSendStatement(
    con,
    paste0(
      'CREATE TABLE ',
      DBParams$TblName,
      '(
    [Id] [int] NOT NULL PRIMARY KEY CLUSTERED,
    [VM.Name] [varchar](255) NULL,
    [Cluster] [varchar](255) NULL,
    [Esxi.Host] [varchar](255) NULL,
    [IP.Address.1] [varchar](255) NULL,
    [IP.Address.2] [varchar](255) NULL,
    [IP.Address.3] [varchar](255) NULL,
    [IP.Address.4] [varchar](255) NULL,
    [IP.Address.5] [varchar](255) NULL,
    [IP.Address.6] [varchar](255) NULL,
    [vCPU] [int] NULL,
    [CPU.Sockets] [int] NULL,
    [Core.per.Socket] [int] NULL,
    [RAM..GB.] [int] NULL,
    [Total.HDD..GB.] [int] NULL,
    [Power.State] [varchar](255) NULL,
    [OS] [varchar](255) NULL,
    [Boot.Time] [varchar](255) NULL,
    [VMTools.Status] [varchar](255) NULL,
    [VMTools.Version] [int] NULL,
    [VMTools.Version.Status] [varchar](255) NULL,
    [VMTools.Running.Status] [varchar](255) NULL,
    [Creation.Date] [varchar](255) NULL,
    [Creator] [varchar](255) NULL,
    [Category] [varchar](255) NULL,
    [Owner] [varchar](255) NULL,
    [Subsystem] [varchar](255) NULL,
    [IP.s] [varchar](255) NULL,
    [vCenter.Name] [varchar](255) NULL,
    DateFrom datetime2 GENERATED ALWAYS AS ROW START NOT NULL,
    DateTo datetime2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (DateFrom, DateTo)
        ) ON [PRIMARY]
        WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = ', DBParams$TblHistName,'));'
    )
  )

  # Отправляем подготовленный запрос
  dbClearResult(create)

} # if

#### Начало работы с таблицей ####

# Обозначаем таблицу, с которой будем работать
allVM_db_con <- tbl(con, DBParams$TblName)

#### Сравниваем таблицы ####

# Собираем данные с таблицы (убираем служебные временные поля)
allVM_db <- allVM_db_con %>%
  select(c(-"DateTo", -"DateFrom")) %>%
  collect()

# Создаём таблицу со сравнением объектов. Сравниваем по Id
# Удалённые объекты там будут помечены через -, созданные через +, изменённые через - и +
ctable_VM <- fullXslx_df %>%
  compare_df(allVM_db,
             c("Id"))

#### Удаление строк ####

# Выдираем Id виртуалок, записи о которых надо удалить
remove_Id <- ctable_VM$comparison_df %>%
  filter(chng_type == "-") %>%
  select(Id)

# Проверяем, что есть записи (если записей нет - и удалять ничего не нужно)
if (remove_Id %>% nrow() > 0) {

  # Конструируем шаблон для запроса на удаление данных
  delete <- dbSendStatement(con,
                        paste0('
                               DELETE
                               FROM ',
                               DBParams$TblName,
                               ' WHERE "Id"=?
                               ') # paste
                        ) # send

  # Создаём запрос на удаление данных
  dbBind(delete, remove_Id)

  # Отправляем подготовленный запрос
  dbClearResult(delete)

} # if

#### Добавление строк ####

# Выделяем таблицу, содержащую строки, которые нужно добавить.
allVM_add <- ctable_VM$comparison_df %>%
  filter(chng_type == "+") %>%
  select(-chng_type)

# Проверяем, есть ли строки, которые нужно добавить и добавляем (если нет - не добавляем)
if (allVM_add %>% nrow() > 0) {
  # Пишем таблицу со всеми необходимыми данными
  dbWriteTable(con,
               DBParams$TblName,
               allVM_add,
               overwrite = FALSE,
               append = TRUE)

} # if

#### Не забываем сделать дисконнект ####
dbDisconnect(con)
Au total
Grâce à l'implémentation du script, un ordre a été établi et est maintenu depuis plusieurs mois. Parfois, des VM mal remplies apparaissent, mais le script sert de bon rappel et il est rare qu'une VM figure sur la liste pendant 2 jours consécutifs.
Une base a également été posée pour l'analyse des données historiques.
Il est évident que beaucoup de cela pourrait être réalisé non pas "à la main", mais avec un logiciel spécialisé, mais la tâche était intéressante et, on peut dire, facultative.
R a montré une fois de plus qu'il s'agit d'un langage universel remarquable, qui convient non seulement à la résolution de problèmes statistiques, mais qui sert également de superbe "intermédiaire" entre d'autres sources de données.
Source : habr.com
