

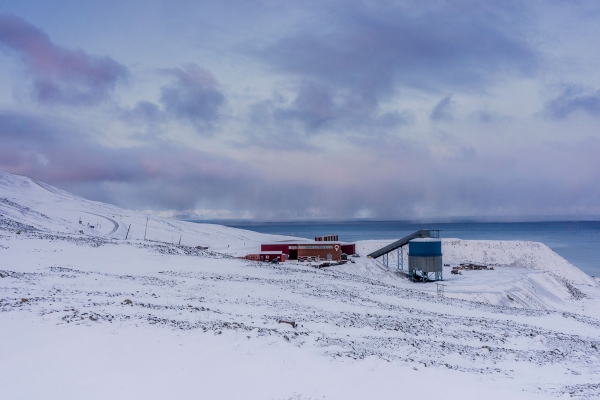
Une ancienne mine de charbon, qui accueillera le dépôt Arctic World Archive. : Guy Martin / Bloomberg Businessweek
Le logiciel libre est la pierre angulaire de notre civilisation moderne et un héritage commun de l'humanité. La mission est de préserver ce code pour les générations futures, afin que l'histoire de la bibliothèque d'Alexandrie ne se répète jamais.
Pour ce faire, GitHub mettra en place de nombreuses copies de sauvegarde sur différents supports, y compris un stockage à long terme. sur l'archipel de Svalbard. Il est situé dans une ancienne mine de charbon à 250 mètres de profondeur dans le permafrost et est conçu pour une durée de conservation d'au moins 1000 ans.
Une capture du code humain sera réalisée le 2 février 2020..
Le projet de stockage à long terme est lancé en collaboration avec la Long Now Foundation, l'Internet Archive, la Software Heritage Foundation, l'Arctic World Archive et d'autres partenaires.
Le projet LOCKSS
Un code vital aujourd'hui peut être oublié ou perdu avec le temps. Ce qui est le plus inquiétant, c'est qu'en cas de catastrophe mondiale, nous pourrions perdre toutes les informations conservées sur des supports 'éphémères' : HDD, SSD, CD et DVD, qui ne sont conçus que pour quelques décennies, ou sur des bandes, dont la durée de vie conditionnelle de 30 ans exige un contrôle strict de la température et de l'humidité.
La solution à ce problème est de dupliquer les sauvegardes, c'est-à-dire d'archiver le logiciel par plusieurs organisations et sous différentes formes. Ce projet, intitulé a été lancé il y a presque En mai 2019, le programme a été présenté comme le premier prototype de logiciel pour la sauvegarde distribuée de données à long terme, avec le soutien de nombreux participants et de stockages externes.
Les développeurs du système partent du principe que le matériel peut être beaucoup plus durable que les supports éphémères : il 'existe donc toute une série de scénarios d'avenir dans lesquels des ordinateurs modernes fonctionnent, mais leur logiciel est largement perdu'.
GitHub rappelle de nombreuses technologies perdues qui auraient pu être utiles : (sa recette n'a été redécouverte qu'en 2014), , perdu. . Il est facile d'imaginer un avenir où les logiciels d'aujourd'hui seront considérés comme des curiosités obsolètes, jusqu'à ce qu'un besoin inattendu se présente : « Comme toute sauvegarde, le programme d'archivage GitHub est également destiné à un avenir imprévisible », indique le site du programme GitHub Archive.
GitHub Archive
GitHub Archive propose trois niveaux de sauvegardes :
- À chaud: presque en temps réel
- À tiède: se met à jour tous les mois à l'année
- À froid: se met à jour tous les 5 ans ou plus
Après toute action des utilisateurs de GitHub, toutes les données Git sont répliquées dans plusieurs centres de données à travers le monde. Les sauvegardes de Git, les issues, les pull requests et toutes les données des utilisateurs sur GitHub sont conservées à plusieurs endroits. Ces informations sont accessibles en temps réel via l'API GitHub.
De plus, un indexage récursif est organisé par le crawler GHTorrent, qui publiera des archives sur une base quotidienne ou mensuelle. Des snapshots des archives peuvent être obtenus via des requêtes BigQuery. D'autres copies du code sont hébergées dans la célèbre « Machine à remonter le temps » de l'Internet Archive, qui conserve des copies à plusieurs endroits. Enfin, la Software Heritage Foundation scannera régulièrement GitHub et ajoutera ses dépôts publics à son archive, pour lequel un API publique est disponible.
L'archive arctique de GitHub
Le 2 février 2020, GitHub fera une copie de tous les dépôts publics actifs et les stockera dans l'archive arctique de GitHub.
Les données seront stockées sur des bobines de film de 3500 pieds, fournies par la société norvégienne Piql, spécialisée dans la conservation à long terme des données. Selon les mesures de l'ISO, ce film à halogénure d'argent dans un polyéther a une durée de vie de 500 ans. Les tests de vieillissement simulé ont montré que le film Piql préserve l'information pendant au moins deux fois plus longtemps.
De plus, GitHub Archive collabore avec des chercheurs du projet Microsoft Silica pour enregistrer tous les dépôts publics sur des plaques de verre quartz à l'aide d'un laser femtoseconde. Ce support garantira la conservation des données pendant plus de 10 000 ans.
Le stockage de code GitHub est créé sur la base de l'Arctic World Archive (AWA) à une profondeur de 250 mètres dans le pergélisol. L'archive se trouve dans une ancienne mine de charbon sur l'archipel du Svalbard, pas très loin du pôle Nord. Le réchauffement climatique n'affectera que quelques mètres de pergélisol et ne menace pas la mine dans un avenir proche (quelques milliers d'années).
Le Svalbard est réglementé en tant que zone démilitarisée. C'est l'un des établissements humains les plus reculés et géopolitiquement stables de la Terre, selon GitHub. Non loin se trouve également le célèbre Réservoir mondial de semences, le principal espoir de l'humanité en cas d'apocalypse.
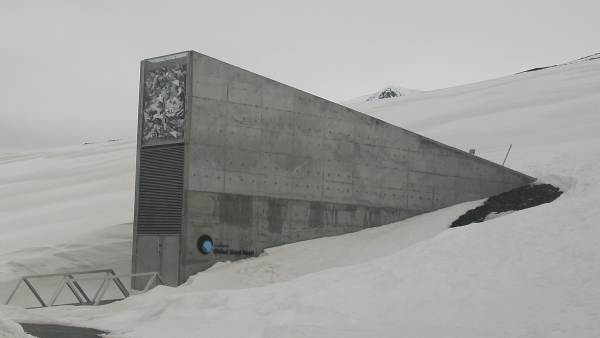
Le Réservoir mondial de semences du Svalbard
AWA est une initiative conjointe entre la société d'extraction minière norvégienne Norske Spitsbergen Kulkompani (SNSK) et le fournisseur de conservation numérique Piql AS. Des données historiques et culturelles d'Italie, du Brésil, de Norvège, du Vatican et d'autres pays y sont déjà conservées.
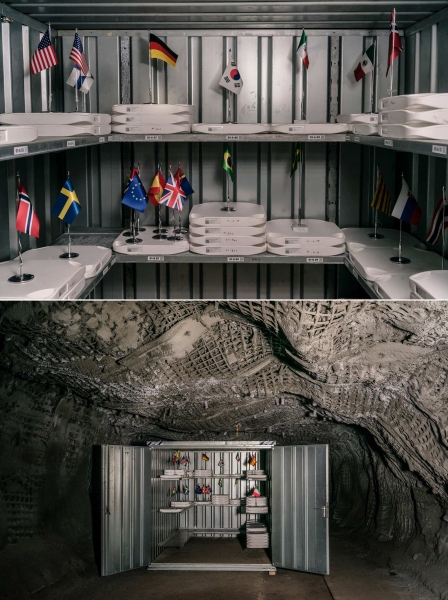
: Guy Martin / Bloomberg Businessweek
Les bobines de code GitHub seront stockées dans un conteneur à parois en acier à l'intérieur d'une chambre hermétique. La capture du 02.02.2020 comprendra tous les dépôts actifs de GitHub et une partie significative des dépôts inactifs (selon les étoiles, les dépendances, etc.), tous les fichiers binaires jusqu'à 100 Ko. Chaque dépôt sera dans un fichier tar séparé. Tout doit tenir sur 200 bobines de 120 Go.
Avec l'archive, un catalogue lisible par l'homme et des manuels techniques sur la déchiffrage des QR, les formats de fichiers, les encodages de caractères et d'autres métadonnées importantes seront inclus, afin que les descendants puissent convertir les données de nouveau en code source.
L'archive inclura également un guide général Tech Tree au cas où les futurs lecteurs n'auraient plus d'ordinateurs fonctionnels et devraient reconstruire les technologies depuis le début.
Source : habr.com
