

Le thème des pannes majeures dans les centres de données modernes soulève des questions auxquelles le premier article n'a pas répondu - nous avons décidé de l'approfondir.
Si l'on en croit les statistiques de l'Uptime Institute, la majorité des incidents dans les centres de données sont liés à des pannes du système d'alimentation électrique - celles-ci représentent 39 % des incidents. Viennent ensuite les erreurs humaines, qui représentent encore 24 % des pannes. La troisième cause la plus significative (15 %) concernait les pannes des systèmes de climatisation, et à la quatrième place (12 %) se trouvaient les catastrophes naturelles. La part totale des autres problèmes ne représente que 10 %. Sans remettre en question les données de cette organisation respectée, mettons en lumière ce que les différentes pannes ont en commun et essayons de comprendre si elles pouvaient être évitées. Spoiler : dans la plupart des cas, oui.
La science des contacts
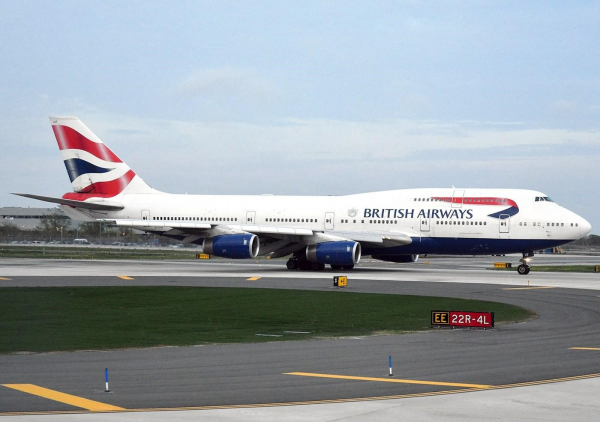
Pour faire simple, il n'y a que deux problèmes possibles avec l'alimentation électrique : soit il n'y a pas de contact là où il devrait y en avoir, soit il y en a là où il ne devrait pas y en avoir. On peut longuement discuter de la fiabilité des systèmes d'alimentation sans interruption modernes, mais ils ne sauvent pas toujours. Prenons par exemple le célèbre cas du centre de données de British Airways, appartenant à la société mère International Airlines Group, situé à proximité de l'aéroport d'Heathrow avec deux de ces installations - Boadicea House et Comet House. Dans la première, le 27 mai 2017, une panne d'alimentation accidentelle a eu lieu, entraînant une surcharge et une panne du système d'alimentation sans interruption. En fin de compte, une partie du matériel informatique a été physiquement endommagée, et il a fallu trois jours pour résoudre cette panne.
La compagnie aérienne a dû annuler ou reporter plus d'un millier de vols, environ 75 000 passagers n'ont pas pu décoller à temps - le montant des compensations s'est élevé à 128 millions de dollars, sans compter les coûts nécessaires pour rétablir le fonctionnement des centres de données. Les raisons de cette panne restent floues. Si l'on en croit les résultats de l'enquête interne annoncés par le directeur général d'International Airlines Group, Willie Walsh, elle serait due à une erreur des ingénieurs. Cependant, le système d'alimentation sans interruption aurait dû supporter une telle panne - c'est à cela qu'il a été conçu. Les centres de données étaient gérés par des spécialistes de la société d'externalisation CBRE Managed Services, c'est pourquoi British Airways a tenté de récupérer le montant des dommages par le biais des tribunaux de Londres.
Les pannes d'alimentation se produisent selon des scénarios similaires : d'abord, il y a une coupure due au fournisseur d'électricité, parfois à cause de mauvaises conditions météorologiques ou de problèmes internes (y compris des erreurs du personnel), puis le système d'alimentation sans interruption ne peut plus supporter la charge, ou une interruption brève de la sinusoïde entraîne des pannes de nombreux services, nécessitant une multitude de temps et d'argent pour rétablir leur fonctionnement. Peut-on éviter de telles pannes ? Absolument. Si l'on conçoit le système correctement, cependant, les erreurs ne sont pas à l'abri même des créateurs de grands centres de données.
Facteur humain
Lorsque la cause directe d'un incident est due à des actions incorrectes du personnel du centre de données, les problèmes touchent le plus souvent (mais pas toujours) la partie logicielle de l'infrastructure IT. De tels incidents se produisent même dans de grandes entreprises. En février 2017, en raison d'une commande incorrecte d'un membre de l'équipe des opérations techniques d'un des centres de données, une partie des serveurs Amazon Web Services a été désactivée. L'erreur s'est produite lors du débogage du processus de facturation des clients du stockage en cloud Amazon Simple Storage Service (S3). L'employé essayait de supprimer un certain nombre de serveurs virtuels utilisés par le système de facturation, mais a touché un cluster plus important.
En conséquence de l'erreur de l'ingénieur, des serveurs hébergeant des modules logiciels importants du stockage en cloud Amazon ont été supprimés. En premier lieu, le sous-système d'indexation, contenant des informations sur les métadonnées et la localisation de tous les objets S3 dans la région américaine US-EAST-1, a été touché. L'incident a également affecté le sous-système utilisé pour stocker les données et gérer l'espace de stockage disponible. Après la suppression des machines virtuelles, ces deux sous-systèmes ont nécessité un redémarrage complet, et les ingénieurs d'Amazon ont ensuite été confrontés à une surprise : pendant une longue période, le stockage en cloud public n'a pas pu traiter les requêtes des clients.
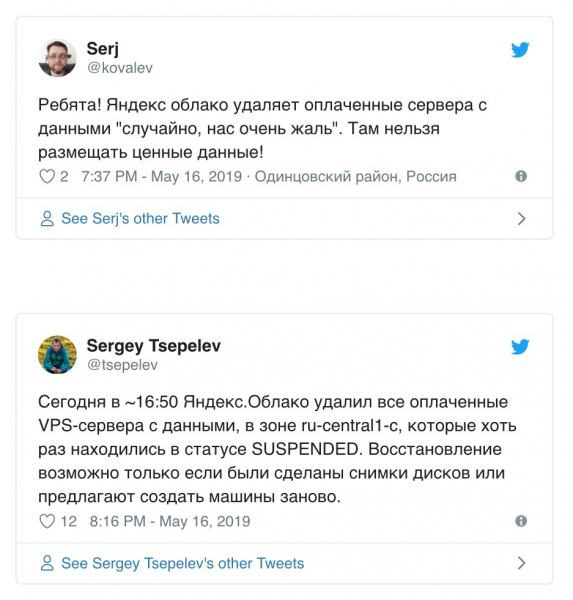
L'effet a été de grande ampleur, car de nombreux grands sites utilisent Amazon S3. Les pannes ont affecté Trello, Coursera, IFTTT et, ce qui est le plus préoccupant, les services de grands partenaires d'Amazon figurant sur la liste S&P 500. Il est difficile d'évaluer les pertes dans de tels cas, mais elles se chiffrent à plusieurs centaines de millions de dollars américains. Comme vous pouvez le constater, il suffit d'une seule commande incorrecte pour paralyser le service de la plus grande plateforme cloud. Ce n'est pas un cas isolé, le 16 mai 2019, lors de travaux de maintenance, le service Yandex.Cloud les machines virtuelles des utilisateurs dans la zone ru-central1-c, qui ont déjà été en statut SUSPENDED au moins une fois. Des données clients ont déjà été compromises, dont une partie a été irrémédiablement perdue. Bien sûr, les gens ne sont pas parfaits, mais les systèmes modernes de sécurité de l'information savent depuis longtemps contrôler les actions des utilisateurs privilégiés avant l'exécution des commandes qu'ils ont entrées. Si des solutions similaires étaient mises en œuvre chez Yandex ou Amazon, de tels incidents pourraient être évités.
Cooling gelé
En janvier 2017, un grave incident s'est produit dans le centre de données de Dmitrov de l'entreprise «Megafon». À cette époque, la température dans la région de Moscou est tombée à −35 °C, ce qui a entraîné une défaillance du système de refroidissement de l'installation. Le service de presse de l'opérateur a été particulièrement avare de détails sur les causes de l'incident — les entreprises russes parlent généralement très peu des accidents sur leurs propriétés, et en termes de transparence, nous sommes largement en retard par rapport à l'Occident. Sur les réseaux sociaux, une théorie circulait selon laquelle le fluide caloporteur avait gelé dans les tuyaux enterrés dans la rue, entraînant une fuite d'éthylène glycol. Si l'on en croit cette théorie, le service d'exploitation n'a pas pu obtenir rapidement 30 tonnes de fluide caloporteur en raison des longs congés, et a dû improviser en utilisant des moyens de fortune, organisant un refroidissement improvisé en violation des règles d'exploitation du système. Les fortes gelées ont aggravé le problème — en janvier, un hiver inattendu a soudainement frappé la Russie, bien que personne ne l'attendait. En fin de compte, le personnel a dû couper l'alimentation de certaines rangées de serveurs, ce qui a rendu certains services de l'opérateur inaccessibles pendant deux jours.
On peut probablement parler d'une anomalie climatique ici, mais de telles températures glaciales ne sont pas inhabituelles pour la région métropolitaine. En hiver, la température en périphérie de Moscou peut descendre à des niveaux encore plus bas, c'est pourquoi les centres de données sont construits pour fonctionner de manière fiable à −42 °C. Le plus souvent, les systèmes de refroidissement tombent en panne par temps froid en raison d'une concentration insuffisante de fluides glycols et d'un excès d'eau dans le liquide de refroidissement. Il y a aussi des problèmes liés à l'installation des tuyaux ou à des erreurs de conception et de test du système, principalement à cause du désir d'économiser. En fin de compte, cela peut entraîner des accidents graves qui pourraient aisément être évités.
Catastrophes naturelles
Le plus souvent, les tempêtes et/ou ouragans perturbent le fonctionnement de l'infrastructure technique du centre de données, ce qui entraîne l'arrêt des services et/ou des dommages physiques à l'équipement. Les incidents provoqués par des conditions météorologiques défavorables se produisent assez fréquemment. En 2012, l'ouragan Sandy a frappé la côte ouest des États-Unis avec de fortes pluies. Le centre de données Peer 1, situé dans un immeuble de grande hauteur à Lower Manhattan, , après que l'eau de mer salée a inondé les sous-sols. Les générateurs de secours de l'établissement étaient situés au 18e étage, et leur réserve de carburant était limitée — les règles mises en place à New York après les attentats du 11 septembre interdisent de stocker une grande quantité de carburant aux étages supérieurs.
La pompe à carburant est également tombée en panne, ce qui a obligé le personnel à transporter manuellement du diesel pour les générateurs pendant plusieurs jours. Le courage de l'équipe a sauvé le centre de données d'un accident grave, mais était-il vraiment nécessaire ? Nous vivons sur une planète avec une atmosphère riche en azote et en oxygène ainsi qu'une abondance d'eau. Les tempêtes et ouragans sont courants ici (surtout dans les zones côtières). Les concepteurs devraient probablement prendre en compte les risques associés et construire un système d'alimentation électrique de secours adéquat. Ou au moins choisir un emplacement plus approprié pour le centre de données qu'un gratte-ciel sur une île.
Tout le reste
Dans cette catégorie, l'Uptime Institute recense divers incidents parmi lesquels il est difficile de choisir un cas typique. Vols de câbles en cuivre, intrusions dans les centres de données, pylônes de lignes électriques et stations de transformation, véhicules, incendies endommageant les fibres optiques par des excavateurs, rongeurs (rats, lapins et même wombats, qui appartiennent pourtant aux marsupiaux), ainsi que des amateurs de tir sur les fils — le menu est vaste. Les pannes d'alimentation peuvent même être causées par une illégale de marijuana qui vole l'électricité. Dans la plupart des cas, les responsables de l'incident sont des personnes spécifiques, c'est-à-dire que nous faisons à nouveau face au facteur humain, lorsque le problème a un nom et un prénom. Même si, à première vue, l'accident est lié à une défaillance technique ou à des catastrophes naturelles, il peut être évité avec une conception appropriée de l'installation et une bonne exploitation. Les exceptions concernent éventuellement les cas de dommages critiques à l'infrastructure des centres de données ou de destruction de bâtiments en raison de catastrophes naturelles. Ce sont vraiment des cas de force majeure, alors que tous les autres problèmes sont causés par la connexion entre l'ordinateur et la chaise — c'est sans doute la partie la plus peu fiable de tout système complexe.
Source : habr.com
