

Si vous utilisez une base de données de séries temporelles (timeseries db, ) comme principal stockage pour un site de statistiques, vous risqueriez de vous retrouver avec beaucoup de maux de tête au lieu de résoudre vos problèmes. Je travaille sur un projet utilisant une telle base, et parfois InfluxDB, dont nous allons parler, a présenté des surprises inattendues.
Avertissement: les problèmes mentionnés concernent la version InfluxDB 1.7.4.
Pourquoi les séries temporelles ?
Le projet consiste à suivre les transactions dans diverses blockchains et à afficher des statistiques. Plus précisément, nous examinons l'émission et la destruction de stablecoins (). À partir de ces transactions, des graphiques doivent être construits et des tableaux récapitulatifs doivent être présentés.
En analysant les transactions, l'idée est venue : utiliser InfluxDB comme principal stockage de données de séries temporelles. Les transactions sont des points dans le temps et elles s'adaptent bien au modèle de séries temporelles.
De plus, les fonctions d'agrégation semblaient très pratiques - elles conviennent parfaitement au traitement de graphiques sur de longues périodes. L'utilisateur a besoin d'un graphique annuel, alors que la base contient des données avec un intervalle de cinq minutes. Envoyer les cent mille points serait absurde - en plus d'un long traitement, ils ne tiendraient même pas à l'écran. Vous pouvez écrire votre propre implémentation pour augmenter l'intervalle de temps, ou utiliser les fonctions d'agrégation intégrées d'Influx. Grâce à elles, vous pouvez regrouper les données par jours et envoyer les 365 points nécessaires.
Ce qui me troublait un peu, c'est que ces bases sont généralement utilisées pour collecter des métriques. Surveillance des serveurs, appareils IoT, toutes ces sources qui « envoient » des millions de points tels que : [<temps> — <valeur de la métrique>]. Mais si la base fonctionne bien avec un grand flux de données, pourquoi un petit volume devrait-il poser des problèmes ? Avec cette réflexion, nous avons décidé d'utiliser InfluxDB.
Quoi d'autre de pratique dans InfluxDB
En plus des fonctions d'agrégation mentionnées, il y a une autre chose remarquable - les requêtes continues (). C'est un planificateur intégré à la base de données qui peut traiter des données selon un calendrier. Par exemple, vous pouvez regrouper toutes les entrées d'une journée toutes les 24 heures, calculer la moyenne et enregistrer un nouveau point dans une autre table sans avoir à écrire vos propres solutions.
Il y a aussi politiques de rétention () — configuration de la suppression des données après une certaine période. Utile lorsqu'il est nécessaire de conserver la charge CPU sur une semaine avec des mesures prises chaque seconde, mais qu'une telle précision n'est pas nécessaire sur plusieurs mois. Dans cette situation, il est possible de procéder ainsi :
- créer une requête continue pour agréger les données dans une autre table ;
- pour la première table, définir une politique de suppression des métriques qui sont plus anciennes que cette semaine.
Et Influx s'occupera de réduire la taille des données et de supprimer ce qui est superflu.
Concernant les données stockées
Il n'y a pas beaucoup de données stockées : environ 70 000 transactions et un million de points d'information de marché. L'ajout de nouvelles entrées ne dépasse pas 3000 points par jour. Il existe également des métriques pour le site, mais il y a peu de données et selon la politique de conservation, elles ne sont pas conservées plus d'un mois.
Problèmes
Au cours du développement et des tests ultérieurs du service, des problèmes de plus en plus critiques sont apparus lors de l'exploitation d'InfluxDB.
1. Suppression des données
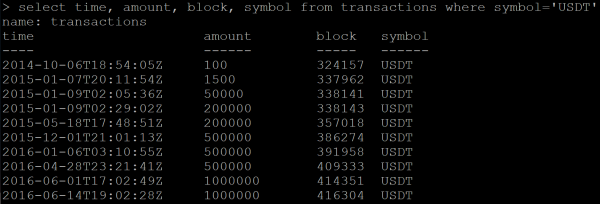
Il y a une série de données avec des transactions :
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Résultat :
J'envoie une commande pour supprimer des données :
DELETE FROM transactions WHERE symbol='USDT'Ensuite, je fais une requête pour récupérer les données déjà supprimées. Et Influx ne renvoie pas une réponse vide, mais une partie des données qui devraient être supprimées.
J'essaie de supprimer la table entière :
DROP MEASUREMENT transactionsJe vérifie la suppression de la table :
SHOW MEASUREMENTSJe ne vois pas la table dans la liste, mais la nouvelle requête de données renvoie toujours le même ensemble de transactions.
Le problème ne s'est produit qu'une seule fois, car le cas de suppression est un cas unique. Mais ce comportement de la base de données ne correspond clairement pas à ce que l'on pourrait considérer comme un fonctionnement 'correct'. Plus tard, j'ai trouvé sur github un problème ouvert il y a presque un an à ce sujet.
En conséquence, la suppression et la restauration subséquente de toute la base ont permis de résoudre le problème.
2. Nombres à virgule flottante
Les calculs mathématiques lors de l'utilisation des fonctions intégrées d'InfluxDB donnent des erreurs de précision. Ce n'est pas étonnant, mais c'est désagréable.
Dans mon cas, les données ont une composante financière et je souhaite les traiter avec une grande précision. Pour cette raison, je prévois d'abandonner les requêtes continues.
3. Les requêtes continues ne peuvent pas être adaptées à différents fuseaux horaires
Le service dispose d'un tableau avec des statistiques quotidiennes sur les transactions. Pour chaque jour, il faut regrouper toutes les transactions de la journée. Cependant, le jour de chaque utilisateur débutant à des heures différentes, le set de transactions varie également. Selon UTC, il y a de décalage pour lesquelles il faut agréger les données.
Dans InfluxDB, lors du regroupement par temps, il est possible d'indiquer un décalage, par exemple pour l'heure de Moscou (UTC+3) :
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Mais le résultat de la requête sera incorrect. Pour une raison quelconque, les données regroupées par jour commenceront en 1677 (InfluxDB prend officiellement en charge les périodes de temps depuis cette année):
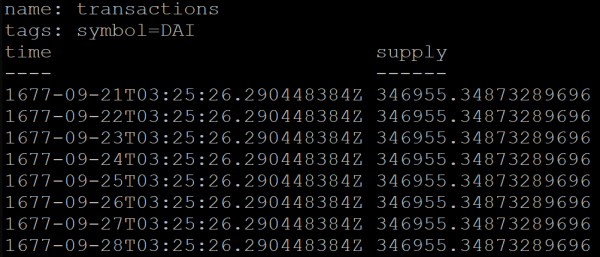
Pour contourner ce problème, le service a temporairement été transféré sur UTC+0.
4. Performance
Il existe de nombreux benchmarks sur Internet comparant InfluxDB et d'autres bases de données. Lors de ma première consultation, ils semblaient être des matériels marketing, mais je pense maintenant qu'il y a une part de vérité.
Je vais vous raconter mon cas.
Le service fournit une méthode API qui retourne des statistiques des dernières 24 heures. Dans les calculs, la méthode interroge la base trois fois avec les requêtes suivantes :
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCExplication :
- Dans la première requête, nous obtenons les derniers points pour chaque pièce avec des données de marché. Huit points pour huit pièces dans mon cas.
- La deuxième requête obtient le point le plus récent.
- La troisième interroge la liste des transactions des dernières 24 heures, il peut y en avoir plusieurs centaines.
Je précise qu'en InfluxDB, des index sont automatiquement construits par tags et par temps, ce qui accélère les requêtes. Dans la première requête, symbol est un tag.
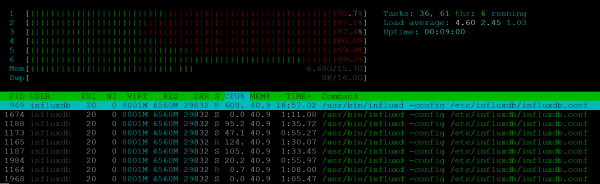
J'ai effectué un test de stress pour cette méthode API. Avec 25 RPS, le serveur montrait une charge complète de six CPU :
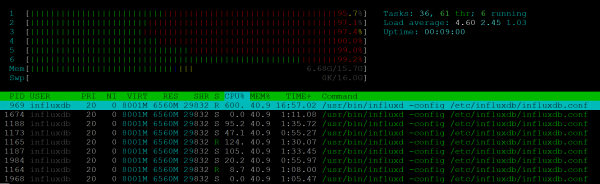
Cependant, le processus NodeJs ne générait aucune charge.
La vitesse d'exécution a déjà commencé à se dégrader à 7-10 RPS : si un client pouvait obtenir une réponse en 200 ms, alors 10 clients devaient attendre une seconde. 25 RPS est la limite à partir de laquelle la stabilité était affectée, des erreurs 500 étaient retournées aux clients.
Avec une telle performance, il est impossible d'utiliser Influx dans notre projet. De plus, dans un projet où la surveillance doit être démontrée à de nombreux clients, des problèmes similaires pourraient survenir et le serveur de métriques serait surchargé.
Sortie
La principale leçon tirée de cette expérience est qu'il ne faut pas intégrer une technologie inconnue dans un projet sans une analyse suffisante. Une simple vérification des tickets ouverts sur GitHub aurait pu fournir des informations pour éviter de choisir InfluxDB comme principal stockage de données.
InfluxDB devait bien convenir aux besoins de mon projet, mais comme l'a montré la pratique, cette base de données ne répond pas aux exigences et présente de nombreux problèmes.
Une version 2.0.0-beta du projet est déjà disponible dans le dépôt, espérons que cette nouvelle version apportera des améliorations significatives. En attendant, je vais commencer à explorer la documentation de TimescaleDB.
Source : habr.com
