

Je vous propose de découvrir la transcription de la présentation d'Alexandre Valialkin à la fin de l'année 2019 intitulée "Optimisations Go dans VictoriaMetrics"
— une base de données rapide et évolutive pour stocker et traiter des données sous forme de séries temporelles (l'enregistrement forme le temps et un ensemble de valeurs correspondantes à ce moment, par exemple, obtenues par un sondage périodique de l'état des capteurs ou la collecte de métriques).
Voici le lien vers la vidéo de cette présentation —
Permettez-moi de me présenter. Je suis Alexandre Valialkin. Voici . Je suis passionné par Go et l'optimisation des performances. J'ai écrit de nombreuses bibliothèques utiles et moins utiles. Elles commencent soit par fast, ou par quick comme préfixe.
Actuellement, je travaille sur VictoriaMetrics. Qu'est-ce que c'est et quel est mon rôle là-dedans ? Je vais en parler dans cette présentation.
Le plan de la présentation est le suivant :
- Dans un premier temps, je vais vous expliquer ce qu'est VictoriaMetrics.
- Ensuite, je vais vous parler des séries temporelles.
- Puis je vais expliquer comment fonctionne la base de données des séries temporelles.
- Ensuite, je parlerai de l'architecture de la base de données : de quoi elle est composée.
- Et enfin, nous aborderons les optimisations présentes dans VictoriaMetrics. Cela inclut l'optimisation de l'index inversé et l'optimisation de l'implémentation du bitset en Go.
Est-ce que quelqu'un dans le public connaît VictoriaMetrics ? Incroyable, déjà beaucoup de gens savent. C'est une bonne nouvelle. Pour ceux qui ne savent pas, c'est une base de données pour les séries temporelles. Elle est basée sur l'architecture de ClickHouse, sur certains détails d'implémentation de ClickHouse. Par exemple, sur des éléments tels que : MergeTree, le calcul parallèle sur tous les cœurs de processeur disponibles et l'optimisation des performances grâce à la gestion de blocs de données qui sont placés dans le cache du processeur.
VictoriaMetrics offre la meilleure compression des données par rapport aux autres bases de données pour les séries temporelles.
Elle se scale verticalement, c'est-à-dire que vous pouvez ajouter davantage de processeurs, plus de mémoire vive sur une seule machine. VictoriaMetrics utilisera efficacement ces ressources disponibles et améliorera la performance linéaire.
VictoriaMetrics se scale également horizontalement, c'est-à-dire que vous pouvez ajouter des nœuds supplémentaires au cluster VictoriaMetrics, et sa performance augmentera presque linéairement.
Comme vous l'avez deviné, VictoriaMetrics est une base de données rapide, car je ne peux pas écrire sur d'autres. Et elle est développée en Go, c'est pourquoi j'en parle lors de ce meetup.
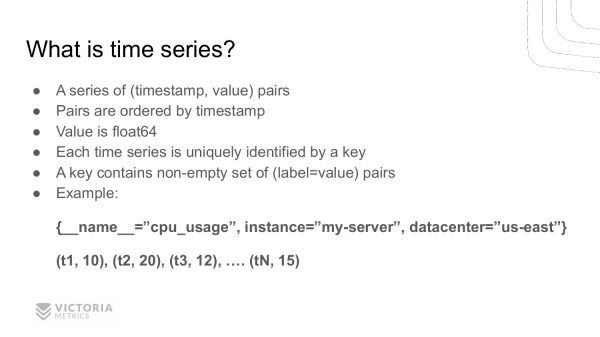
Qui sait ce qu'est une série temporelle ? Beaucoup de gens le savent aussi. Une série temporelle est une série de paires (timestamp, valeur), où ces paires sont triées par temps. La valeur est un nombre à virgule flottante – float64.
Chaque série temporelle est identifiée de manière unique par une clé. De quoi se compose cette clé ? Elle se compose d'un ensemble non vide de paires clé-valeur.
Voici un exemple de série temporelle. La clé de cette série est une liste de paires : __name__="cpu_usage" – c'est le nom de la métrique, instance="my-server" – c'est l'ordinateur sur lequel cette métrique a été collectée, datacenter="us-east" – c'est le centre de données où se trouve cet ordinateur.
Nous avons obtenu un nom de série temporelle composé de trois paires clé-valeur. Cette clé correspond à une liste de paires (timestamp, value). t1, t3, t3, ..., tN – ce sont des timestamps, 10, 20, 12, ..., 15 – avec les valeurs correspondantes. C'est l'utilisation du CPU à ce moment donné pour cette série.
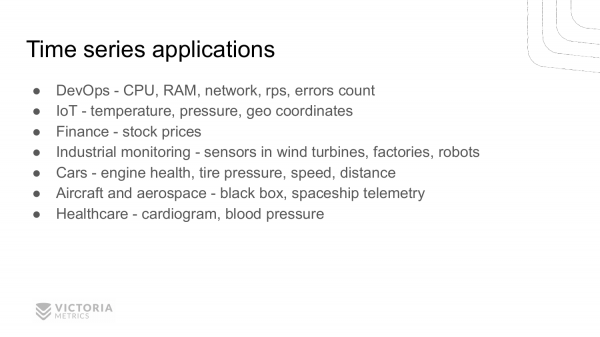
Où peuvent être utilisées les séries temporelles ? Quelqu'un a-t-il des idées ?
- Dans DevOps, nous pouvons mesurer les lectures de charge CPU, RAM, réseau, rps, nombre d'erreurs, etc.
- IoT – nous pouvons mesurer la température, la pression, les coordonnées géographiques et d'autres éléments.
- Également pour les finances – nous pouvons surveiller les prix des actions et des devises.
- De plus, les séries temporelles peuvent être utilisées pour surveiller les processus de production dans les usines. Nous avons des utilisateurs qui utilisent VictoriaMetrics pour surveiller les éoliennes, pour les robots.
- Les séries temporelles sont également utiles pour collecter des informations à partir de capteurs de divers dispositifs. Par exemple, pour les moteurs ; pour mesurer la pression dans les pneus ; pour mesurer la vitesse, la distance ; pour mesurer la consommation d'essence, etc.
- Les séries temporelles peuvent également être utilisées pour surveiller les avions. Chaque avion a une boîte noire qui collecte des séries temporelles sur différents paramètres de santé de l'avion. Les séries temporelles sont également utilisées dans l'industrie aérospatiale.
- La santé – c'est la pression sanguine, le pouls, etc.
Il peut encore y avoir d'autres applications dont j'ai oublié de parler, mais j'espère que vous avez compris que les séries temporelles sont activement utilisées dans le monde moderne. Et leur utilisation augmente chaque année.
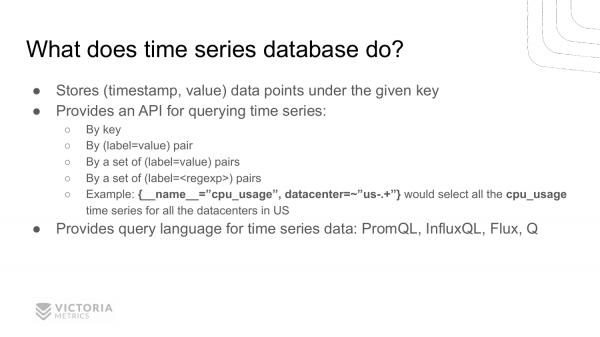
À quoi sert une base de données pour les séries temporelles ? Pourquoi ne pas utiliser une base de données relationnelle classique pour stocker des séries temporelles ?
Parce que dans les séries temporelles, il y a généralement une grande quantité d'informations qui sont difficiles à stocker et à traiter dans des bases de données classiques. C'est pourquoi des bases de données spécialisées pour les séries temporelles ont vu le jour. Ces bases stockent efficacement les points. (timestamp, value) avec une clé donnée. Elles fournissent une API pour lire les données stockées par clé, soit une paire clé-valeur, soit plusieurs de ces paires, soit par regexp. Par exemple, si vous souhaitez trouver la charge du processeur de tous vos services dans un centre de données en Amérique, vous devez utiliser cette sorte de pseudointerrogation.
En général, les bases de données pour séries temporelles proposent des langages de requête spécialisés, car SQL n'est pas très adapté aux séries temporelles. Bien qu'il existe des bases de données qui supportent SQL, ce dernier ne convient pas vraiment. Des langages de requête comme , , , sont mieux adaptés. J'espère que quelqu'un a déjà entendu parler d'au moins l'un de ces langages. De nombreux gens ont sûrement entendu parler de PromQL. C'est le langage de requêtes de Prometheus.
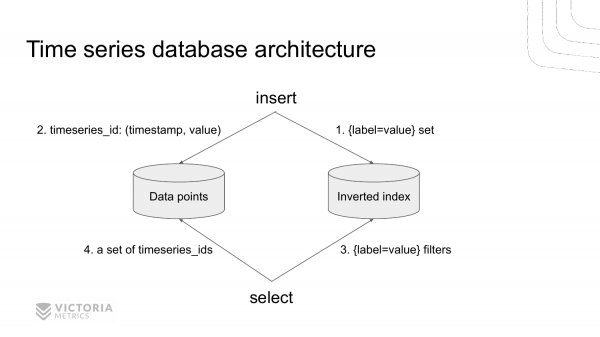
Voici à quoi ressemble l'architecture d'une base de données moderne pour séries temporelles, avec VictoriaMetrics comme exemple.
Elle se compose de deux parties. Il y a un stockage pour l'index inversé et un stockage pour les valeurs des séries temporelles. Ces stockages sont séparés.
Lorsque qu'un nouvel enregistrement arrive dans la base de données, nous consultons d'abord l'index inversé pour trouver l'identifiant de la série temporelle correspondant à un ensemble donné label=value pour cette métrique. Nous trouvons cet identifiant et stockons la valeur dans le stockage de données.
Lorsque qu'une requête d'extraction de données est faite au TSDB, nous consultons d'abord l'index inversé. Nous obtenons tous les timeseries_ids d'enregistrements, qui correspondent à l'ensemble donné. label=valuePuis nous récupérons toutes les données nécessaires du stockage de données, indexées par timeseries_ids.
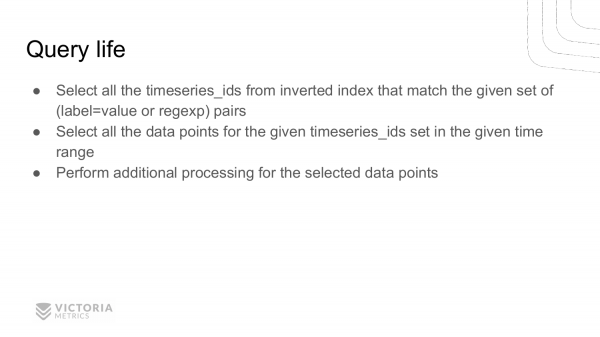
Considérons un exemple où la base de données pour séries temporelles traite une requête SELECT entrante.
- Dans un premier temps, elle récupère tous les
timeseries_idsde l'index inversé, qui contiennent les paires donnéeslabel=value, ou qui satisfont à une expression régulière donnée. - Puis elle extrait tous les points de données du stockage de données sur l'intervalle de temps donné pour les trouvés.
timeseries_ids. - Après cela, la base de données effectue certains calculs sur ces points de données, selon la requête de l'utilisateur. Et ensuite, elle retourne la réponse.
Dans cette présentation, je vais vous parler de la première partie. C'est la recherche. timeseries_ids selon l'index inversé. Vous pouvez ensuite consulter la deuxième et la troisième partie. , ou attendre que je prépare d'autres présentations 🙂
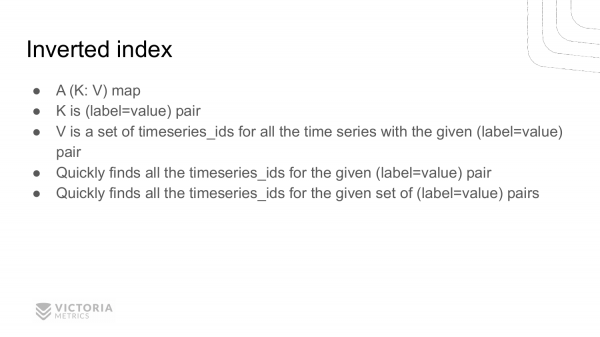
Commençons par l'index inversé. Beaucoup peuvent penser que c'est simple. Qui sait ce qu'est un index inversé et comment il fonctionne ? Oh, il n'y a déjà plus tant de gens. Essayons de comprendre ce que c'est.
En réalité, c'est assez simple. C'est juste un dictionnaire qui fait correspondre une clé à une valeur. Qu'est-ce qu'une clé ? Cette paire label=value, où label et value — ce sont des chaînes. Et les valeurs sont un ensemble timeseries_ids, qui contient la paire donnée. label=value.
L'index inversé permet de trouver rapidement tous timeseries_ids, qui possèdent les label=value.
Il permet également de trouver rapidement des timeseries_ids séries temporelles pour plusieurs paires label=value, ou pour des paires label=regexp. Comment cela fonctionne-t-il ? Grâce à la recherche de l'intersection d'un ensemble timeseries_ids pour chaque paire. label=value.
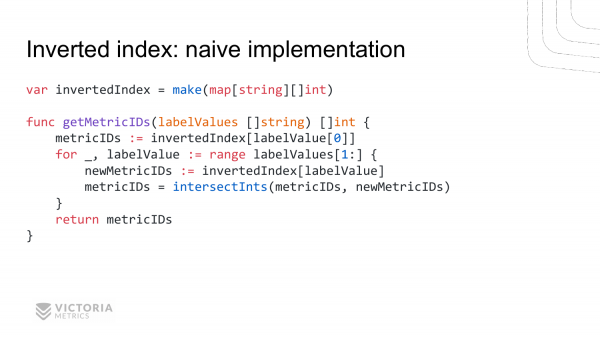
Examinons différentes implémentations de l'index inversé. Commençons par l'implémentation naïve la plus simple. Elle ressemble à ceci.
Fonction getMetricIDs obtient une liste de chaînes. Chaque chaîne contient label=value. Cette fonction renvoie une liste de metricIDs..
Comment cela fonctionne-t-il ? Ici, nous avons une variable globale appelée invertedIndex.C'est un simple dictionnaire (carte), qui associe une chaîne à un slice d'entiers. La chaîne contient label=value.
Implémentation de la fonction : nous obtenons metricIDs. pour le premier label=value, puis nous parcourons tous les autres label=value, nous obtenons metricIDs. pour eux. Et nous appelons la fonction intersectInts,qui sera expliquée plus loin. Cette fonction renvoie l'intersection de ces listes.
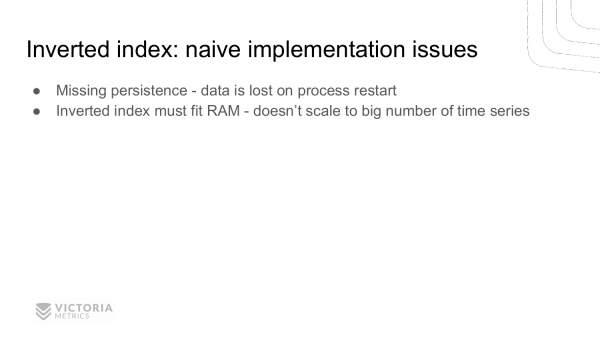
Comme vous pouvez le voir, l'implémentation de l'index inversé n'est pas très compliquée. Mais c'est une implémentation naïve. Quels en sont les inconvénients ? Le principal inconvénient de l'implémentation naïve est que cet index inversé est stocké en mémoire vive. Après le redémarrage de l'application, nous perdons cet index. Il n'y a pas de sauvegarde de cet index sur disque. Pour une base de données, un tel index inversé n'est probablement pas adapté.
Le deuxième inconvénient est également lié à la mémoire. L'index inversé doit tenir dans la mémoire vive. S'il dépasse la taille de la mémoire, il est évident que nous obtiendrons une erreur de type sorti de mémoire. Et le programme ne fonctionnera pas.
Ce problème peut être résolu grâce à des solutions prêtes à l'emploi telles que , ou bien .
En résumé, nous avons besoin d'une base de données qui permet d'effectuer rapidement trois opérations.
- La première opération consiste à écrire
clé-valeurdans cette base. Elle le fait très rapidement, oùclé-valeurce sont des chaînes aléatoires. - La deuxième opération consiste à rechercher rapidement une valeur par clé.
- Et la troisième opération consiste à rechercher rapidement toutes les valeurs par un préfixe donné.
LevelDB et RocksDB – ces bases ont été développées chez Google et Facebook. LevelDB est apparu en premier. Ensuite, les gars de Facebook ont pris LevelDB et l'ont amélioré, créant RocksDB. Actuellement, presque toutes les bases de données internes de Facebook fonctionnent sur RocksDB, y compris MySQL, qui a été transféré sur RocksDB. Ils l'ont appelé .
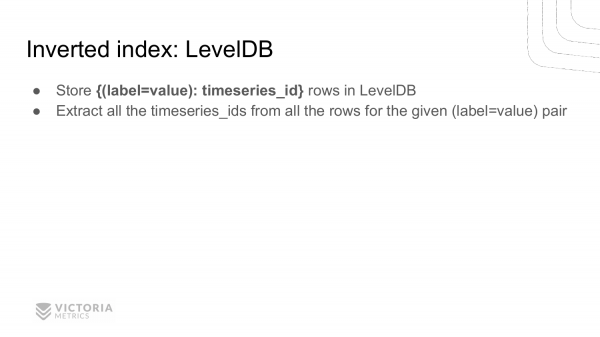
Un index inversé peut être réalisé avec LevelDB. Comment faire cela ? Nous le sauvegardons en tant que clé label=value. Et en tant que valeur – l'identifiant de la série temporelle où la paire est présente. label=value.
Si nous avons plusieurs séries temporelles avec cette paire label=value, il y aura beaucoup de lignes dans cette base de données avec la même clé et différentes timeseries_ids. Pour obtenir la liste de tous les timeseries_ids, qui commencent par un certain label=prefix, nous effectuons un scan de plage, pour lequel cette base de données est optimisée. C'est-à-dire que nous sélectionnons toutes les lignes qui commencent par label=prefix et obtenons les timeseries_ids.
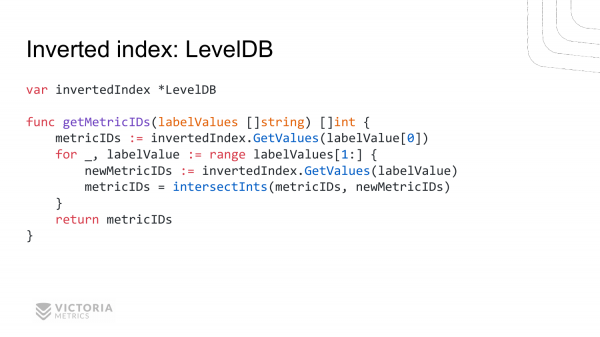
Voici une implémentation approximative de ce à quoi cela ressemblerait en Go. Nous avons un index inversé. C'est LevelDB.
La fonction est la même que pour l'implémentation naïve. Elle répète presque ligne par ligne l'implémentation naïve. Le seul point, c'est qu'au lieu d'accéder à carte , nous accédons à l'index inversé. Nous récupérons toutes les valeurs pour le premier label=value. Ensuite, nous passons en revue toutes les paires restantes label=value et obtenons les ensembles correspondants de metricIDs pour elles. Puis nous trouvons l'intersection.
Tout semble bien, mais cette solution a ses inconvénients. VictoriaMetrics a d'abord implémenté l'index inversé basé sur LevelDB. Mais au final, ils ont dû y renoncer.
Pourquoi ? Parce que LevelDB est plus lent que l'implémentation naïve. Dans l'implémentation naïve, pour une clé donnée, nous accédons directement à tout le slice metricIDs.. C'est une opération très rapide – tout le slice est prêt à être utilisé.
Dans LevelDB, à chaque appel de la fonction GetValues , il faut parcourir toutes les lignes qui commencent par label=value. Et pour chaque ligne, extraire la valeur timeseries_ids. De ces timeseries_ids , recueillir un slice de ces timeseries_ids. Il est évident que c'est beaucoup plus lent que d'accéder directement à une map normale par clé.
Le deuxième inconvénient est que LevelDB est écrit en C. L'appel des fonctions C depuis Go n'est pas très rapide. Cela prend des centaines de nanosecondes. Ce n'est pas très rapide, car par rapport à un appel de fonction écrit en Go, qui prend 1 à 5 nanosecondes, l'écart de performance est de plusieurs ordres de grandeur. Pour VictoriaMetrics, cela a été un inconvénient fatal 🙂
C'est pourquoi j'ai écrit ma propre implémentation d'un index inversé. Je l'ai appelée .
Mergeset est basé sur la structure de données MergeTree. Cette structure de données est empruntée à ClickHouse. Il est évident que mergeset doit être optimisé pour une recherche rapide timeseries_ids par clé. Mergeset est entièrement écrit en Go. Vous pouvez consulter . L'implémentation de mergeset se trouve dans le dossier . Vous pouvez essayer de comprendre ce qui s'y passe.
L'API de mergeset est très similaire à celle de LevelDB et RocksDB. C'est-à-dire qu'elle permet de sauvegarder rapidement de nouvelles entrées et de sélectionner rapidement des entrées par un préfixe donné.
Nous parlerons plus tard des défauts de mergeset. Pour l'instant, discutons des problèmes rencontrés avec VictoriaMetrics en production lors de l'implémentation de l'index inversé.
Pourquoi sont-ils survenus ?
La première raison est le taux de renouvellement élevé. En d'autres termes, il s'agit d'un changement fréquent des séries temporelles. C'est lorsque une série temporelle se termine et qu'une nouvelle série commence, ou que de nombreuses nouvelles séries temporelles commencent. Et cela se produit fréquemment.
La deuxième raison est le grand nombre de séries temporelles. Au début, lorsque la surveillance gagnait en popularité, le nombre de séries temporelles était faible. Par exemple, pour chaque ordinateur, il faut surveiller l'utilisation du processeur, de la mémoire, du réseau et du disque. 4 séries temporelles par ordinateur. Supposons que vous ayez 100 ordinateurs et 400 séries temporelles. C'est très peu.
Avec le temps, les gens ont réalisé qu'il était possible de mesurer des informations plus détaillées. Par exemple, mesurer l'utilisation non pas de l'ensemble du processeur, mais de chaque cœur de processeur séparément. Si vous avez 40 cœurs de processeur, alors vous obtenez 40 fois plus de séries temporelles pour mesurer l'utilisation du processeur.
Mais ce n'est pas tout. Chaque cœur de processeur peut avoir plusieurs états, tels que idle, lorsqu'il est inactif. Il peut également fonctionner en espace utilisateur, en espace noyau et dans d'autres états. Chacun de ces états peut également être mesuré comme une série temporelle distincte. Cela augmente encore le nombre de séries de 7 à 8 fois.
Nous avons obtenu 40 x 8 = 320 métriques rien que pour un ordinateur. En multipliant par 100, nous obtenons 32 000 au lieu de 400.
Puis est arrivé Kubernetes. Cela a encore aggravé la situation, car de nombreux services différents peuvent être hébergés dans Kubernetes. Chaque service dans Kubernetes est composé de nombreux pods. Tout cela nécessite une surveillance. De plus, nous avons un déploiement constant de nouvelles versions de vos services. Pour chaque nouvelle version, nous devons créer de nouvelles séries temporelles. Au final, le nombre de séries temporelles augmente de manière exponentielle et nous faisons face à un problème de nombreuses séries temporelles, qui est appelé high-cardinality. VictoriaMetrics gère cela avec succès par rapport à d'autres bases de données de séries temporelles.
Examinons de plus près le high churn rate. Qu'est-ce qui cause un high churn rate en production ? Parce que certaines valeurs d'étiquettes et de tags changent constamment.
Par exemple, prenons Kubernetes, qui a le concept de déploiement, c'est-à-dire lorsque la nouvelle version de votre application est déployée. Les développeurs de Kubernetes ont décidé d'ajouter l'ID du déploiement dans l'étiquette.
Quelle en est la conséquence ? Que lors de chaque nouveau déploiement, toutes nos anciennes séries temporelles sont interrompues, et à la place de celles-ci, de nouvelles séries temporelles commencent avec une nouvelle valeur d'étiquette deployment_id. Il peut y avoir des centaines de milliers, voire des millions de telles séries.
Une caractéristique importante de tout cela est que le nombre total de séries temporelles augmente, mais le nombre de séries temporelles qui sont actuellement actives, dont les données arrivent, reste constant. Cet état est appelé – high churn rate.
Le principal problème du high churn rate est d'assurer une vitesse de recherche constante pour toutes les séries temporelles sur la base d'un ensemble donné d'étiquettes pendant un certain intervalle de temps. Généralement, il s'agit d'un intervalle de temps au cours de la dernière heure ou de la dernière journée.
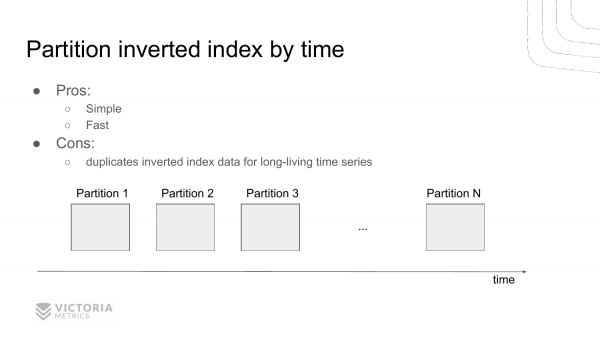
Comment résoudre ce problème ? Voici une première option. Il s'agit de diviser l'index inversé en parties indépendantes par période. C'est-à-dire qu'après un certain intervalle de temps, nous terminons notre travail avec l'index inversé actuel et créons un nouvel index inversé. Un autre intervalle de temps passe, et nous créons encore un autre index inversé.
Et lors de la sélection parmi ces index inversés, nous trouvons un ensemble d'index inversés qui tombent dans l'intervalle spécifié. Nous sélectionnons donc les identifiants des séries temporelles à partir de là.
Cela permet d'économiser des ressources, car nous n'avons pas besoin d'examiner des parties qui ne tombent pas dans l'intervalle spécifié. C'est-à-dire généralement, si nous sélectionnons des données de la dernière heure, nous ignorons les requêtes des intervalles de temps précédents.
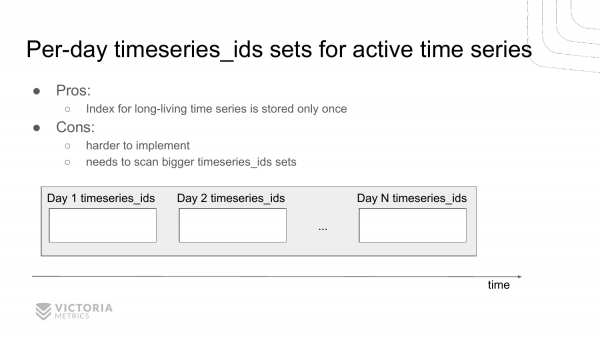
Il existe une autre option pour résoudre ce problème. Il s'agit de stocker pour chaque jour une liste distincte des identifiants des séries temporelles rencontrées ce jour-là.
L'avantage de cette solution par rapport à la précédente est que nous ne doublons pas les informations sur les séries temporelles qui ne disparaissent pas avec le temps. Elles sont toujours présentes et ne changent pas.
L'inconvénient est que cette solution est plus complexe à mettre en œuvre et plus difficile à déboguer. Et VictoriaMetrics a choisi cette solution. Cela s'est installé historiquement. Cette solution s'est également bien comportée par rapport à la précédente. Car cette solution n'a pas été mise en œuvre à cause de la nécessité de dupliquer les données dans chaque partition pour les séries temporelles qui ne changent pas, c'est-à-dire qui ne disparaissent pas avec le temps. VictoriaMetrics a d'abord été optimisée pour la consommation d'espace disque, et l'implémentation précédente a dégradé la consommation d'espace disque. Mais cette implémentation est mieux adaptée à la minimisation de la consommation d'espace disque, c'est pourquoi elle a été choisie.
Il a fallu lutter contre ça. La lutte consistait à devoir sélectionner un nombre beaucoup plus important timeseries_ids de données, que lorsque l'index inversé est divisé par période.
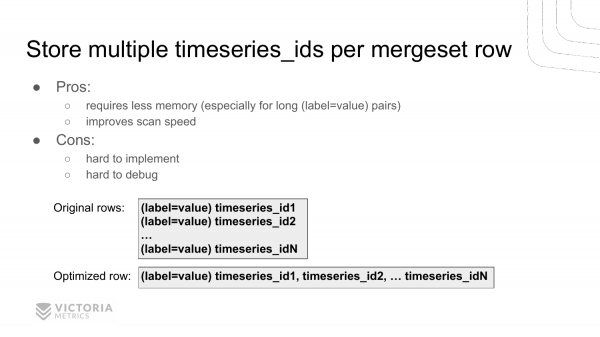
Comment avons-nous résolu ce problème ? Nous l'avons résolu de manière originale – en sauvegardant plusieurs identifiants de séries temporelles dans chaque enregistrement de l'index inversé au lieu d'un seul identifiant. C'est-à-dire que nous avons une clé label=value, qui est présent dans chaque série temporelle. Et maintenant, nous conservons plusieurs timeseries_ids dans un seul enregistrement.
Voici un exemple. Avant, nous avions N enregistrements, et maintenant, nous avons un enregistrement dont le préfixe est le même que celui de tous les autres. L'enregistrement précédent contenait toutes les identifiants de séries temporelles.
Cela a permis d'augmenter la vitesse de consultation de cet index inversé jusqu'à 10 fois. Et a permis de diminuer la consommation de mémoire pour le cache, car maintenant nous stockons la chaîne label=value une seule fois dans le cache au lieu de N fois. Et cette chaîne peut être grande si vos tags et labels contiennent de longues chaînes que Kubernetes aime y intégrer.
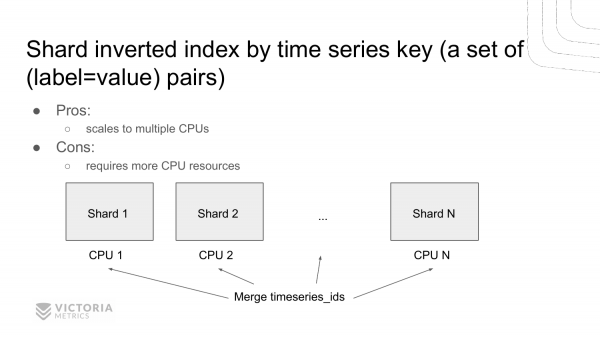
Une autre option pour accélérer la recherche dans un index inversé est le sharding. Créer plusieurs index inversés au lieu d'un seul et shard les données entre eux par clé. C'est un ensemble clé=valeur de paires. C'est-à-dire que nous obtenons plusieurs index inversés indépendants que nous pouvons interroger en parallèle sur plusieurs processeurs. Les implémentations précédentes ne permettaient de fonctionner qu'en mode monocœur, c'est-à-dire de scanner les données sur un seul cœur. Cette solution permet de scanner les données simultanément sur plusieurs cœurs, comme ClickHouse aime le faire. C'est ce que nous prévoyons de mettre en œuvre.
Et maintenant, revenons à nos moutons – à la fonction d'intersection timeseries_ids. Voyons quelles pourraient être les réalisations. Cette fonction permet de trouver timeseries_ids pour un ensemble donné label=value.
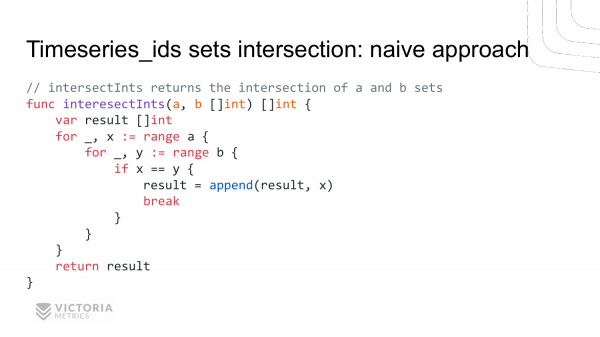
La première option est l'implémentation naïve. Deux boucles imbriquées. Nous recevons en entrée de la fonction intersectInts, deux slices — a et b. En sortie, elle doit nous renvoyer l'intersection de ces slices.
L'implémentation naïve ressemble à cela. Nous passons en revue toutes les valeurs du slice a, à l'intérieur de cette boucle, nous parcourons toutes les valeurs du slice b. Et nous les comparons. S'ils correspondent, cela signifie que nous avons trouvé une intersection. Et nous l'enregistrons dans result.
Quels sont les inconvénients ? La complexité quadratique — c'est son principal inconvénient. Par exemple, si vous avez des tailles de slice a et b d'un million, cette fonction ne vous renverra jamais une réponse. Parce qu'il lui faudrait effectuer un trillion d'itérations, ce qui est énorme même pour des ordinateurs modernes.
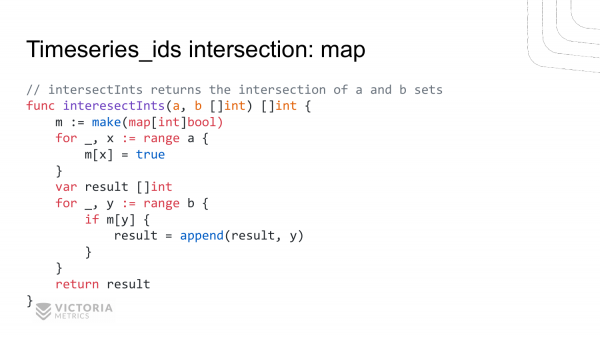
La deuxième réalisation est basée sur une map. Nous créons une map. Nous y insérons toutes les valeurs du slice a. Ensuite, nous parcourons le slice b. Et nous vérifions s'il y a cette valeur du slice. b dans map. S'il existe, nous l'ajoutons au résultat.
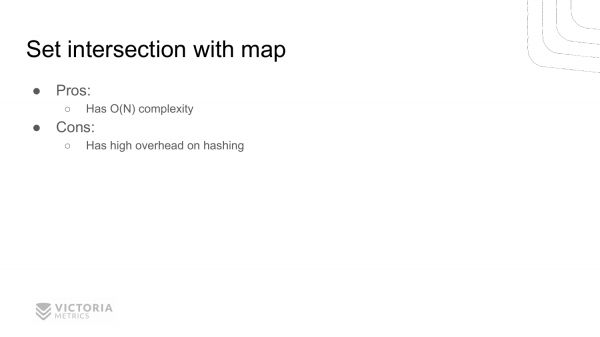
Quels sont les avantages ? L'avantage est qu'il s'agit uniquement d'une complexité linéaire. C'est-à-dire que la fonction s'exécute beaucoup plus rapidement pour de grandes tailles de slices. Pour une taille de slice d'un million, cette fonction s'exécutera en 2 millions d'itérations, contrairement à un trillion d'itérations, comme dans la fonction précédente.
L'inconvénient est que cette fonction nécessite plus de mémoire pour créer cette map.
Le deuxième inconvénient est le grand overhead lors du hachage. Cet inconvénient n'est pas très évident. Et cela n'a pas été très évident pour nous non plus, donc au début, l'implémentation de l'intersection dans VictoriaMetrics était via map. Mais ensuite, le profilage a montré que le temps processeur principal était dépensé à écrire dans la map et à vérifier la présence d'une valeur dans cette map.
Pourquoi le temps processeur est-il dépensé ici ? Parce que dans ces lignes, Go effectue une opération de hachage. C'est-à-dire qu'il calcule le hash de la clé pour ensuite y accéder par l'indice donné dans le HashMap. L'opération de calcul du hash est réalisée en quelques dizaines de nanosecondes. C'est lent pour VictoriaMetrics.
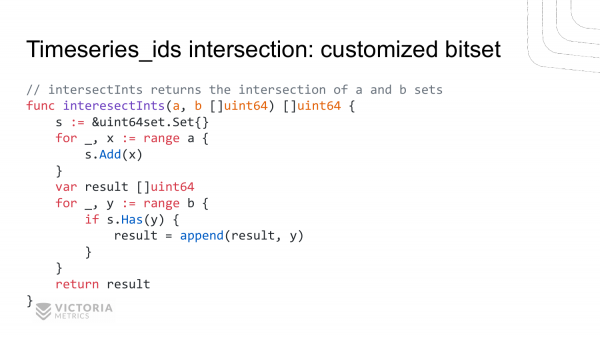
J'ai décidé d'implémenter un bitset, optimisé spécialement pour ce cas. Voici comment se présente maintenant l'intersection de deux slices. Ici, nous créons un bitset. Nous y ajoutons des éléments du premier slice. Ensuite, nous vérifions la présence de ces éléments dans le second slice. Et nous les ajoutons au résultat. C'est-à-dire que cela ne diffère presque pas de l'exemple précédent. La seule chose que nous avons remplacée ici, c'est l'accès à la map par des fonctions personnalisées. add et has.
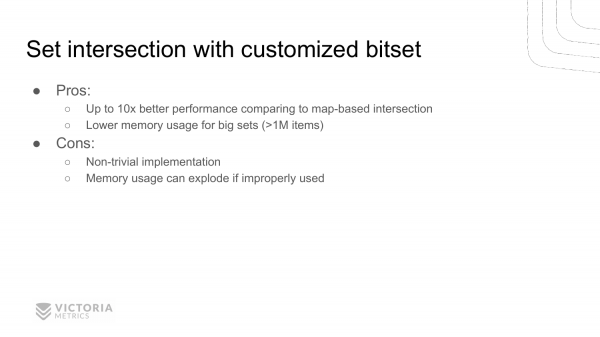
À première vue, cela semble devoir être plus lent, si auparavant une map standard était utilisée et ici des fonctions supplémentaires sont appelées, mais le profilage montre que cela fonctionne 10 fois plus vite que la map standard dans le contexte de VictoriaMetrics.
De plus, cela utilise beaucoup moins de mémoire par rapport à l'implémentation de la map. Parce que nous stockons ici des bits au lieu de valeurs de huit octets.
L'inconvénient de cette implémentation est qu'elle n'est pas aussi évidente, pas triviale.
Un autre inconvénient que beaucoup pourraient ne pas remarquer est que cette implémentation peut mal fonctionner dans certains cas. C'est-à-dire qu'elle est optimisée pour un cas particulier, celui de l'intersection des identifiants de séries temporelles de VictoriaMetrics. Cela ne veut pas dire qu'elle convient à tous les cas. Si elle est mal utilisée, nous n'obtiendrons pas d'augmentation des performances, mais une erreur de mémoire insuffisante et un ralentissement de la performance.
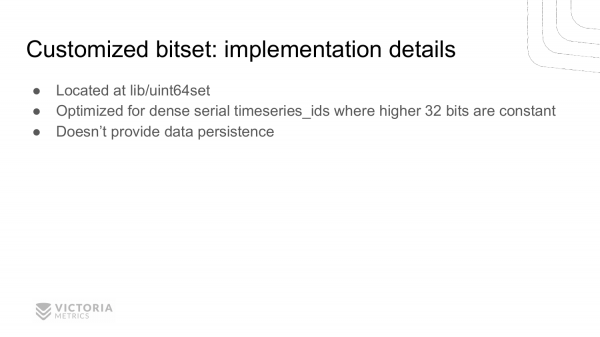
Examinons l'implémentation de cette structure. Si vous souhaitez la consulter, elle se trouve dans les sources de VictoriaMetrics, dans le dossier . Elle est optimisée pour le cas de VictoriaMetrics, où timeseries_id représente une valeur de 64 bits, où les 32 premiers bits sont principalement constants et seuls les 32 derniers bits changent.
Cette structure de données n'est pas stockée sur le disque, elle fonctionne uniquement en mémoire.
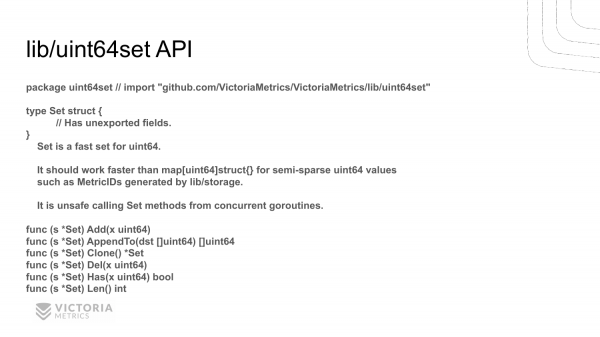
Voici son API. Elle n'est pas très compliquée. L'API est ajustée spécifiquement pour un exemple d'utilisation de VictoriaMetrics. C'est-à-dire qu'il n'y a pas de fonctions superflues. Ici, les fonctions sont celles qui sont explicitement utilisées par VictoriaMetrics.
Il y a des fonctions add, qui ajoutent de nouvelles valeurs. Il y a une fonction has, qui vérifie les nouvelles valeurs. Et il y a une fonction del, qui supprime des valeurs. Il y a aussi une fonction auxiliaire len, qui retourne la taille de l'ensemble. La fonction clone clone l'ensemble. Et la fonction appendto transforme cet ensemble en tranche timeseries_ids.
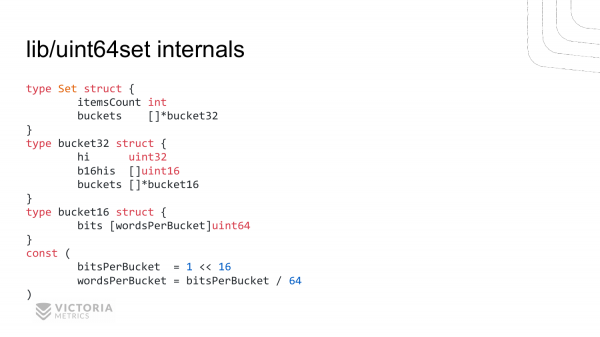
Voici à quoi ressemble l'implémentation de cette structure de données. Dans l'ensemble, il y a deux éléments :
ItemsCount– c'est un champ auxiliaire, pour renvoyer rapidement le nombre d'éléments dans l'ensemble. On aurait pu se passer de ce champ auxiliaire, mais il a dû être ajouté ici, car VictoriaMetrics interroge souvent dans ses algorithmes la longueur du bitset.Le deuxième champ est
buckets. C'est une tranche de la structurebucket32. Chaque structure contienthiun champ. Ce sont les 32 bits supérieurs. Et deux tranches —b16hisetbucketsdebucket16de structures.
Ici sont stockés les 16 bits supérieurs de la deuxième partie de la structure 64 bits. Et ici sont stockés les bitsets pour les 16 bits inférieurs de chaque octet.
Bucket64 consiste en un tableau uint64. La longueur est calculée à l'aide de ces constantes. Dans un bucket16 maximum peut être stocké 2^16=65536 bits. Si l'on divise cela par 8, cela fait 8 ko. Si l'on divise encore par 8, cela fait 1000 uint64 valeurs. C'est-à-dire que Bucket16 est une structure de 8 ko.
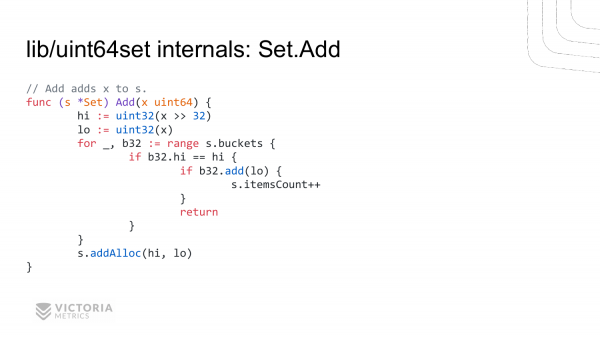
Examinons comment l'une des méthodes de cette structure pour ajouter une nouvelle valeur est implémentée.
Tout commence par uint64 valeurs. Nous calculons les 32 bits supérieurs, nous calculons les 32 bits inférieurs. Nous parcourons tous les buckets. Nous comparons les 32 bits supérieurs dans chaque bucket avec la valeur ajoutée. Et si elles correspondent, nous appelons la fonction add dans la structure b32 buckets. Et nous y ajoutons les 32 bits inférieurs. Et si cela a retourné true, cela signifie que nous avons ajouté cette valeur et que nous n'avions pas cette valeur auparavant. Si elle retourne faux, cela signifie que cette valeur était déjà là. Nous augmentons ensuite le nombre d'éléments dans la structure.
Si nous n'avons pas trouvé le bucket avec la valeur hi-essentielle correspondante, nous appelons la fonction addAlloc, qui alloue un nouvel bucket, en l'ajoutant à la structure de bucket.
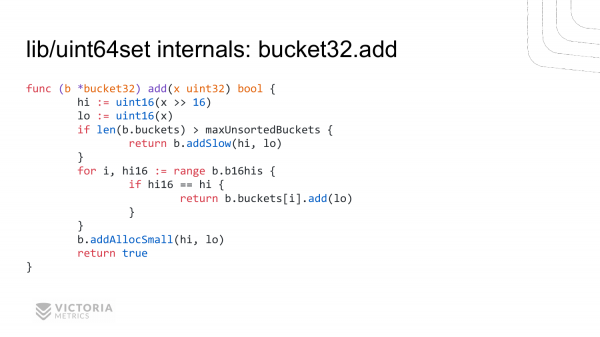
C'est l'implémentation de la fonction b32.add. Elle ressemble à l'implémentation précédente. Nous calculons les 16 bits supérieurs, les 16 bits inférieurs.
Ensuite, nous parcourons tous les 16 bits supérieurs. Nous trouvons des correspondances. Et en cas de correspondance, nous appelons la méthode add, que nous examinerons à la page suivante pour bucket16.
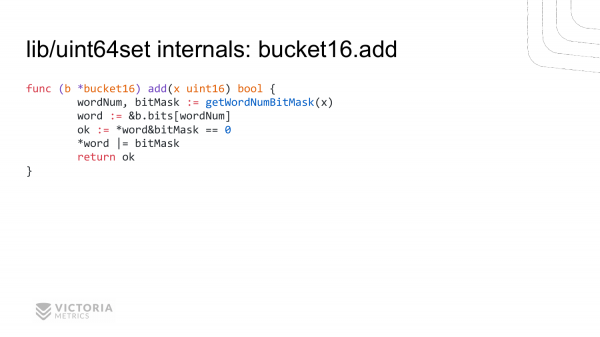
Et voici le niveau le plus bas, qui doit être maximisé pour l'optimisation. Nous calculons pour uint64 la valeur id dans slice bit, ainsi que bitmask. C'est un masque pour cette valeur 64 bits, avec lequel nous pouvons vérifier la présence de ce bit, ou le définir. Nous vérifions si ce bit est déjà défini, nous le définissons, et nous retournons sa présence. Voici une telle implémentation que nous avons, qui a permis d'accélérer l'opération d'intersection d'ids de séries temporelles de 10 fois par rapport aux maps ordinaires.
Dans VictoriaMetrics, en plus de cette optimisation, il y a beaucoup d'autres optimisations. La majorité de ces optimisations ont été ajoutées non pas par hasard, mais après profilage du code en production.
C'est la règle principale de l'optimisation - ne pas ajouter d'optimisation en supposant qu'il y aura un goulet d'étranglement ici, car il peut s'avérer qu'il n'y en a pas. L'optimisation dégrade généralement la qualité du code. Par conséquent, il vaut mieux optimiser seulement après profilage et idéalement en production, afin que ce soient des données réelles. Pour ceux qui sont intéressés, vous pouvez consulter les sources de VictoriaMetrics et étudier d'autres optimisations qui s'y trouvent.
J'ai une question sur le bitset. Cela ressemble beaucoup à l'implémentation du vector bool en C++, un bitset optimisé. Avez-vous pris l'implémentation de là-bas?
Non, ce n'est pas ça. Lors de la mise en œuvre de ce bitset, je me suis basé sur la connaissance de la structure de ces ids timeseries, utilisés dans VictoriaMetrics. Leur structure est telle que les 32 bits supérieurs sont principalement constants. Les 32 bits inférieurs peuvent varier. Plus le bit est bas, plus il peut changer fréquemment. Par conséquent, cette mise en œuvre est précisément optimisée pour cette structure de données. L'implémentation C++, autant que je sache, est optimisée pour le cas général. Si l'on fait une optimisation pour le cas général, cela signifie qu'elle ne sera pas optimale pour un cas spécifique.
Je vous conseille également de consulter la présentation d'Alexey Milovidov. Il a parlé des optimisations dans ClickHouse pour des spécialisations spécifiques il y a environ un mois. Il explique justement que dans le cas général, l'implémentation C++ ou toute autre implémentation est conçue pour bien fonctionner dans l'ensemble. Elle peut fonctionner moins bien qu'une implémentation spécialisée en fonction de connaissances spécifiques, comme dans notre cas, où nous savons que les 32 bits supérieurs sont principalement constants.
J'ai une deuxième question. Quelle est la différence fondamentale avec InfluxDB ?
Il y a beaucoup de différences fondamentales. En termes de performance et de consommation de mémoire, InfluxDB montre dans les tests une consommation de mémoire dix fois plus élevée pour des séries temporelles à haute cardinalité, lorsque vous en avez beaucoup, par exemple des millions. Par exemple, VictoriaMetrics consomme 1 Go pour un million de séries actives, tandis qu'InfluxDB consomme 10 Go. Et c'est une grande différence.
La deuxième différence fondamentale est qu'InfluxDB a des langages de requête étranges – Flux et InfluxQL. Ils ne sont pas très pratiques pour travailler avec des séries temporelles par rapport à , qui est pris en charge dans VictoriaMetrics. PromQL est le langage de requêtes de Prometheus.
Et une autre différence est que InfluxDB a un modèle de données un peu étrange, où chaque ligne peut contenir plusieurs champs avec différentes ensembles d'étiquettes. Ces lignes sont également divisées en différentes tables. Ces complications supplémentaires rendent le travail ultérieur avec cette base plus difficile. Il est difficile de la maintenir et de la comprendre.
Dans VictoriaMetrics, tout est beaucoup plus simple. Chaque série temporelle représente une clé-valeur. La valeur est un ensemble de points – (timestamp, value), et la clé est un ensemble label=value. Il n'y a pas de séparation entre les fields et les measurements. Cela vous permet de sélectionner n'importe quelles données, puis de les combiner, d'additionner, de soustraire, de multiplier et de diviser, contrairement à InfluxDB, où les calculs entre différentes séries ne sont toujours pas réalisés, autant que je sache. Même s'ils l'étaient, c'est compliqué, il faudrait écrire beaucoup de code.
J'ai une question de clarification. Ai-je bien compris qu'il y avait un problème dont vous parliez, à savoir que cet index inversé ne tient pas en mémoire, c'est pourquoi le partitionnement a lieu ?
Au début, j'ai présenté une implémentation naïve de l'index inversé utilisant la carte standard de Go. Cette implémentation n'est pas adaptée aux bases de données, car cet index inversé n'est pas enregistré sur le disque, et une base de données doit conserver ces données sur le disque pour qu'elles restent accessibles après un redémarrage. Dans cette implémentation, après un redémarrage de l'application, vous perdrez l'index inversé. Et vous perdrez l'accès à toutes les données, car vous ne pourrez pas les retrouver.
Bonjour ! Merci pour votre présentation ! Je m'appelle Pavel. Je viens de la société Wildberries. J'ai plusieurs questions à vous poser. Première question. Que pensez-vous, si vous aviez choisi un autre principe pour construire l'architecture de votre application et partitionné les données par temps, il est possible que vous ayez pu faire des intersections de données lors des recherches, en vous basant uniquement sur le fait qu'une partition contient des données pour une période de temps donnée, c'est-à-dire pour un seul intervalle de temps et que vous n'auriez pas eu à vous soucier des morceaux dispersés ? Question numéro 2 - puisque vous implémentez un algorithme similaire avec un bitset et tout le reste, peut-être que vous avez essayé d'utiliser des instructions du processeur ? Peut-être avez-vous tenté de faire de telles optimisations ?
Je vais répondre au deuxième tout de suite. Nous n'en sommes pas encore là. Mais si besoin, nous y arriverons. Et pour le premier, quelle était la question ?
Vous avez discuté de deux scénarios. Et vous avez dit que vous aviez choisi le second avec une implémentation plus complexe. Et que vous ne préfériez pas le premier, où les données sont partitionnées par temps.
Oui. Dans le premier cas, le volume total de l'index serait plus élevé, car nous devrions stocker des doublons de données pour les séries temporelles qui se poursuivent à travers toutes ces partitions. Et si vous avez un taux de désabonnement des séries temporelles faible, c'est-à-dire que les mêmes séries sont constamment utilisées, dans le premier cas, nous perdrions beaucoup plus en termes d'espace disque occupé par rapport au deuxième cas.
En effet, le partitionnement temporel est une bonne option. Prometheus l'utilise. Mais Prometheus a un autre inconvénient. Lors de la fusion de ces morceaux de données, il doit garder en mémoire les métadonnées de tous les labels et séries temporelles. Donc, si les morceaux de données qu'il fusionne sont volumineux, la consommation de mémoire augmente considérablement, contrairement à VictoriaMetrics. Lors de la fusion, VictoriaMetrics ne consomme pratiquement pas de mémoire, quelques kilooctets sont utilisés, indépendamment de la taille des morceaux de données fusionnés.
L'algorithme que vous utilisez utilise de la mémoire. Il marque les labels des séries temporelles sur lesquels il y a des valeurs. Ainsi, vous vérifiez la présence paire dans un tableau de données et dans un autre. Et vous comprenez s'il y a eu intersection ou non. Dans les bases de données, des curseurs, des itérateurs sont généralement implémentés, qui conservent leur état actuel et parcourent les données triées, permettant ainsi une complexité simple pour ces opérations.
Pourquoi n'utilisons-nous pas de curseurs pour l'intersection des données ?
Oui.
Nous avons dans LevelDB ou dans mergeset des lignes triées. Nous pouvons passer avec un curseur et trouver l'intersection. Mais pourquoi ne l'utilisons-nous pas ? Parce que c'est lent. Parce que les curseurs impliquent que pour chaque ligne, une fonction doit être appelée. L'appel de fonction prend 5 nanosecondes. Et si vous avez 100 000 000 de lignes, cela signifie que nous perdons une demi-seconde juste pour l'appel de fonction.
Ça existe, oui. Et j'ai une dernière question. Peut-être que cette question peut sembler un peu étrange. Pourquoi, au moment de l'arrivée des données, ne peut-on pas calculer tous les agrégats nécessaires et les enregistrer dans le format requis ? Pourquoi stocker de gros volumes dans des systèmes comme VictoriaMetrics, ClickHouse, etc., pour ensuite passer beaucoup de temps à les traiter ?
Je vais donner un exemple pour que ce soit plus clair. Supposons, comment fonctionne un petit compteur de vitesse en jouet ? Il enregistre la distance que vous avez parcourue, en l'additionnant constamment à une valeur, et le temps à une autre. Puis il divise. Et obtient la vitesse moyenne. Vous pouvez faire à peu près la même chose. Additionner à la volée tous les faits nécessaires.
Bien, j'ai compris la question. Votre exemple a du sens. Si vous savez quels agrégats vous avez besoin, c'est la meilleure façon de procéder. Mais le problème, c'est que les gens conservent ces métriques, certaines données dans ClickHouse, et ils ne savent pas encore comment ils vont les agréger, les filtrer à l'avenir, donc ils doivent garder toutes les données brutes. Mais si vous savez que vous devez calculer une moyenne, pourquoi ne pas le faire au lieu de conserver une multitude de valeurs brutes ? Mais cela n'est valable que si vous savez exactement ce dont vous avez besoin.
Au fait, les bases de données pour le stockage de séries temporelles supportent le calcul d'agrégats. Par exemple, Prometheus supporte . C'est-à-dire que cela peut être fait si vous savez quels agrégats vous aurez besoin. Dans VictoriaMetrics, ce n'est pas encore le cas, mais Prometheus est généralement placé devant elle, où cela peut être réalisé dans les règles d'enregistrement.
Par exemple, dans mon précédent emploi, il fallait compter le nombre d'événements dans une fenêtre glissante sur la dernière heure. Le problème, c'est qu'il a fallu faire une implémentation personnalisée en Go, c'est-à-dire un service pour compter cela. Ce service s'est finalement révélé non trivial, car c'est difficile à compter. L'implémentation peut être simple si vous devez calculer certains agrégats à des intervalles de temps fixes. Mais si vous voulez compter des événements dans une fenêtre glissante, ce n'est pas aussi simple qu'il n'y paraît. Je pense que cela n'est toujours pas implémenté dans ClickHouse ou dans les bases de données de séries temporelles, car c'est difficile à réaliser.
Et une autre question. Nous avons parlé de moyennage, et je me souviens qu'il y avait autrefois quelque chose comme Graphite avec le backend Carbon. Et il savait réduire les anciennes données, c'est-à-dire laisser un point par minute, un point par heure, etc. En principe, c'est assez pratique si nous avons besoin de données brutes, disons, pour un mois, et tout le reste peut être réduit. Mais Prometheus et VictoriaMetrics ne prennent pas en charge cette fonctionnalité. Est-il prévu de le prendre en charge ? Si non, pourquoi ?
Merci pour votre question. Nos utilisateurs la posent régulièrement. Ils demandent quand nous ajouterons la prise en charge de l'échantillonnage (downsampling). Il y a plusieurs problèmes. Tout d'abord, chaque utilisateur comprend sous downsampling quelque chose de différent : certains souhaitent obtenir n'importe quel point arbitraire sur un intervalle donné, d'autres désirent des valeurs maximales, minimales ou moyennes. Si plusieurs systèmes écrivent des données dans votre base, il est impossible de tout traiter de la même manière. Il se peut que chaque système nécessite un échantillonnage différent. Et cela complique la mise en œuvre.
Deuxièmement, VictoriaMetrics, tout comme ClickHouse, est optimisé pour travailler avec de grands volumes de données brutes, donc il peut traiter un milliard de lignes en moins d'une seconde si vous disposez de nombreux cœurs dans votre système. Le balayage des points de séries temporelles dans VictoriaMetrics atteint 50 000 000 de points par seconde par cœur. Et cette performance se scale sur les cœurs disponibles. Par exemple, si vous avez 20 cœurs, vous pourrez scanner un milliard de points par seconde. Cette caractéristique de VictoriaMetrics et ClickHouse réduit le besoin de downsampling.
Une autre caractéristique est que VictoriaMetrics compresse efficacement ces données. La compression est en moyenne de 0,4 à 0,8 octet par point en production. Chaque point consiste en un timestamp + une valeur, et elle est compressée à moins d'un octet en moyenne.
Serguei. J'ai une question. Quelle est la durée minimale d'un quantum d'enregistrement ?
Une milliseconde. Nous avons récemment eu une conversation avec d'autres développeurs de bases de données pour séries temporelles. Leur quantum minimum est d'une seconde. Dans Graphite, par exemple, c'est aussi une seconde. Dans OpenTSDB également, c'est une seconde. Dans InfluxDB, la précision est à la nanoseconde. Dans VictoriaMetrics, c'est une milliseconde, car dans Prometheus, c'est une milliseconde. VictoriaMetrics a initialement été développée comme un stockage à distance pour Prometheus. Mais aujourd'hui, il peut également stocker des données provenant d'autres systèmes.
La personne à qui je parlais dit qu'ils ont une précision d'une seconde — cela leur suffit, car cela dépend du type de données qui sont enregistrées dans la base de séries temporelles. Si ce sont des données DevOps ou des données d'infrastructure que vous collectez à des intervalles de 30 secondes ou d'une minute, alors une précision d'une seconde est suffisante, moins n'est pas nécessaire. En revanche, si vous collectez ces données à partir de systèmes de trading haute fréquence, alors vous avez besoin d'une précision à la nanoseconde.
La précision millisecondes de VictoriaMetrics convient à la fois pour les cas DevOps et peut convenir à la plupart des cas que j'ai mentionnés au début de ma présentation. La seule chose pour laquelle elle peut ne pas convenir est les systèmes de trading haute fréquence.
Merci ! Et une autre question. Quelle est la compatibilité avec PromQL ?
Compatibilité complète. VictoriaMetrics prend entièrement en charge PromQL. De plus, elle ajoute une fonctionnalité supplémentaire avancée à PromQL, appelée . Concernant cette fonctionnalité étendue, il y a une présentation sur YouTube. J'ai parlé lors du Monitoring Meetup au printemps à Saint-Pétersbourg.
Canal Telegram .
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Qu'est-ce qui vous empêche de passer à VictoriaMetrics comme stockage à long terme pour Prometheus ? (Écrivez dans les commentaires, je l'ajouterai au sondage))
71,4%Je n'utilise pas Prometheus5
28,6%Je ne savais pas pour VictoriaMetrics2
7 utilisateurs ont voté. 12 utilisateurs se sont abstenus.
Source : habr.com
