

Bonjour, amis de Habr. Comme d'habitude, nous continuons à partager des contenus intéressants en vue du lancement de nouveaux cours. Aujourd'hui, spécialement pour vous, nous avons traduit un article sur Google Cloud Spanner, coïncidant avec le lancement du cours .
Publié à l'origine sur .
En tant qu'entreprise qui propose de nombreuses solutions POS cloud pour les commerçants, les restaurateurs et les vendeurs en ligne dans le monde entier, Lightspeed utilise plusieurs types de plateformes de bases de données pour de nombreux cas d'utilisation transactionnels, analytiques et de recherche. Chacune de ces plateformes de bases de données a ses forces et ses faiblesses. Ainsi, lorsque Google a présenté Cloud Spanner sur le marché — avec des fonctionnalités prometteuses, sans précédent dans le monde des bases de données relationnelles, telles que la scalabilité horizontale quasi illimitée et un accord de niveau de service (SLA) de 99,999 % — nous n'avons pas pu résister à la tentation de l'essayer !
Pour fournir un aperçu complet de notre expérience avec Cloud Spanner, ainsi que des critères d'évaluation que nous avons utilisés, nous aborderons les sujets suivants :
- Nos critères d'évaluation
- Cloud Spanner en quelques mots
- Notre évaluation
- Nos conclusions
1. Nos critères d'évaluation
Avant d'approfondir les fonctionnalités de Cloud Spanner, ses similitudes et différences avec d'autres solutions sur le marché, discutons d'abord des principaux cas d'utilisation que nous avions en tête en considérant où déployer Cloud Spanner dans notre infrastructure :
- Comme un remplacement (prévalent) de la solution de base de données SQL traditionnelle
- En tant que solution OLTP avec prise en charge de l'OLAP
Remarque : Pour simplifier et faciliter la comparaison, cet article compare Cloud Spanner avec les options MySQL des familles de solutions GCP Cloud SQL et Amazon AWS RDS.
Utilisation de Cloud Spanner comme remplacement de la solution de base de données SQL traditionnelle
Dans un environnement de bases de données traditionnelles, lorsque le temps de réponse des requêtes à la base de données approche ou dépasse les seuils prédéfinis des applications (principalement en raison de l'augmentation du nombre d'utilisateurs et/ou de requêtes), plusieurs méthodes existent pour réduire le temps de réponse à des niveaux acceptables. Cependant, la plupart de ces solutions nécessitent une intervention manuelle.
Par exemple, la première étape à suivre consiste à examiner les différents paramètres de la base de données liés à la performance et à les configurer de manière à ce qu'ils correspondent le mieux aux modèles d'utilisation des applications. Si cela s'avère insuffisant, il est possible de choisir un dimensionnement vertical ou horizontal de la base de données.
Le dimensionnement vertical d'une application implique la mise à niveau de l'instance du serveur, généralement en ajoutant plus de processeurs/noyaux, plus de mémoire RAM, un stockage plus rapide, etc. L'ajout de ressources matérielles supplémentaires entraîne une augmentation des performances de la base de données, mesurée principalement en transactions par seconde et en latence des transactions pour les systèmes OLTP. Les systèmes de bases de données relationnelles (qui utilisent une approche multithreadée), tels que MySQL, se dimensionnent bien verticalement.
Cette approche présente plusieurs inconvénients, le plus évident étant la taille maximale du serveur disponible sur le marché. Une fois que la limite de la plus grande instance de serveur est atteinte, il ne reste qu'une seule option : le dimensionnement horizontal.
Le dimensionnement horizontal est une approche où l'on ajoute davantage de serveurs au cluster, afin d'augmenter idéalement les performances de manière linéaire avec l'ajout de serveurs. La plupart des de bases de données systèmes de bases de données se dimensionnent mal horizontalement ou ne se dimensionnent pas du tout. Par exemple, MySQL peut se dimensionner horizontalement pour les opérations de lecture en ajoutant des lecteurs esclaves, mais ne peut pas se dimensionner horizontalement pour les opérations d'écriture.
D'un autre côté, en raison de sa nature, Cloud Spanner peut facilement se dimensionner horizontalement avec un minimum d'intervention.
Base de données complète DBaaS doit être évaluée sous différents angles. Comme base, nous avons choisi la base de données cloud la plus populaire – pour Google, GCP Cloud SQL et pour Amazon, AWS RDS. Dans notre évaluation, nous nous sommes concentrés sur les catégories suivantes :
- Comparaison de fonctionnalités : étendue SQL, DDL, DML ; bibliothèques de connexion/connecteurs, support des transactions, etc.
- Support de développement : facilité de développement et de test.
- Support de l'administration : gestion des instances - par exemple, montée/descente en charge et mise à niveau des instances ; SLA, sauvegarde et restauration ; sécurité/contrôle d'accès.
Utilisation de Cloud Spanner comme solution OLTP avec support OLAP
Bien que Google ne déclare pas explicitement que Cloud Spanner est destiné au traitement analytique, il partage certains attributs avec d'autres moteurs comme Apache Impala & Kudu et YugaByte, conçus pour des charges de travail OLAP.
Même s'il n'y avait qu'une faible probabilité que Cloud Spanner inclue un moteur HTAP (traitement hybride transactionnel/analytique) évolutif horizontalement cohérent avec un ensemble de fonctionnalités OLAP (plus ou moins) utilisable, nous pensons que cela mériterait notre attention.
Cela dit, nous avons examiné les catégories suivantes :
- Chargement des données, index et support du partitionnement
- Performance des requêtes et DML
2. Cloud Spanner en bref
Google Spanner est un système de gestion de bases de données relationnelles (SGBDR) en cluster, utilisé par Google pour plusieurs de ses propres services. Google l'a rendu disponible au public pour les utilisateurs de Google Cloud Platform début 2017.
Voici quelques-uns des attributs de Cloud Spanner :
- Cluster SGBDR hautement cohérent et évolutif : utilise la synchronisation matérielle du temps pour garantir la cohérence des données.
- Support des transactions inter-table : les transactions peuvent couvrir plusieurs tables - pas nécessairement limitées à une seule table (contrairement à Apache HBase ou Apache Kudu).
- Tables basées sur la clé primaire : toutes les tables doivent avoir une clé primaire déclarée (KP), qui peut être composée de plusieurs colonnes de la table. Les données des tables sont stockées dans l'ordre de la KP, ce qui les rend très efficaces et rapides à rechercher par KP. Comme d'autres systèmes basés sur la KP, l'implémentation doit être modélisée en tenant compte des cas d'utilisation préalablement réfléchis pour atteindre .
- Tables alternées : les tables peuvent avoir des dépendances physiques entre elles. Les lignes de la table enfant peuvent correspondre aux lignes de la table parent. Cette approche accélère la recherche de relations qui peuvent être définies lors de la modélisation des données, par exemple lors de l'hébergement commun des clients et de leurs factures.
- Indexes : Cloud Spanner prend en charge les index secondaires. Un index se compose de colonnes indexées et de toutes les colonnes de la clé primaire. Si souhaité, l'index peut également contenir d'autres colonnes non indexées. Un index peut être entrelacé avec la table parent pour accélérer les requêtes. Plusieurs restrictions s'appliquent aux index, telles que le nombre maximum de colonnes supplémentaires pouvant être stockées dans l'index. De plus, les requêtes à travers les index peuvent être moins directes que dans d'autres SGBD.
« Cloud Spanner choisit automatiquement l'index seulement dans de rares cas. En particulier, Cloud Spanner ne choisit pas automatiquement un index secondaire si la requête demande des colonnes qui ne sont pas conservées dans ».
- Accord de niveau de service (SLA) : déploiement dans une seule région avec un SLA de 99,99 % ; déploiements multirégionaux avec un SLA de 99,999 %. Bien que l'accord de niveau de service soit simplement un accord et non une garantie, je crois que les employés de Google disposent de données suffisamment précises pour faire une telle affirmation. (Pour référence, 99,999 % équivaut à 26,3 secondes d'indisponibilité du service par mois.)
- En savoir plus :
Remarque : Le projet Apache Tephra ajoute un support avancé des transactions dans Apache HBase (qui est également maintenant implémenté dans Apache Phoenix en version bêta).
3. Notre évaluation
Ainsi, nous avons tous lu les déclarations de Google sur les avantages de Cloud Spanner — une montée en charge horizontale pratiquement illimitée tout en conservant une grande cohérence et des SLA très élevés. Bien que ces exigences soient en tout cas extrêmement difficiles à atteindre, notre objectif n'était pas de les contredire. Concentrons-nous plutôt sur d'autres éléments qui préoccupent la plupart des utilisateurs de bases de données : l'intégrité et la facilité d'utilisation.
Nous avons évalué Cloud Spanner comme un remplacement de Sharded MySQL.
Google Cloud SQL et Amazon AWS RDS, deux des bases de données OLTP les plus populaires sur le marché du cloud, offrent un large éventail de fonctionnalités. Cependant, pour évoluer au-delà de la taille d'un seul nœud, vous devez effectuer un partitionnement des applications. Cette approche ajoute une complexité supplémentaire tant pour les applications que pour l'administration. Nous avons examiné comment Spanner s'intègre dans le scénario de regroupement de plusieurs segments en une seule instance et quelles fonctionnalités (le cas échéant) pourraient devoir être sacrifiées.
Support SQL, DML et DDL, ainsi que connecteur et bibliothèques ?
Tout d'abord, lorsque vous démarrez avec n'importe quelle base de données, vous devez créer un modèle de données. Si vous pensez que vous pouvez connecter JDBC Spanner à votre outil SQL préféré, vous découvrirez que vous pouvez interroger vos données avec, mais que vous ne pouvez pas l'utiliser pour créer ou modifier des tables (DDL) ou pour toute opération d'insertion/mise à jour/suppression (DML). Le JDBC officiel de Google ne prend en charge ni l'un ni l'autre.
« Actuellement, les pilotes ne prennent pas en charge les opérateurs DML ou DDL ».
Documentation Spanner
Avec la console GCP, la situation n'est pas meilleure — vous ne pouvez envoyer que des requêtes SELECT. Heureusement, il existe un pilote JDBC communautaire qui prend en charge DML et DDL, y compris les transactions. . Bien que ce pilote soit extrêmement utile, l'absence d'un pilote JDBC propre à Google est surprenante. Heureusement, Google propose un large soutien pour les bibliothèques clientes (basées sur gRPC) : C#, Go, Java, node.js, PHP, Python et Ruby.
L'utilisation presque obligatoire des API personnalisées de Cloud Spanner (en raison de l'absence de DDL et DML dans JDBC) entraîne certaines limitations pour les zones de code associées, telles que les pools de connexions ou les frameworks de liaison de base de données (par exemple, Spring MVC). En général, avec JDBC, vous pouvez choisir librement votre pool de connexions préféré (par exemple, HikariCP, DBCP, C3PO, etc.), qui est éprouvé et fonctionne bien. Dans le cas des API personnalisées Spanner, nous devons nous appuyer sur les frameworks/pools de liaison/sessions que nous avons créés nous-mêmes.
Une structure orientée vers la clé primaire (PK) permet à Cloud Spanner d'accéder très rapidement aux données via la PK, mais entraîne également certains problèmes de requêtes.
- Vous ne pouvez pas mettre à jour la valeur de la clé primaire ; vous devez d'abord supprimer l'enregistrement avec la clé primaire d'origine et le réinsérer avec la nouvelle valeur. (Cela ressemble à d'autres bases de données orientées sur les clés primaires / mécanismes de stockage.)
- Tout opérateur UPDATE et DELETE doit spécifier la clé primaire dans la clause WHERE, donc il ne peut pas y avoir d'opérateurs DELETE vides - il doit toujours y avoir une sous-requête, par exemple : UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Absence d'une option d'auto-incrémentation ou de quelque chose de similaire qui définit une séquence pour le champ de la clé primaire. Pour que cela fonctionne, la valeur correspondante doit être créée du côté de l'application.
Index secondaires ?
Google Cloud Spanner prend en charge nativement les index secondaires. C'est une fonctionnalité très appréciée qui n'est pas toujours présente dans d'autres technologies. Apache Kudu ne prend actuellement pas en charge les index secondaires, et Apache HBase ne prend pas en charge les index directement, mais peut les ajouter via Apache Phoenix.
Les index dans Kudu et HBase peuvent être modélisés comme une table distincte avec une composition différente des clés primaires, mais l'atomicité des opérations effectuées sur la table parente et les tables d'index associées doit être gérée au niveau de l'application et n'est pas triviale dans une mise en œuvre correcte.
Comme mentionné dans la revue de Cloud Spanner, ses index peuvent différer des index MySQL. Il convient donc de faire preuve d'une attention particulière lors de la construction de requêtes et de l'analyse des performances afin de garantir l'utilisation de l'index approprié là où cela est nécessaire.
Vues ?
Les vues sont des objets très populaires et utiles dans une base de données. Elles peuvent être utiles pour un grand nombre de cas d'utilisation ; mes deux préférées sont le niveau d'abstraction logique et le niveau de sécurité. Malheureusement, Cloud Spanner ne prend pas en charge les vues. Cependant, cela ne nous limite que partiellement, car il n'y a pas de détail sur le niveau des colonnes pour les autorisations d'accès, où les vues pourraient être une solution acceptable.
Dans la documentation de Cloud Spanner, dans la section qui décrit en détail les quotas et les limites (), il y en a une en particulier qui peut poser problème pour certaines applications : Cloud Spanner a par défaut une limite de 100 bases de données par instance. Évidemment, cela peut devenir un véritable obstacle pour une base de données destinée à évoluer au-delà de 100 bases de données. Heureusement, après avoir discuté avec notre représentant technique de Google, nous avons découvert que cette limite peut être augmentée à pratiquement n'importe quelle valeur via le support technique de Google.
Support pour le développement ?
Cloud Spanner offre un support assez respectable pour les langages de programmation interagissant avec son API. Les bibliothèques officiellement prises en charge couvrent C#, Go, Java, node.js, PHP, Python et Ruby. La documentation est assez détaillée, mais comme c'est le cas avec d'autres technologies de pointe, la communauté est relativement petite par rapport aux technologies de bases de données les plus populaires, ce qui peut prolonger le temps nécessaire pour résoudre des cas d'utilisation ou des problèmes moins courants.
Et qu'en est-il du support pour le développement local ?
Nous n'avons pas trouvé de moyen de créer une instance Cloud Spanner dans un environnement local. Le plus proche que nous avons obtenu est une image Docker , qui est en principe similaire, mais en pratique très différente. Par exemple, CockroachDB peut utiliser PostgreSQL JDBC. Étant donné que l'environnement de développement doit être aussi proche que possible de l'environnement de production, Cloud Spanner n'est pas idéal, car il faut compter sur une instance Spanner complète. Pour économiser des coûts, vous pouvez opter pour une instance d'une seule région.
Support d'administration ?
Créer une instance Cloud Spanner est très simple. Il suffit de choisir entre la création d'une instance multi-régionale ou d'une instance d'une seule région, de spécifier la ou les régions et le nombre de nœuds. En moins d'une minute, l'instance sera lancée et prête à l'emploi.
Plusieurs métriques de base sont directement disponibles sur la page Spanner dans la console Google. Des vues plus détaillées sont accessibles via Stackdriver, où vous pouvez également définir des seuils pour les métriques et des politiques d'alerte.
Accès aux ressources ?
MySQL offre des configurations de permissions et de rôles utilisateurs très détaillées et étendues. Il est facile de gérer l'accès à une table spécifique, voire à un sous-ensemble de ses colonnes. Cloud Spanner utilise l'outil Google Identity & Access Management (IAM), qui permet d'établir des politiques et des permissions à un niveau très élevé. L'option la plus détaillée est la permission au niveau de la base de données, qui ne s'intègre pas dans la plupart des cas de production. Cette limitation vous oblige à ajouter des mesures de sécurité supplémentaires dans votre code, votre infrastructure, ou les deux, pour prévenir l'utilisation non autorisée des ressources Spanner.
Des sauvegardes ?
Pour parler simplement, il n'existe pas de sauvegardes dans Cloud Spanner. Bien que les exigences élevées du SLA de Google garantissent que vous ne perdrez aucune donnée en raison de pannes matérielles ou de bases de données, cela ne protège pas contre les erreurs humaines, les défauts d’application, etc. Nous savons tous que la haute disponibilité ne remplace pas une stratégie de sauvegarde réfléchie. Pour l'instant, la seule façon de sauvegarder les données est de les transférer par flux à partir de la base de données vers un environnement de stockage séparé.
Performance des requêtes ?
Pour charger les données et tester les requêtes, nous avons utilisé Yahoo! Cloud Serving Benchmark. Le tableau ci-dessous présente la charge de travail B YCSB avec un ratio de lecture de 95 % et d'écriture de 5 %.
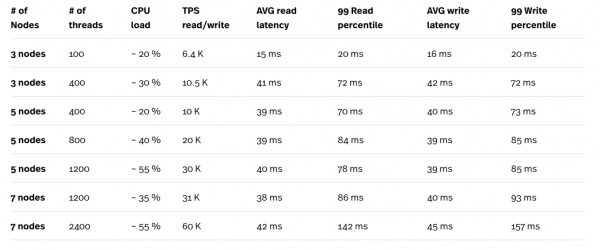
* Le test de charge a été effectué sur un moteur de calcul (CE) n1-standard-32 (32 vCPU, 120 Go de RAM), et l'instance de test n'a jamais été un goulot d'étranglement dans les tests.
** Le nombre maximum de threads dans une instance YCSB est de 400. Il a été nécessaire de lancer six instances parallèles des tests YCSB pour obtenir un total de 2400 threads.
En examinant les résultats des tests, notamment la combinaison de la charge du processeur et du TPS, nous pouvons clairement voir que Cloud Spanner évolue assez bien. Une forte charge, générée par un grand nombre de threads, est compensée par un grand nombre de nœuds dans le cluster Cloud Spanner. Bien que la latence semble assez élevée, surtout avec 2400 threads, des tests supplémentaires avec 6 instances plus petites du moteur de calcul pourraient être nécessaires pour obtenir des chiffres plus précis. Chaque instance exécutera un test YCSB au lieu d'une seule grande instance CE avec 6 tests parallèles. Cela permettra de mieux différencier la latence des requêtes Cloud Spanner et la latence ajoutée par la connexion réseau entre Cloud Spanner et l'instance CE sur laquelle le test est effectué.
Comment Cloud Spanner se comporte-t-il en tant qu'OLAP ?
Partitionnement ?
La division des données en segments physiquement et/ou logiquement indépendants, appelés partitions, est un concept très populaire dans la plupart des mécanismes OLAP. Les partitions peuvent améliorer considérablement les performances des requêtes et la maintenabilité de la base de données. Une exploration plus approfondie des partitions pourrait donner lieu à un article (ou plusieurs), donc mentionnons simplement l'importance d'avoir un schéma de partitionnement et de sous-partitionnement. La capacité à sectionner les données en partitions et même plus loin en sous-partitions est cruciale pour les performances des requêtes analytiques.
Cloud Spanner ne prend pas en charge les partitions en tant que telles. Il divise les données en ce qu'on appelle des splits- basés sur des plages de clés primaires. La division est effectuée automatiquement pour équilibrer la charge dans le cluster Cloud Spanner. Une fonctionnalité très pratique de Cloud Spanner est la répartition de la charge de la table parent (table qui n’est pas interleaved avec une autre). Spanner détermine automatiquement si splits des données sont plus fréquemment lues que celles d'autres splits- et peut décider de procéder à un partage supplémentaire. Ainsi, plus de nœuds peuvent être impliqués dans la requête, ce qui augmente également efficacement la capacité.
Chargement des données ?
La méthode Cloud Spanner pour les gros volumes de données est similaire à un chargement normal. Pour atteindre des performances optimales, vous devez suivre certaines recommandations, notamment :
- Triez vos données par clé primaire.
- Divisez-les en 10*nœuds sections séparées.
- Créez un ensemble de tâches de travail qui chargent les données en parallèle.
Avec ce type de chargement des données, tous les nœuds de Cloud Spanner sont utilisés.
Nous avons utilisé la charge de travail A YCSB pour générer un ensemble de données de 10 millions de lignes.
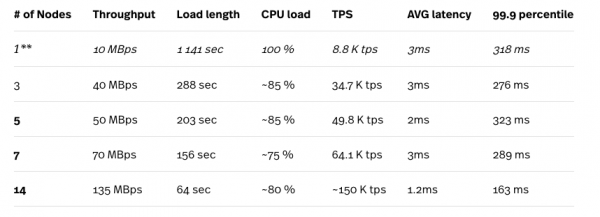
* Le test de charge a été réalisé sur le moteur de calcul n1-standard-32 (32 vCPU, 120 Go de RAM), et l'instance de test n'a jamais été un goulot d'étranglement lors des tests.
** Une configuration à 1 nœud n'est pas recommandée pour les charges de travail en production.
Comme mentionné ci-dessus, Cloud Spanner gère automatiquement les fractionnements en fonction de leur charge, donc les résultats s'améliorent après plusieurs répétitions consécutives du test. Les résultats présentés ici sont les meilleures performances que nous avons obtenues. En regardant les chiffres ci-dessus, nous pouvons voir comment Cloud Spanner (bien) évolue avec l'augmentation du nombre de nœuds dans le cluster. Les chiffres qui se démarquent représentent des latences moyennes extrêmement basses, qui contrastent avec les résultats de charges de travail mixtes (95 % pour la lecture et 5 % pour l'écriture), comme décrit dans la section ci-dessus.
Évoluer ?
Augmenter ou diminuer le nombre de nœuds de Cloud Spanner est une tâche qui se fait en un clic. Si vous souhaitez charger rapidement des données, vous pouvez envisager de booster l'instance à son maximum (dans notre cas, c'était 25 nœuds dans la région US-EAST), puis réduire le nombre de nœuds adapté à votre charge de travail normale, une fois que toutes les données sont dans la base de données, en gardant à l'esprit la limite de 2 To/nœud.
Nous avons été rappelés de cette limite même avec une base de données beaucoup plus petite. Après plusieurs exécutions de tests de charge, notre base de données faisait environ 155 Go, et en réduisant à une instance à 1 nœud, nous avons rencontré l'erreur suivante :
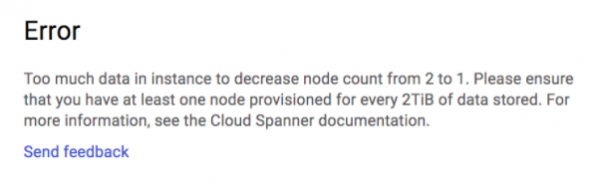
Nous avons réussi à réduire la portée de 25 à 2 instances, mais nous sommes restés bloqués sur deux nœuds.
L'augmentation et la réduction du nombre de nœuds dans un cluster Cloud Spanner peuvent être automatisées via l'API REST. Cela peut être particulièrement utile pour diminuer une charge accrue sur le système aux heures de pointe.
Comment se porte les performances des requêtes OLAP ?
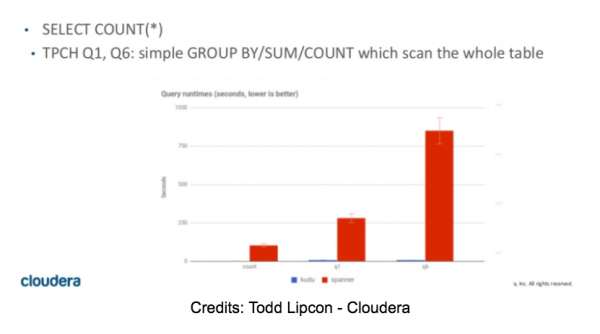
À l'origine, nous avions prévu de consacrer beaucoup de temps à notre évaluation de Spanner sur cette partie. Après plusieurs SELECT COUNT, nous avons immédiatement compris que le test serait bref et que Spanner NE serait pas adapté comme moteur OLAP. Peu importe le nombre de nœuds dans le cluster, une simple sélection du nombre de lignes dans une table de 10M de lignes a pris entre 55 et 60 secondes. De plus, toute requête nécessitant plus de mémoire pour stocker des résultats intermédiaires s'est terminée par une erreur OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M de valeurs distinctes) -> SpoolingHashAggregateIterator a manqué de mémoire lors de la création de nouvelles lignes.
Certaines données concernant les requêtes TPC-H peuvent être trouvées dans l'article de Todd Lipkon , diapositives 42 et 43. Ces chiffres sont en accord avec nos propres résultats (malheureusement).
4. Nos conclusions
Étant donné l'état actuel des fonctionnalités de Cloud Spanner, il est difficile de l'imaginer comme un simple remplacement d'une solution OLTP existante, surtout lorsque vos besoins dépasseront ses capacités. Il faudrait dépenser un temps considérable pour construire une solution en tenant compte des lacunes de Cloud Spanner.
Lorsque nous avons commencé l'évaluation de Cloud Spanner, nous nous attendions à ce que ses fonctionnalités de gestion soient au niveau ou, du moins, pas très éloignées des autres solutions Google SQL. Mais nous avons été surpris par l'absence totale de sauvegardes et le contrôle d'accès très limité sur les ressources. Sans parler de l'absence de vues, de l'absence d'un environnement de développement local, de séquences non prises en charge, de JDBC sans support DML et DDL, etc.
Alors, que faire pour ceux qui doivent mettre à l'échelle une base de données transactionnelle ? Il semble qu'il n'y ait pas encore de solution unique sur le marché qui convienne à tous les cas d'utilisation. Il existe de nombreuses solutions à code source fermé et ouvert (certaines d'entre elles sont mentionnées dans cet article), chacune ayant ses forces et ses faiblesses, mais aucune d'entre elles n'offre de SaaS avec un SLA de 99,999 % et un haut niveau de cohérence. Si un niveau élevé de SLA est votre objectif principal et que vous n'êtes pas enclin à créer votre propre solution pour plusieurs environnements cloud, Cloud Spanner pourrait être la solution que vous recherchez. Mais vous devez être conscient de toutes ses limitations.
Pour être juste, il faut noter que Cloud Spanner a été rendu accessible au public au printemps 2017, il est donc raisonnable de s'attendre à ce que certains de ses défauts actuels puissent éventuellement disparaître (nous l'espérons), et lorsque cela se produira, cela pourrait changer la donne. Après tout, Cloud Spanner n'est pas simplement un projet tiers pour Google. Google l'utilise comme base pour d'autres produits Google. Et lorsque Google a récemment remplacé Megastore dans Google Cloud Storage par Cloud Spanner, cela a permis à Google Cloud Storage d'être strictement cohérent pour les listes d'objets à l'échelle mondiale (ce qui n'est toujours pas le cas pour ).
Donc, il y a toujours de l'espoir... nous espérons.
C'est tout. Comme l'auteur de l'article, nous continuons également à espérer, et que pensez-vous à ce sujet ? Écrivez vos commentaires.
Nous invitons tous les intéressés à visiter notre dans le cadre duquel nous expliquerons en détail le cours d'OTUS.
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish