

Nous examinerons le fonctionnement de Zabbix avec la base de données TimescaleDB en tant que backend. Nous montrerons comment démarrer à partir de zéro et comment migrer depuis PostgreSQL. Nous fournirons également des tests comparatifs de performance entre les deux configurations.
HighLoad++ Sibérie 2019. Salle « Tomsk ». 24 juin, 16h00. Thèses et . La prochaine conférence HighLoad++ se tiendra les 6 et 7 avril 2020 à Saint-Pétersbourg. Détails et billets .
Andrei Goutchin (ci-après – AG) : – Je suis ingénieur support technique ZABBIX (ci-après – « Zabbix »), formateur. Je travaille depuis plus de 6 ans dans le support technique et j'ai été directement confronté à la performance. Aujourd'hui, je vais parler de la performance que peut offrir TimescaleDB par rapport à un PostgreSQL ordinaire 10. Je ferai également une petite introduction sur le fonctionnement général.
Les principaux défis de performance : de la collecte à la purification des données
Commençons par le fait qu'il existe certains défis de performance auxquels chaque système de monitoring est confronté. Le premier défi de performance est la collecte et le traitement rapide des données.
Un bon système de surveillance doit recevoir rapidement et en temps voulu toutes les données, les traiter selon des expressions de déclenchement, c'est-à-dire les traiter selon certains critères (cela varie d'un système à l'autre) et les conserver dans une base de données, afin que ces données puissent être utilisées ultérieurement.
Le deuxième défi de performance est le stockage de l'historique. Il est souvent nécessaire de conserver des données dans une base de données et d'avoir un accès rapide et pratique à ces métriques qui ont été collectées sur une certaine période. L'essentiel est que ces données soient facilement accessibles, pour pouvoir les utiliser dans des rapports, des graphiques, des déclencheurs, des valeurs seuils, des alertes, etc.
Le troisième défi de performance est la purification de l'historique, c'est-à-dire lorsque vous atteignez un jour où vous n'avez plus besoin de conserver certaines métriques détaillées collectées au cours des 5 dernières années (même de quelques mois ou de deux mois). Certains nœuds du réseau ont été supprimés, ou certains hôtes, les métriques ne sont plus nécessaires car elles sont obsolètes et ne sont plus collectées. Tout cela doit être nettoyé pour que votre base de données ne devienne pas trop volumineuse. De manière générale, la purification de l'historique constitue souvent un véritable défi pour le stockage, car cela affecte souvent la performance.
Comment résoudre les problèmes de mise en cache ?
Je vais maintenant parler spécifiquement de « Zabbix ». Dans « Zabbix », le premier et le deuxième appels sont résolus par le biais de la mise en cache.
Collecte et traitement des données - nous utilisons la mémoire vive pour stocker toutes ces données. Ces données seront détaillées plus loin.
Il existe également une certaine mise en cache du côté de la base de données pour les ensembles de données principaux - pour les graphiques, d'autres éléments.
Mise en cache du côté du serveur Zabbix : nous avons ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Qu'est-ce que cela signifie ?
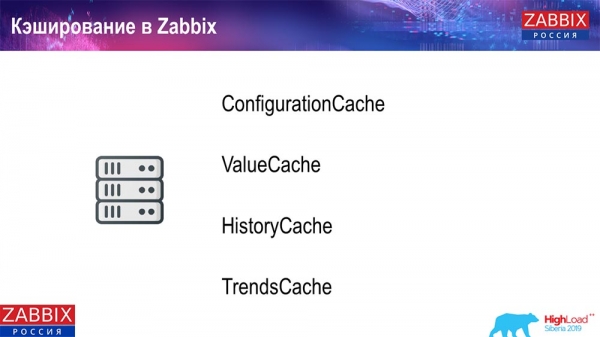
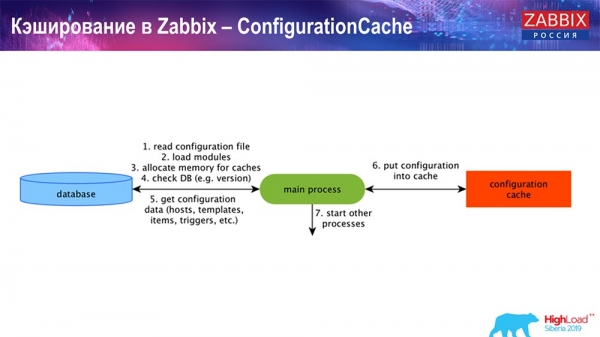
ConfigurationCache est la mémoire cache principale où nous stockons les métriques, les hôtes, les éléments de données, les déclencheurs ; tout ce qui est nécessaire pour le prétraitement, la collecte de données, les hôtes à partir desquels collecter, à quelle fréquence. Tout cela est stocké dans ConfigurationCache, afin de ne pas avoir à interroger la base de données pour éviter des requêtes superflues. Après le démarrage du serveur, nous mettons à jour ce cache (le créons) et le mettons à jour régulièrement (selon les paramètres de configuration).
Mise en cache dans Zabbix. Collecte de données
Ici, le schéma est assez important :
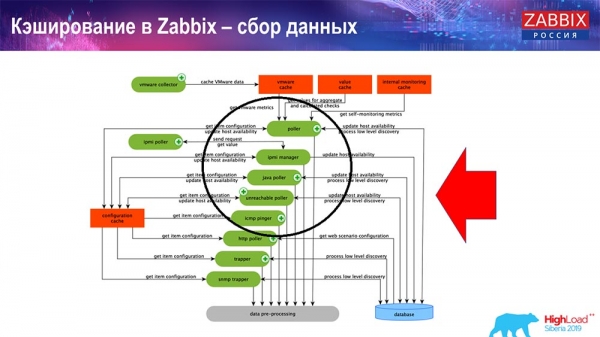
Les principaux éléments du schéma sont ces collecteurs :
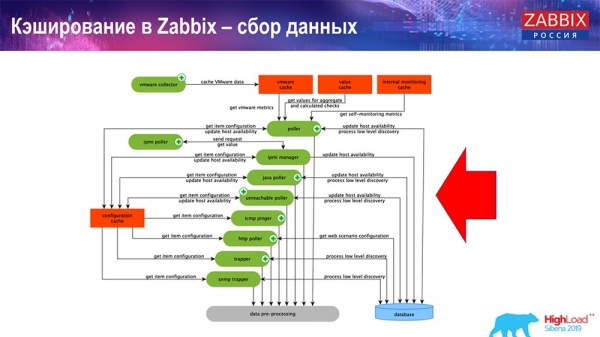
Ce sont les processus de collecte eux-mêmes, divers « pollers », qui sont responsables de différents types de collectes. Ils collectent des données via icmp, ipmi, différents protocoles et transmettent tout cela au prétraitement.
Prétraitement HistoryCache
De plus, s'il y a des éléments de données calculés (ceux qui connaissent « Zabbix » le savent), c'est-à-dire des éléments de données calculés, d'agrégation - nous les extrayons directement de ValueCache. Je parlerai plus tard de la façon dont il est alimenté. Tous ces collecteurs utilisent ConfigurationCache pour recevoir leurs tâches et transmettent ensuite pour le prétraitement.
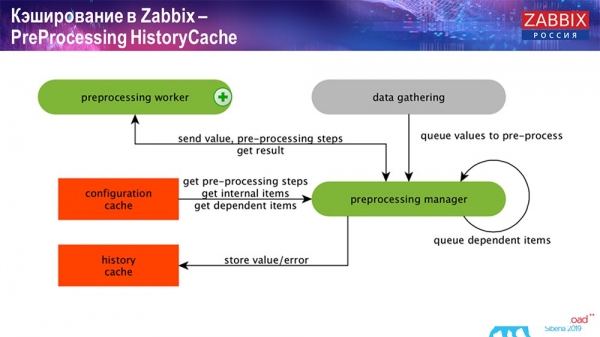
Le prétraitement utilise également ConfigurationCache pour obtenir les étapes de prétraitement, traitant ces données de diverses manières. À partir de la version 4.2, il a été déporté vers le proxy. C'est très pratique, car le prétraitement est une opération assez lourde. Et si vous avez un très grand « Zabbix », avec un grand nombre d'éléments de données et une fréquence de collecte élevée, cela facilite énormément le travail.
Par conséquent, après avoir traité ces données d'une manière ou d'une autre à l'aide du prétraitement, nous les enregistrons dans HistoryCache pour une utilisation ultérieure. C'est là que se termine la collecte de données. Nous passons au processus principal.
Fonctionnement du syncer d'historique
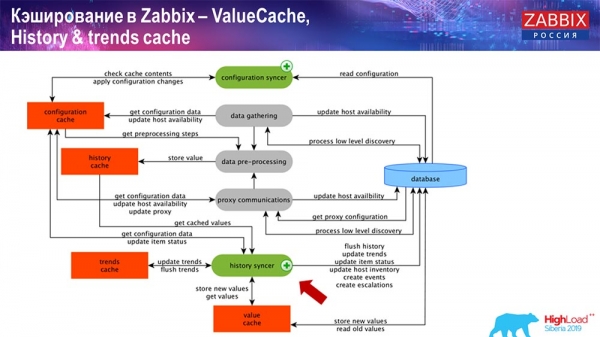
Le principal processus dans «Zabbix» (car il s'agit d'une architecture monolithique) est le synchroniseur d'historique. C'est le processus principal qui s'occupe du traitement atomique de chaque élément de donnée, c'est-à-dire chaque valeur :
- une valeur arrive (il la prend du HistoryCache);
- il vérifie dans le synchroniseur de configuration : y-a-t-il des déclencheurs à évaluer – il les calcule;
s'il y en a – il crée des événements, génère une escalade pour créer une alerte si nécessaire selon la configuration; - il enregistre les déclencheurs pour un traitement et une agrégation ultérieurs; si vous agrégerez sur la dernière heure, par exemple, cette valeur est mémorisée dans le ValueCache, afin de ne pas interroger la table d'historique; ainsi, le ValueCache est rempli des données nécessaires pour le calcul des déclencheurs, des éléments calculés, etc.;
- ensuite, le synchroniseur d'historique enregistre toutes les données dans la base de données;
- la base de données les enregistre sur le disque – à ce moment, le processus de traitement se termine.
Bases de données. Mise en cache
Du côté de la BDD, lorsque vous souhaitez consulter des graphiques ou des rapports sur les événements, il existe divers caches. Mais dans le cadre de cette présentation, je ne vais pas en parler.
Pour MySQL, il y a Innodb_buffer_pool, ainsi qu'une multitude d'autres caches qui peuvent également être configurés.
Mais voici les principaux :
- shared_buffers;
- effective_cache_size;
- shared_pool.
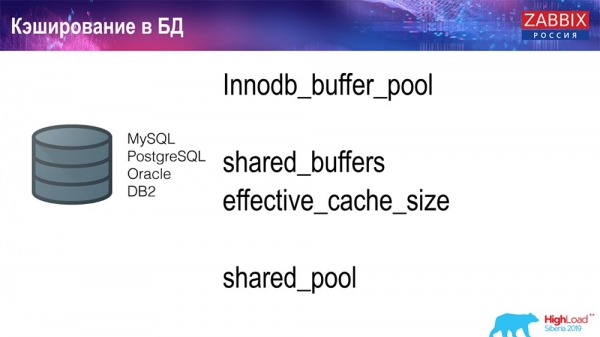
Pour toutes les bases de données, j'ai mentionné qu'il existe certains caches qui permettent de garder en mémoire vive les données souvent nécessaires pour les requêtes. Ils ont leurs propres technologies pour cela.
Sur la performance de la base de données
Par conséquent, il existe un environnement concurrentiel, c'est-à-dire que le serveur «Zabbix» collecte des données et les enregistre. Lors d'un redémarrage, il lit également l'historique pour remplir le ValueCache et ainsi de suite. Vous pouvez aussi avoir des scripts et des rapports qui utilisent l'API «Zabbix», qui est construite sur la base d'une interface web. L'API «Zabbix» accède à la BDD et obtient les données nécessaires pour obtenir des graphiques, des rapports ou une liste d'événements, des problèmes récents.
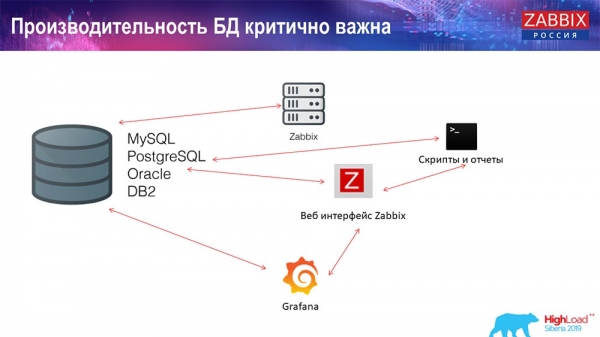
Une solution de visualisation très populaire est Grafana, que nos utilisateurs utilisent. Elle sait accéder directement à la fois via l'API «Zabbix» et la BDD. Elle crée aussi une certaine concurrence pour l'obtention de données : une configuration de BDD plus fine et meilleure est nécessaire pour garantir une restitution rapide des résultats et des tests.
Nettoyage de l'historique. Dans Zabbix, il existe un Housekeeper
Le troisième appel utilisé dans « Zabbix » est le nettoyage de l'historique via le Housekeeper. Le « Housekeeper » respecte tous les paramètres, c'est-à-dire que nous avons dans les éléments de données indiqué combien de temps conserver (en jours), combien de temps conserver les tendances, la dynamique des changements.
Je n'ai pas parlé de TrendCache, que nous calculons à la volée : les données arrivent, nous les agrégeons sur une heure (principalement ce sont des chiffres de la dernière heure), quantité moyenne / minimum et nous les enregistrons une fois par heure dans la table de dynamique des changements (« Trends »). Le « Housekeeper » est lancé et supprime les données de la base de données par des sélections ordinaires, ce qui n'est pas toujours efficace.
Comment comprendre que ce n'est pas efficace ? Vous pouvez voir sur les graphiques de performance des processus internes cette image :
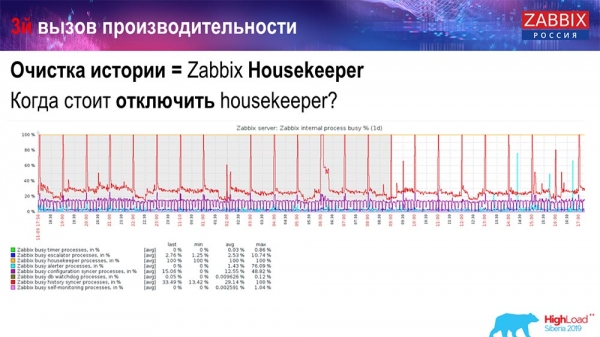
Votre History syncer est constamment occupé (graphique rouge). Et le graphique « orange », qui se trouve au-dessus. C'est le « Housekeeper », qui est lancé et attend de la base de données qu'elle supprime toutes les lignes qu'il a définies.
Prenons un ID d'élément quelconque : il faut supprimer les 5 000 derniers ; bien sûr, par index. Mais généralement, le dataset est suffisamment grand - la base de données le lit toujours depuis le disque et le charge en cache, et c'est une opération très coûteuse pour la base de données. Selon sa taille, cela peut entraîner certains problèmes de performance.
Désactiver le « Housekeeper » peut se faire facilement - nous avons une interface web bien connue. Dans le paramétrage de l'Administration générale (paramètres pour le « Housekeeper »), nous désactivons le nettoyage interne pour l'historique et les tendances. Par conséquent, le « Housekeeper » ne gère plus cela :
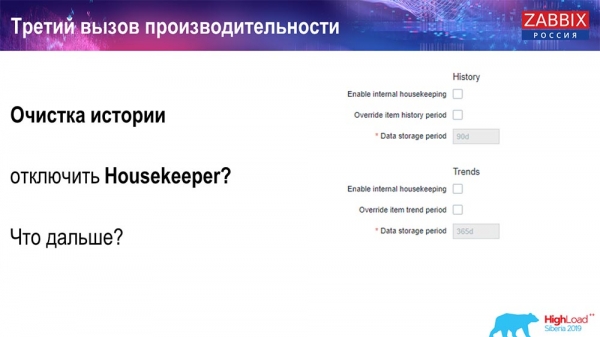
Que peut-on faire ensuite ? Vous avez désactivé, vos graphiques se sont redressés… Quels problèmes peuvent encore survenir dans ce cas ? Qu'est-ce qui peut aider ?
Partitionnement (sectionnement)
Cela se configure généralement sur chaque base de données relationnelle que j'ai énumérée, de différentes manières. Sur MySQL, il y a sa propre technologie. Mais dans l'ensemble, elles sont très similaires lorsqu'on parle de PostgreSQL 10 et MySQL. Bien sûr, il y a beaucoup de différences internes sur la façon dont tout cela est mis en œuvre et comment cela impacte la performance. Mais dans l'ensemble, la création d'une nouvelle partition entraîne souvent aussi certains problèmes.
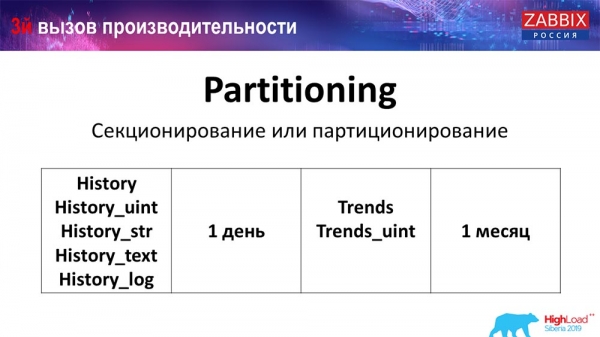
Selon votre configuration (en fonction du volume de données généré par jour), la durée minimale généralement attribuée est d'un jour/partition, et pour les « tendances », la dynamique des changements est d'un mois/nouvelle partition. Cela peut varier si vous avez une très grande configuration.
Commençons par parler des tailles de configuration : jusqu'à 5 000 nouvelles valeurs par seconde (ce qu'on appelle NVPS) est considéré comme une petite configuration. Une moyenne va de 5 000 à 25 000 valeurs par seconde. Tout ce qui dépasse cela correspond à de grandes et très grandes installations, nécessitant un réglage très précis de la base de données.
Sur de très grandes installations, une durée d'un jour peut ne pas être optimale. J'ai personnellement observé des partitions MySQL allant jusqu'à 40 Go par jour (et plus). C'est un volume de données très important qui peut poser certains problèmes. Il faut le réduire.
Pourquoi la partitionnement est-il nécessaire ?
Ce que le partitionnement apporte, je pense que tout le monde le sait – c'est la ségrégation des tables. Souvent, ce sont des fichiers distincts sur le disque et des requêtes segmentées. Il sélectionne plus efficacement une partition si cela s'inscrit dans le partitionnement habituel.
Pour « Zabbix », en particulier, il s'utilise par plage, c'est-à-dire que nous utilisons un horodatage (un nombre ordinaire, le temps depuis le début de l'époque). Vous définissez le début et la fin de la journée, ce qui constitue la partition. Ainsi, si vous accédez aux données datant de deux jours, celles-ci sont récupérées de la base de données plus rapidement, car il suffit de charger un seul fichier dans le cache et de le délivrer (plutôt qu'une grande table).
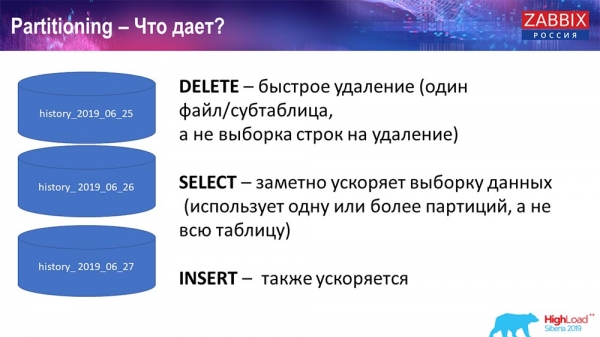
De nombreuses bases de données accélèrent également l'insertion (ajout dans une table enfant). Je parle de manière abstraite, mais c'est aussi possible. Le partitionnement est souvent bénéfique.
Elasticsearch pour NoSQL
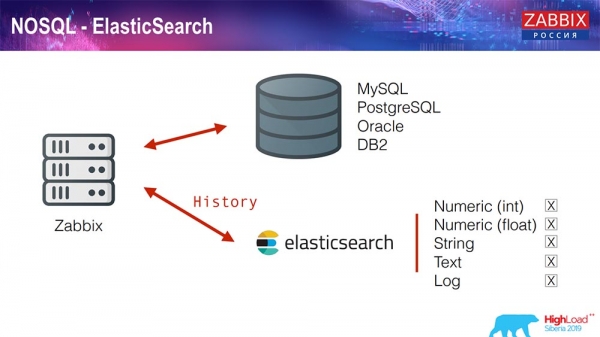
Récemment, dans la version 3.4, nous avons introduit une solution pour NoSQL. Nous avons ajouté la possibilité d'écrire dans Elasticsearch. Vous pouvez écrire différents types : choisir – soit des chiffres, soit des symboles ; nous avons du texte string, vous pouvez écrire des journaux dans Elasticsearch… Ainsi, l'interface web interagira également avec Elasticsearch. Cela fonctionne très bien dans certains cas, mais pour le moment, c'est utilisable.
TimescaleDB. Hyper-tables
Pour la version 4.4.2, nous avons remarqué une chose concernant TimescaleDB. Qu'est-ce que c'est ? C'est une extension pour PostgreSQL, c'est-à-dire qu'elle a une interface native PostgreSQL. De plus, cette extension permet de travailler de manière beaucoup plus efficace avec les données de séries temporelles et d'avoir un partitionnement automatique. Voici à quoi cela ressemble :
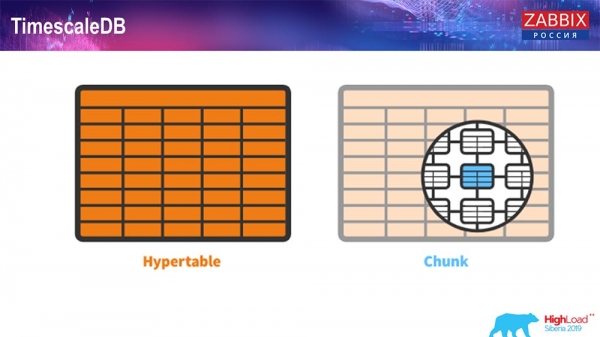
C'est un hypertable – c'est un concept dans Timescale. C'est une hypertable que vous créez, et à l'intérieur se trouvent des chunks. Les chunks sont des partitions, des sous-tables, si je ne me trompe pas. C'est vraiment efficace.
TimescaleDB et PostgreSQL
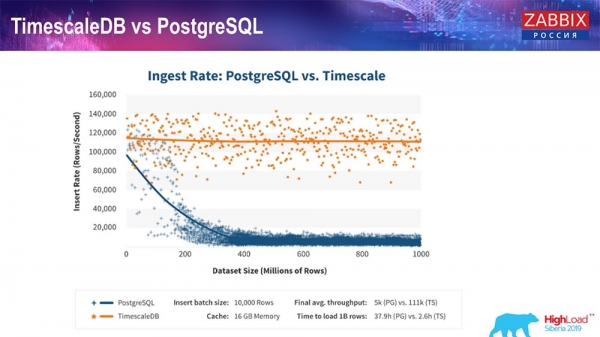
Selon les producteurs de TimescaleDB, ils utilisent un algorithme de traitement de requêtes plus optimal, en particulier pour les insertions, qui permet d'avoir une performance quasi constante avec une taille de jeu de données croissante. Autrement dit, après 200 millions de lignes, PostgreSQL commence à ralentir considérablement et perd presque toute sa performance, tandis que Timescale permet d'insérer des données aussi efficacement que possible, quel que soit le volume.
Comment installer TimescaleDB ? C'est simple !
Il y a cela dans sa documentation, c'est écrit – vous pouvez l'installer à partir des paquets pour divers systèmes… Il dépend des paquets officiels de PostgreSQL. Vous pouvez le compiler manuellement. Il se trouve que j'ai dû le compiler pour la base de données.
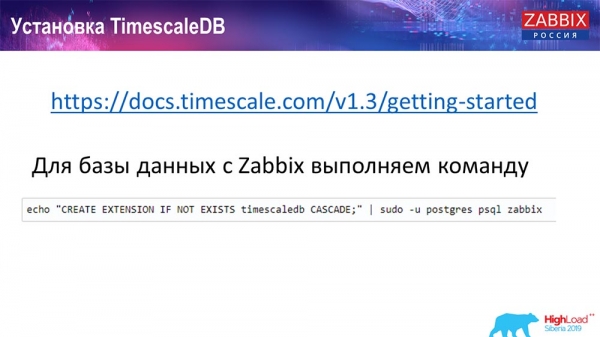
Pour Zabbix, nous activons simplement l'extension. Je pense que ceux qui ont déjà utilisé une extension dans PostgreSQL… Vous activez simplement l'extension, vous la créez pour la base de données Zabbix que vous utilisez.
Et la dernière étape…
TimescaleDB. Migration des tables d'historique
Vous devez créer un hypertable. Pour ce faire, il existe une fonction spéciale – Create hypertable. Dans celle-ci, vous indiquez en premier paramètre la table dont vous avez besoin dans cette base pour créer l'hypertable.
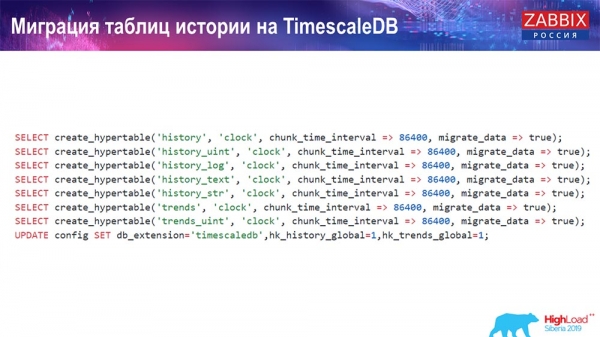
Le champ selon lequel vous souhaitez créer, et chunk_time_interval (c'est l'intervalle des chunks (partitions à utiliser). 86 400 – c'est un jour.
Paramètre migrate_data : si vous le mettez à true, cela déplace toutes les données actuelles vers les chunks créés à l'avance.
J'ai moi-même utilisé migrate_data – cela prend un certain temps, en fonction de la taille de votre base de données. J'avais plus d'un téraoctet – la création a pris plus d'une heure. Dans certains cas, lors de tests, j'ai supprimé des données historiques pour le texte (history_text) et la chaîne (history_str), pour ne pas les transférer – elles ne m'intéressaient vraiment pas.
Et la dernière mise à jour que nous faisons dans notre db_extension : nous installons timescaledb, afin que la base de données et, en particulier, notre « Zabbix », comprennent qu'il y a une db_extension. Il l'active et utilise correctement la syntaxe et les requêtes à la base de données, en utilisant déjà les « fonctionnalités » nécessaires pour TimescaleDB.
Configuration du serveur
J'ai utilisé deux serveurs. Le premier serveur est une machine virtuelle assez petite, avec 20 processeurs et 16 gigaoctets de mémoire vive. J'ai configuré « PostgreSQL » 10.8 dessus :
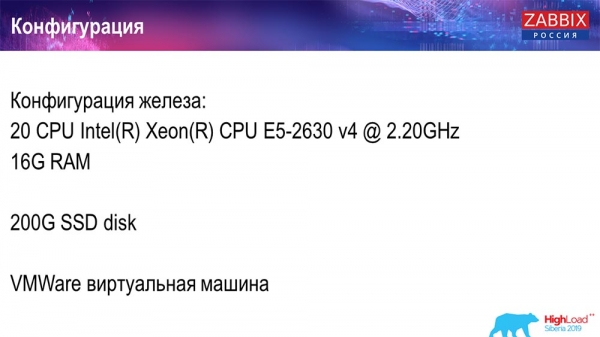
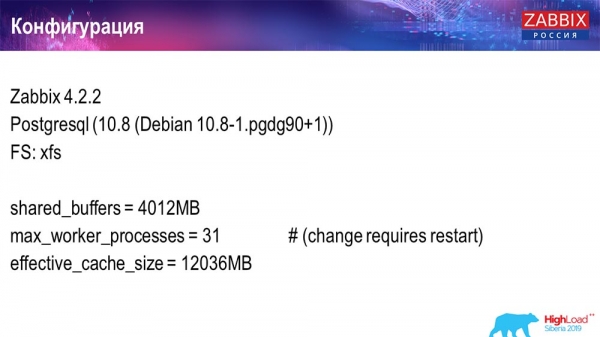
Le système d'exploitation était Debian, et le système de fichiers – xfs. J'ai effectué des réglages minimaux pour utiliser spécifiquement cette base de données, en tenant compte de ce que « Zabbix » utiliserait lui-même. Sur cette même machine se trouvaient le serveur « Zabbix », PostgreSQL et des agents de charge.
J'ai utilisé 50 agents actifs, qui exploitent LoadableModule pour générer rapidement différents résultats. Ils ont généré des chaînes, des nombres, etc. J'ai alimenté la base de données avec un grand nombre de données. À l'origine, la configuration contenait 5 000 éléments de données par hôte, et environ chaque élément de données avait un déclencheur – afin que ce soit une véritable configuration. Parfois, l'utilisation nécessite même plus d'un déclencheur.
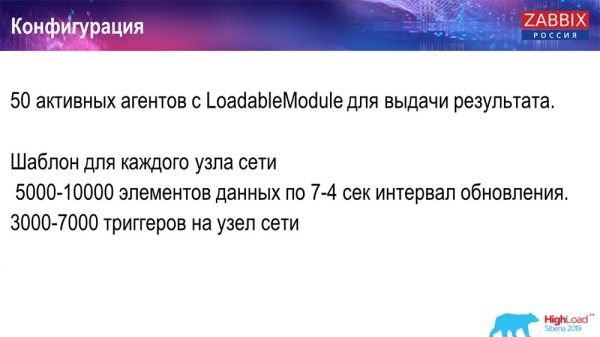
J'ai régulé l'intervalle de mise à jour et la charge, non seulement en utilisant 50 agents (j'en ai ajouté d'autres), mais aussi grâce à des éléments de données dynamiques, réduisant l'intervalle de mise à jour à 4 secondes.
Test de performance. PostgreSQL : 36 000 NVPs
La première exécution, le premier setup que j'ai fait était sur du PostgreSQL 10 vierge sur ce matériel (35 000 valeurs par seconde). Dans l'ensemble, comme on peut le voir à l'écran, l'insertion de données prend des fractions de seconde – tout est bon et rapide, disques SSD (200 gigaoctets). La seule chose est que 20 Go se remplissent assez rapidement.
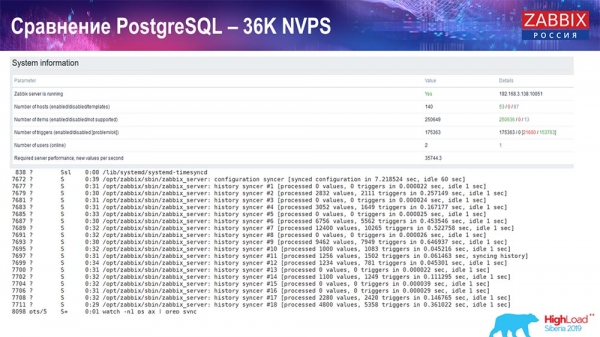
Il y aura pas mal d'autres graphiques de ce type. C'est le tableau de bord standard de performance du serveur « Zabbix ».
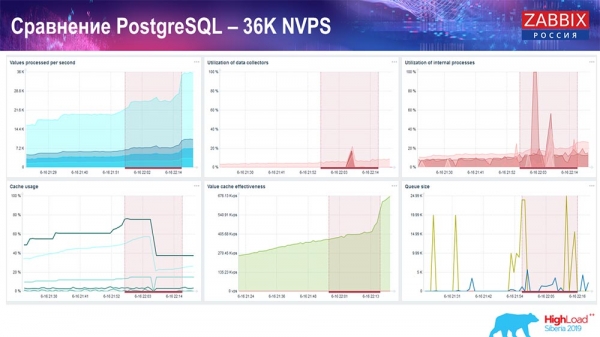
Le premier graphique – le nombre de valeurs par seconde (en bleu, en haut à gauche), 35 000 valeurs dans ce cas. Cela (en haut au centre) indique la charge des processus d'assemblage, et cela (en haut à droite) – la charge des processus internes : history syncers et housekeeper, qui ici (en bas au centre) a fonctionné pendant une durée suffisante.
Ce graphique (en bas au centre) montre l'utilisation de ValueCache – combien de hits ValueCache pour les déclencheurs (plusieurs milliers de valeurs par seconde). Un autre graphique important est le quatrième (en bas à gauche), qui montre l'utilisation de HistoryCache, que j'ai mentionné, qui sert de tampon avant d'insérer dans la base de données.
Test de performance. PostgreSQL : 50 000 NVPs
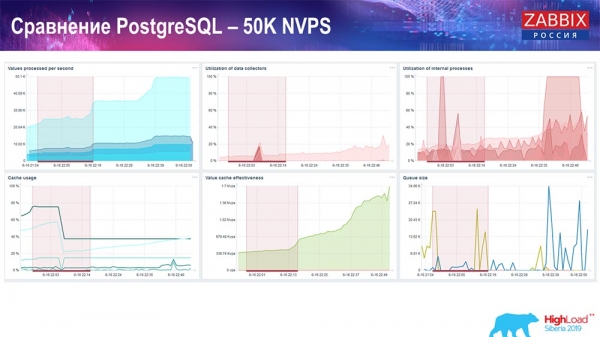
Ensuite, j'ai augmenté la charge à 50 000 valeurs par seconde sur ce même matériel. Lors du chargement par le 'Housekeeper', 10 000 valeurs étaient déjà enregistrées en 2-3 secondes avec calcul. Ce qui est, en fait, montré sur la capture d'écran suivante :
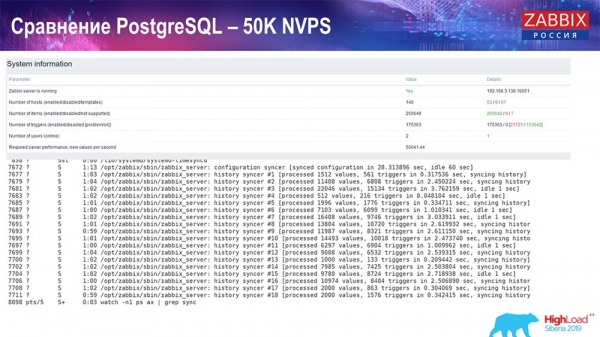
Le 'Housekeeper' commence déjà à interférer avec le fonctionnement, mais globalement la charge des trappes des history-syncers est encore à 60 % (troisième graphique, en haut à droite). HistoryCache commence déjà à se remplir activement pendant le fonctionnement du 'Housekeeper' (en bas à gauche). Il était d'environ un demi-gigaoctet, rempli à 20 %.
Test de performance. PostgreSQL : 80 000 NVPs
Ensuite, j'ai augmenté à 80 000 valeurs par seconde :
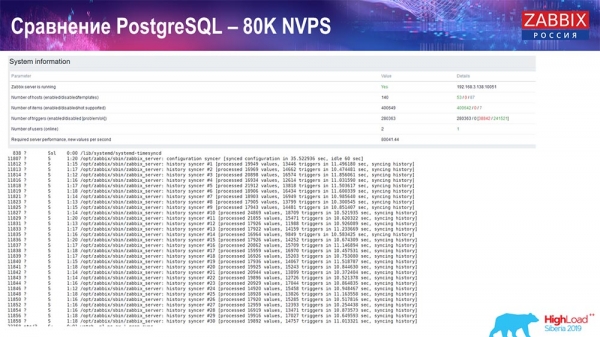
Il s'agissait d'environ 400 000 éléments de données, 280 000 déclencheurs. L'insertion, comme vous le voyez, était déjà assez élevée en charge sur les history-syncers (il y en avait 30). J'ai ensuite augmenté divers paramètres : history-syncers, cache... Sur ce matériel, la charge des history-syncers a commencé à grimper à son maximum, pratiquement 'en rayons' – par conséquent, HistoryCache a atteint une charge très élevée :
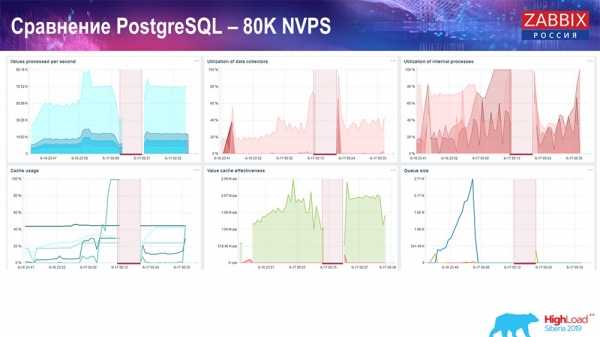
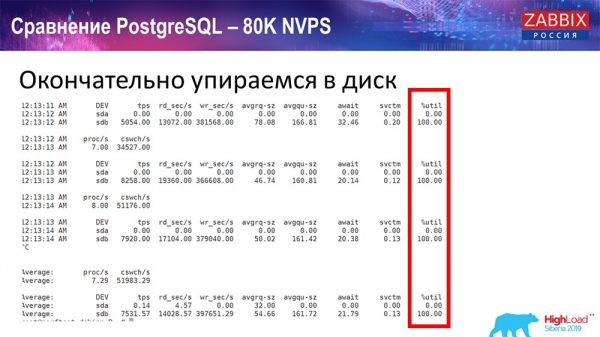
Tout ce temps, j'ai observé tous les paramètres système (comment le processeur est utilisé, la mémoire vive) et j'ai découvert que l'utilisation des disques était maximale – j'avais atteint la capacité maximale de ce disque sur ce matériel, sur cette machine virtuelle. PostgreSQL a commencé à vider les données assez activement dans une telle intensité, et le disque ne parvenait plus à écrire, lire…
J'ai pris un autre serveur, qui avait déjà 48 processeurs et 128 gigaoctets de mémoire vive :
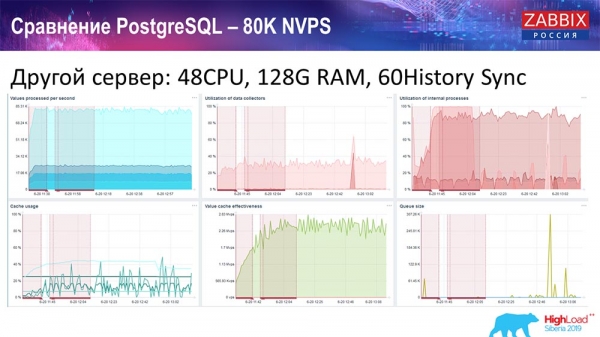
Je l'ai également 'optimisé' – j'ai installé 60 History syncers et j'ai atteint des performances acceptables. En fait, nous ne sommes pas 'en rayons', mais c'est déjà, probablement, la limite de performance où il est nécessaire de faire quelque chose à ce sujet.
Test de performance. TimescaleDB : 80 000 NVPs
J'avais pour principal objectif d'utiliser TimescaleDB. Sur chaque graphique, une chute est visible :
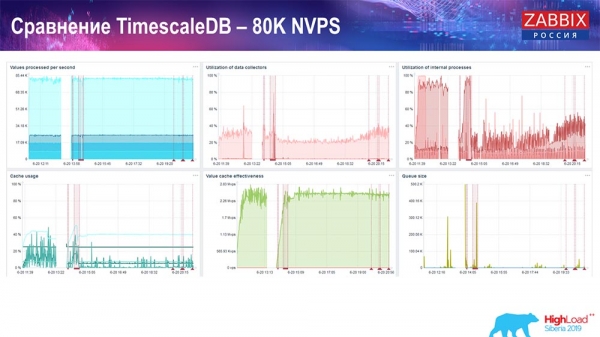
Ces échecs concernent la migration des données. Après cela, sur le serveur « Zabbix », le profil de chargement des synchroniseurs d'historique, comme vous pouvez le voir, a beaucoup changé. Il permet d'insérer des données presque trois fois plus rapidement et utilise moins de HistoryCache – ainsi, vous recevrez les données en temps utile. Encore une fois, 80 000 valeurs par seconde, c'est un taux assez élevé (bien sûr, pas pour « Yandex »). Dans l'ensemble, c'est une configuration assez importante, avec un seul serveur.
Test de performance de PostgreSQL : 120 000 NVPs
Ensuite, j'ai augmenté la valeur du nombre d'éléments de données à un demi-million et j'ai obtenu une valeur estimée de 125 000 par seconde :
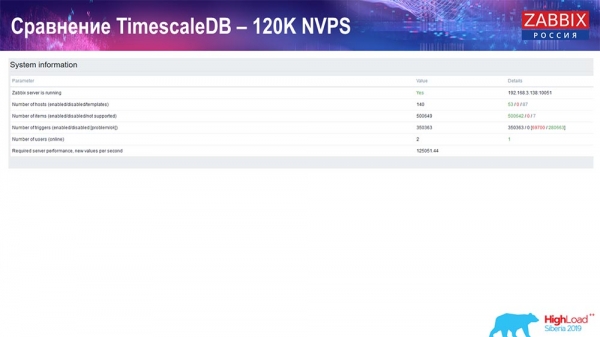
Et j'ai obtenu ces graphiques :
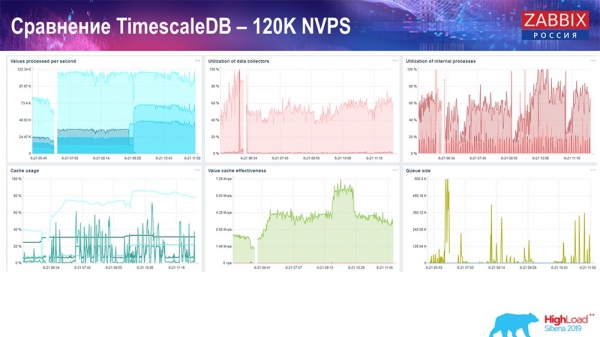
En principe, c'est une configuration fonctionnelle, elle peut fonctionner pendant une période relativement longue. Mais comme j'avais un disque de seulement 1,5 To, je l'ai épuisé en quelques jours. Ce qui est le plus important, c'est que pendant ce temps, de nouvelles partitions étaient créées sur TimescaleDB, et cela se faisait de manière totalement invisible pour la performance, ce qui ne peut pas être dit pour MySQL.
Généralement, les partitions sont créées la nuit, car cela bloque complètement l'insertion et le travail avec les tables, ce qui peut entraîner une dégradation du service. Dans ce cas, ce n'est pas le cas ! L'objectif principal était de vérifier les capacités de TimescaleDB. On a obtenu ce chiffre : 120 000 valeurs par seconde.
Il y a aussi des exemples dans la « communauté » :
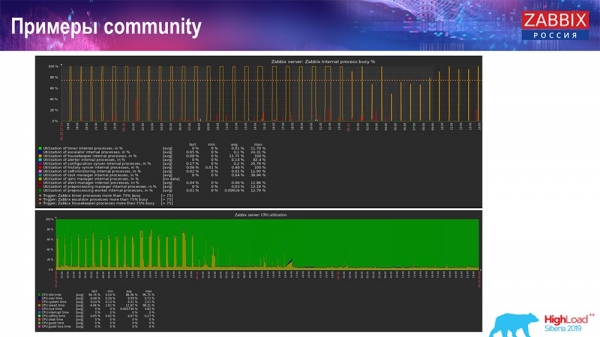
Une personne a également activé TimescaleDB et la charge d'utilisation de io.weight a diminué sur le processeur ; l'utilisation des éléments des processus internes a également diminué grâce à l'activation de TimescaleDB. D'ailleurs, il s'agit de disques durs ordinaires, c'est-à-dire d'une machine virtuelle sur des disques classiques (pas SSD) !
Pour des configurations plus petites, limitées par la performance du disque, TimescaleDB me semble être une très bonne solution. Elle permettra de continuer à fonctionner jusqu'à ce que vous migriez vers un matériel de base de données plus rapide.
Je vous invite tous à nos événements : Conférence – à Moscou, Sommet – à Riga. Utilisez nos canaux – « Telegram », forum, IRC. Si vous avez des questions – venez nous voir au stand, nous pouvons tout discuter.
Questions du public
Question from the audience (hereinafter – A): – If TimescaleDB is so easy to set up, and it offers such a performance boost, could it be considered best practice to use it with PostgreSQL for configuring Zabbix? Are there any pitfalls or downsides to this solution, or can I just seamlessly use PostgreSQL with Timescale from the start for Zabbix and not worry about any issues?
AG : – Yes, I would say it’s a good recommendation: to use PostgreSQL right away with the TimescaleDB extension. As I mentioned, there are many positive reviews, despite this feature being experimental. But tests actually show that this is an excellent solution (with TimescaleDB), and I believe it will continue to evolve! We are monitoring how this extension develops and will adjust as needed.
Even during development, we relied on one of their well-known features: it allowed for somewhat different chunk management. But then they removed it in the next release, and we had to stop relying on that code. I would recommend using this solution in many setups. If you are using MySQL… Any solution works well for medium setups.
A: – In the latest charts, which are from the community, there was a chart with ‘Housekeeper’:
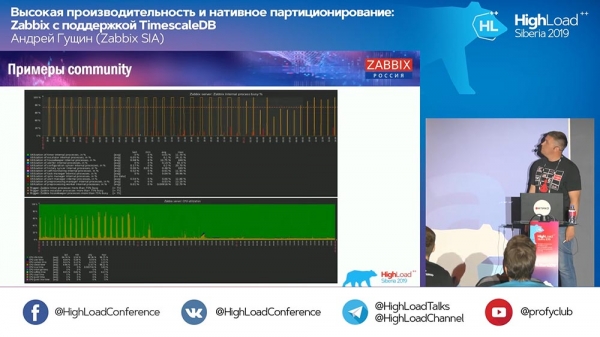
It continued to work. What does 'Housekeeper' do in the case of TimescaleDB?
AG : – I can’t say for sure right now – I’ll check the code and provide more details. It specifically uses TimescaleDB queries not for dropping chunks, but rather aggregates somehow. For now, I’m not ready to answer this technical question. We will clarify it on the stand today or tomorrow.
A: – I have a similar question – about the performance of delete operations in Timescale.
A (response from the audience): – When you delete data from a table, if you do this using delete, you need to go through the table – delete, clean up, mark everything for future vacuuming. In Timescale, since you have chunks, you can just drop them. Roughly speaking, you’re just telling the file in big data: 'Delete!'
«TimeScale» comprend simplement qu'il n'y a plus de ce chunk. Étant donné qu'il s'intègre dans le planificateur de requêtes, il attrape vos conditions dans le select ou dans d'autres opérations et comprend immédiatement que ce chunk n'existe plus – «Je n'irai plus là-bas !» (données manquantes). Voilà tout ! C'est-à-dire que le scan de la table est remplacé par la suppression du fichier binaire, donc c'est rapide.
A: – Nous avons déjà abordé le sujet de non-SQL. Si je comprends bien, «Zabbix» n'a pas vraiment besoin de modifier les données, tout cela ressemble à un journal. Peut-on utiliser des bases de données spécialisées qui ne peuvent pas changer leurs données, mais qui sont beaucoup plus rapides pour enregistrer, accumuler, restituer – Clickhouse, par exemple, quelque chose d'analogique à Kafka ?.. Kafka est aussi un journal ! Peut-on les intégrer d'une manière ou d'une autre ?
AG : – On peut faire une exportation. Nous avons une certaine «fonctionnalité» depuis la version 3.4 : vous pouvez écrire dans des fichiers tous les fichiers historiques, les événements, tout le reste ; puis envoyer à toute autre base de données avec un certain traitement. En fait, beaucoup de gens font cela et écrivent directement dans la base de données. Des history-syncers le font à la volée, écrivant dans des fichiers, faisant tourner ces fichiers, et ensuite vous pouvez les transférer dans «Clickhouse». Je ne peux pas parler des projets futurs, mais il est possible que le support des solutions NoSQL (comme «Clickhouse») se poursuive.
A: – Donc, en fait, on peut complètement se passer de Postgres ?
AG : – Bien sûr, la partie la plus complexe dans «Zabbix» est les tables historiques, qui posent le plus de problèmes, ainsi que les événements. Dans ce cas, si vous ne conservez pas les événements trop longtemps et que vous stockez l'historique avec des tendances dans un autre stockage rapide, il ne devrait pas y avoir de problème, je pense.
A: – Pouvez-vous évaluer à quel point tout fonctionnera plus vite si on passe à «Clickhouse», disons ?
AG : – Je n'ai pas testé. Je pense qu'on peut atteindre au moins les mêmes chiffres assez facilement, sachant que «Clickhouse» a son interface, mais je ne peux pas dire avec certitude. Mieux vaut tester. Tout dépend de la configuration : combien vous avez d'hôtes, etc. L'insertion est une chose, mais il faut aussi récupérer ces données – avec Grafana ou quelque chose d'autre.
A: – Donc, il s'agit d'une lutte équitable, et non d'un grand avantage de ces bases de données rapides ?
AG : – Je pense que lors de l'intégration, nous aurons des tests plus précis.
A: – Où est donc passé le bon vieux RRD ? Qu'est-ce qui a poussé à passer aux bases de données SQL ? Au départ, toutes les métriques étaient collectées sur RRD.
AG : – Dans « Zabbix », RRD n'existait peut-être que dans une très ancienne version. Il y a toujours eu des bases de données SQL – c'est l'approche classique. L'approche classique, c'est MySQL, PostgreSQL (qui existent depuis très longtemps). Nous n'avons pratiquement jamais utilisé d'interface commune pour les bases de données SQL et RRD.

Un peu de publicité 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenu intéressant ? Soutenez-nous en passants une commande ou en nous recommandant à des amis, , un équivalent unique des serveurs d'entrée de gamme, conçu pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd deux fois moins cher dans le data center Equinix Tier IV à Amsterdam ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
