

Tout le monde parle des processus de développement et de test, de la formation du personnel, de l'augmentation de la motivation, mais ces processus sont peu nombreux lorsque chaque minute d'arrêt du service coûte une fortune. Que faire lorsque vous réalisez des transactions financières sous des SLA stricts ? Comment améliorer la fiabilité et la tolérance aux pannes de vos systèmes sans tenir compte du développement et des tests ?
La prochaine conférence HighLoad++ se tiendra les 6 et 7 avril 2020 à Saint-Pétersbourg. Détails et billets disponibles sur . 9 novembre, 18h00. HighLoad++ Moscou 2018, salle « Delhi + Calcutta ». Résumés et .
Evgueni Kouzovlev (ci-après – EK) : – Bonjour, amis ! Je m'appelle Evgueni Kouzovlev. Je viens de l'entreprise EcommPay, plus précisément de la division EcommPay IT, la branche technologique du groupe. Aujourd'hui, nous allons parler des temps d'arrêt – comment les éviter et comment minimiser leurs conséquences si nous ne pouvons pas les éviter. Le thème est annoncé comme suit : « Que faire lorsque une minute d'arrêt coûte 100 000 dollars » ? Pour nous, en se projetant, les chiffres sont comparables.
Que fait EcommPay IT ?
Qui sommes-nous ? Pourquoi suis-je ici devant vous ? Pourquoi ai-je le droit de vous parler de quelque chose ici ? Et de quoi allons-nous parler en détail ici ?
Le groupe EcommPay est un acquéreur international. Nous traitons des paiements dans le monde entier – en Russie, en Europe, en Asie du Sud-Est (Partout dans le monde). Nous avons 9 bureaux, 500 employés au total, et environ un peu moins de la moitié d'entre eux sont des spécialistes en IT. Tout ce que nous faisons, tout ce par quoi nous gagnons de l'argent, nous l'avons fait nous-mêmes.
Tous nos produits (et nous en avons assez – dans notre gamme de grandes solutions informatiques, il y a environ 16 composants différents) ont été développés par nous ; nous écrivons et développons nous-mêmes. Actuellement, nous traitons environ un million de transactions par jour (ou plutôt, des millions, ce qui serait plus correct). Nous sommes une entreprise suffisamment jeune – cela fait seulement environ six ans.
Il y a 6 ans, c'était une sorte de start-up, lorsque des gars sont arrivés avec l'idée d'affaires. Ils étaient unis par cette idée (il n'y avait rien d'autre que l'idée), et nous avons commencé. Comme toute start-up, nous avons couru plus vite... Pour nous, la vitesse était plus importante que la qualité.
À un moment donné, nous nous sommes arrêtés : nous avons réalisé que nous ne pouvions plus vivre à ce rythme et avec cette qualité, et que nous devions privilégier la qualité. C'est à ce moment-là que nous avons décidé d'écrire une nouvelle plateforme, qui serait correcte, évolutive et fiable. Nous avons commencé à développer cette plateforme (en investissant, en développant la recherche et les tests), mais à un moment donné, nous avons compris que le développement et les tests ne permettaient pas d'atteindre un nouveau niveau de qualité de service.
Vous créez un nouveau produit, vous le mettez en production, mais il y a toujours quelque chose qui ne va pas. Aujourd'hui, nous allons parler de la manière d'atteindre un nouveau niveau de qualité (comment nous avons réussi, notre expérience), en mettant de côté le développement et les tests ; nous allons discuter de ce qui est à la disposition de l'exploitation – ce que l'exploitation peut faire elle-même, ce qu'elle peut proposer aux tests pour influencer la qualité.
Les temps d'arrêt. Les commandements de l'exploitation.
Le principal pilier dont nous allons parler aujourd'hui est le downtime. Un mot terrible. Si nous connaissons un downtime, tout va mal. Nous courons pour le rétablir, les administrateurs essaient de maintenir le serveur – espérons qu'il ne tombera pas, comme dit cette chanson. C'est de cela dont nous allons parler aujourd'hui.
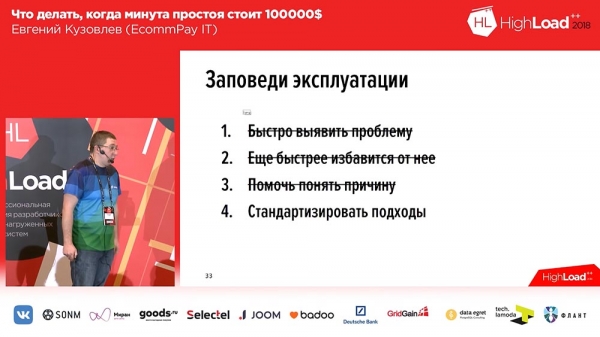
Lorsque nous avons commencé à changer nos approches, nous avons formulé 4 commandements. Ils sont présentés dans les diapositives :
Ces commandements sont assez simples :
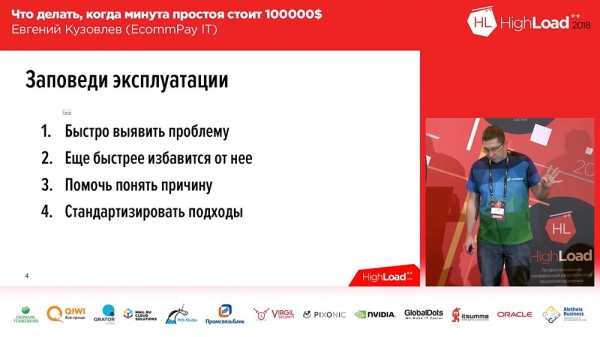
- Identifier rapidement le problème.
- S'en débarrasser encore plus rapidement.
- Aider à comprendre la cause (plus tard, pour les développeurs).
- Standardiser les approches.
Je vais attirer votre attention sur le point n° 2. Nous nous débarrassons du problème, et non pas nous le résolvons. Résoudre est secondaire. Pour nous, l'important est que l'utilisateur soit protégé de ce problème. Il existera dans un environnement isolé, mais cet environnement ne sera en aucun cas en contact avec lui. En fait, nous allons parcourir ces quatre groupes de problèmes (certains plus en détail, d'autres moins), je vous expliquerai ce que nous utilisons, quelle est notre expérience en matière de solutions.
Résolution des problèmes : quand ils surviennent et que faire avec eux ?
Mais nous ne commencerons pas par l'ordre, mais par le point n° 2 – comment résoudre le problème rapidement ? Il y a un problème – nous devons le résoudre. « Que devons-nous en faire ? » est la question principale. Et lorsque nous avons commencé à réfléchir à la manière de résoudre le problème, nous avons élaboré certaines exigences auxquelles la résolution des problèmes doit répondre.
Pour formuler ces exigences, nous avons décidé de nous poser la question : « Quand rencontrons-nous des problèmes ? » Et les problèmes, comme il s'est avéré, surviennent dans quatre cas :
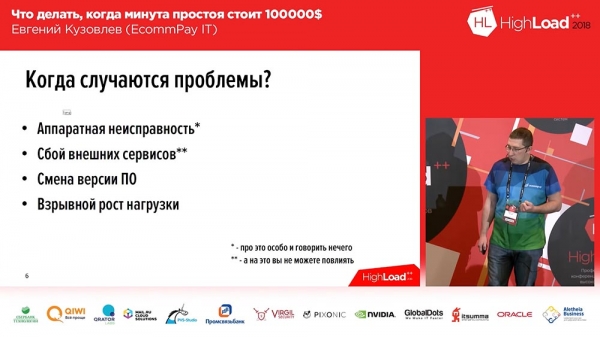
- Défaillance matérielle.
- Panne de services externes.
- Changement de version du logiciel (ce fameux déploiement).
- Croissance explosive de la charge.
Nous ne parlerons pas des deux premiers. La défaillance matérielle se résout assez facilement : tout doit être dupliqué. Si ce sont des disques – les disques doivent être configurés en RAID, si c'est un serveur – le serveur doit être dupliqué, si vous avez une infrastructure réseau – vous devez installer une deuxième copie de l'infrastructure réseau, c'est-à-dire que vous prenez et vous dupliquez. Et si quelque chose échoue, vous basculez vers des ressources de secours. Il est difficile d'en dire plus ici.
Le second, ce sont les pannes de services externes. Pour la plupart des systèmes, ce n'est pas vraiment un problème, mais pas pour nous. Comme nous traitons les paiements, nous sommes un agrégateur qui se situe entre l'utilisateur (qui saisit ses informations de carte) et les banques, les systèmes de paiement (« Visa », « MasterCard », « Mir » entre autres). Nos services externes (systèmes de paiement, banques) sont sujets à des pannes. Ni nous, ni vous (si vous avez de tels services) ne pouvons y faire quoi que ce soit.
Que faire alors ? Il y a deux options. Premièrement, si vous le pouvez, vous devez dupliquer ce service d'une manière ou d'une autre. Par exemple, si nous le pouvons, nous redirigeons le trafic d'un service à un autre : nous avons traité des cartes via « Sberbank », si « Sberbank » a des problèmes – nous transférons le trafic [conditionnellement] vers « Raiffeisen ». Deuxièmement, ce que nous pouvons faire, c'est détecter très rapidement les pannes de services externes, et donc nous parlerons de la rapidité de réaction dans la prochaine partie de notre rapport.
En réalité, parmi ces quatre points, nous pouvons concrètement influencer le changement de version du logiciel – entreprendre des actions qui amélioreront la situation tant en ce qui concerne les déploiements que la croissance explosive de la charge. En fait, c'est ce que nous avons fait. Ici, encore une petite remarque…
Parmi ces quatre problèmes, plusieurs se résolvent immédiatement si vous avez un cloud. Si vous êtes dans les clouds de « Microsoft Azure », « Ozon », ou utilisez nos clouds de « Yandex » ou « Mail », alors au moins, un dysfonctionnement matériel devient leur problème et tout s'améliore immédiatement pour vous en matière de dysfonctionnement matériel.
Nous sommes une entreprise un peu atypique. Ici, tout le monde parle de « Kubernetes », de clouds – nous n'avons ni « Kubernetes », ni clouds. En revanche, nous avons des racks avec du matériel dans de nombreux centres de données, et c'est sur ce matériel que nous sommes contraints de vivre, nous devons en être responsables. C'est pourquoi, dans ce contexte, nous allons parler. Donc, concernant les problèmes. Nous avons mis les deux premiers de côté.
Changement de version du logiciel. Bases
Nos développeurs n'ont pas accès à la production. Pourquoi ? Tout simplement parce que nous sommes certifiés PCI DSS, et nos développeurs n'ont pas le droit d'accéder à la production. C'est tout, point final. Donc, la responsabilité du développement s'arrête exactement au moment où le développement a transmis le build pour la release.
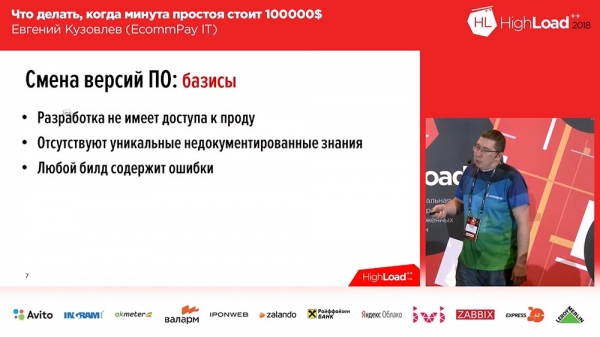
Notre deuxième base, qui nous aide également beaucoup, est l'absence de connaissances uniques non documentées. J'espère que vous en avez également. Parce que si ce n'est pas le cas – vous rencontrerez des problèmes. Les problèmes surviendront lorsque ces connaissances uniques non documentées ne seront pas présentes au bon moment et au bon endroit. Par exemple, si une personne sait comment déployer un composant spécifique – si cette personne est absente, en congé ou malade – voilà, vous avez des problèmes.
Et la troisième base à laquelle nous sommes arrivés. Nous y sommes parvenus à travers la douleur, le sang et les larmes – nous avons réalisé que chaque build contient des erreurs, même s'il est sans défaut. Nous avons décidé que lorsque nous déployons quelque chose, lorsque nous mettons quelque chose en production – notre build contient des erreurs. Nous avons défini des exigences que notre système doit respecter.
Exigences pour le changement de version du logiciel
Ces exigences sont au nombre de trois :
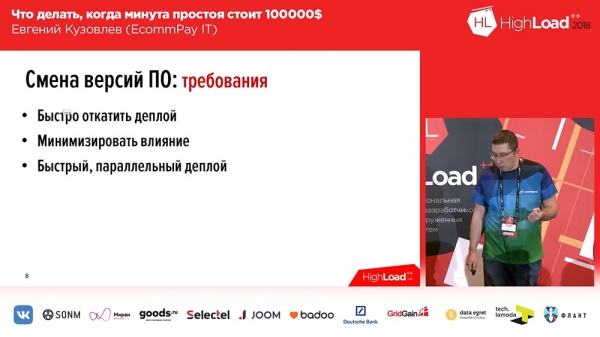
- Nous devons pouvoir annuler rapidement le déploiement.
- Nous devons minimiser l'impact d'un déploiement infructueux.
- Et nous devons être en mesure de nous déployer rapidement à la fois en parallèle.
C'est précisément dans cet ordre ! Pourquoi ? Parce qu'en premier lieu, lors du déploiement d'une nouvelle version, la vitesse n'est pas primordiale, mais il est important pour vous de pouvoir revenir rapidement en arrière si quelque chose ne va pas, en minimisant l'impact. Cependant, si vous avez un ensemble de versions en production, pour lesquelles une erreur a été découverte (comme un coup de tonnerre, il n'y a pas eu de déploiement, mais l'erreur est présente) – alors la vitesse du déploiement suivant est cruciale. Qu'avons-nous fait pour satisfaire ces exigences ? Nous avons adopté une méthodologie telle que :
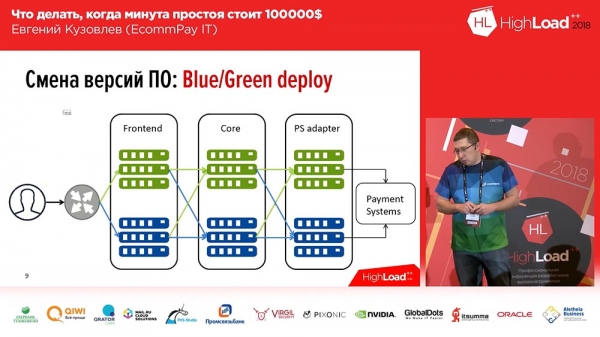
Elle est assez connue, nous ne l'avons jamais inventée – il s'agit du déploiement Blue/Green. Qu'est-ce que c'est ? Pour chaque groupe de serveurs sur lesquels vos applications sont installées, vous devez avoir une copie. Une copie « chaude » : elle ne reçoit pas de trafic, mais à tout moment ce trafic peut être redirigé vers cette copie. Cette copie contient la version précédente. Et au moment du déploiement, vous déployez le code sur la copie inactive. Ensuite, vous redirigez une partie du trafic (ou tout) vers la nouvelle version. Ainsi, pour changer le flux de trafic de l'ancienne version vers la nouvelle, vous n'avez qu'une seule action à réaliser : vous devez changer l'équilibreur en amont, changer la direction – d'un amont à l'autre. C'est très pratique et cela résout le problème d'un basculement rapide, d'un retour rapide.Ici réside également la solution à la deuxième question – la minimisation : vous pouvez diriger vers la nouvelle ligne, vers la ligne avec le nouveau code, seulement une partie de votre trafic (disons, par exemple, 2 %). Et ces 2 % – ce ne sont pas 100 % ! Si vous perdez 100 % de votre trafic lors d'un déploiement raté – c'est terrible, mais si vous ne perdez que 2 % – cela peut être désagréable, mais ce n'est pas grave. De plus, les utilisateurs ne le remarqueront probablement même pas, car dans certains cas (pas tous), le même utilisateur, en appuyant sur F5, atterrira sur une autre version fonctionnelle.
Déploiement Blue/Green. Routage
Cela dit, tout n'est pas si simple dans le déploiement Blue/Green… Tous nos composants peuvent être divisés en trois groupes :
- c'est le front-end (pages de paiement que voient nos clients) ;
- le noyau de traitement ;
- l'adaptateur pour travailler avec les systèmes de paiement (banques, MasterCard, Visa…).
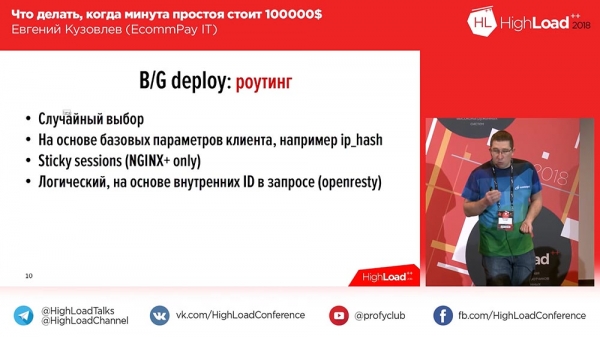
Et ici, il y a un détail – le détail réside dans le routage entre les lignes. Si vous ne redirigez 100 % du trafic, vous n'avez pas ces problèmes. Mais si vous souhaitez rediriger 2 %, des questions se posent : « Comment faire cela ? » La solution la plus simple, de manière directe : vous pouvez configurer un choix aléatoire, Round Robin dans nginx, et vous aurez 2 % à gauche, 98 % à droite. Mais ce n'est pas toujours approprié.
Par exemple, chez nous, un utilisateur interagit avec le système avec plus d'une requête. C'est normal : 2, 3, 4, 5 requêtes – vos systèmes peuvent être de même nature. Et si vous tenez à ce que toutes les requêtes de l'utilisateur arrivent sur la même ligne que la première requête, ou (deuxième point) que toutes les requêtes de l'utilisateur arrivent sur une nouvelle ligne après la bascule (il pourrait avoir commencé à travailler avec le système avant la bascule), – alors, cette répartition aléatoire ne vous convient pas. Vous aurez donc les options suivantes :
La première option, la plus simple – basée sur les paramètres de base du client (IP Hash). Vous avez une IP, et vous la séparez à droite et à gauche selon l'ip. Ainsi, cela fonctionnera pour le deuxième cas que j'ai décrit, lorsque le déploiement a eu lieu, l'utilisateur a déjà commencé à travailler avec votre système, et depuis le moment du déploiement, toutes les requêtes iront vers la nouvelle ligne (vers la même, disons).Si pour une raison quelconque cela ne convient pas et que vous devez absolument envoyer les requêtes vers la ligne où la requête primaire, initiale de l'utilisateur est arrivée, alors vous avez deux options…
La première option : vous pouvez opter pour un nginx+ payant. Il y a un mécanisme de sessions persistantes qui, lors de la requête initiale de l'utilisateur, assigne une session à cet utilisateur et la lie à un ou plusieurs backends. Toutes les requêtes suivantes de l'utilisateur pendant la durée de vie de la session seront envoyées à ce même backend, vers lequel la session a été attribuée.Cela ne nous convenait pas, parce que nous avions déjà un nginx standard. Passer à nginx+ – ce n'est pas que ce soit cher, c'est juste que cela nous semblait un peu douloureux et pas très juste. Les « Sticky sessions » ne fonctionnaient pas pour nous, par la simple raison que les « Sticky sessions » ne permettent pas de router selon le principe « Ou-ou ». On peut établir des « Sticky sessions » par exemple en fonction de l'ip ou de l'ip et des cookies ou d'un paramètre post, mais pour « Ou-ou », c'est déjà plus complexe.
C'est pourquoi nous avons opté pour la quatrième option. Nous avons pris nginx 'stéroïdé' (c'est openresty) – c'est le même nginx, mais il prend également en charge l'inclusion de last-scripts. Vous pouvez écrire un last-script, le soumettre à cet 'opernesti', et ce last-script sera exécuté lorsque la requête de l'utilisateur arrivera.
Nous avons donc écrit un petit script, installé 'opernesti' et dans ce script, nous parcourons 6 différents paramètres par concaténation 'ou'. En fonction de la présence de tel ou tel paramètre, nous savons si l'utilisateur est arrivé sur une page ou une autre, sur une ligne ou une autre.
Déploiement Blue/Green. Avantages et inconvénients
Bien sûr, il aurait probablement été possible de faire un peu plus simple (en utilisant les 'Sticky sessions', par exemple), mais il y a aussi ce détail que nous n'interagissons pas seulement avec l'utilisateur dans le cadre d'un seul traitement d'une transaction… Mais aussi avec les systèmes de paiement : après avoir traité la transaction (en envoyant une requête au système de paiement), nous recevons un callback.
Et admettons que si, à l'intérieur de notre contour, nous pouvons passer l'adresse IP de l'utilisateur dans toutes les requêtes et, sur la base de l'adresse IP des utilisateurs, les séparer, nous ne dirons pas à Visa : 'Les gars, nous sommes une sorte d'entreprise rétro, semble-t-il internationale (sur le site et en Russie)… Mais pouvez-vous nous passer l'adresse IP de l'utilisateur dans un champ supplémentaire, votre protocole normalisé' ! Évidemment, ils ne seront pas d'accord.
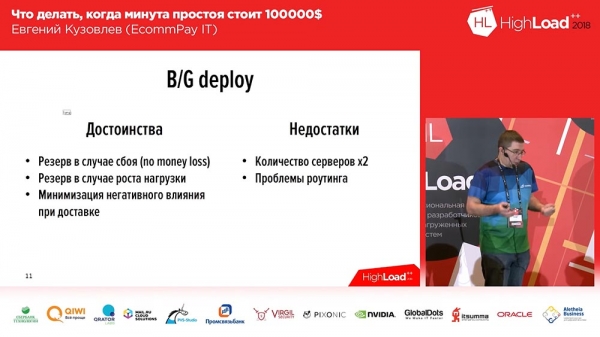
C'est pourquoi cela ne nous convenait pas – nous avons décidé de faire openresty. Ainsi, avec le routage, cela a donné ceci :Le déploiement Blue/Green a, par conséquent, des avantages que j'ai mentionnés, et des inconvénients.
Il y a deux inconvénients :
- vous devez vous soucier du routage ;
- le deuxième inconvénient majeur – ce sont les coûts.
Vous avez besoin de deux fois plus de serveurs, vous avez besoin de deux fois plus de ressources opérationnelles, vous devez dépenser deux fois plus d'efforts pour maintenir tout ce zoo.
D'ailleurs, parmi les avantages, il y a une chose que je n'ai pas mentionnée auparavant : vous avez une réserve en cas d'augmentation de la charge. Si vous rencontrez une croissance explosive de la charge, si un grand nombre d'utilisateurs afflue vers vous, vous n'avez qu'à activer une seconde ligne de distribution à 50/50, et vous avez immédiatement x2 serveurs dans votre cluster, le temps que vous résolviez le problème de la disponibilité des serveurs.
Comment effectuer un déploiement rapide ?
Nous avons discuté de la façon de minimiser et d'effectuer un retour rapide, mais la question demeure : « Comment se déployer rapidement ? »
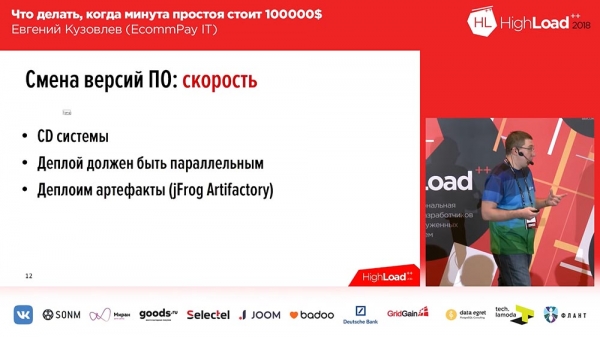
C'est simple et direct ici.- Vous devez disposer d'un système de CD (Continuous Delivery) – sans cela, vous n'irez pas loin. Si vous n'avez qu'un seul serveur, vous pouvez déployer manuellement. Nous avons environ mille cinq cents serveurs et faire cela manuellement est évident – nous pourrions remplir une salle de taille moyenne, juste pour déployer.
- Le déploiement doit être parallèle. Si votre déploiement est séquentiel, tout va mal. Un serveur – ça va, mais mille cinq cents serveurs, vous allez passer la journée à déployer.
- Encore une fois, pour accélérer, ce n'est probablement plus nécessaire. Lors d'un déploiement, un build du projet est généralement effectué. Vous avez un projet web, il y a une partie frontale (vous faites un web-pack, vous compilez avec npm – quelque chose comme ça), et ce processus prend en principe peu de temps – environ 5 minutes, mais ces 5 minutes peuvent être critiques. Donc, par exemple, nous ne faisons pas cela ainsi : nous avons éliminé ces 5 minutes, nous déployons des artefacts.
Qu'est-ce qu'un artefact ? Un artefact est un build assemblé, dans lequel toute la partie de compilation a déjà été réalisée. Cet artefact est stocké dans un dépôt d'artefacts. Nous avons utilisé deux tels dépôts à l'époque – c'était Nexus et maintenant jFrog Artifactory. Nous avons initialement utilisé « Nexus » parce que nous avons commencé à pratiquer cette approche dans des applications Java (il était bien adapté à cela). Ensuite, nous y avons également intégré certaines applications écrites en PHP ; et « Nexus » n'était plus adapté, c'est pourquoi nous avons choisi jFrog Artifactory, qui peut gérer pratiquement tout. Nous en sommes même arrivés à stocker dans ce dépôt d'artefacts nos propres paquets binaires que nous compilons pour nos serveurs.
Croissance explosive de la charge
Nous avons parlé du changement de version de logiciel. La prochaine chose que nous avons est une croissance explosive de la charge. Ici, je pense comprendre par croissance explosive de la charge quelque chose qui n'est pas tout à fait correct...
Nous avons développé un nouveau système – il est orienté services, élégant et beau, avec des workers partout, des files d'attente partout, et de l'asynchronisme partout. Dans de tels systèmes, les données peuvent circuler par différents flux. Pour la première transaction, il peut être fait appel au 1er, 3e ou 10e worker, pour la deuxième transaction – au 2e, 4e ou 5e. Et aujourd'hui, par exemple, le matin, vous avez un flux de données qui utilise les trois premiers workers, mais le soir, cela change brusquement et cela fait appel à trois autres workers.
Cela signifie que vous devez somehow scaler vos workers, scaler vos services, tout en évitant le gonflement des ressources.
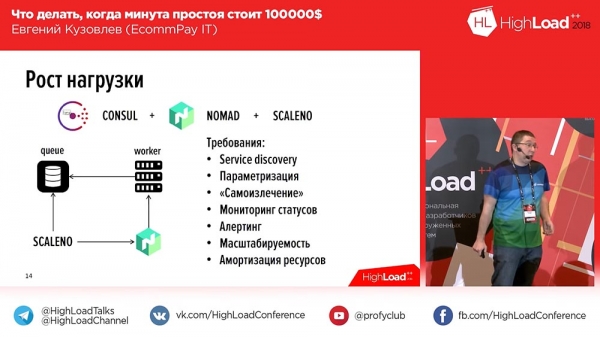
Nous avons établi nos exigences. Ces exigences sont relativement simples : un service de découverte, de la paramétrisation – tout est standard pour la construction de tels systèmes scalables, sauf un point – c'est l'amortissement des ressources. Nous avons dit que nous n'étions pas prêts à amortir les ressources juste pour que les serveurs chauffent l'air. Nous avons choisi « Consul » et « Nomad », qui gère nos workers.Pourquoi est-ce un problème pour nous ? Revenons un peu en arrière. Nous avons actuellement environ 70 systèmes de paiement. Le matin, le trafic passe par « Sberbank », puis « Sberbank » tombe, par exemple, et nous le redirigeons vers un autre système de paiement. Nous avons eu 100 workers avant « Sberbank », et après cela, il nous faut tout à coup augmenter à 100 workers pour un autre système de paiement. Et cela doit idéalement se faire sans intervention humaine. Parce que si une intervention humaine est nécessaire, il doit y avoir un ingénieur disponible 24/7 qui s'occupe uniquement de cela, car de tels pannes, avec 70 systèmes en cours, se produisent régulièrement.
C'est pourquoi nous avons examiné « Nomad », qui a une IP ouverte, et avons écrit notre propre outil Scale-Nomad – ScaleNo, qui fait à peu près ceci : il surveille la croissance de la file d'attente et augmente ou diminue le nombre de workers en fonction de la dynamique de changement de la file d'attente. Lorsque nous l'avons créé, nous avons pensé : « Peut-être devrions-nous le rendre open source ? » Puis nous l'avons regardé – il est simple comme bonjour.
Jusqu'à présent, nous ne l'avons pas rendu open source, mais si après la présentation, vous réalisez que vous avez besoin d'un tel outil, mes coordonnées se trouvent sur la dernière diapositive – écrivez-moi, s'il vous plaît. Si nous réunissons au moins 3-5 personnes, nous le rendrons open source.
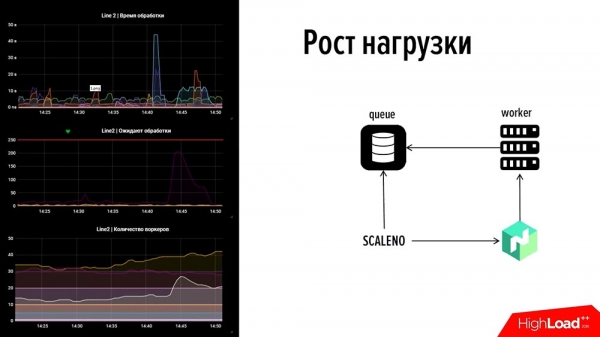
Comment ça fonctionne ? Voyons voir ! Pour vous donner un aperçu : à gauche, il y a un aperçu de notre surveillance : une ligne, en haut – le temps de traitement des événements, au milieu – le nombre de transactions, en bas – le nombre de travailleurs.Si l'on regarde, sur cette image, il y a une défaillance. Sur le graphique du haut, l'un des graphiques a échoué après 45 secondes – l'un des systèmes de paiement est tombé. Ici, le trafic a été enregistré sur 2 minutes et il y a eu une augmentation de la file d'attente sur un autre système de paiement, où il n'y avait pas de travailleurs (nous n'avons pas utilisé les ressources – au contraire, nous avons utilisé les ressources correctement). Nous ne voulions pas surcharger – il y avait un nombre minimal, environ 5-10 travailleurs, mais ils n'ont pas réussi.
Sur le dernier graphique, on voit une « bosse », qui indique que « Scaleno » a doublé ce nombre. Et ensuite, lorsque le graphique a légèrement diminué, il a légèrement réduit – le nombre de travailleurs a été ajusté automatiquement. Voilà comment cela fonctionne. Nous avons parlé du point n° 2 – « Comment se débarrasser rapidement des causes ».
Surveillance. Comment identifier rapidement un problème ?
Maintenant, le premier point – « Comment identifier rapidement un problème ? » Surveillance ! Nous devons rapidement comprendre certaines choses. Quelles choses devons-nous comprendre rapidement ?
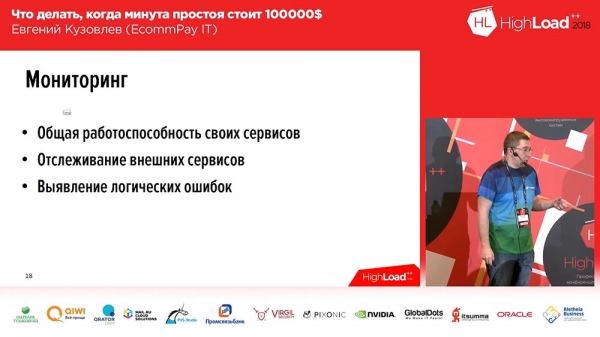
Trois choses !- Nous devons comprendre rapidement le fonctionnement de nos propres ressources.
- Nous devons rapidement identifier les pannes et surveiller le fonctionnement des systèmes externes.
- Le troisième point – l'identification des erreurs logiques. C'est lorsque le système fonctionne chez vous, que tout semble normal, mais quelque chose ne va pas.
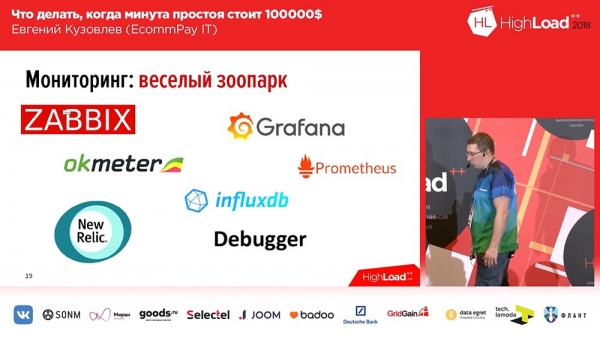
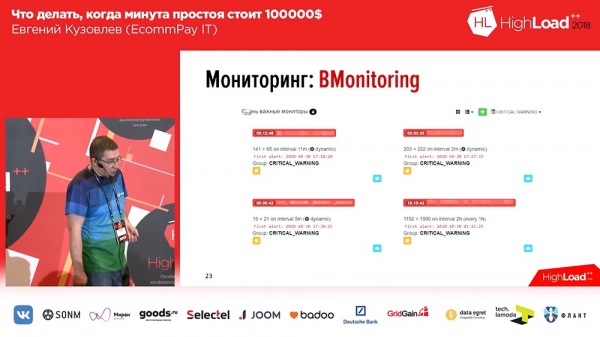
Ici, je ne vais probablement pas dire grand-chose de spécial. Je vais jouer le rôle du capitaine Évidence. Nous avons cherché ce qui est disponible sur le marché. Nous avons formé un « zoo amusant ». Voici le zoo que nous avons en ce moment :
Nous utilisons « Zabbix » pour surveiller le « matériel », pour surveiller les principaux indicateurs des serveurs. « Okmeter » est utilisé pour les bases de données. Nous utilisons « Grafana » et « Prometheus » pour tous les autres indicateurs qui ne rentrent pas dans les deux premiers, une partie avec « Grafana » et « Prometheus », et une partie – « Grafana » avec « Influx » et Telegraf.Il y a un an, nous voulions utiliser New Relic. C'est un outil génial, il fait tout. Mais autant il fait tout, autant il est cher. Lorsque nous avons atteint 1 500 serveurs, un vendeur est venu et a dit : « Signons un contrat pour l'année prochaine ». Nous avons regardé le prix et avons décidé de ne pas le faire. Actuellement, nous nous désengageons de New Relic, nous avons environ 15 serveurs restants sous la surveillance de New Relic. Le prix s'est avéré complètement exorbitant.
Et il y a un outil que nous avons développé nous-mêmes – c'est le Débogueur. Au début, nous l'appelions ‘Bagger’, mais ensuite un professeur d'anglais est passé, a ri de manière ridicule, et nous l'avons renommé en ‘Débugueur’. Qu'est-ce que c'est ? C'est un outil qui, en fait, dans les 15 à 30 secondes sur chaque composant, comme une ‘boîte noire’ du système, exécute des tests sur le bon fonctionnement du composant.
Par exemple, si c'est une page externe (la page de paiement) – il l'ouvre simplement et vérifie à quoi elle devrait ressembler. Si c'est un traitement, il effectue un ‘test transactionnel’ - il vérifie que cette ‘transaction’ passe. Si c'est une connexion avec des systèmes de paiement – nous envoyons donc une requête de test, là où nous le pouvons, et vérifions que tout fonctionne correctement.
Quels indicateurs sont importants pour la surveillance ?
Que surveillons-nous principalement ? Quels indicateurs sont importants pour nous ?
- Le temps de réponse / RPS sur les fronts – c'est un indicateur très important. Il indique immédiatement que quelque chose ne va pas.
- Le nombre de messages traités dans toutes les files d'attente.
- Le nombre de workers.
- Les principales métriques de correction.
Le dernier point – c'est une métrique 'business'. Si vous voulez surveiller la même chose, vous devez définir une ou deux métriques qui sont pour vous des indicateurs principaux. Pour nous, cette métrique est la conversion (c'est le rapport entre le nombre de transactions réussies et le flux total de transactions). Si quelque chose change dans ce ratio sur un intervalle de 5-10-15 minutes – cela signifie que nous avons des problèmes (s'il change radicalement).
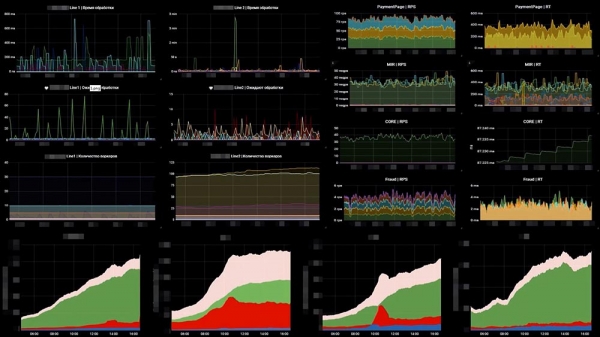
Voici à quoi cela ressemble – un exemple de l'un de nos tableaux :
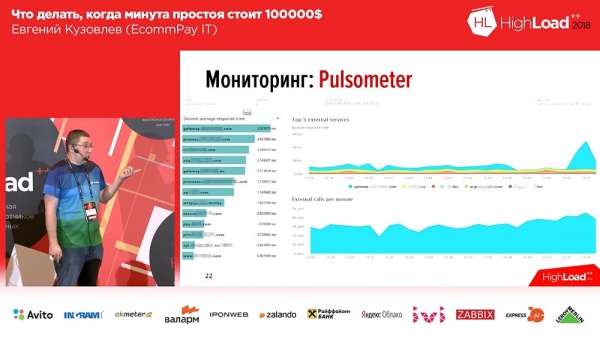
Sur la gauche, il y a 6 graphiques, ce qui correspond aux lignes – le nombre de travailleurs et le nombre de messages dans les files d'attente. Sur la droite – RPS, RTS. En bas – la métrique « commerciale » en question. Et sur cette métrique commerciale, nous pouvons immédiatement voir que quelque chose ne va pas sur les deux graphiques du milieu… C'est justement le moment où un autre système a échoué, qui se trouve derrière nous.Deuxièmement, ce que nous devions faire, c'était suivre l'effondrement des systèmes de paiement externes. Ici, nous avons utilisé OpenTracing – un mécanisme, une norme, une paradigme qui permet de tracer des systèmes distribués ; et nous l'avons un peu modifié. La logique standard d'OpenTracing stipule que nous construisons le traçage de chaque requête individuelle. Ce n'était pas nécessaire pour nous, donc nous l'avons adapté en traçage global, agrégé. Nous avons créé un outil qui nous permet de suivre la vitesse des systèmes qui se trouvent derrière nous.
Le graphique nous montre qu'un des systèmes de paiement a commencé à répondre en 3 secondes – nous avons commencé à avoir des problèmes. De plus, ce système réagira dès que des problèmes commenceront, dans une plage de 20-30 secondes.Et la troisième classe d'erreurs de surveillance dont il s'agit – c'est la surveillance logique.
Honnêtement, je ne savais pas quoi dessiner sur ce diapositif, car nous avons longtemps cherché sur le marché ce qui pourrait nous convenir. Nous n'avons rien trouvé, donc nous avons dû le faire nous-mêmes.
Que veux-je dire par surveillance logique ? Eh bien, imaginez : vous créez un système pour vous-même (par exemple, un clone de Tinder) ; vous l'avez fait, vous l'avez lancé. Le manager réussi Vasya Pupkin l'a installé sur son téléphone, voit une fille, aime son profil… mais le « like » ne va pas à la fille – il va au garde de sécurité Mikhailitch de ce même centre d'affaires. Le manager descend, et ensuite il se demande : « Pourquoi ce garde de sécurité Mikhailitch lui sourit-il si agréablement ? »Dans ces situations... Pour nous, cette situation sonne un peu différemment, car (j'ai écrit) il s'agit d'une perte de réputation qui entraîne indirectement des pertes financières. Nous avons une situation inverse : nous pouvons subir des pertes financières directes – par exemple, si nous avons réalisé une transaction comme réussie, mais qu'elle était en réalité un échec (ou vice versa). Nous avons dû créer notre propre outil qui suit, en fonction des indicateurs commerciaux, le nombre de transactions réussies dans le temps. Nous n'avons rien trouvé sur le marché ! Je voulais transmettre cette idée. Il n'y a rien sur le marché pour résoudre ce genre de problèmes.
C'était à propos de la rapidité de détection d'un problème.
Comment déterminer les causes du déploiement
Le troisième groupe de tâches que nous résolvons consiste, une fois le problème identifié et résolu, à comprendre la cause pour le développement, pour le test et à faire quelque chose à ce sujet. Par conséquent, nous devons enquêter, nous devons relever les logs.
Si nous parlons des logs (la principale raison – les logs), la majeure partie des logs que nous avons se trouve dans l'ELK Stack – c'est le cas pour presque tout le monde. Pour certains, cela peut ne pas être dans l'ELK, mais si vous écrivez des logs par gigaoctets, tôt ou tard, vous vous tournerez vers l'ELK. Nous les écrivons par téraoctets.
Il y a un problème ici. Nous avons corrigé l'erreur pour l'utilisateur, nous avons commencé à creuser pour comprendre ce qu'il s'est passé, nous sommes allés dans « Kibana », avons saisi l'identifiant de la transaction et avons obtenu un long rapport (montre beaucoup). Et dans ce rapport, rien n'est clair. Pourquoi ? Parce que nous ne comprenons pas quelle partie appartient à quel worker, quelle partie appartient à quel composant. À ce moment-là, nous avons compris que nous avions besoin de traçabilité – ce fameux OpenTracing dont j'ai parlé.Nous y avons pensé il y a un an, nous avons tourné notre regard vers le marché, et nous avons trouvé deux outils – « Zipkin » et « Jaeger ». « Jaeger » est en fait l'héritier idéologique, le continuateur idéologique de « Zipkin ». Tout est bon dans « Zipkin », sauf qu'il ne peut pas agréger, ne peut pas inclure les logs dans la traçabilité, juste la traçabilité du temps. « Jaeger » a pris cela en charge.
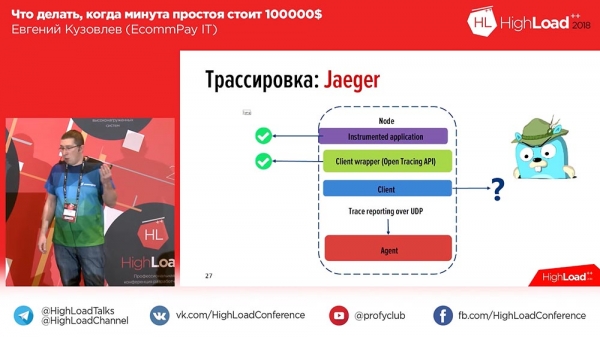
Nous avons examiné «Eger» : il est possible d'instrumenter les applications, d'écrire dans l'Api (la norme Api pour PHP à cette époque, certes, n'était pas approuvée – c'était il y a un an, et maintenant elle est déjà approuvée), mais il n'y avait absolument aucun client. «D'accord», avons-nous pensé, et nous avons écrit notre propre client. Voici à quoi cela ressemble :
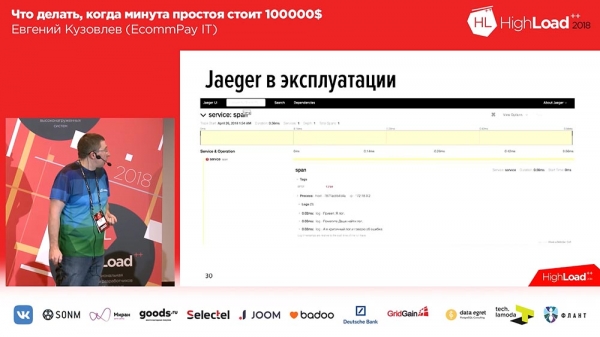
Dans «Eger», des span sont créés pour chaque message. Cela signifie que lorsque l'utilisateur ouvre le système, il voit un ou deux blocs pour chaque requête entrante (1-2-3 – autant de blocs que de requêtes entrantes de l'utilisateur). Pour faciliter la tâche des utilisateurs, nous avons ajouté des balises aux logs et au traçage temporel. Ainsi, en cas d'erreur, notre application marquera le log avec la balise correspondante Error. Il est possible de filtrer par la balise Error et seuls les spans contenant ce bloc d'erreur s'afficheront. Voici à quoi cela ressemble lorsque nous développons un span :
À l'intérieur du span, il y a un ensemble de traces. Dans ce cas, ce sont trois traces de test, et la troisième trace nous indique qu'une erreur s'est produite. Ici, nous voyons également le traçage temporel : en haut, il y a une frise chronologique, et nous pouvons voir à quel intervalle de temps tel ou tel log a été enregistré.Par conséquent, tout s'est bien passé. Nous avons écrit notre propre extension, et nous l'avons open-sourcée. Si vous souhaitez travailler avec le traçage, si vous souhaitez utiliser «Eger» en PHP – voici notre extension, bienvenue à l'utiliser, comme on dit :
Notre extension est un client pour travailler avec l'Api OpenTracing, conçu comme un php-extension, c'est-à-dire qu'il vous faudra le compiler et l'ajouter au système. Il y a un an, il n'y avait rien d'autre. Maintenant, d'autres clients existent également sous forme de composants. C'est à vous de choisir : soit vous téléchargez des composants avec Composer, soit vous utilisez l'extension, à vous de décider.Normes d'entreprise
Nous avons parlé des trois commandements. Le quatrième commandement consiste à normaliser les approches. De quoi s'agit-il ? C'est à peu près de cela :
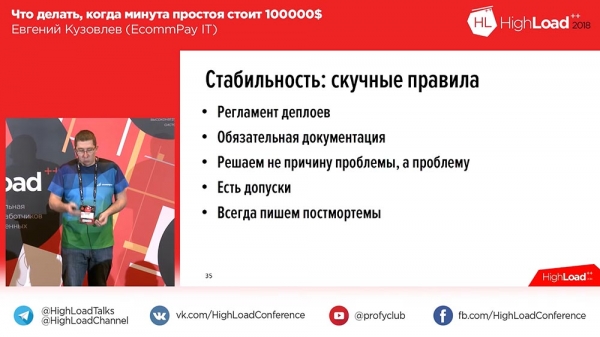
Pourquoi ici le mot «entreprise» ? Pas parce que nous sommes une grande ou bureaucratique société, non ! J'ai voulu utiliser le mot «entreprise» dans le contexte où chaque société, chaque produit doit avoir ses propres normes, tout comme vous. Quelles normes avons-nous ?- Nous avons un règlement sur les déploiements. Sans lui, nous ne pouvons pas avancer. Nous déployons environ 60 fois par semaine, donc nos déploiements se produisent presque constamment. À ce sujet, nous avons, par exemple, une interdiction de déployer le vendredi – en principe, nous ne déployons pas.
- Nous avons une documentation obligatoire. Aucun nouveau composant ne passe en production sans documentation, même s'il a été créé par nos RnD. Nous exi géons d'eux une instruction de déploiement, une carte de surveillance et une description approximative (comme les programmeurs peuvent l'écrire) de son fonctionnement et comment le dépanner.
- Nous ne résolvons pas la cause du problème, mais le problème lui-même – comme je l'ai déjà dit. Il est important pour nous de protéger l'utilisateur des problèmes.
- Nous avons des seuils. Par exemple, nous ne considérons pas qu'il y a downtime si nous perdons 2 % du trafic pendant deux minutes. Cela ne fait pas partie de nos statistiques. Si le pourcentage ou la durée est plus élevé, nous le considérons comme du downtime.
- Et nous rédigeons toujours des post-mortems. Quelle que soit la situation qui s'est mal déroulée en production, elle sera reflétée dans le post-mortem. Un post-mortem est un document dans lequel vous décrivez ce qui s'est passé, un timing détaillé, ce que vous avez fait pour corriger la situation et (c'est un bloc obligatoire !) ce que vous ferez pour éviter que cela ne se reproduise à l'avenir. C'est indispensable pour une analyse ultérieure.
Que considère-t-on comme downtime ?
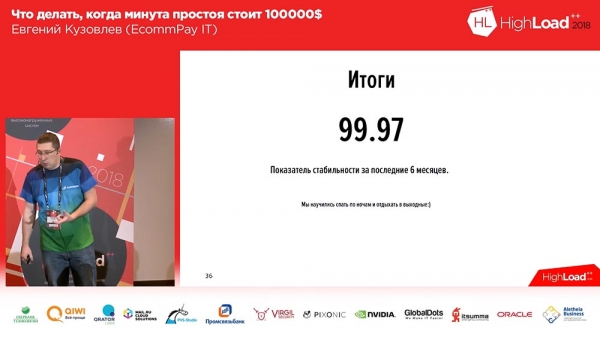
Qu'est-ce que cela a entraîné ?Cela a conduit au fait que (nous avons eu certains problèmes de stabilité, ce qui ne convenait ni à nos clients ni à nous) au cours des six derniers mois, notre indicateur de stabilité a été de 99,97. On peut dire que ce n'est pas très élevé. Oui, nous avons des objectifs à atteindre. Environ la moitié de cet indicateur est liée à la stabilité qui n'est pas vraiment la nôtre, mais celle de notre pare-feu d'application web, qui est en amont et utilisé comme service, mais cela reste indifférent pour les clients.
Nous avons appris à dormir la nuit. Enfin ! Il y a six mois, nous ne savions pas. Et sur cette note avec les résultats, j'aimerais faire une petite remarque. Hier soir, il y avait une excellente présentation sur le système de gestion d'un réacteur nucléaire. Si des personnes qui ont écrit ce système m'entendent – s'il vous plaît, oubliez ce que j'ai dit sur « 2 % – ce n'est pas du downtime ». Pour vous, 2 % est du downtime, même si c'est pendant deux minutes !
C'est tout ! Vos questions.
Sur les équilibreurs de charge et la migration de bases de données
Question du public (ci-après – Q) : – Bonsoir. Merci beaucoup pour cette présentation technique ! Une question brève sur vos équilibreurs de charge. Vous avez mentionné que vous avez un WAF, donc, si je comprends bien, en tant qu'équilibreur de charge, vous utilisez un service externe...
EK : – Non, pour les équilibreurs de charge, nous utilisons nos propres services. Dans ce cas, le WAF est uniquement un outil de protection contre les DDoS.
Q : – Pourriez-vous dire quelques mots sur les équilibreurs de charge ?
EK : – Comme je l'ai déjà dit, c'est un groupe de serveurs sous openresty. Nous avons actuellement 5 groupes de serveurs de secours qui ne s'occupent que... c'est-à-dire que le serveur sur lequel openresty est installé ne fait que proxyfier le trafic. Pour vous donner une idée, notre flux de trafic actuel est de plusieurs centaines de mégabits. Ils s'en sortent bien, c'est facile pour eux, même pas de stress.
Q : – Une question simple. Il y a le déploiement Blue/Green. Que faites-vous, par exemple, en ce qui concerne les migrations de bases de données ?
EK : – Bonne question ! Regardez, dans notre déploiement Blue/Green, nous avons des files d'attente distinctes pour chaque ligne. C'est-à-dire que si nous parlons des files d'attente d'événements qui sont transmises d'un worker à un autre, il y a des files séparées pour la ligne bleue et la ligne verte. En ce qui concerne la base de données elle-même, nous l'avons délibérément réduite au maximum, et presque tout est placé dans des files d'attente. Dans la base de données, nous ne stockons que une pile de transactions. Et la pile de transactions est unique pour toutes les lignes. Concernant la base de données dans ce contexte : nous ne la divisons pas en bleu et vert, car les deux versions du code doivent savoir ce qui se passe avec la transaction.
Les amis, j'ai encore un petit prix pour vous motiver – un livre. Et je dois le remettre pour la meilleure question.
Q : – Bonjour. Merci pour la présentation. La question est la suivante. Vous surveillez les paiements, vous surveillez les services avec lesquels vous interagissez... Mais comment surveillez-vous qu'une personne est arrivée sur votre page de paiement, a effectué le paiement et que le projet lui a crédité de l'argent ? En d'autres termes, comment surveillez-vous que le marchand est disponible et a acceptés votre callback ?
EK : – Le « marchand » pour nous dans ce cas est exactement le même type de service externe que le système de paiement. Nous surveillons la vitesse de réponse du « marchand ».
Sur le chiffrement des bases de données
Q : – Bonjour. J'ai une petite question à côté. Vous avez des données sensibles selon la norme PCI DSS. Je voulais savoir comment vous stockez les PAN dans les files d'attente que vous devez traiter ? Utilisez-vous un chiffrement ? Et d'où découle ma deuxième question : selon la norme PCI DSS, il est nécessaire de re-chiffrer périodiquement la base de données en cas de changements (comme le départ d'administrateurs, etc.) – comment cela affecte-t-il la disponibilité ?
EK : – Excellente question ! Tout d'abord, nous ne stockons pas les PAN dans les files d'attente. Nous n'avons pas le droit de stocker les PAN sous une forme non chiffrée, c'est donc pourquoi nous utilisons un service spécial (que nous appelons « Keydemon ») – c'est un service qui fait une seule chose : il reçoit un message et renvoie un message chiffré. Et nous stockons tout avec ce message chiffré. Par conséquent, la longueur de la clé est d'environ un kilooctet, c'est sérieux et fiable.Q : – Est-ce qu'il faut maintenant 2 kilooctets ?
EK : – Il semblerait qu'hier c'était encore 256… Combien encore ?!
C'est donc la première chose. Deuxièmement, la solution disponible prend en charge la procédure de re-chiffrement – il y a deux paires de « KEKs » (keys encrypting keys) qui produisent des « DEKs » qui chiffrent (key – c'est les clés, dek – c'est des dérivés des clés qui chiffrent). En cas d'initiation de la procédure (qui a lieu régulièrement, tous les 3 mois ou ± quelque chose), nous chargeons une nouvelle paire de « KEKs », et nous procédons au re-chiffrement des données. Nous avons des services distincts qui extraient toutes les données, les chiffrent à nouveau ; pour chaque donnée, un identifiant de clé est stocké, celle-ci ayant été chiffrée. Dès que les données sont chiffrées avec les nouvelles clés, nous supprimons les anciennes clés.
Parfois, les paiements doivent être effectués manuellement…
Q : – Donc si un remboursement pour une opération arrive, vous déchiffrez avec l'ancienne clé ?
EK : – Oui.
Q : – Alors, encore une petite question. Lorsqu'il y a une défaillance, un plantage ou un incident, il est nécessaire de traiter la transaction manuellement. Cela peut arriver.
EK : – Oui, ça arrive.
Q : – D'où prenez-vous ces données ? Ou vous allez vous-même manuellement dans ce stockage ?
EK : – Non, bien sûr, nous avons un système de back-office qui contient une interface pour notre support. Si nous ne savons pas dans quel état se trouve la transaction (par exemple, tant que le système de paiement n'a pas encore répondu par un timeout) – nous ne savons pas a priori, c'est-à-dire que nous n'attribuons le statut final qu'avec une certitude absolue. Dans ce cas, nous transférons la transaction dans un statut spécial pour traitement manuel. Le matin, le lendemain, dès que le support reçoit l'information que le système de paiement a certaines transactions en cours, ils les traitent manuellement dans cette interface.
Q : – J'ai quelques questions. L'une d'elles concerne les journaux de conformité PCI DSS : comment extrayez-vous les logs de leur périmètre ? Je pose cette question parce que le développeur pourrait avoir mis n'importe quoi dans les logs ! Deuxième question : comment déployez-vous les correctifs ? Manuellement dans la base, c'est une option, mais il peut y avoir des correctifs gratuits – quelle est la procédure ? Et la troisième question est probablement liée à RTO et RPO. Vous aviez une disponibilité de 99,97, presque quatre nines, mais je comprends que vous avez également un deuxième, un troisième, et un cinquième centre de données… Comment gérez-vous leur synchronisation, leur réplication, et tout le reste ?EK : – Commençons par la première. La première question portait sur les logs, n'est-ce pas ? Lorsque les logs sont écrits, il y a une couche intermédiaire qui masque toutes les données sensibles. Elle examine les données à l'aide d'un masque et d'autres champs. En conséquence, nos logs sortent avec des données déjà masquées et répondent aux exigences PCI DSS. C'est l'une des tâches régulières qui revient au département des tests. Ils doivent vérifier chaque tâche, y compris les logs qu'ils écrivent, et c'est une des tâches régulières lors de la revue de code, pour contrôler que le développeur n'a pas enregistré quelque chose. Le contrôle ultérieur est effectué régulièrement par le département de la sécurité de l'information, environ une fois par semaine : ils prennent de manière aléatoire les logs du dernier jour, et ils les passent par un analyseur de scanner spécialement dédié pour tout vérifier.
À propos des hot-fixes. Cela fait partie de notre réglementation de déploiements. Nous avons un point spécifique concernant les hot-fixes. Nous considérons que nous déployons des hot-fixes 24 heures sur 24, chaque fois que cela est nécessaire. Dès que la version est assemblée, validée et qu'un artefact est disponible, un administrateur système de garde est appelé par le support, et il déploie cela au moment où cela est nécessaire.À propos des « quatre nines ». Le chiffre que nous avons actuellement a réellement été atteint, et nous visons encore ce résultat dans un autre centre de données. Nous avons maintenant un deuxième centre de données, et nous commençons à router entre eux. La question de la réplication entre centres de données est en effet un problème complexe. Nous avons tenté de le résoudre par divers moyens à l'époque : nous avons essayé d'utiliser le même « Tarantool » – ça n'a pas fonctionné, je le dis tout de suite. Donc, nous avons décidé de faire des commandes « senza » manuellement. En fait, chaque application fonctionne en mode asynchrone avec la synchronisation nécessaire « changement – fait » entre les centres de données.
Q : – Si vous avez un deuxième, alors pourquoi n’avez-vous pas un troisième ? Parce que le Split-brain personne ne…
EK : – Nous n'avons pas de « Split-brain ». Comme chaque application fonctionne avec un multi-maître, il n'importe pas dans quel centre la demande est arrivée. Nous sommes préparés à ce que, si un centre de données s'effondre (nous prévoyons cela), et qu'au milieu de la demande de l'utilisateur, nous basculions vers le deuxième centre de données, nous sommes prêts à perdre cet utilisateur, effectivement ; mais cela ne concernera que quelques cas, des cas vraiment isolés.
Q : – Bonsoir. Merci pour votre présentation. Vous avez parlé de votre débogueur qui exécute des transactions de test en production. Mais parlez-nous des transactions de test ! Jusqu'où cela va-t-il ?
EK : – Cela passe par le cycle complet de tout le composant. Il n'y a pas de distinction entre une transaction de test et une transaction réelle pour le composant. En termes de logique, c'est simplement un projet distinct dans le système, qui ne traite que des transactions de test.
Q : – Et où l'interrompez-vous ? Core a envoyé…
EK : – Nous suivons « Core » dans ce cas pour les transactions de test… Nous avons un concept appelé routage : « Core » sait dans quel système de paiement il doit envoyer – nous envoyons vers un système de paiement fictif, qui ne fait qu'un simple feedback http et c'est tout.
Q : Pouvez-vous me dire, s'il vous plaît, votre application est-elle écrite comme un énorme monolithe, ou l'avez-vous découpée en services ou même en microservices ?
EK : Nous n'avons pas de monolithe, bien sûr, nous avons une application orientée services. Nous avons une blague disant que nous avons des services à partir de monolithes – ils sont en effet assez grands. On ne peut pas vraiment appeler ça des microservices, mais ce sont bien des services où travaillent des travailleurs de machines distribuées.
Si un service sur le serveur est compromis…
Q : Alors j'ai une question suivante. Même si c'était un monolithe, vous avez dit que vous avez beaucoup de ces serveurs instantanés, tous capables de traiter des données, et ma question est : "En cas de compromission de l'un de ces serveurs instantanés ou d'une application, d'un élément particulier, ont-ils un contrôle d'accès ? Qui peut faire quoi ? À qui s'adresser pour quelles données ?"
EK : Oui, sans aucun doute. Les exigences de sécurité sont assez strictes. Tout d'abord, nous avons des mouvements de données ouverts, et les ports sont seulement ceux par lesquels nous prévoyons à l'avance le mouvement du trafic. Si un composant communique avec une base de données (par exemple, avec 'MySQL') sur le port 5-4-3-2, seuls les ports 5-4-3-2 seront ouverts, et d'autres ports, d'autres directions de trafic ne seront pas accessibles. De plus, il faut comprendre qu'il existe environ 10 contours de sécurité différents en production. Et même si l'application était compromise d'une manière ou d'une autre, Dieu nous en préserve, l'attaquant ne pourra pas accéder à la console de gestion du serveur car c'est une autre zone de sécurité réseau.Q : Ce qui m'intéresse davantage dans ce contexte, c'est que vous avez des contrats avec les services – ce qu'ils peuvent faire, à travers quelles « actions » ils peuvent s'adresser les uns aux autres… Et dans un flux normal, certains services demandent une certaine liste d'« actions » aux autres. En temps normal, ils ne s'adressent pas aux autres, et ils ont d'autres zones de responsabilité. Si l'un d'eux est compromis, pourra-t-il exécuter les « actions » de cet autre service ?
EK : – Je comprends. Si, dans une situation normale avec un autre serveur, la communication était généralement autorisée, alors oui. Selon notre contrat SLA, nous ne vérifions pas que seuls les trois premiers « actions » vous sont permis, tandis que la quatrième « action » vous est interdite. C'est probablement excessif pour nous, car nous avons déjà un système de protection à quatre niveaux conçu pour les périmètres. Nous préférons nous défendre via des périmètres plutôt qu'au niveau des composants internes.
Comment fonctionnent Visa, MasterCard et Sberbank
Q : – Je souhaite clarifier le point concernant le basculement d'un utilisateur d'un centre de données à un autre. D'après ce que je sais, Visa et MasterCard fonctionnent selon le protocole de synchronisation binaire 8583, avec des mixeurs. J'aimerais savoir si le basculement concerne directement Visa et MasterCard ou s'il s'agit des systèmes de paiement, jusqu'aux processeurs ?
EK : – Cela concerne les mixeurs. Nos mixeurs se trouvent dans un seul centre de données.
Q : – Grosso modo, vous avez un seul point de connexion ?
EK : – Pour Visa et MasterCard, oui. Tout simplement parce que Visa et MasterCard nécessitent un investissement assez conséquent dans l'infrastructure pour établir des contrats séparés afin d'obtenir une deuxième paire de mixeurs, par exemple. Ils sont réservés dans le cadre d'un même centre de données, mais si jamais notre centre de données, Dieu nous en préserve, s'arrête, la connexion avec Visa et MasterCard sera perdue...
Q : – Comment peuvent-ils être réservés ? Je sais que Visa autorise seulement une connexion à garder en principe !
EK : – Ils fournissent eux-mêmes l'équipement. Quoi qu'il en soit, nous avons reçu un équipement qui est rigoureusement réservé à l'intérieur.
Q : – Donc le rack provient de leurs Connects Orange ?...
EK : – Oui.
Q : – Et dans ce cas : si votre centre de données disparaît, comment continuer à l'utiliser ? Ou le trafic s'arrête-t-il simplement ?
EK : – Non. Dans ce cas, nous allons simplement rediriger le trafic vers un autre canal, qui, bien sûr, sera plus coûteux pour nous, plus coûteux pour les clients. Mais le trafic ne passera pas par notre connexion directe à Visa, MasterCard, mais via un Sberbank conditionnel (pour simplifier).
Je m'excuse sincèrement si j'ai offensé les employés de Sberbank. Mais d'après nos statistiques, parmi les banques russes, Sberbank tombe le plus souvent en panne. Il ne se passe pas un mois sans que quelque chose ne tombe en panne chez Sberbank.

Un peu de publicité 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenu intéressant ? Soutenez-nous en passants une commande ou en nous recommandant à des amis, , un équivalent unique des serveurs d'entrée de gamme, conçu pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd deux fois moins cher dans le data center Equinix Tier IV à Amsterdam ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
