

La configuration du stockage des données pour les applications exécutées dans un cluster Kubernetes peut être effectuée de plusieurs manières. Certaines sont déjà obsolètes, d'autres sont apparues récemment. Dans cet article, nous examinerons le concept de trois options de connexion aux systèmes de stockage, y compris la plus récente — la connexion via l'interface Container Storage Interface.
Méthode 1. Spécification du PV dans le manifeste du pod
Un manifeste typique décrivant un pod dans un cluster Kubernetes :
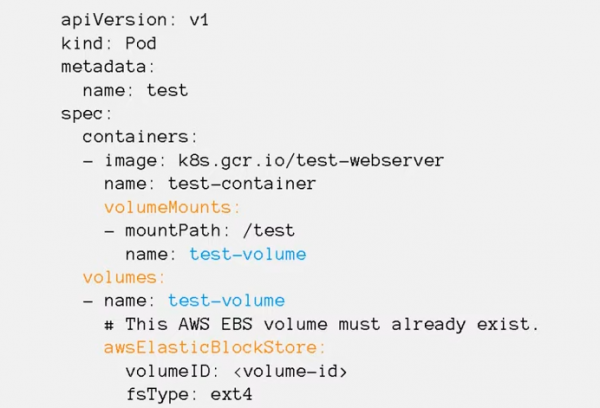
Les parties du manifeste où il est indiqué quel volume est connecté et où sont mises en évidence en couleur.
Dans la section volumeMounts indiquent les points de montage (mountPath) — dans quel répertoire à l'intérieur du conteneur le volume persistant sera monté, ainsi que le nom du volume.
Dans la section x énumèrent tous les volumes utilisés dans le pod. Ils précisent le nom de chaque volume, ainsi que le type (dans notre cas : awsElasticBlockStore) et les paramètres de connexion. Les paramètres spécifiques inclus dans le manifeste dépendent du type de volume.
Le même volume peut être monté simultanément dans plusieurs conteneurs du pod. Ainsi, différents processus de l'application peuvent accéder aux mêmes données.
Cette méthode de connexion a été conçue au tout début, lorsque Kubernetes était encore en développement, et aujourd'hui, cette méthode est obsolète.
Son utilisation entraîne plusieurs problèmes :
- tous les volumes doivent être créés manuellement, Kubernetes ne pourra rien créer pour nous ;
- les paramètres d'accès à chacun des volumes sont uniques et doivent être spécifiés dans les manifestes de tous les pods qui utilisent le volume ;
- pour changer le système de stockage (par exemple, passer d'AWS à Google Cloud), il faut modifier les paramètres et le type des volumes connectés dans tous les manifestes.
Tout cela est très peu pratique, c'est pourquoi dans la réalité, une telle méthode n'est utilisée que pour connecter certains types spéciaux de volumes : configMap, secret, emptyDir, hostPath :
configMap et secret — volumes de service, permettent de créer dans le conteneur un volume avec des fichiers issus des manifestes Kubernetes.
emptyDir — volume temporaire, créé uniquement pendant la durée de vie du pod. Il est pratique à utiliser pour les tests ou pour le stockage de données temporaires. Lorsque le pod est supprimé, le volume de type emptyDir est également supprimé et toutes les données sont perdues.
hostPath — permet de monter dans le conteneur d'application n'importe quel répertoire du disque local du serveur sur lequel l'application fonctionne, y compris /etc/kubernetes. C'est une fonctionnalité peu sécurisée, donc les politiques de sécurité interdisent généralement l'utilisation de volumes de ce type. Sinon, une application malveillante pourrait monter dans son conteneur le répertoire HTC Kubernetes et voler tous les certificats du cluster. En règle générale, les volumes hostPath ne sont autorisés qu'aux applications système qui s'exécutent dans l'espace de noms kube-system.
sont décrits dans la documentation.
Méthode 2. Connexion aux pods SC/PVC/PV
Une méthode alternative de connexion est le concept de Storage class, PersistentVolumeClaim, PersistentVolume.
Storage class stocke les paramètres de connexion au système de stockage.
PersistentVolumeClaim décrit les exigences concernant le volume nécessaire à l'application.
PersistentVolume stocke les paramètres d'accès et l'état du volume.
L'idée principale : dans le manifeste du pod, on spécifie un volume de type PersistentVolumeClaim et on indique le nom de cette entité dans le paramètre claimName.
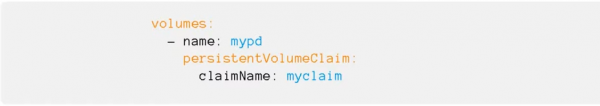
Dans le manifeste PersistentVolumeClaim, on décrit les exigences concernant le volume de données nécessaire à l'application. Cela inclut :
- la taille du disque ;
- le mode d'accès : ReadWriteOnce ou ReadWriteMany ;
- le lien vers Storage class — dans quel système de stockage nous voulons créer le volume.
Dans le manifeste Storage class, on stocke le type et les paramètres de connexion au système de stockage. Ils sont nécessaires au kubelet pour monter le volume sur son nœud.
Dans les manifestes PersistentVolume, on indique Storage class et les paramètres d'accès au volume spécifique (ID du volume, chemin, etc.).
En créant un PVC, Kubernetes vérifie de quelle taille de volume et de quel Storage class il a besoin, et sélectionne un PersistentVolume disponible.
S'il n'y a pas de tels PV disponibles, Kubernetes peut lancer un programme spécial — Provisioner (son nom est indiqué dans Storage class). Ce programme se connecte au système de stockage, crée le volume de la taille requise, obtient l'identifiant et crée dans le cluster Kubernetes un manifeste PersistentVolume qui est lié au PersistentVolumeClaim.
Tout cela permet d'éliminer les détails concernant le système de stockage avec lequel l'application travaille du niveau du manifeste des applications au niveau de l'administration.
Tous les paramètres de connexion au système de stockage se trouvent dans la classe de stockage, dont sont responsables les administrateurs de clusters. Tout ce que vous devez faire lors du passage d'AWS à Google Cloud, c'est de modifier le nom de la classe de stockage dans le PVC dans les manifestes d'application. Les volumes persistants pour le stockage des données seront créés automatiquement dans le cluster à l'aide du programme Provisioner.
Méthode 3. Interface de Stockage de Conteneurs
Tout le code interagissant avec les différents systèmes de stockage est intégré au noyau de Kubernetes. La publication de corrections ou de nouvelles fonctionnalités est liée aux nouvelles versions, le code doit être modifié pour toutes les versions prises en charge par Kubernetes. Tout cela est difficile à maintenir et à ajouter de nouvelles fonctionnalités.
Pour résoudre le problème, les développeurs de Cloud Foundry, Kubernetes, Mesos et Docker ont créé l'Interface de Stockage de Conteneurs (CSI) — une interface unifiée simple décrivant l'interaction entre le système de gestion de conteneurs et un pilote spécifique (CSI Driver) travaillant avec un stockage spécifique. Tout le code concernant l'interaction avec le stockage a été extrait du noyau de Kubernetes dans un système distinct.
.
En général, le CSI Driver se compose de deux composants : le Node Plugin et le Controller Plugin.
Le Node Plugin s'exécute sur chaque nœud et est responsable du montage des volumes et des opérations sur ceux-ci. Le Controller Plugin interagit avec le stockage : il crée ou supprime des volumes, attribue des droits d'accès, etc.
Tant que d'anciens pilotes restent dans le noyau de Kubernetes, leur utilisation n'est plus recommandée et tout le monde est conseillé d'installer le CSI Driver spécifique au système avec lequel il travaille.
Cette nouveauté peut effrayer ceux qui sont déjà habitués à configurer le stockage des données via la classe de stockage, mais en réalité, rien de grave ne s'est produit. Pour les développeurs, rien ne change réellement - ils continueront à travailler uniquement avec le nom de la classe de stockage. Pour les administrateurs, l'installation du helm chart a été ajoutée et la structure des configurations a changé. Auparavant, les configurations étaient directement saisies dans la classe de stockage, maintenant elles doivent d'abord être définies dans le helm chart, puis dans la classe de stockage. En y regardant de plus près, rien de grave ne s'est passé.
Prenons un exemple et voyons quels avantages peuvent être obtenus en passant à la connexion au stockage Ceph à l'aide du driver CSI.
Lorsque vous travaillez avec Ceph, le plugin CSI offre plus de possibilités de travail avec le stockage que les pilotes intégrés.
- Création dynamique de disques. Normalement, les disques RBD ne sont utilisés qu'en mode RWO, mais le CSI pour Ceph permet de les utiliser en mode RWX. Plusieurs pods sur différents nœuds peuvent monter le même disque RDB sur leurs nœuds et travailler avec eux en parallèle. À l'honneur de la vérité, tout n'est pas si éclatant — ce disque ne peut être connecté qu'en tant que périphérique de bloc, ce qui signifie qu'il faudra adapter l'application pour fonctionner avec lui en mode d'accès multiple.
- Création de snapshots. Dans un cluster Kubernetes, il est possible de créer un manifeste avec une demande de création de snapshot. Le plugin CSI le verra et effectuera un snapshot du disque. Sur cette base, il sera possible de faire soit une sauvegarde, soit une copie du PersistentVolume.
- Augmentation de la taille du disque sur le stockage et le PersistentVolume dans le cluster Kubernetes.
- Quotas. Les pilotes CephFS intégrés dans Kubernetes ne prennent pas en charge les quotas, tandis que les nouveaux plugins CSI avec le nouveau Ceph Nautilus peuvent activer les quotas sur les partitions CephFS.
- Métriques. Le plugin CSI peut fournir à Prometheus de nombreuses métriques sur les volumes connectés, les interactions, etc.
- Topologie consciente. Permet d'indiquer dans les manifestes comment le cluster est géographiquement distribué et d'éviter de se connecter à des pods, exécutés à Londres, à un stockage de données situé à Amsterdam.
Pour savoir comment connecter Ceph à un cluster Kubernetes via CSI, consultez . Vous pouvez également vous inscrire au , qui débutera le 15 octobre.
L'auteur de l'article : Sergey Bondarev, architecte praticien chez Southbridge, Administrateur Kubernetes certifié, l'un des développeurs de kubespray.
Un petit Post Scriptum non publicitaire mais utile…
P.S. Sergey Bondarev anime deux sessions intensives : la mise à jour du 28 au 30 septembre et avancée du 14 au 16 octobre.
Source : habr.com
