

Cela fait plus de 20 ans que nous consultons des pages Web via le protocole HTTP. La plupart des utilisateurs ne se rendent même pas compte de ce que c'est et comment cela fonctionne. D'autres savent qu'il y a quelque part sous HTTP du TLS, puis TCP, puis IP, et ainsi de suite. Et enfin, certains hérétiques estiment que TCP est dépassé et désirent quelque chose de plus rapide, plus fiable et plus sécurisé. Cependant, dans leurs tentatives d'inventer un nouveau protocole idéal, ils reviennent à des technologies des années 80 pour essayer de construire leur nouveau monde merveilleux.
Un peu d'histoire : HTTP/1.1
En 1997, le protocole d'échange d'informations textuelles HTTP version 1.1 a obtenu son RFC. À l'époque, le protocole était déjà utilisé par les navigateurs depuis plusieurs années, et la nouvelle norme a duré encore quinze ans. Ce protocole fonctionnait uniquement sur le principe de la demande-réponse et était principalement destiné à la transmission d'informations textuelles.
HTTP a été conçu pour fonctionner au-dessus du protocole TCP, garantissant la livraison fiable des paquets au destinataire. Le fonctionnement de TCP repose sur l'établissement et le maintien d'une connexion fiable entre les points finaux et le découpage du trafic en segments. Les segments ont un numéro de séquence et un code de contrôle. Si un des segments ne parvient pas ou arrive avec un code de contrôle incorrect, la transmission s'arrête jusqu'à ce que le segment perdu soit restitué.
Dans HTTP/1.0, la connexion TCP se fermait après chaque demande. C'était extrêmement gaspilleur, car l'établissement d'une connexion TCP (3-Way-Handshake) n'est pas un processus rapide. Dans HTTP/1.1, un mécanisme keep-alive a été introduit, permettant de réutiliser une seule connexion pour plusieurs demandes. Toutefois, comme cela peut facilement devenir un goulot d'étranglement, différentes implémentations de HTTP/1.1 autorisent l'ouverture de plusieurs connexions TCP vers un même hôte. Par exemple, dans Chrome et dans les versions récentes de Firefox, jusqu'à six connexions sont autorisées.
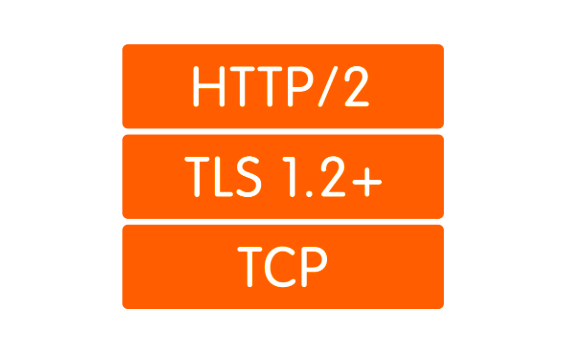
Le chiffrement devait également être confié à d'autres protocoles, et pour cela, le protocole TLS a été utilisé au-dessus de TCP, protégeant les données de manière assez fiable, mais augmentant encore davantage le temps nécessaire à l'établissement de la connexion. Au final, le processus de poignée de main ressemblait à ceci :
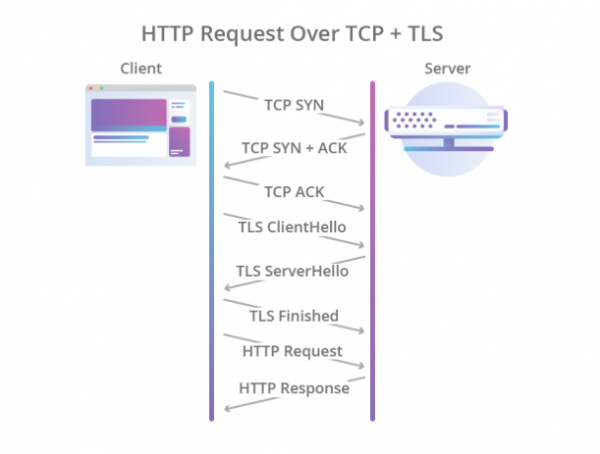
Illustration Cloudflare
Ainsi, HTTP/1.1 avait un certain nombre de problèmes :
- Installation de connexion lente.
- Les données sont transmises sous forme de texte, ce qui signifie que la transmission d'images, de vidéos et d'autres informations non textuelles est inefficace.
- Une connexion TCP est utilisée pour une seule requête, ce qui signifie que les autres requêtes doivent soit trouver une autre connexion, soit attendre que la requête en cours se libère.
- Seul le modèle pull est pris en charge. La norme ne parle pas du server-push.
- Les en-têtes sont transmis en texte.
Si le server-push est plus ou moins réalisé par le protocole WebSocket, d'autres problèmes doivent être abordés de manière plus radicale.
Un peu de modernité : HTTP/2
En 2012, Google a commencé à travailler sur le protocole SPDY (prononcé « speedy »). Ce protocole visait à résoudre les principaux problèmes de HTTP/1.1 tout en maintenant la rétrocompatibilité. En 2015, le groupe de travail IETF a présenté la spécification HTTP/2, basée sur le protocole SPDY. Voici les différences dans HTTP/2 :
- Sérialisation binaire.
- Multiplexage de plusieurs requêtes HTTP dans une seule connexion TCP.
- Server-push intégré (sans WebSocket).
Le protocole a constitué un grand pas en avant. Il améliore considérablement et ne nécessite pas de créer plusieurs connexions TCP : toutes les requêtes vers un même hôte sont multiplexées en une seule. Cela signifie qu'il y a plusieurs flux dits, chacun ayant son propre ID. En prime, on a le server-push intégré.
Cependant, le multiplexage entraîne un autre problème fondamental. Imaginez que nous effectuons de manière asynchrone 5 requêtes vers un même serveur. Avec HTTP/2, toutes ces requêtes seront exécutées dans le cadre d'une connexion TCP unique, donc si un segment de l'une des requêtes est perdu ou mal reçu, la transmission de toutes les requêtes et réponses sera arrêtée jusqu'à ce que le segment perdu soit récupéré. Évidemment, plus la qualité de la connexion est mauvaise, plus HTTP/2 fonctionne lentement. , dans des conditions où les paquets perdus représentent 2 % du total, HTTP/1.1 se comporte mieux dans le navigateur que HTTP/2 car il ouvre 6 connexions au lieu d'une.
Ce problème est appelé « head-of-line blocking » et, malheureusement, il semble impossible de le résoudre en utilisant TCP.
Illustration Daniel Steinberg
En fin de compte, les développeurs de la norme HTTP/2 ont réalisé un travail énorme et ont fait pratiquement tout ce qui pouvait être fait au niveau applicatif du modèle OSI. Il est temps de descendre au niveau de transport et d'inventer un nouveau protocole de transport.
Nous avons besoin d'un nouveau protocole : UDP vs TCP
Il est rapidement devenu clair qu'implémenter un tout nouveau protocole de niveau transport est un défi insurmontable dans les réalités d'aujourd'hui. En effet, le niveau de transport est connu des équipements ou des middle-boxes (routeurs, pare-feux, serveurs NAT…), et il est très difficile de leur apprendre quelque chose de nouveau. De plus, le support des protocoles de transport est intégré dans le noyau des systèmes d'exploitation, et les noyaux changent également assez rarement.
On pourrait alors baisser les bras et dire « Bien sûr, nous allons inventer un nouveau HTTP/3 avec des atouts et des courtisanes, mais son adoption prendra 10-15 ans (environ le temps qu'il faudra pour que la plupart des équipements soient remplacés) », mais il existe une autre option, pas si évidente : utiliser le protocole UDP. Oui, ce même protocole avec lequel nous échangeons des fichiers sur le réseau local à la fin des années 90 et au début des années 2000. Pratiquement tous les équipements d'aujourd'hui savent comment travailler avec cela.
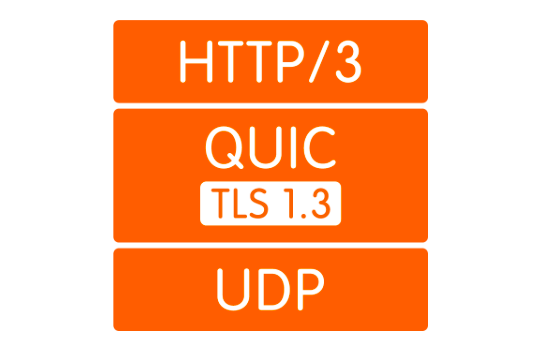
Quels sont les avantages d'UDP par rapport à TCP ? Tout d'abord, il n'y a pas de session de niveau de transport, connue des équipements. Cela nous permet de définir nous-mêmes la session aux points finaux et de gérer les conflits qui pourraient survenir. Cela signifie que nous ne sommes pas limités à une ou plusieurs sessions (comme dans TCP), mais pouvons en créer autant que nous le souhaitons. Deuxièmement, la transmission des données via UDP est plus rapide que via TCP. Ainsi, en théorie, nous pourrions percer le plafond de vitesse actuel atteint avec HTTP/2.
Cependant, UDP ne garantit pas la fiabilité de la transmission des données. En fait, nous envoyons simplement des paquets, espérant qu'ils seront reçus à l'autre bout. Pas reçu ? Eh bien, tant pis… Cela était suffisant pour transmettre des vidéos pour adultes, mais pour des choses plus sérieuses, la fiabilité est nécessaire, ce qui signifie qu'il faudra ajouter quelque chose au-dessus de l'UDP.
Tout comme dans le cas de HTTP/2, le travail sur la création d'un nouveau protocole a commencé chez Google en 2012, c'est-à-dire à peu près au même moment que le début du travail sur SPDY. En 2013, Jim Roskind a présenté au grand public , en 2015, un Internet Draft a été soumis pour standardisation à l'IETF. À ce moment-là, le protocole développé par Roskind chez Google était déjà très différent de la version proposée pour le standard, c'est pourquoi la version de Google a été surnommée gQUIC.
Qu'est-ce que QUIC
Tout d'abord, comme déjà mentionné, c'est un wrapper au-dessus de l'UDP. Au-dessus de l'UDP, une connexion QUIC est établie, où plusieurs flux peuvent exister, comme avec HTTP/2. Ces flux existent uniquement aux points finaux et sont gérés de manière indépendante. Si un paquet est perdu dans un flux, les autres ne sont pas affectés.
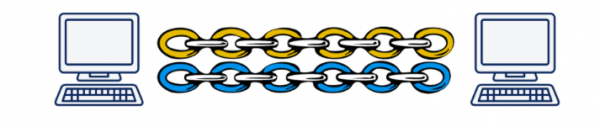
Illustration Daniel Steinberg
Deuxièmement, le chiffrement est désormais intégré dans le protocole plutôt que sous forme d'un niveau séparé. Cela permet d'établir une connexion et d'échanger des clés publiques en un seul échange, et d'utiliser un astucieux mécanisme de handshake 0-RTT pour éviter les délais lors de l'établissement de la connexion. De plus, il est maintenant possible de chiffrer des paquets de données individuels. Cela permet de déchiffrer les paquets reçus indépendamment, sans attendre la fin de la réception des données du flux. Ce mode de fonctionnement était impossible avec TCP, car TLS et TCP fonctionnaient indépendamment l'un de l'autre, et TLS ne pouvait pas savoir comment les données seraient fragmentées par TCP. Par conséquent, il ne pouvait pas préparer ses segments pour qu'ils s'adaptent segment par segment avec ceux de TCP et puissent être déchiffrés de manière indépendante. Toutes ces améliorations permettent à QUIC de réduire la latence par rapport à TCP.
Troisièmement, le concept de flux légers permet de dissocier la connexion de l'adresse IP du client. Cela est important, par exemple, lorsque le client passe d'un point d'accès Wi-Fi à un autre, changeant ainsi son IP. Dans ce cas, avec TCP, un long processus se déroule, au cours duquel les connexions TCP existantes expirent et de nouvelles connexions sont établies avec la nouvelle IP. Avec QUIC, le client continue simplement à envoyer des paquets au serveur à partir de la nouvelle IP avec l'ancien ID de flux. Étant donné que l'ID de flux est désormais unique et non réutilisé, le serveur comprend que le client a changé d'IP, renvoie les paquets perdus et poursuit la communication à la nouvelle adresse.
Quatrièmement, QUIC est implémenté au niveau de l'application et non au niveau du système d'exploitation. D'une part, cela permet de modifier le protocole plus rapidement, car pour obtenir une mise à jour, il suffit de mettre à jour la bibliothèque, au lieu d'attendre une nouvelle version de l'OS. D'autre part, cela entraîne une forte augmentation de la consommation du processeur.
Enfin, parlons des en-têtes. La compression des en-têtes est justement l'un des aspects qui diffèrent entre QUIC et gQUIC. Je ne vois pas l'intérêt d'y consacrer beaucoup de temps, je dirai simplement que dans la version soumise à la normalisation, la compression des en-têtes a été rendue aussi similaire que possible à celle du HTTP/2. Vous pouvez en lire plus. .
À quel point est-ce plus rapide ?
C'est une question complexe. Le fait est qu'en l'absence de norme, il n'y a pas grand-chose à mesurer. Peut-être que les seules données statistiques dont nous disposons sont celles de Google, qui utilise gQUIC depuis 2013 et en 2016 , que près de 90 % du trafic vers leurs serveurs en provenance du navigateur Chrome utilise désormais QUIC. Dans cette même présentation, ils annoncent que via gQUIC, les pages se chargent environ 5 % plus rapidement, et qu'il y a 30 % de moins de « freezes » pour la vidéo en streaming par rapport à TCP.
En 2017, un groupe de chercheurs dirigé par Arash Molavi Kakhki a publié une étude sur la performance de gQUIC par rapport à TCP.
L'étude a mis en évidence plusieurs faiblesses de gQUIC, telles que sa sensibilité au mélange des paquets réseau, son avidité (unfairness) en matière de bande passante, et la transmission plus lente des petits objets (jusqu'à 10 Ko). Cette dernière, en revanche, peut être compensée par l'utilisation du 0-RTT. Dans tous les autres cas étudiés, gQUIC a montré une augmentation de la vitesse par rapport à TCP. Il est difficile de parler de chiffres ici. Mieux vaut lire ou .
Il convient de noter que ces données concernent précisément gQUIC, et elles ne sont pas pertinentes pour la norme en cours d'élaboration. Ce que sera QUIC : c'est encore un mystère, mais on espère que les faiblesses identifiées dans gQUIC seront prises en compte et corrigées.
Un peu d'avenir : qu'en est-il de HTTP/3 ?
Ici, tout est clair : l'API ne changera pas. Tout restera exactement comme c'était dans HTTP/2. Et si l'API reste la même, le passage à HTTP/3 devra être résolu en utilisant une version récente de la bibliothèque côté serveur, prenant en charge le transport via QUIC. Cependant, il faudra encore un bon moment pour maintenir une rétrocompatibilité avec les anciennes versions d'HTTP, car Internet n'est pas encore prêt pour une transition complète vers UDP.
Qui supporte déjà
Voici les implémentations existantes de QUIC. Malgré le manque de norme, la liste est plutôt bonne.
Aucun navigateur ne prend actuellement en charge QUIC en version stable. Récemment, des informations ont été publiées sur le fait que Chrome a activé la prise en charge de HTTP/3, mais seulement dans la version Canary.
Parmi les serveurs, seul et le support de HTTP/3 est disponible, mais seulement de manière expérimentale. NGINX a commencé à travailler sur la prise en charge de HTTP/3 à la fin du printemps 2019. , but has not yet finished.
Quels sont les problèmes
Nous vivons dans un monde réel où aucune grande technologie ne peut se répandre sans rencontrer de résistances, et QUIC n'est pas une exception.
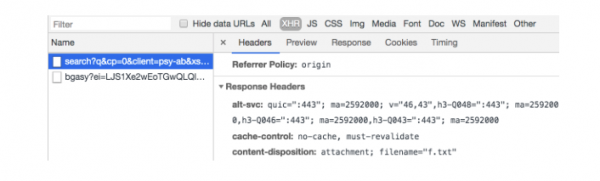
Le plus important est qu'il faut expliquer au navigateur que "https://" ne mène peut-être pas au port TCP 443. Il se peut qu'il n'y ait même pas de TCP. Pour cela, on utilise l'en-tête Alt-Svc. Il permet de signaler au navigateur que ce site web est également accessible sur un autre protocole à une certaine adresse. En théorie, ça devrait fonctionner parfaitement, mais en pratique, nous serons confrontés au fait que UDP peut être interdit par le pare-feu pour éviter les attaques DDoS.
Mais même si UDP n'est pas bloqué, le client peut se trouver derrière un routeur NAT configuré pour maintenir la session TCP par adresse IP, et comme nous utilisons UDP, qui n'a pas de session de matériel, le NAT ne maintiendra pas la connexion, et la session QUIC .
Tous ces problèmes sont liés au fait que UDP n'a pas été utilisé auparavant pour le transfert de contenu Internet, et les fabricants de matériel n'avaient pas prévu que cela arriverait un jour. De même, les administrateurs ne comprennent pas très bien comment configurer correctement leurs réseaux pour le fonctionnement de QUIC. Cette situation commencera lentement à changer, et de toute façon, ces changements prendront moins de temps que l'implémentation d'un nouveau protocole de transport.
De plus, comme indiqué précédemment, QUIC augmente considérablement l'utilisation du processeur. Daniel Stenberg une augmentation du processeur allant jusqu'à trois fois.
Quand HTTP/3 arrivera
Standard À la mi-mai 2020, et compte tenu du fait que les documents prévus pour juillet 2019 ne sont toujours pas finalisés, on peut dire que la date sera probablement repoussée.
En effet, Google utilise sa propre implémentation de gQUIC depuis 2013. Si l'on examine la requête HTTP envoyée au moteur de recherche Google, on peut y voir ceci :
Conclusions
QUIC semble actuellement être une technologie encore en développement, mais avec un potentiel très prometteur. Étant donné que, ces 20 dernières années, toutes les optimisations des protocoles de transport se sont principalement concentrées sur TCP, QUIC, qui surpasse souvent en performance, apparaît déjà très favorable.
Cependant, il existe encore des problèmes non résolus qu'il faudra aborder dans les années à venir. Le processus pourrait prendre du temps à cause de l'équipement, que personne n'aime mettre à jour, mais toutes les questions semblent néanmoins assez solutionnables, et tôt ou tard, nous aurons tous HTTP/3.
L'avenir est à portée de main !
Source : habr.com
