

Dans cet article, je partage mes réflexions sur l'histoire et les perspectives de développement d'Internet, des réseaux centralisés et décentralisés, et par conséquent, sur l'architecture possible d'un réseau décentralisé de nouvelle génération.
Il y a quelque chose qui ne va pas avec Internet
J'ai découvert Internet pour la première fois en 2000. Bien sûr, ce n'est pas le tout début — le réseau existait déjà auparavant, mais cette époque peut être considérée comme le premier âge d'or d'Internet. Le World Wide Web — une invention géniale de Tim Berners-Lee, le web 1.0 dans sa forme canonique classique. De nombreux sites et pages se référant les uns aux autres par des hyperliens. À première vue, une architecture simple, comme tout ce qui est génial : décentralisé et libre. Je veux — je navigue sur les sites des autres en suivant des hyperliens ; je veux — je crée mon propre site où je publie ce qui m'intéresse — par exemple mes articles, mes photos, des programmes, des hyperliens vers des sites qui m'intéressent. Et les autres mettent des liens vers moi.
Pourrait-on penser — une image idyllique ? Mais vous savez déjà comment tout cela a fini.
Le nombre de pages est devenu tellement élevé que la recherche d'informations est devenue une tâche assez peu triviale. Les hyperliens définis par les auteurs ne pouvaient tout simplement pas structurer ce volume d'informations immense. D'abord, des annuaires, remplis manuellement, sont apparus, puis d'énormes moteurs de recherche, qui ont commencé à utiliser des algorithmes heuristiques astucieux de classement. Les sites étaient créés et abandonnés, l'information était dupliquée et déformée. Internet se commercialisait rapidement et s'éloignait de plus en plus du réseau académique idéal. Le langage de balisage s'est rapidement transformé en langage de formatage. La publicité est arrivée, des bannières agaçantes et désagréables ainsi que des techniques de référencement et d'escroquerie de moteurs de recherche — le SEO. Le réseau était rapidement pollué par les déchets d'information. Les hyperliens ont cessé d'être un outil de liaison logique et se sont transformés en un outil de promotion. Les sites se fermaient, se renfermaient sur eux-mêmes, devenaient de « simples pages » ouvertes à des « applications » hermétiques, n'étant que des moyens de générer des revenus.
À l'époque, j'ai eu une certaine pensée que « quelque chose ne va pas ici ». Une multitude de sites différents, allant de pages d'accueil primitives avec un design criard à des « mégaportails » surchargés de bannières clignotantes. Même si les sites traitaient d'un même sujet, ils n'étaient pas du tout liés, chacun ayant son propre design, sa propre structure, des bannières ennuyeuses, un moteur de recherche mal fonctionnant, des problèmes de téléchargement (oui, je voulais avoir des informations hors ligne). À ce moment-là, Internet commençait déjà à se transformer en une sorte de télévision, où à un contenu utile était collée toute sorte de fioritures.
La décentralisation est devenue un cauchemar.
Que désire-t-on au juste ?
Paradoxalement, même alors, sans connaître ni le web 2.0 ni le p2p, je n'avais pas besoin de décentralisation en tant qu'utilisateur ! En repensant à mes réflexions non troublées de l'époque, je conclue que j'avais besoin de... une base de données unique! Une base de données dont les requêtes fourniraient tous les résultats, et non les plus pertinents selon un algorithme de classement. Une base de données où tous ces résultats seraient présentés de manière uniforme et stylisés par ma propre mise en forme unique, et non par les designs criards de nombreux Vasya Poupkine. Une base de données que je pourrais sauvegarder hors ligne sans craindre que le site disparaisse demain et que l'information soit perdue à jamais. Une base de données dans laquelle je pourrais entrer mes propres informations — par exemple, des commentaires et des balises. Une base de données dans laquelle je pourrais effectuer des recherches, des tris et des filtrages avec mes propres algorithmes.
Web 2.0 et les réseaux sociaux
Entre-temps, la conception du Web 2.0 est apparue. Formulée en 2005 par Tim O'Reilly, comme « une méthodologie de conception de systèmes qui, en prenant en compte les interactions réseau, s'améliorent à mesure que plus de personnes les utilisent » — et impliquant l'engagement actif des utilisateurs dans la création et l'édition collective du contenu du Web. Sans exagération, le sommet et le triomphe de ce concept ont été les réseaux sociaux. Des plateformes gigantesques, unissant des milliards d'utilisateurs et stockant des centaines de pétaoctets de données.
Que recevons-nous donc sur les réseaux sociaux ?
- unification de l'interface ; il s'est avéré que toutes les options de création de designs variés et voyants ne sont pas nécessaires pour les utilisateurs ; toutes les pages de tous les utilisateurs ont le même design et cela convient à tout le monde et même c'est pratique ; seul le contenu diffère.
- unification des fonctionnalités ; toute la diversité des scripts s'est également révélée inutile. « Fil », amis, albums… au fil du temps, le fonctionnement des réseaux sociaux s'est stabilisé et il est peu probable qu'il change : en effet, les fonctionnalités sont déterminées par les types d'activités des gens, et les gens ne changent pratiquement pas.
- base de données unique ; travailler avec une telle base de données s'est avéré beaucoup plus pratique que de gérer de nombreux sites disparates ; la recherche est devenue beaucoup plus simple. Au lieu de scanner en continu diverses pages faiblement liées, de tout mettre en cache, de classer selon des algorithmes heuristiques complexes — une simple requête unifiée à une base unique avec une structure connue.
- interface de feedback — likes et reposts ; sur le web traditionnel, Google ne pouvait obtenir aucun retour des utilisateurs après avoir cliqué sur un lien dans les résultats de recherche. Sur les réseaux sociaux, ce retour s'est révélé simple et naturel.
Qu'avons-nous perdu ? Nous avons perdu la décentralisation, et donc — la liberté. On considère maintenant que nos données ne nous appartiennent plus. Auparavant, nous pouvions héberger une page d'accueil sur notre propre ordinateur, mais maintenant, nous confions toutes nos données aux géants d'Internet.
De plus, à mesure que l'Internet se développait, il a attiré l'attention des gouvernements et des corporations, ce qui a engendré des problèmes de censure politique et de restrictions de copyright. Nos pages sur les réseaux sociaux peuvent être interdites et supprimées si le contenu ne correspond pas à certaines règles du réseau social ; un post imprudent peut entraîner des sanctions administratives et même pénales.
Et maintenant nous nous posons à nouveau la question : ne devrait-on pas récupérer la décentralisation ? Mais sous une autre forme, sans les défauts de la première tentative ?
réseaux peer-to-peer
Les premiers réseaux P2P sont apparus bien avant le Web 2.0 et se sont développés parallèlement à l'évolution du web. L'application classique principale des P2P est l'échange de fichiers ; les premiers réseaux ont été développés pour échanger de la musique. Les premiers réseaux (comme Napster) étaient essentiellement centralisés, ce qui a conduit à leur fermeture rapide par les titulaires de droits. Les successeurs ont opté pour la décentralisation. En 2000, les protocoles ED2K (premier client eDonkey) et Gnutella ont vu le jour, suivis en 2001 par le protocole FastTrack (client KaZaA). Graduellement, le degré de décentralisation a augmenté, les technologies se sont améliorées. Les systèmes avec « files d'attente de téléchargement » ont été remplacés par des torrents, et la notion de tables de hachage distribuées (DHT) a été introduite. Avec le renforcement des mesures gouvernementales, l'anonymat des participants est devenu de plus en plus important. Depuis 2000, le développement du réseau Freenet est en cours, et depuis 2003, celui d'I2P, tandis que le projet RetroShare a été lancé en 2006. On peut mentionner de nombreux réseaux P2P, tant ceux qui ont existé auparavant et ont disparu que ceux qui sont actifs aujourd'hui : WASTE, MUTE, TurtleF2F, RShare, PerfectDark, ARES, Gnutella2, GNUNet, IPFS, ZeroNet, Tribbler et bien d'autres. Il y en a beaucoup. Ils sont différents. Très différents — tant en termes de but que de structure… Il est probable que beaucoup d'entre vous ne soient même pas familiers avec tous ces noms. Et ce n'est pas tout.
Cependant, les réseaux P2P présentent de nombreux inconvénients. En plus des défauts techniques spécifiques à chaque implémentation de protocole et de client, on peut noter un inconvénient assez général : la difficulté de recherche (c’est-à-dire tout ce avec quoi Web 1.0 était confronté, mais dans une version encore plus complexe). Il n'y a pas de Google avec sa recherche omniprésente et instantanée. Et si pour les réseaux d'échange de fichiers, il est encore possible d'utiliser la recherche par nom de fichier ou par métadonnées, trouver quelque chose dans des réseaux superposés comme onion ou I2P est assez compliqué, voire impossible.
En général, si l'on fait des analogies avec Internet classique, la plupart des réseaux décentralisés sont restés quelque part au niveau FTP. Imaginez un internet qui ne contient rien d'autre que FTP : pas de sites modernes, pas de Web 2.0, pas de YouTube... C'est à peu près dans cet état que se trouvent les réseaux décentralisés. Et malgré quelques tentatives de changement, il y a encore peu d'évolutions.
Contenu
Retournons à un autre élément important de ce puzzle : le contenu. Le contenu est le principal problème de toute ressource Internet, et surtout d’une ressource décentralisée. D'où le prendre ? Bien sûr, on peut compter sur un groupe d'enthousiastes (comme cela se passe avec les réseaux P2P existants), mais dans ce cas, l'évolution du réseau sera assez longue et il y aura peu de contenu.
Travailler avec Internet traditionnel, c'est chercher et étudier du contenu. Parfois, c'est conserver (si le contenu est intéressant et utile, beaucoup, surtout ceux qui sont venus sur le réseau à l'époque du modem commuté - y compris moi - conservent judicieusement ce contenu hors ligne, pour ne pas le perdre ; car Internet est une chose hors de notre contrôle, un site peut exister aujourd'hui et disparaître demain, une vidéo sur YouTube peut être supprimée le lendemain, etc.
Et pour les torrents (que nous percevons plutôt comme un simple moyen de livraison que comme un réseau P2P), la sauvegarde est généralement impliquée. D'ailleurs, c'est l'un des problèmes des torrents : un fichier téléchargé une fois est difficile à déplacer vers un endroit où il est plus pratique de l'utiliser (généralement, il faut regénérer manuellement le partage) et il est complètement impossible de renommer (on peut faire un lien dur, mais presque personne ne sait vraiment comment faire cela).
En général, beaucoup de gens conservent le contenu d'une manière ou d'une autre. Quel est son avenir ? En général, les fichiers sauvegardés se retrouvent quelque part sur le disque, dans un dossier comme Téléchargements, dans un fouillis général, et y restent avec des milliers d'autres fichiers. C'est mauvais — et c'est surtout mauvais pour l'utilisateur lui-même. Si Internet a des moteurs de recherche, l'ordinateur local de l'utilisateur n'a rien de semblable. Heureusement, si l'utilisateur est organisé et a l'habitude de trier les fichiers téléchargés dans les « entrants ». Mais ce n'est pas le cas de tout le monde...
En réalité, il y a même pas mal de gens qui ne sauvegardent rien et comptent entièrement sur l'en ligne. Mais dans les réseaux P2P, il est supposé que le contenu est stocké localement sur l'appareil de l'utilisateur et partagé avec d'autres participants. Existe-t-il une solution qui pourrait impliquer les deux catégories d'utilisateurs dans un réseau décentralisé, sans changer leurs habitudes, et mieux encore - leur faciliter la vie ?
L'idée est assez simple : que diriez-vous de créer un moyen pratique et transparent pour l'utilisateur de sauvegarder du contenu sur Internet, en faisant une sauvegarde intelligente — avec des métadonnées sémantiques, et non pas dans un fouillis, mais dans une structure définie avec la possibilité de re-structuration, tout en distribuant le contenu sauvegardé dans un réseau décentralisé ?
Commençons par la sauvegarde
Nous ne considérerons pas l'utilisation utilitaire d'Internet pour consulter les prévisions météorologiques ou les horaires de vol. Nous sommes plus intéressés par des objets auto-suffisants et plus ou moins immuables — des articles (allant des tweets/ publications sur les réseaux sociaux aux longs articles comme ceux-ci sur Habré), des livres, des images, des programmes, des enregistrements audio et vidéo. D'où provient principalement l'information ? Généralement, cela
- réseaux sociaux (diverses nouvelles, petites notes — « tweets », images, audio et vidéo)
- articles sur des ressources thématiques (comme Habré) ; il n'y a pas beaucoup de bonnes ressources, généralement ces ressources sont également construites selon le principe des réseaux sociaux
- sites d'actualités
En général, il y a des fonctionnalités standard : « j'aime », « republier », « partager sur les réseaux sociaux », etc.
Imaginons un plugin de navigateur, qui sauvegarderait spécifiquement tout ce sur quoi nous avons cliqué « j'aime », fait un repost, enregistré dans « favori » (ou appuyé sur un bouton spécial du plugin, affiché dans le menu du navigateur — au cas où le site n'aurait pas la fonction « j'aime »/« repost »/« ajouter aux favoris »). L'idée principale est que vous aimez simplement — comme vous l'avez fait un million de fois auparavant, et le système sauvegarde l'article, l'image ou la vidéo dans un stockage hors ligne et cet article ou image devient accessible — aussi bien pour vous en mode hors ligne via l'interface d'un client décentralisé que dans le réseau décentralisé lui-même ! Pour moi, c'est très pratique. Pas d'actions superflues, et nous résolvons immédiatement de nombreuses tâches :
- sauvegarder du contenu précieux qui pourrait être perdu ou supprimé
- remplissage rapide du réseau décentralisé
- agrégation de contenu provenant de différentes sources (vous pouvez être inscrit sur des dizaines de ressources Internet, et tous les j'aime/reposts s'accumuleront dans une base locale unique)
- structuration du contenu qui vous intéresse par vos règles
Il est évident que l'extension de navigateur doit être adaptée à la structure de chaque site (c'est tout à fait réalisable — il existe déjà des extensions pour enregistrer du contenu depuis Youtube, Twitter, VK, etc.). Il n’y a pas tant de sites pour lesquels il vaut la peine de créer des extensions personnalisées. En règle générale, ce sont des réseaux sociaux courants (il doit y en avoir à peine une dizaine) et un certain nombre de sites thématiques de haute qualité comme Habr (il n’y en a pas beaucoup non plus). Avec un code ouvert et une spécification, le développement d'une nouvelle extension à partir d'un modèle ne devrait pas prendre beaucoup de temps. Pour les autres sites, on peut utiliser un bouton de sauvegarde universel, qui sauvegarderait la page entière au format mhtml — peut-être après avoir supprimé la publicité de la page.
Maintenant, sur la structuration
Par « sauvegarde intelligente », j'entends au minimum la sauvegarde avec des métadonnées : la source de contenu (URL), un ensemble de likes, de tags, de commentaires précédemment publiés, leurs identifiants, etc. Car lors d'une sauvegarde classique, ces informations sont perdues... Par source, on peut comprendre non seulement l'URL directe, mais aussi la composante sémantique : par exemple, un groupe sur un réseau social ou un utilisateur ayant partagé un post. L'extension peut être suffisamment intelligente pour utiliser ces informations pour une structuration et un étiquetage automatiques. De plus, il convient de comprendre que l'utilisateur lui-même peut toujours ajouter certaines métadonnées au contenu sauvegardé, pour cela, il faut prévoir des moyens d'interface aussi pratiques que possible (j'ai beaucoup d'idées à ce sujet).
Ainsi, la question de la structuration et de l'organisation des fichiers locaux de l'utilisateur est résolue. C'est déjà un avantage prêt à l'emploi, dont on peut tirer parti même sans p2p. C'est simplement une base hors ligne, qui sait quoi, d'où et dans quel contexte nous avons sauvegardé, et qui permet de réaliser de petites recherches. Par exemple, trouver des utilisateurs d'un réseau social externe qui ont aimé le plus de posts semblables aux vôtres. Beaucoup de réseaux sociaux le permettent-ils de manière explicite ?
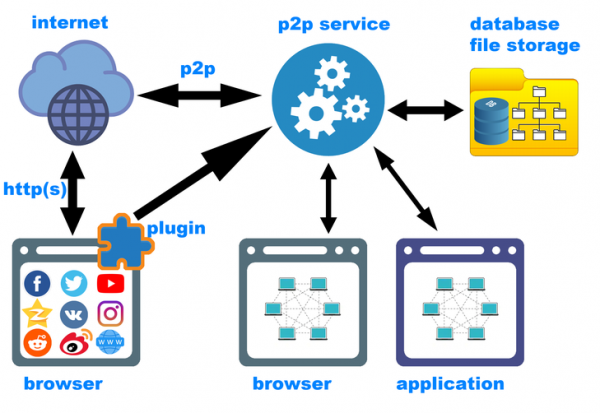
Il convient déjà de mentionner qu'un seul plugin de navigateur est évidemment insuffisant. Le deuxième composant essentiel du système est un service de réseau décentralisé fonctionnant en arrière-plan, qui gère à la fois le réseau p2p (les demandes du réseau et les demandes du client) et l'enregistrement de nouveau contenu via le plugin. Le service, en collaborant avec le plugin, placera le contenu au bon endroit, calculera les hachages (et pourra éventuellement déterminer que ce contenu a déjà été enregistré auparavant), et ajoutera les métadonnées nécessaires à la base de données locale.
Ce qui est intéressant, c'est que le système serait utile déjà sous cette forme, sans aucun p2p. Beaucoup de gens utilisent des clipper web pour ajouter du contenu intéressant du web, par exemple dans Evernote. L'architecture proposée est une version étendue de ce type de clipper.
Et enfin, l'échange p2p
Le plus agréable, c'est que les informations et les métadonnées (à la fois capturées du web et les miennes) peuvent être échangées. Le concept de réseau social se transpose parfaitement à l'architecture p2p. On peut dire que les réseaux sociaux et le p2p sont faits l'un pour l'autre. Tout réseau décentralisé doit idéalement être construit comme un réseau social, c'est seulement alors que cela fonctionnera efficacement. Les « Amis », les « Groupes » — ce sont les mêmes pairs, qui doivent avoir des liens solides, et ceux-ci proviennent d'une source naturelle : des intérêts communs des utilisateurs.
Les principes de conservation et de partage de contenu dans un réseau décentralisé sont entièrement identiques aux principes de conservation (capture) du contenu depuis l'Internet traditionnel. Si vous utilisez un contenu du réseau (et donc, vous l'avez enregistré), alors n'importe qui peut utiliser vos ressources (disque et canal) nécessaires pour obtenir ce contenu précis.
J'aime est l'outil le plus simple pour conserver et partager. Si j'aime — peu importe, sur Internet ou à l'intérieur du réseau décentralisé — cela signifie que j'apprécie le contenu, et donc je suis prêt à le conserver localement et à le partager avec d'autres participants du réseau décentralisé.
- Le contenu ne sera pas « perdu » ; il est maintenant enregistré chez moi localement, je pourrai y revenir plus tard, à tout moment, sans m'inquiéter que quelqu'un le supprime ou le bloque.
- Je peux (immédiatement ou plus tard) le catégoriser, le taguer, y ajouter des commentaires, l'associer à d'autres contenus, en gros, lui donner un sens — appelons cela « formation de métainformation ».
- Je peux partager cette métainformation avec d'autres membres du réseau.
- Je peux synchroniser ma métainformation avec celle des autres membres.
Il semble logique de renoncer aux « dislikes » : si je n'aime pas le contenu, il est raisonnable de ne pas vouloir utiliser mon espace de stockage pour le conserver et ma bande passante pour le distribuer. Pourquoi les dislikes s'intègrent-ils si mal dans la décentralisation ? (bien que parfois cela soit quand même utile) ).
Parfois, il faut conserver aussi ce que « je n'aime pas ». Il y a ce mot « nécessaire » :)
«Favoris» (ou « Merveilleux ») — je n'exprime pas d'opinion sur le contenu, mais je le conserve dans ma base de données locale de favoris. Le mot « favori » (favorites) ne correspond pas tout à fait au sens (pour cela, il y a les likes et leur catégorisation ultérieure), tandis que « favoris » (bookmarks) correspond parfaitement. Le contenu dans les « favoris » est également distribué — s'il vous « faut » (c'est-à-dire que vous l'« utilisez » d'une manière ou d'une autre), il est logique qu'il puisse également intéresser quelqu'un d'autre. Pourquoi ne pas utiliser vos ressources pour cela ?
La fonction «amis« est assez évidente. Ce sont des pairs, des personnes ayant des intérêts similaires, et donc celles qui sont susceptibles d'avoir du contenu intéressant. Dans un réseau décentralisé, cela signifie d'abord s'abonner au fil d'actualités de mes amis et d'accéder à leurs catalogues (albums) contenant leur contenu enregistré.
De même, la fonction «groupes» — ce sont des fils collectifs, ou des forums, ou quelque chose de ce genre, auxquels on peut également s'abonner — et donc recevoir tout le matériel du groupe et le redistribuer. Peut-être que les « groupes », comme les grands forums, devraient être hiérarchiques — cela permettrait de mieux structurer le contenu des groupes et de limiter le flux d'informations pour ne pas recevoir/ne pas distribuer ce qui ne vous intéresse pas vraiment.
Tout le reste
Il convient de noter que l'architecture décentralisée est toujours plus complexe que celle qui est centralisée. Dans les ressources centralisées, il existe une dictature stricte du code serveur. Dans les décentralisées, il est nécessaire de se mettre d'accord entre de nombreux participants égaux. Évidemment, cela nécessite de la cryptographie, des blockchains et d'autres avancées principalement développées pour les cryptomonnaies.
Je suppose qu'il pourrait être nécessaire d'établir certains classements de confiance cryptographiques mutuels, formés par les participants du réseau les uns pour les autres. L'architecture doit permettre de lutter efficacement contre les botnets qui, existant dans un certain cloud, peuvent par exemple manipuler mutuellement leurs notes. J'espère sincèrement que les corporations et les fermes de botnets, malgré leur supériorité technologique, ne prendront pas le contrôle d'un tel réseau décentralisé ; que sa principale ressource sera composée de personnes réelles capables de produire et de structurer du contenu intéressant et utile pour d'autres personnes réelles.
Il est également souhaitable qu'un tel réseau pousse la civilisation vers le progrès. À ce sujet, j'ai tout un tas d'idées qui, cependant, ne rentrent pas dans le cadre de cet article. Je dirai simplement qu'un certain type de contenu scientifique, technique, médical, etc., devrait avoir un avantage par rapport au contenu de divertissement, ce qui nécessitera une certaine modération. La modération d'un réseau décentralisé n'est pas une tâche triviale, mais elle est réalisable (bien que le mot « modération » soit ici complètement inapproprié et ne reflète pas du tout la nature du processus - ni extérieurement, ni intérieurement… et je n'ai même pas trouvé comment l'appeler).
Il serait peut-être superflu de mentionner la nécessité d'assurer l'anonymat - tant par des moyens intégrés (comme dans i2p ou Retroshare), que par le passage de tout le trafic par TOR. VPN.
Enfin, parlons de l'architecture logicielle (schématiquement représentée sur l'image de l'article). Comme mentionné précédemment, le premier composant du système est un plugin pour le navigateur qui capture le contenu avec des métadonnées. Le deuxième composant essentiel est un service p2p fonctionnant en arrière-plan (« backend »). Le fonctionnement du réseau ne devrait évidemment pas dépendre de l'état du navigateur. Le troisième composant est le logiciel client — le frontend. Cela peut être un service web local (dans ce cas, l'utilisateur pourra travailler avec le réseau décentralisé sans quitter son navigateur préféré), ou une application GUI distincte pour un système d'exploitation spécifique (Windows, Linux, MacOS, Android, iOS, etc.). J'aime l'idée de faire coexister toutes les options de frontend. Cela obligera également à une architecture de backend plus rigoureuse.
Il existe encore de nombreux aspects qui ne sont pas abordés dans cet article. La connexion aux partages d'entrepôts existants (c'est-à-dire lorsque vous avez déjà quelques téraoctets téléchargés, et vous permettez au client de les scanner, d'obtenir des hachages, de les comparer avec ceux présents dans le réseau et de rejoindre le partage, tout en récupérant des métadonnées sur vos propres fichiers depuis le réseau — noms normaux, descriptions, évaluations, avis, etc.), la connexion à des sources de métadonnées externes (comme les bases Libgen), l'utilisation optionnelle de l'espace de stockage pour le contenu chiffré d'autrui (comme dans Freenet), l'architecture d'intégration avec les réseaux décentralisés existants (c'est tout un sac de nœuds), l'idée de media-hachage (utilisation de hachages perceptifs spéciaux pour le contenu média — images, audio et vidéo, permettant de faire correspondre des fichiers multimédia ayant le même sens mais des tailles et résolutions différentes), et bien d'autres choses.
Résumé de l'article
1. Dans les réseaux décentralisés, il n'y a pas de Google avec son moteur de recherche et son classement — mais il y a une communauté de personnes réelles. Un réseau social avec ses mécanismes de retour d'information (mentions J'aime, partages, etc.) et son graphe social (amis, communautés, etc.) constitue un modèle idéal de niveau applicatif pour un réseau décentralisé.
2. L'idée principale que j'apporte avec cet article est la sauvegarde automatique de contenus intéressants depuis le Web traditionnel lors d'un like/partage ; cela peut être utile même sans p2p, simplement pour tenir un archive personnelle d'informations intéressantes.
3. Ce contenu peut également remplir automatiquement un réseau décentralisé.
4. Le principe de sauvegarde automatique de contenu intéressant fonctionne aussi avec des likes/partages au sein du réseau décentralisé lui-même.
Source : habr.com
