

Le 26 février, nous avons organisé une rencontre sur Apache Ignite GreenSource, avec la participation de contributeurs du projet open source. . Un événement marquant dans la vie de cette communauté a été la restructuration du composant , qui permet de déployer des microservices personnalisés directement dans le cluster Ignite. Ce processus complexe a été expliqué lors de la rencontre par , ingénieur logiciel et contributeur d'Apache Ignite depuis plus de deux ans.
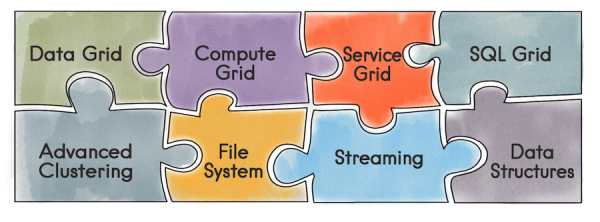
Commençons par définir ce qu'est réellement Apache Ignite. C'est une base de données qui constitue un stockage distribué Key/Value avec prise en charge de SQL, de la transactionnalité et de la mise en cache. De plus, Ignite permet de déployer des services personnalisés directement dans le cluster Ignite. Les développeurs ont accès à tous les outils offerts par Ignite : structures de données réparties, Messaging, Streaming, Compute et Data Grid. Par exemple, en utilisant Data Grid, on évite les problèmes d'administration d'une infrastructure séparée pour le stockage de données, et par conséquent, les frais généraux qui en découlent.
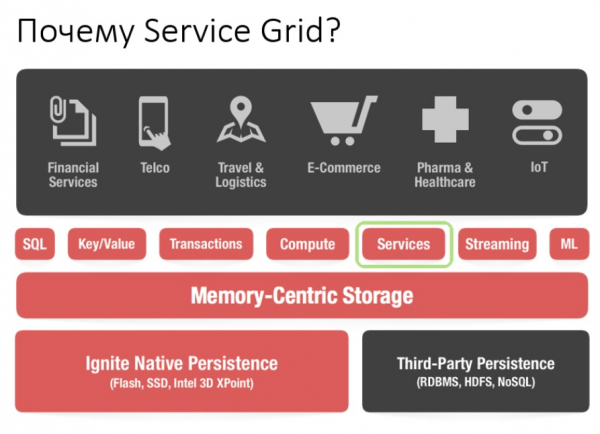
En utilisant l'API Service Grid, il est possible de déployer un service en spécifiant simplement, dans la configuration, le schéma de déploiement et, en conséquence, le service lui-même.
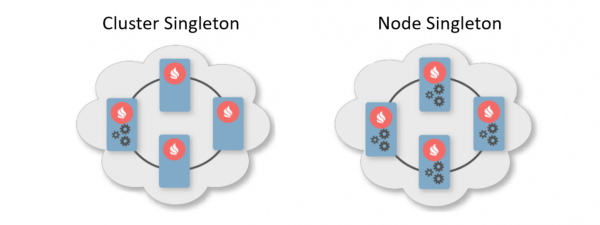
En général, le schéma de déploiement indique le nombre d'instances qui doivent être déployées sur les nœuds du cluster. Il existe deux schémas de déploiement typiques. Le premier est le Cluster Singleton : à tout moment, un seul exemplaire du service personnalisé sera garanti dans le cluster. Le second est le Node Singleton : une instance du service est déployée sur chaque nœud du cluster.
L'utilisateur peut également spécifier le nombre d'instances du service dans tout le cluster et définir un prédicat pour filtrer les nœuds appropriés. Dans ce scénario, Service Grid calculera lui-même la répartition optimale pour le déploiement des services.
De plus, il existe une fonctionnalité appelée Affinity Service. L'Affinity est une fonction qui définit la relation entre les clés et les partitions, ainsi que la relation entre les partitions et les nœuds dans la topologie. Par la clé, il est possible de déterminer le nœud principal sur lequel les données sont stockées. Ainsi, vous pouvez associer votre propre service à une clé et au cache de la fonction d'affinité. En cas de modification de la fonction d'affinité, un redéploiement automatique aura lieu. Ainsi, le service sera toujours situé à proximité des données auxquelles il doit accéder, réduisant ainsi les frais d'accès à l'information. Ce schéma peut être considéré comme une sorte de calcul collocatif.
Maintenant que nous avons exploré les avantages de Service Grid, parlons de son histoire de développement.
Ce qui était avant
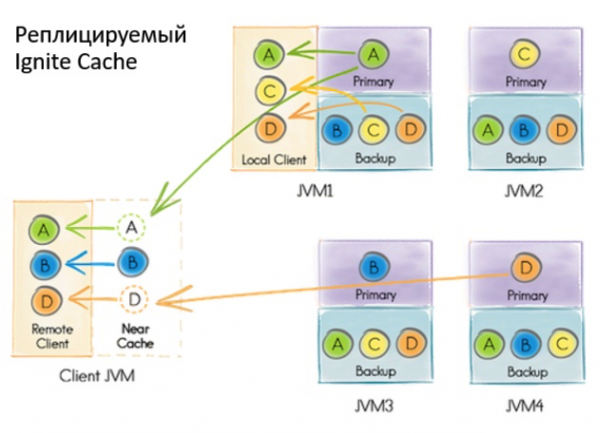
La version précédente de Service Grid était basée sur un cache système répliqué transactionnel Ignite. Dans Ignite, par le terme « cache », on entend un stockage. Ce n'est donc pas quelque chose de temporaire, comme on pourrait le penser. Bien que le cache soit répliqué et que chaque nœud contienne l'ensemble des données, à l'intérieur, le cache présente une vision partitionnée. Cela est lié à l'optimisation des stockages.
Que se passait-il lorsque l'utilisateur voulait déployer un service ?
- Tous les nœuds dans le cluster s'inscrivaient aux mises à jour des données dans le stockage via le mécanisme intégré de Query Continue.
- Le nœud initiateur effectuait une écriture dans la base de données sous une transaction read-committed, qui contenait la configuration du service, y compris une instance sérialisée.
- Lors de la réception d'une notification concernant un nouvel enregistrement, le coordinateur calculait la distribution basée sur la configuration. L'objet obtenu était réécrit dans la base.
- Si un nœud faisait partie de la distribution, le coordinateur devait le déployer.
Ce qui ne nous convenait pas
À un moment donné, nous avons conclu qu'il n'était pas possible de travailler ainsi avec les services. Plusieurs raisons ont conduit à cette conclusion.
Si une erreur se produisait lors du déploiement, on ne pouvait l'apprendre que par les journaux du nœud où cela s'est produit. Il n'y avait qu'un déploiement asynchrone, donc après avoir redonné le contrôle à l'utilisateur à partir de la méthode de déploiement, il fallait un certain temps supplémentaire pour démarrer le service — et pendant ce temps, l'utilisateur ne pouvait rien gérer. Pour continuer à développer Service Grid, ajouter de nouvelles fonctionnalités, attirer de nouveaux utilisateurs et faciliter la vie de tous, il fallait changer quelque chose.
Lors de la conception de la nouvelle Service Grid, notre première priorité était de garantir un déploiement synchrone : dès que l'utilisateur a récupéré le contrôle de l'API, il peut immédiatement utiliser les services. Nous souhaitions également donner à l'initiateur la possibilité de gérer les erreurs de déploiement.
De plus, nous voulions faciliter la mise en œuvre, notamment en éliminant les transactions et le rééquilibrage. Bien que le cache soit répliqué et qu'il n'y ait pas de rééquilibrage, des problèmes surviennent lors de déploiements massifs avec de nombreux nœuds. Lorsqu'il y a des changements de topologie, les nœuds doivent échanger des informations, et pendant un grand déploiement, ces données peuvent prendre beaucoup de place.
Lorsque la topologie était instable, le coordonnateur devait recalculer la répartition des services. En général, lorsque l'on doit travailler avec des transactions sur une topologie instable, cela peut entraîner des erreurs difficiles à prévoir.
Problèmes
Quelles globales transformations sans problèmes associés ? Le premier d'entre eux était le changement de topologie. Il faut comprendre qu’à tout moment, même lors du déploiement d’un service, un nœud peut entrer ou sortir du cluster. De plus, si un nœud entre dans le cluster pendant le déploiement, il faudra transmettre de manière cohérente toutes les informations concernant les services au nouveau nœud. Et il ne s'agit pas seulement de ce qui a déjà été déployé, mais aussi des déploiements actuels et futurs.
C'est juste un des problèmes que l'on peut rassembler dans une liste séparée :
- Comment déployer des services statiquement configurés lors du démarrage du nœud ?
- Sortie d'un nœud du cluster – que faire si le nœud hébergeait des services ?
- Que faire si le coordonnateur a changé ?
- Que faire si le client se reconnecte au cluster ?
- Faut-il traiter les demandes d'activation/désactivation et comment ?
- Et que faire si une destruction du cache a été appelée alors que nous avons des services avec affinité liés à lui ?
Et ce n'est pas tout.
Solution
Nous avons choisi d'adopter une approche Event Driven, avec la mise en œuvre de la communication des processus via des messages. Ignite dispose déjà de deux composants qui permettent aux nœuds d'échanger des messages entre eux : communication-spi et discovery-spi.
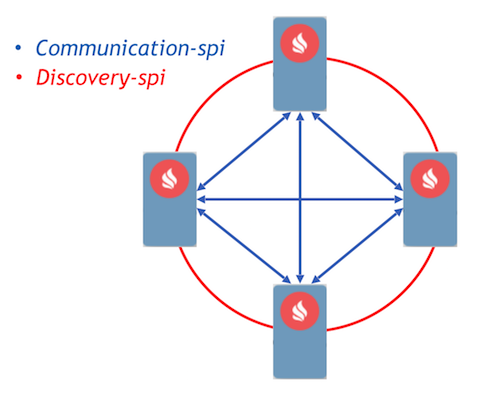
Communication-spi permet aux nœuds de communiquer directement et d'envoyer des messages. Il convient bien pour le transfert de grandes quantités de données. Discovery-spi permet d'envoyer un message à tous les nœuds du cluster. Dans l'implémentation standard, cela se fait selon la topologie "anneau". Il existe également une intégration avec Zookeeper, auquel cas la topologie utilisée est "étoile". Il est également important de noter que discovery-spi garantit que le message sera précisément livré dans le bon ordre à tous les nœuds.
Considérons le protocole de déploiement. Toutes les demandes d'utilisateur pour déployer et désaffecter sont envoyées via discovery-spi. Cela offre les garanties:
- La demande sera reçue par tous les nœuds du cluster. Cela permettra de continuer à traiter la demande en cas de changement de coordinateur. Cela signifie également qu'avec un seul message, chaque nœud recevra toutes les métadonnées nécessaires, telles que la configuration du service et son instance sérialisée.
- L'ordre strict de livraison des messages permet de résoudre les conflits de configuration et les demandes concurrentes.
- Puisque l'entrée d'un nœud dans la topologie est également traitée par discovery-spi, le nouveau nœud recevra toutes les données nécessaires pour travailler avec les services.
Lors de la réception d'une demande, les nœuds du cluster la valident et forment des tâches à traiter. Ces tâches sont empilées dans une queue et ensuite traitées dans un autre thread par un worker séparé. Cela est réalisé ainsi car le déploiement peut prendre un temps considérable et retarder la précieuse flux de discovery est inacceptable.
Toutes les demandes de la queue sont traitées par le gestionnaire de déploiement. Il possède un worker spécial qui extrait une tâche de cette queue et l'initialise pour commencer le déploiement. Après cela, les actions suivantes se produisent :
- Chaque nœud calcule de manière autonome la distribution grâce à une nouvelle fonction d’assignation déterministe.
- Les nœuds forment un message avec les résultats du déploiement et l'envoient au coordinateur.
- Le coordinateur agrège tous les messages et forme le résultat de l'ensemble du processus de déploiement, qui est envoyé via discovery-spi à tous les nœuds du cluster.
- Lors de la réception du résultat, le processus de déploiement se termine, après quoi la tâche est supprimée de la queue.
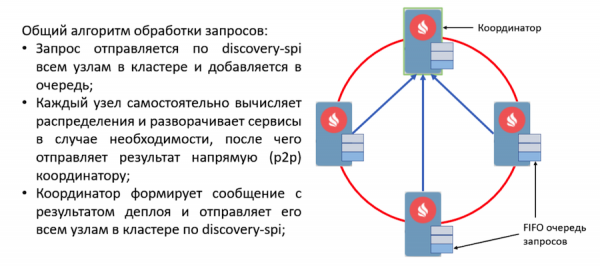
Nouveau design basé sur les événements : org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Si une erreur se produit lors du déploiement, le nœud inclut immédiatement cette erreur dans le message qu'il envoie au coordinateur. Après l'agrégation des messages, le coordinateur disposera d'informations sur toutes les erreurs survenues pendant le déploiement et transmettra ce message via discovery-spi. Les informations sur les erreurs seront accessibles depuis n'importe quel nœud du cluster.
Tous les événements importants dans le Service Grid sont traités selon cet algorithme de fonctionnement. Par exemple, un changement de topologie est également un message via discovery-spi. En général, si l'on compare à ce qu'il y avait auparavant, le protocole s'est révélé assez léger et fiable. Suffisamment pour traiter n'importe quelle situation pendant le déploiement.
Que va-t-il se passer ensuite
Parlons maintenant des projets. Toute amélioration majeure dans le projet Ignite est réalisée sous la forme d'une initiative d'amélioration d'Ignite, appelée IEP. Le redesign du Service Grid a également un IEP - avec un nom humoristique « Changement d'huile dans le Service Grid ». Mais en fait, nous n'avons pas changé l'huile dans le moteur, mais le moteur entier.
Nous avons divisé les tâches dans l'IEP en 2 phases. La première est une grande phase qui consiste à retravailler le protocole de déploiement. Elle est déjà intégrée dans la branche principale, vous pouvez essayer le nouveau Service Grid qui apparaîtra dans la version 2.8. La deuxième phase comprend de nombreuses autres tâches :
- Redéploiement à chaud
- Versionnage des services
- Augmentation de la résilience
- Client léger
- Outils de surveillance et de comptage de diverses métriques
Enfin, nous vous recommandons Service Grid pour la construction de systèmes hautement disponibles et tolérants aux pannes. Nous vous invitons également à nous rejoindre sur et pour partager votre expérience. Votre expérience est vraiment importante pour la communauté, elle aidera à comprendre quelle direction prendre et comment développer le composant à l'avenir.
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish