

In-Memory — un ensemble de concepts de stockage de données où celles-ci sont conservées dans la mémoire vive de l'application, tandis que le disque est utilisé pour la sauvegarde. Dans les approches classiques, les données sont stockées sur le disque, et la mémoire sert de cache. Par exemple, une application web avec un backend pour le traitement des données sollicite ces dernières dans le stockage : elle les obtient, les transforme, et transmet de grandes quantités de données sur le réseau. Avec In-Memory, les calculs sont envoyés aux données — dans le stockage, où elles sont traitées, et le réseau est moins sollicité.

Quelles autres possibilités In-Memory offre-t-il et de quoi s'agit-il, nous le dira Vladimir Pligin — ingénieur chez GridGain. Ce matériel d'exposé sera utile aux développeurs de backend d'applications web qui n'ont pas travaillé avec In-Memory et souhaitent essayer, ou qui s'intéressent aux tendances modernes du développement de solutions logicielles et à la conception d'architectures.
Remarque. Cet article est basé sur la transcription de la conférence de Vladimir lors de la #GetIT Conf. Avant l'instauration du confinement, nous organisions régulièrement des meetups et des conférences pour les développeurs à Moscou et à Saint-Pétersbourg : nous discutions des tendances, des questions d'actualité dans le développement, des problèmes et de leurs solutions. Maintenant que les conférences ne peuvent pas avoir lieu, c'est le moment idéal pour partager des documents utiles des précédents événements.
Qui utilise In-Memory et comment
In-Memory est le plus souvent utilisé là où une interaction rapide avec l'utilisateur ou le traitement de grandes quantités de données est nécessaire.
- Les banques utilisent In-Memory, par exemple, pour réduire les délais lors de l'utilisation des applications par les clients ou pour analyser le profil client avant de délivrer un crédit.
- La fintech utilise In-Memory pour améliorer la performance des services et applications bancaires, qui externalisent le traitement et l'analyse de données.
- Les compagnies d'assurance: pour évaluer les risques, par exemple en analysant les données du client sur plusieurs années.
- Entreprises de logistique. Elles traitent de nombreuses données, par exemple pour calculer les itinéraires optimaux pour le transport de marchandises et de passagers en tenant compte de milliers de paramètres, et suivre le statut des expéditions.
- Retail. Les solutions In-Memory aident à servir les clients plus rapidement et à traiter de grands volumes d'informations : expéditions, factures, transactions, disponibilité de milliers de produits en stock, préparation de rapports analytiques.
- Dans IoT In-Memory remplace les bases de données traditionnelles.
- Les entreprises pharmaceutiques utilisent In-Memory, par exemple, pour explorer les combinaisons de compositions de médicaments.
Je vais vous donner quelques exemples de la manière dont nos clients utilisent les solutions In-Memory et comment vous pouvez les intégrer chez vous.
In-Memory comme stockage principal
L'un de nos clients est un important fournisseur d'équipements scientifiques médicaux basé aux États-Unis. Ils utilisent la solution In-Memory comme stockage principal de données. Toutes les données sont stockées sur disque, et un sous-ensemble de données qui sont fréquemment utilisées est maintenu en mémoire vive. Les méthodes d'accès au stockage sont standards — GDBC (Generic Database Connector) et le langage de requêtes SQL.
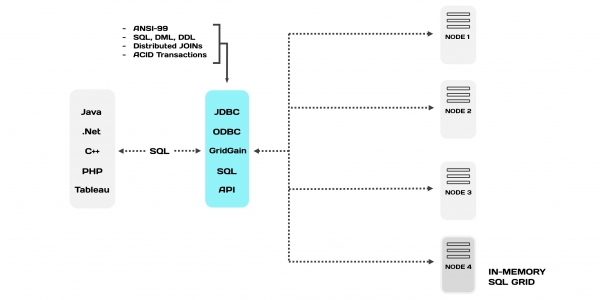
Ensemble, cela s'appelle In-Memory Database (IMDB) ou Memory-Centric Storage. Cette catégorie de solutions a plusieurs noms, ce ne sont pas les seuls.
Caractéristiques de l'IMDB :
- Les données stockées en In-Memory et accessibles via SQL sont les mêmes que dans d'autres approches. Elles sont synchronisées, seule la manière de les représenter et d'y accéder diffère. L'intégrité transactionnelle prévaut entre les données.
- L'IMDB est plus rapide que les bases de données relationnelles, car il est plus rapide d'extraire des informations de la mémoire vive que du disque.
- Les algorithmes d'optimisation internes nécessitent moins d'instructions.
- L'IMDB est adapté à la gestion des données, des événements et des transactions dans les applications.
L'IMDB prend partiellement en charge l'ACID : atomicité, cohérence et isolation. Mais il ne prend pas en charge la « durabilité » — en cas de coupure de courant, toutes les données sont perdues. Pour résoudre ce problème, il est possible d'utiliser des snapshots — un « instantané » de la base de données, semblable à un backup sur disque dur, ou d'enregistrer les transactions (journaux), pour récupérer les données après un redémarrage.
Pour créer des applications résilientes
Imaginons l'architecture classique d'une application web tolérante aux pannes. Elle fonctionne de la manière suivante : toutes les requêtes sont réparties par le répartiteur de charge entre les serveurs. Ce système est résilient car les serveurs se dupliquent et se soutiennent lors des incidents.
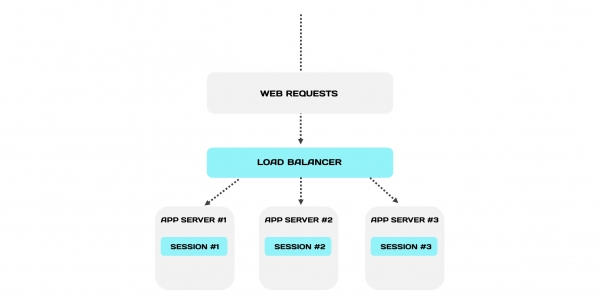
Le répartiteur dirige toutes les requêtes d'une session vers un seul serveur. C'est le mécanisme des sessions collantes : chaque session est liée à serveur, où elle est stockée et traitée localement.
Que se passera-t-il si l'un des serveurs?
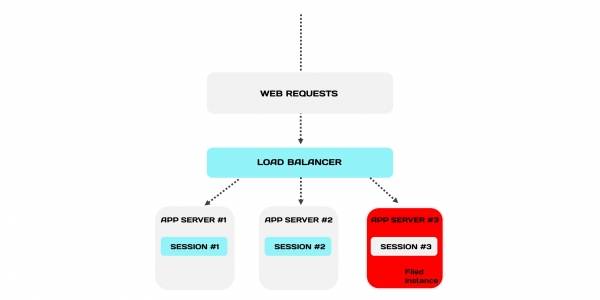
Serveur tombe en panne, le service ne sera pas affecté car l'architecture est redondante. Mais nous perdrons un sous-ensemble de sessions du serveur défaillant. Et par conséquent, les utilisateurs qui sont liés à ces sessions. Par exemple, un client passe une commande et est soudainement déconnecté de son compte. Il ne sera pas satisfait de devoir se reconnecter et de découvrir qu'il doit tout recommencer.
L'application web doit être capable de gérer un grand nombre d'utilisateurs sans "ralentir" pour qu'ils puissent travailler confortablement. Mais en cas de panne, à chaque nouvelle requête, le temps de communication avec le stockage des sessions va augmenter. Cela augmente la latence moyenne pour les autres utilisateurs. Mais ils ne veulent pas attendre plus longtemps qu'ils ne le font déjà.
Ce problème peut être résolu, comme pour un autre de nos clients - un grand fournisseur PASS des États-Unis. Il utilise In-Memory pour clusteriser les sessions web. Pour cela, il les stocke non localement, mais de manière centralisée - dans un cluster In-Memory. Dans ce cas, les sessions sont accessibles beaucoup plus rapidement, car elles sont déjà en mémoire vive.
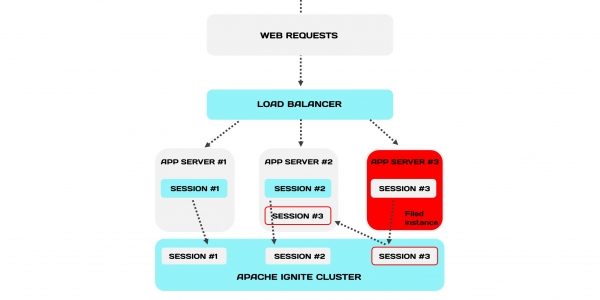
Lorsque le serveur tombe, le répartiteur envoie les requêtes du serveur défaillant vers d'autres serveurs, comme dans l'architecture classique. Mais il y a une différence importante : les sessions sont stockées dans un cluster In-Memory et les serveurs ont accès aux sessions du serveur défaillant.
Cette architecture augmente la résilience de l'ensemble du système. De plus, il est même possible de se passer de la mécanique des sessions collantes.
Traitement hybride transactionnel-analytique (HTAP)
En général, les systèmes transactionnels et analytiques sont séparés. Lorsqu'ils sont dissociés, la base de données principale subit une charge. Pour le traitement analytique, les données sont copiées dans une réplique, afin que l'analyse ne perturbe pas les processus transactionnels. Cependant, la copie se fait avec un décalage - sans ce décalage, la réplication est impossible. Si nous le faisons de manière synchrone, cela ralentira également la base principale et nous n'en retirerons aucun bénéfice.
Avec HTAP, tout fonctionne différemment : le même stockage de données est utilisé pour la charge transactionnelle des applications et pour les requêtes analytiques, qui peuvent prendre du temps. Lorsque les données résident en mémoire vive, les requêtes analytiques s'exécutent plus rapidement, et le serveur de base de données est moins chargé (en moyenne).
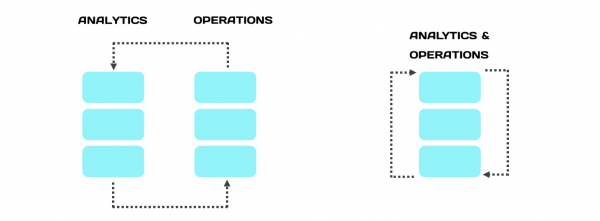
L'approche hybride « brise le mur » entre le traitement des transactions et l'analyse. Si nous effectuons des analyses sur le même stockage, les requêtes analytiques s'exécutent sur les données en mémoire. Elles sont beaucoup plus précises, mieux interprétables et plus adéquates.
Intégration des solutions In-Memory
Une manière relativement simple consiste à développer tout depuis zéro.Nous gardons les données sur disque, tandis que les données actives sont stockées en mémoire. Cela aide à survivre aux redémarrages des serveurs ou aux pannes.
Deux scénarios principaux s'appliquent lorsque les données sont stockées sur disque. Dans le premier, nous souhaitons survivre aux pannes ou aux redémarrages planifiés du cluster ou de ses parties - nous souhaitons utiliser cela comme une base de données simple. Dans le second scénario, lorsque les données sont trop nombreuses, une partie d'entre elles est stockée en mémoire.
Si nous n'avons pas la possibilité de tout construire depuis zéro, nous pouvons intégrer In-Memory dans une architecture existante.Cependant, toutes les solutions In-Memory ne conviennent pas à cela. Il y a trois conditions indispensables. La solution In-Memory doit soutenir :
- un moyen standard de connexion à la base qui se trouvera en dessous (par exemple, MySQL);
- un langage de requête standard, pour ne pas avoir à réécrire et à modifier la logique d'interaction avec le stockage;
- la transactionnalité - maintenir la sémantique de l'interaction.
Si ces trois conditions sont remplies, l'intégration est possible. Nous plaçons un In-Memory Data Grid entre l'application et la base. Maintenant, les requêtes d'écriture seront déléguées à la base sous-jacente, tandis que les requêtes de lecture iront vers la base, si les données ne sont pas présentes dans le cache.
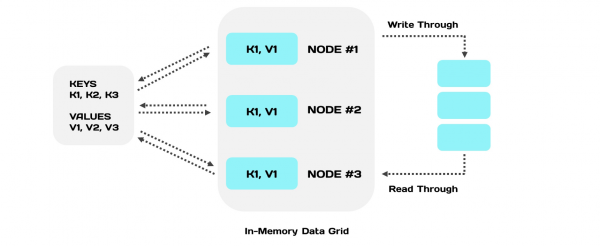
Si l'accès rapide aux données et leur traitement sont importants pour vous, par exemple pour l'analyse commerciale, vous pouvez envisager l'implémentation de l'In-Memory. Pour sa réalisation, vous pouvez utiliser les deux méthodes lors de la conception d'une nouvelle architecture.
Source : habr.com
