

Le développement industriel des systèmes logiciels nécessite une attention particulière à la résilience du produit final, ainsi qu'une réactivité rapide en cas de pannes et d'incidents, s'ils surviennent néanmoins. La surveillance aide, bien sûr, à réagir aux pannes et aux défauts de manière plus efficace et rapide, mais ce n'est pas suffisant. Tout d'abord, il est très difficile de suivre un grand nombre de serveurs — un grand nombre de personnes est nécessaire. Deuxièmement, il faut bien comprendre comment l'application est structurée pour prévoir son état. Par conséquent, il faut beaucoup de personnes qui comprennent bien les systèmes que nous développons, leurs indicateurs et leurs particularités. Supposons que, même si l'on trouve un nombre suffisant de personnes désireuses de s'en occuper, il faudra encore beaucoup de temps pour les former.
Que faire alors ? Ici, l'intelligence artificielle vient à notre secours. Cet article parlera de (predictive maintenance). Cette approche gagne en popularité. Un grand nombre d'articles ont été écrits à ce sujet, y compris sur Habr. De grandes entreprises utilisent cette méthode pour maintenir la fonctionnalité de leurs serveurs. Après avoir étudié de nombreux articles, nous avons décidé d'essayer d'appliquer cette approche. Quels ont été les résultats ?
Introduction
Un système logiciel développé est, tôt ou tard, mis en exploitation. Il est important pour l'utilisateur que le système fonctionne sans interruptions. Si une situation exceptionnelle se produit, elle doit être résolue avec un minimum de délais.
Pour simplifier le support technique du système logiciel, surtout lorsqu'il y a de nombreux serveurs, on utilise généralement des programmes de surveillance qui collectent des métriques du système logiciel en fonctionnement, permettant de diagnostiquer son état et aidant à déterminer ce qui a causé la panne. Ce processus est appelé surveillance du système logiciel.
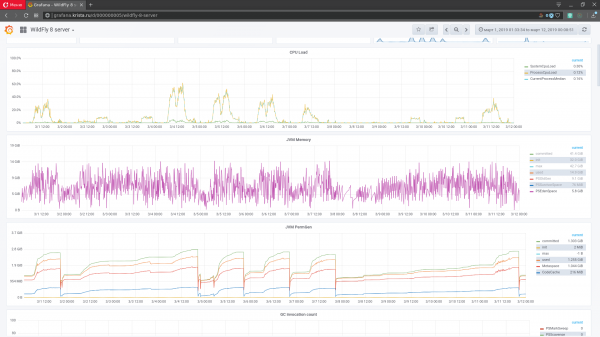
Figure 1. Interface de surveillance Grafana
Les métriques sont divers indicateurs d'un système logiciel, de son environnement d'exécution ou de la machine de calcul physique sur laquelle le système fonctionne, avec un horodatage du moment où les métriques ont été obtenues. Dans l'analyse statique, les données métriques sont appelées séries temporelles. Pour observer l'état du système logiciel, les métriques sont affichées sous forme de graphiques : sur l'axe X, le temps, et sur l'axe Y, les valeurs (figure 1). Un système logiciel opérationnel peut enregistrer plusieurs milliers de métriques (de chaque nœud). Celles-ci forment un espace de métriques (séries temporelles multidimensionnelles).
Étant donné qu'un grand nombre de métriques sont collectées à partir de systèmes logiciels complexes, la surveillance manuelle devient une tâche difficile. Pour réduire le volume des données analysées par l'administrateur, les outils de surveillance contiennent des mécanismes pour détecter automatiquement les problèmes potentiels. Par exemple, il est possible de configurer un déclencheur qui s'active lorsque l'espace disque libre chute en dessous d'un certain seuil. Il est également possible de diagnostiquer automatiquement l'arrêt d'un serveur ou un ralentissement critique de la vitesse de service. En pratique, les outils de surveillance réussissent raisonnablement bien à détecter les défaillances déjà survenues ou à identifier des symptômes simples de défaillances futures, mais globalement, la prévision d'une défaillance possible reste un défi. La prévision par une analyse manuelle des métriques nécessite l'intervention de spécialistes qualifiés, ce qui n'est pas très productif. La plupart des défaillances potentielles peuvent passer inaperçues.
Récemment, parmi les grandes entreprises IT développant des logiciels, ce qu'on appelle la maintenance prédictive des systèmes logiciels gagne en popularité. L'essence de cette approche réside dans la détection des problèmes menant à la dégradation du système à un stade précoce, avant sa défaillance, à l'aide de l'intelligence artificielle. Cette approche n'élimine pas complètement la surveillance manuelle du système. Elle est complémentaire au processus de surveillance dans son ensemble.
L'outil principal de la mise en œuvre de la maintenance prédictive est la tâche de détection des anomalies dans les séries temporelles, car lorsqu'une anomalie se produit dans les données, il y a de fortes chances qu'après un certain temps une défaillance ou un échec surviendra. Une anomalie est une certaine déviation des indicateurs d'un système logiciel, comme la détection d'une dégradation de la vitesse d'exécution d'un type de requête ou une diminution du nombre moyen de demandes traitées tout en maintenant un niveau constant de sessions clients.
La tâche de recherche d'anomalies dans les systèmes logiciels a ses propres spécificités. En théorie, pour chaque système logiciel, il est nécessaire de développer ou d'adapter les méthodes existantes, car la recherche d'anomalies dépend fortement des données dans lesquelles elle est effectuée, et les données des systèmes logiciels varient énormément en fonction des outils de mise en œuvre du système, jusqu'à la machine de calcul sur laquelle il est exécuté.
Méthodes de détection d'anomalies dans la prévision des défaillances des systèmes logiciels
Tout d'abord, il convient de mentionner que l'idée de prévoir les défaillances a été inspirée par l'article . Pour vérifier l'efficacité de l'approche de détection automatique d'anomalies, le système logiciel « Web-Consolidation » a été choisi, qui est l'un des projets de l'entreprise NPO « Krista ». Auparavant, il était soumis à une surveillance manuelle basée sur les métriques obtenues. Étant donné que le système est assez complexe, un grand nombre de métriques en sont extraites : indicateurs de la JVM (charge du ramasse-miettes), indicateurs du système d'exploitation sous lequel le code s'exécute (mémoire virtuelle, % de charge du CPU), indicateurs de réseau (charge réseau), du serveur lui-même (charge CPU, mémoire), métriques wildfly et métriques propres de l'application sur tous les sous-systèmes critiques.
Toutes les métriques sont extraites du système à l'aide de graphite. Initialement, une base whisper était utilisée comme solution standard pour grafana, mais avec la croissance de la base client, graphite a cessé de faire face, épuisant la capacité de la sous-solution de stockage du DC. Après cela, il a été décidé de rechercher une solution plus efficace. Le choix s'est porté sur , ce qui a permis de réduire l нагрузку sur la sous-solution de stockage d'un ordre de grandeur et de diminuer cinq à six fois l'espace disque occupé. Ci-dessous est présentée le schéma du mécanisme de collecte des métriques utilisant graphite+clickhouse (figure 2).
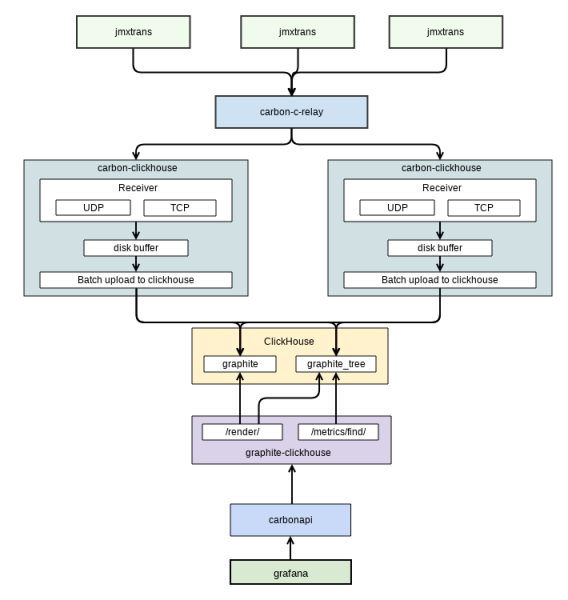
Figure 2. Schéma de collecte des métriques
Le schéma est extrait de la documentation interne. Il illustre l'échange de données entre Grafana (l'interface utilisateur de surveillance que nous utilisons) et Graphite. La collecte des métriques de l'application est effectuée par un logiciel distinct – . Ce dernier les stocke dans Graphite.
Le système « Web-Consolidation » présente plusieurs particularités qui posent des problèmes pour la prévision des pannes :
- il y a souvent un changement de tendance. Différentes versions de ce système logiciel sont publiées. Chacune d'elles entraîne des modifications dans la partie logicielle du système. Par conséquent, les développeurs influencent directement les métriques de ce système et peuvent provoquer un changement de tendance ;
- la particularité de l'implémentation, ainsi que les objectifs d'utilisation par les clients de ce système, déclenchent souvent des anomalies sans dégradation préalable ;
- le pourcentage d'anomalies par rapport à l'ensemble des données est faible (< 5%) ;
- il peut y avoir des interruptions dans la collecte des indicateurs de système. Pendant de courtes périodes, le système de surveillance ne parvient pas à obtenir des métriques. Par exemple, si le serveur est surchargé. Pour l'apprentissage du réseau neuronal, c'est critique. Il est donc nécessaire de remplir les lacunes de manière synthétique ;
- Les cas d'anomalies sont généralement pertinents uniquement pour un nombre/mois/temps spécifique (saisonnalité). Ce système a un règlement strict d'utilisation par ses utilisateurs. En conséquence, les métriques ne sont pertinentes que pour un moment précis. Le système peut ne pas être utilisé de manière constante, mais uniquement durant certains mois : sélectivement en fonction de l'année. Il y a des situations où le même comportement des métriques dans un cas peut entraîner la défaillance du système logiciel, tandis que dans un autre, cela ne le fait pas.
Pour commencer, les méthodes de détection d'anomalies dans les données de surveillance des systèmes logiciels ont été analysées. Dans la documentation sur ce sujet, lorsque le pourcentage d'anomalies par rapport à l'ensemble des données est faible, il est souvent recommandé d'utiliser des réseaux neuronaux.
La logique principale de recherche d'anomalies à l'aide de données de réseaux neuronaux est illustrée dans la figure 3 :
Figure 3. Recherche d'anomalies à l'aide d'un réseau neuronal
Le résultat de la prévision ou de la récupération d'une fenêtre de flux de métriques est calculé par rapport à celui obtenu à partir d'un système logiciel en fonctionnement. En cas de grande différence entre les métriques obtenues du système logiciel et celles du réseau de neurones, on peut conclure à l'anomalie de la tranche de données actuelle. Cela soulève un certain nombre de problèmes pour l'utilisation des réseaux de neurones :
- Pour un fonctionnement correct en mode streaming, les données d'apprentissage des modèles de réseaux de neurones ne doivent inclure que des données « normales » ;
- Il est nécessaire d'avoir un modèle à jour pour une détection correcte. Un changement de tendance et de saisonnalité dans les métriques peut provoquer de nombreux faux positifs dans le modèle. Pour sa mise à jour, il faut clairement définir le moment où le modèle est obsolète. Si le modèle est mis à jour trop tard ou trop tôt, il est probable qu'il en résulte un grand nombre de faux positifs.
Il ne faut pas non plus oublier de rechercher et de prévenir la survenue fréquente de faux positifs. On suppose qu'ils se produiront le plus souvent dans des situations anormales. Cependant, ils peuvent également être le résultat d'une erreur du réseau de neurones en raison d'un apprentissage insuffisant. Il est nécessaire de minimiser le nombre de faux positifs du modèle. Sinon, de fausses prévisions prendront beaucoup de temps pour l'administrateur, qui est censé vérifier le système. Tôt ou tard, cela conduira simplement à ce que l'administrateur cesse de réagir à un système de surveillance « paranoïaque ».
Réseau de neurones récurrent
Pour la détection d'anomalies dans les séries temporelles, on peut appliquer avec des cellules de mémoire LSTM. Le problème est que cela ne peut être utilisé que pour des séries temporelles prédictibles. Dans notre cas, toutes les métriques ne sont pas prédictibles. Une tentative d'appliquer un RNN LSTM à une série temporelle est présentée sur la figure 4.
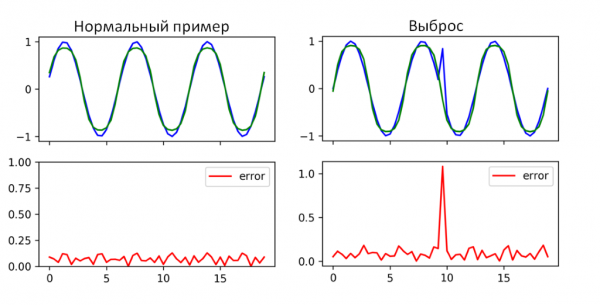
Figure 4. Exemple de fonctionnement d'un réseau de neurones récurrent avec des cellules de mémoire LSTM
Comme on peut le voir sur la figure 4, le RNN LSTM a réussi à détecter une anomalie pendant cette période. Là où le résultat présente une forte erreur de prévision (erreur moyenne), il y a effectivement eu une anomalie dans les indicateurs. L'utilisation d'un seul RNN LSTM sera clairement insuffisante, car il n'est applicable qu'à un petit nombre de métriques. On peut l'utiliser comme méthode auxiliaire pour la détection d'anomalies.
Autoencodeur pour la prévision des pannes
– il s'agit en fait d'un réseau de neurones artificiel. La couche d'entrée est l'encodeur, la couche de sortie est le décodeur. Le principal inconvénient de tous les réseaux neuronaux de ce type est qu'ils localisent mal les anomalies. L'architecture de l'autoencodeur synchrone a été choisie.
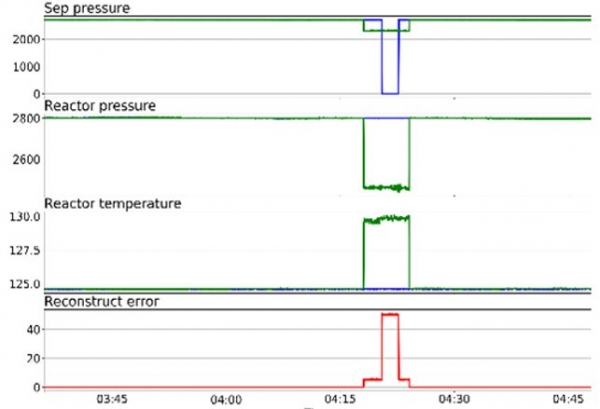
Figure 5. Exemple de fonctionnement de l'autoencodeur
Les autoencodeurs sont entraînés sur des données normales et détectent ensuite quelque chose d'anormal dans les données présentées au modèle. C'est exactement ce qu'il faut pour cette tâche. Il reste seulement à choisir quel autoencodeur conviendra à cette problématique. La forme architecturalement la plus simple d'un autoencodeur est un réseau de neurones direct et non récurrent, très similaire à (multilayer perceptron, MLP), avec un niveau d'entrée, un niveau de sortie et une ou plusieurs couches cachées les reliant.
Cependant, les différences entre les autoencodeurs et les MLP résident dans le fait que dans l'autoencodeur, le niveau de sortie a le même nombre de nœuds que l'entrée, et que plutôt que d'apprendre à prédire une valeur cible Y, donnée par l'entrée X, l'autoencodeur apprend à reconstruire ses propres X. C'est pourquoi les autoencodeurs sont des modèles d'apprentissage non supervisés.
La tâche de l'autoencodeur consiste à trouver les indices temporels r0 … rn correspondant aux éléments anormaux dans le vecteur d'entrée X. Cet effet est obtenu grâce à la recherche de l'erreur quadratique.
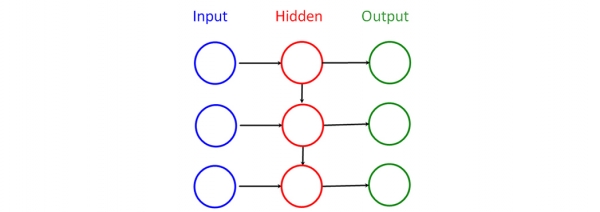
Figure 6. Autoencodeur synchrone
Une architecture . Ses avantages : la possibilité d'utiliser un mode de traitement en flux et un nombre relativement réduit de paramètres du réseau de neurones par rapport à d'autres architectures.
Mécanisme de minimisation des fausses alertes
Étant donné que diverses situations imprévues peuvent survenir, ainsi que des lacunes potentielles dans l'entraînement du réseau neuronal, il a été décidé pour le modèle de détection des anomalies en cours de développement de créer un mécanisme pour minimiser les faux positifs. Ce mécanisme est basé sur une base de modèles classifiée par un administrateur.
(L'algorithme DTW, abréviation de dynamic time warping) permet de trouver une correspondance optimale entre des séquences temporelles. Il a été utilisé pour la première fois en reconnaissance vocale : utilisé pour déterminer comment deux signaux vocaux représentent la même phrase prononcée. Son utilisation a ensuite été étendue à d'autres domaines.
Le principe fondamental de minimisation des faux positifs repose sur la collecte d'une base d'étalons par un opérateur qui classe les cas suspects identifiés par les réseaux neuronaux. Par la suite, l'étalon classifié est comparé au cas détecté par le système, permettant de déterminer si le cas est un faux positif ou une situation entraînant une défaillance. C'est précisément pour la comparaison de deux séries temporelles que l'algorithme DTW est utilisé. L'outil principal de minimisation reste la classification. Il est supposé qu'après la collecte d'un grand nombre de cas d'étalons, le système devra moins interroger l'opérateur en raison de la similarité de la plupart des cas et de l'émergence de cas similaires.
Ainsi, sur la base des méthodes de réseaux neuronaux décrites ci-dessus, un programme expérimental a été créé pour prédire les pannes du système « Web-Consolidation ». L'objectif de ce programme était, en utilisant l'archive existante des données de surveillance et les informations concernant les pannes survenues, d'évaluer l'efficacité de cette approche pour nos systèmes logiciels. Le schéma de fonctionnement du programme est présenté ci-dessous, dans la figure 7.
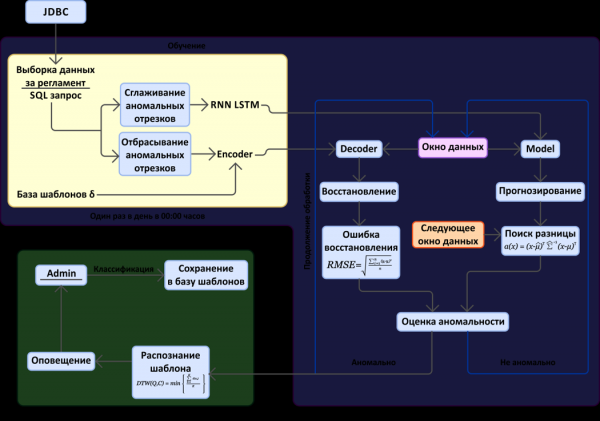
Figure 7. Schéma de prédiction des pannes basé sur l'analyse de l'espace des métriques
Dans le schéma, deux blocs principaux peuvent être identifiés : la recherche de segments de temps anormaux dans le flux de données de surveillance (métriques) et le mécanisme de minimisation des faux positifs. Remarque : à des fins expérimentales, les données sont obtenues via une connexion JDBC à la base de données dans laquelle elles sont sauvegardées par graphite.
Ci-dessous se trouve l'interface résultante du système de surveillance développé (figure 8).
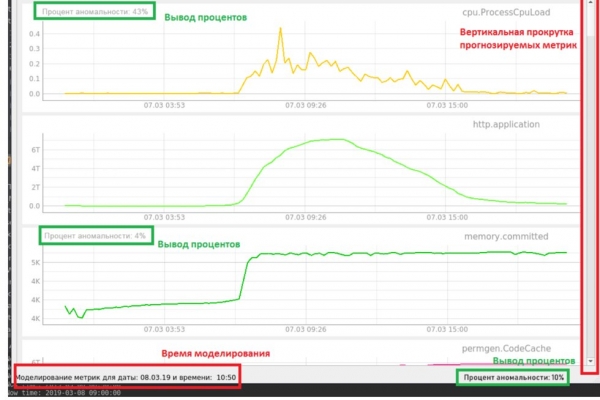
Figure 8. Interface du système de surveillance expérimental
L'interface affiche le pourcentage d'anomalie basé sur les métriques reçues. Dans notre cas, la réception est simulée. Nous disposons déjà de toutes les données de plusieurs semaines et les chargeons progressivement pour vérifier le cas d'anomalie conduisant à une panne. Dans la barre d'état inférieure, le pourcentage total d'anomalie des données est affiché à un moment donné, déterminé grâce à un auto-encodeur. Pour les métriques prévues, un pourcentage distinct est également affiché, calculé par un RNN LSTM.
Exemple de détection d'anomalie des indicateurs CPU à l'aide d'un réseau de neurones RNN LSTM (figure 9).
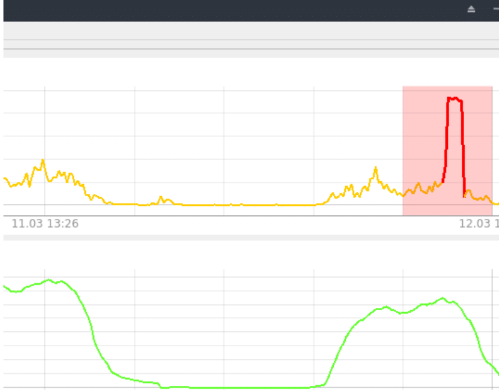
Figure 9. Détection par RNN LSTM
Un cas plutôt simple, en fait une simple anomalie, mais qui conduit à une panne du système, a été correctement détecté par le RNN LSTM. Le pourcentage d'anomalie à ce moment donné est de 85 à 95%, tout ce qui est au-dessus de 80% (seuil défini expérimentalement) est considéré comme une anomalie.
Exemple de détection d'anomalie lorsque le système n'a pas pu démarrer après une mise à jour. Cette situation est détectée par l'auto-encodeur (figure 10).
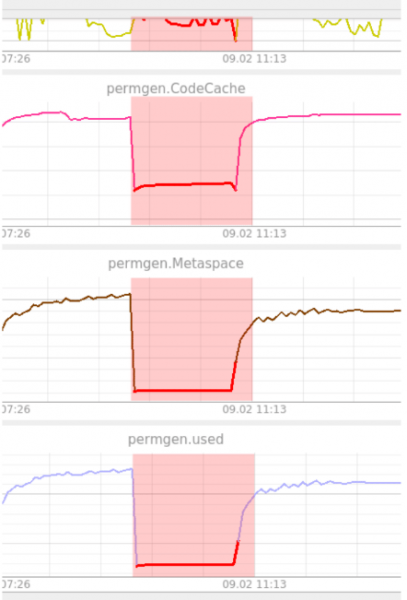
Figure 10. Exemple de détection par l'auto-encodeur
Comme on peut le voir sur la figure, PermGen est resté à un niveau constant. L'auto-encodeur a jugé cela étrange car il n'avait jamais rien vu de tel auparavant. Ici, l'anomalie est maintenue à 100% jusqu'au retour du système à un état fonctionnel. L'anomalie est affichée dans toutes les métriques. Comme mentionné précédemment, l'auto-encodeur ne peut pas localiser les anomalies. L'opérateur est censé remplir cette fonction dans ces situations.
Conclusion
Le PC « Web-Considération » est en cours de développement depuis plusieurs années. Le système est dans un état suffisamment stable et le nombre d'incidents enregistrés est faible. Cependant, il a été possible de repérer des anomalies conduisant à des pannes 5 à 10 minutes avant qu'elles ne se produisent. Dans certains cas, des alertes sur des pannes à l'avance auraient permis d'économiser le temps alloué pour effectuer des travaux de 'réparation'.
Les expériences réalisées jusqu'à présent ne permettent pas encore de tirer des conclusions définitives. Pour l’instant, les résultats sont contradictoires. D'une part, il est clair que les algorithmes basés sur des réseaux neuronaux peuvent identifier des anomalies « utiles ». D'autre part, un pourcentage élevé de fausses alertes subsiste, et toutes les anomalies détectées par un spécialiste qualifié ne peuvent pas être identifiées par le réseau neuronal. Un inconvénient est que le réseau nécessite actuellement un apprentissage supervisé pour fonctionner correctement.
Pour le développement futur du système de prévision des pannes et son amélioration vers un état satisfaisant, plusieurs voies peuvent être envisagées. Cela inclut une analyse plus détaillée des cas d'anomalies menant à des pannes, en complétant la liste des métriques cruciales qui affectent l'état du système et en écartant celles qui n'ont pas d'impact. De plus, en suivant cette direction, on pourrait tenter de spécialiser les algorithmes spécifiquement pour nos cas d'anomalies entraînant des pannes. Une autre voie consiste à améliorer les architectures de réseaux neuronaux, augmentant ainsi la précision des détections tout en réduisant le temps d'apprentissage.
Je tiens à remercier mes collègues qui m'ont aidé à rédiger et à maintenir la pertinence de cet article : et Sergey Finogenov.
Source : habr.com
