

À ce jour, il existe des solutions prêtes à l'emploi (propriétaires) pour le suivi des flux IP(TS), par exemple et , elles offrent un ensemble de fonctionnalités assez riche et de telles solutions sont généralement disponibles chez les grands opérateurs œuvrant dans les services de télévision. Cet article décrit une solution basée sur le projet open source , destiné à un contrôle minimal des flux IP(TS) via le compteur de continuité (CC) et le débit binaire. Une application possible serait le contrôle de la perte de paquets ou de flux entier via un canal L2 loué (qui ne peut pas être surveillé normalement, par exemple en lisant les compteurs de perte dans les files d'attente).
À propos de TSDuck
TSDuck est un logiciel open source (licence 2-Clause BSD) qui consiste en un ensemble d'outils en ligne de commande et une bibliothèque pour développer ses propres utilitaires ou plugins, permettant de manipuler les flux TS. Il peut traiter des entrées IP (multicast/unicast), http, hls, tuners DVB, démodulateurs dektec dvb-asi, comprend un générateur interne de flux TS et la lecture à partir de fichiers. En sortie, il peut écrire dans un fichier, sur IP (multicast/unicast), hls, démodulateurs dektec dvb-asi et HiDes, ainsi que des lecteurs (mplayer, vlc, xine) et drop. Entre l'entrée et la sortie, divers processeurs de trafic peuvent être insérés, par exemple, le remappage des PID, le scrambling/déscrambling, l'analyse des compteurs CC, le comptage des débits binaires et d'autres opérations typiques pour les flux TS.
Dans cet article, les flux IP (multicast) seront utilisés en entrée, avec les processeurs bitrate_monitor (comme l'indique le nom) et continuity (analyse des compteurs CC). Il est possible de remplacer facilement l'IP multicast par un autre type d'entrée pris en charge par TSDuck.
Il existe officiels de TSDuck pour la plupart des systèmes d'exploitation actuels. Pour Debian, il n'en existe pas, mais nous avons pu le compiler sans problème sous debian 8 et debian 10.
Nous utiliserons la version TSDuck 3.19-1520, avec Linux comme système d'exploitation (pour la préparation de la solution, debian 10 a été utilisé, et pour l'utilisation réelle — CentOS 7).
Préparation de TSDuck et du système d'exploitation
Avant de surveiller les flux réels, il est nécessaire de s'assurer que TSDuck fonctionne correctement et qu'il n'y a pas de pertes au niveau de la carte réseau ou du système d'exploitation (socket). Cela est requis afin d'éviter de se poser des questions sur l'origine des pertes — étaient-elles dues au réseau ou « à l'intérieur du serveur ». On peut vérifier les pertes au niveau de la carte réseau avec la commande ethtool -S ethX, le réglage se fait avec le même ethtool (en général, il faut augmenter le buffer RX (-G) et parfois désactiver certains offloads (-K)). En règle générale, il est conseillé d'utiliser un port séparé pour recevoir le trafic analysé, si cela est possible, cela minimise les fausses alertes liées au fait que la perte s'est produite précisément sur le port de l'analyseur en raison de la présence d'un autre trafic. Si cette possibilité n'existe pas (si un mini-ordinateur/NUC avec un seul port est utilisé), il est très souhaitable de configurer une priorisation du trafic analysé par rapport au reste sur le dispositif auquel l'analyseur est connecté. En ce qui concerne les environnements virtuels, il faut être prudent et savoir détecter les pertes de paquets depuis le port physique jusqu'à l'application à l'intérieur de la machine virtuelle.
Génération et réception de flux à l'intérieur de l'hôte
Comme première étape de préparation de TSDuck, nous allons générer et recevoir du trafic à l'intérieur d'un même hôte en utilisant netns.
Préparation de l'environnement :
ip netns add P #création de netns P, où l'analyse de trafic aura lieu
ip link add type veth #création d'une paire veth - veth0 reste dans le netns par défaut (le trafic sera généré sur cette interface)
ip link set dev veth1 netns P #veth1 - placement dans netns P (le trafic sera reçu sur cette interface)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #activation de l'IP sur veth1, peu importe laquelle
ip netns exec P ip ro add default via 192.0.2.2 #configuration de la route par défaut à l'intérieur de netns P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #désactivation de l'IPv6 sur veth0 - ceci est fait pour éviter que des déchets externes ne tombent dans le compteur TX
ifconfig veth0 up #activation de l'interface veth0
ip route add 239.0.0.1 dev veth0 #création d'une route pour que le système d'exploitation dirige le trafic vers 239.0.0.1 via veth0
L'environnement est prêt. Lançons l'analyseur de trafic :
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
où « -p 1 -t 1 » signifie qu'il faut calculer le bitrate chaque seconde et afficher les informations sur le bitrate chaque seconde
Lançons le générateur de trafic à une vitesse de 10 Mbit/s :
tsp -I craft
 -P regulate -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
où «-p 7 -e» signifie que nous devons emballer 7 paquets TS dans 1 paquet IP et le faire de manière stricte (-e), c'est-à-dire toujours attendre 7 paquets TS du dernier processeur avant d'envoyer la formation du paquet IP.
L'analyseur commence à afficher les messages attendus :
* 2020/01/03 14:55:44 - bitrate_monitor : 2020/01/03 14:55:44, débit TS : 9 970 016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor : 2020/01/03 14:55:45, débit TS : 10 022 656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor : 2020/01/03 14:55:46, débit TS : 9 980 544 bits/s
Nous ajoutons maintenant un peu de pertes :
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPet apparaissent des messages de ce type :
* 2020/01/03 14:57:11 - continuity : index du paquet : 80,745, PID : 0x0000, 7 paquets manquants
* 2020/01/03 14:57:11 - continuity : index du paquet : 83,342, PID : 0x0000, 7 paquets manquants
ce qui est attendu. Nous désactivons la perte de paquets (ip netns exec P iptables -F) et essayons d'augmenter le débit du générateur à 100 Mbit/s. L'analyseur rapporte de nombreuses erreurs CC et environ 75 Mbit/s au lieu de 100. Nous essayons de comprendre qui est en faute — le générateur ne suit pas ou le problème vient d'ailleurs, pour cela nous lançons la génération d'un nombre fixe de paquets (700000 paquets TS = 100000 paquets IP) :
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Comme on peut le voir, exactement 100000 paquets IP ont été générés (151925460-151825460). Nous examinons donc ce qui se passe avec l'analyseur, en vérifiant le compteur RX sur veth1, il est strictement égal au compteur TX sur veth0, puis nous regardons ce qui se passe au niveau du socket :
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Ici, on voit le nombre de pertes = 24355. En paquets TS, cela représente 170485 ou 24,36 % des 700000, nous voyons donc que ces 25 % de perte de débit proviennent des pertes dans le socket UDP. Les pertes dans le socket UDP surviennent généralement en raison d'un manque de mémoire tampon, voyons quelle est la taille de la mémoire tampon du socket par défaut et la taille de mémoire tampon maximale du socket :
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Ainsi, si les applications ne demandent pas explicitement la taille de la mémoire tampon, les sockets sont créés avec une mémoire tampon de 208 Ko, mais si elles demandent plus, elles ne l'obtiennent pas. Puisque dans tsp pour l'entrée IP, nous pouvons définir la taille de la mémoire tampon (—buffer-size), nous ne toucherons pas la taille de la mémoire tampon par défaut du socket, mais définirons uniquement la taille de mémoire tampon maximale du socket et spécifierons la taille de la mémoire tampon explicitement via les arguments tsp :
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
Avec ce réglage de la mémoire tampon du socket, le débit rapporté est maintenant d'environ 100 Mbit/s, sans erreurs CC.
En ce qui concerne la consommation de CPU par l'application tsp, pour un cœur i5-4260U CPU @ 1.40GHz, l'analyse d'un flux de 10 Mbit/s nécessitera 3-4 % de CPU, 100 Mbit/s — 25 %, 200 Mbit/s — 46 %. Avec un certain pourcentage de perte de paquets, la charge du CPU n'augmente pratiquement pas (mais peut diminuer).
Sur du matériel plus performant, il était possible de générer et d'analyser sans problème des flux de plus de 1 Gb/s.
Test sur des cartes réseau réelles
Après les tests sur une paire veth, il faut prendre deux hôtes ou deux ports d'un même hôte, relier les ports entre eux, exécuter le générateur sur l'un et l'analyseur sur l'autre. Aucune surprise ne s'est produite ici, mais en réalité, tout dépend du matériel ; plus il est faible, plus la situation devient intéressante.
Utilisation des données obtenues par le système de surveillance (Zabbix)
Le tsp n'a pas de API machine-readable comme SNMP ou similaire. Les messages CC doivent être agrégés au moins par seconde (avec un taux élevé de perte de paquets, il peut y avoir des centaines, des milliers, voire des dizaines de milliers par seconde, selon le débit).
Ainsi, pour conserver les informations et dessiner des graphiques sur les erreurs CC et le débit, les options suivantes peuvent être envisagées :
- Parser et agréger (par CC) la sortie de tsp, c'est-à-dire la transformer au format requis.
- Améliorer le logiciel tsp et/ou les plugins processeurs bitrate_monitor et continuity, afin que le résultat soit fourni sous une forme machine-readable, adaptée pour le système de surveillance.
- Écrire votre propre application au-dessus de la bibliothèque tsduck.
Il est évident que du point de vue des efforts nécessaires, l'option 1 est la plus simple, surtout compte tenu du fait que le tsduck lui-même est écrit dans un langage bas niveau (selon les normes modernes) (C++).
Un prototype simple de parseur+agrégateur en bash a montré qu'avec un flux de 10 Mbit/s et 50 % de perte de paquets (le pire des scénarios), le processus bash consommait 3-4 fois plus de CPU que le processus tsp lui-même. Ce type de scénario n'est pas acceptable. Voici d'ailleurs une partie de ce prototype ci-dessous.
Pâtes à la sauce bash.
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
En plus de fonctionner de manière inadmissiblement lente, bash n'a pas de véritables threads, les jobs bash étant des processus autonomes, il a fallu enregistrer une fois par seconde la valeur missingPackets sur l'effet secondaire (lors de la réception des messages de débit, qui arrivent chaque seconde). Au final, bash a été laissé de côté et il a été décidé d'écrire une couche (parser + agrégateur) en golang. La consommation CPU d'un code équivalent en golang est de 4 à 5 fois inférieure à celle du processus tsp. L'accélération de la couche grâce à la substitution de bash par golang a obtenu un gain d'environ 16 fois et dans l'ensemble, le résultat est acceptable (surcharge CPU de 25% dans le pire des cas). Le fichier source en golang se trouve .
Lancement de la couche
Pour lancer la couche, un modèle de service très simple pour systemd a été créé (). Il est prévu que la couche elle-même soit compilée en un fichier binaire (go build tsduck-stat.go), placé dans /opt/tsduck-stat/. Il est supposé que golang avec support de l'horloge monotone (>=1.9) est utilisé.
Pour créer une instance de service, il faut exécuter la commande systemctl enable tsduck-stat@239.0.0.1:1234, puis la démarrer avec systemctl start tsduck-stat@239.0.0.1:1234.
Découverte depuis Zabbix
Afin que Zabbix puisse effectuer la découverte des services en cours d'exécution, un (discovery.sh) a été créé, dans le format requis pour la découverte Zabbix, il est présumé qu'il est placé là aussi — dans /opt/tsduck-stat. Pour exécuter la découverte via zabbix-agent, il faut ajouter dans le répertoire des configurations de zabbix-agent pour ajouter un paramètre utilisateur.
Modèle Zabbix
(tsduck_stat_template.xml) contient une règle d'auto-découverte, des prototypes d'éléments de données, de graphiques et de déclencheurs.
Liste de contrôle rapide (au cas où quelqu'un déciderait de l'utiliser)
- S'assurer que tsp ne perd pas de paquets dans des conditions « idéales » (le générateur et l'analyseur étant connectés directement), s'il y a des pertes, voir p.2 ou le texte de l'article à ce sujet.
- Faire un réglage du tampon maximal du socket (net.core.rmem_max=8388608).
- Compiler tsduck-stat.go (go build tsduck-stat.go).
- Placer le modèle de service dans /lib/systemd/system.
- Lancer les services avec systemctl, vérifier qu'ils commencent à apparaître dans les compteurs (grep « » /dev/shm/tsduck-stat/*). Le nombre de services est égal au nombre de flux multicast. Il peut être nécessaire de créer une route vers le groupe multicast, éventuellement de désactiver rp_filter ou de créer une route vers l'ip source.
- Lancer discovery.sh, s'assurer qu'il génère du json.
- Fournir la configuration de zabbix-agent, redémarrer zabbix-agent.
- Téléchargez le modèle dans Zabbix, appliquez-le à l'hôte sur lequel la surveillance est effectuée et où l'agent Zabbix est installé, attendez environ 5 minutes, puis vérifiez que de nouveaux éléments de données, graphiques et déclencheurs sont apparus.
Résultat
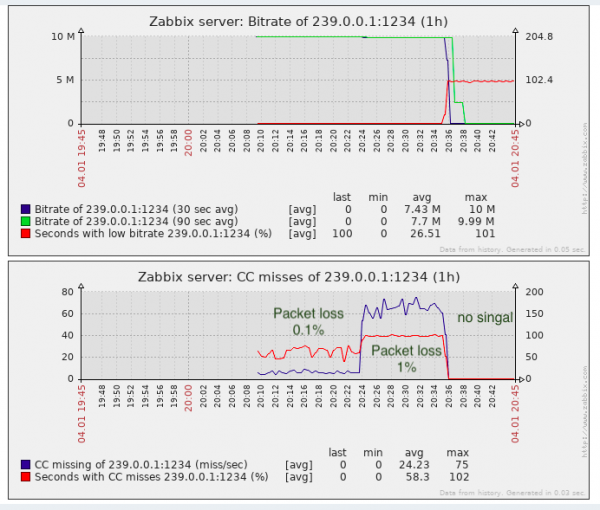
Pour la tâche de détection de perte de paquets, cela est presque suffisant, et c'est mieux que de ne pas avoir de surveillance.
En réalité, les CC de « pertes » peuvent se produire lors du montage de fragments vidéo (autant que je sache, c'est ainsi que les insertions sont réalisées dans les centres de télévision locaux en Russie, c'est-à-dire sans recalculer le compteur CC), il faut en tenir compte. Dans les solutions propriétaires, ce problème est partiellement contourné par la détection des étiquettes SCTE-35 (si elles sont ajoutées par le générateur de flux).
Du point de vue de la surveillance de la qualité du transport, il manque une surveillance du jitter (IAT), car l'équipement TV (qu'il s'agisse de modulateurs ou de dispositifs finaux) a des exigences pour ce paramètre et il n'est pas toujours possible de gonfler le jitbuffer indéfiniment. De plus, le jitter peut varier lorsque du matériel avec de grands buffers est utilisé en transit et que le QoS pour le transfert de ce type de trafic en temps réel n'est pas configuré ou pas suffisamment bien configuré.
Source : habr.com
