

Le contenu de cet article est tiré de ma .
Mécanisme de transfert de données
- Bloc de données dblk_t
- Message mblk_t
- Fonctions de traitement des messages mblk_t
- File d'attente queue_t
- Fonctions de gestion des files d'attente queue_t
- Connexion de filtres
- Point de signalisation du graphe de traitement de données
- Activité en coulisse du ticker
- Mise en mémoire tampon (MSBufferizer)
- Fonctions de gestion du MSBufferizer
Dans le passé, Nous avons développé notre propre filtre. Cet article sera consacré aux mécanismes internes de transfert de données entre les filtres du mediastreamer. Cela permettra d'écrire des filtres complexes avec moins d'efforts.
Mécanisme de transfert de données
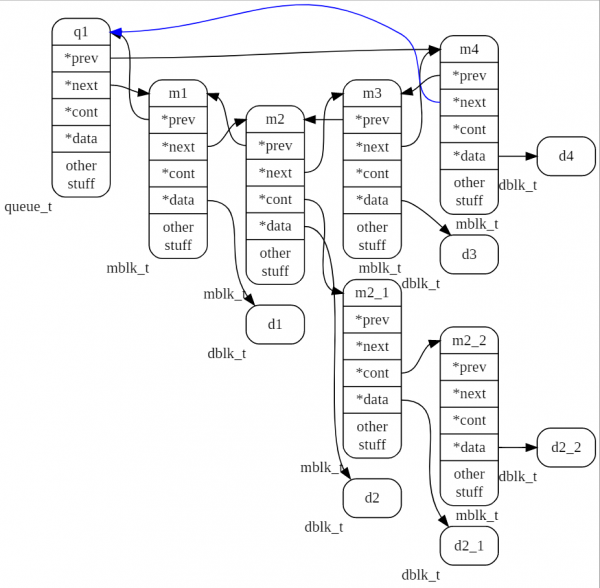
Le transfert de données dans le mediastreamer se fait à l'aide de files d'attente décrites par la structure queue_t. Les files d'attente transfèrent des chaînes de messages de type mblk_t, qui ne contiennent pas de données de signal en elles-mêmes, mais uniquement des références au message précédent, au message suivant et au bloc de données. De plus, il est crucial de souligner qu'il existe également un champ pour référencer un message du même type, ce qui permet d'organiser une liste chaînée de messages. Le groupe de messages ainsi réunis sera appelé un tuple. Ainsi, tout élément de la file d'attente peut être un message unique mblk_t, ou bien la tête d'un tuple de messages mblk_t. Chaque message dans le tuple peut avoir son propre bloc de données associé. Nous discuterons davantage de l'utilité des tuples un peu plus tard.
Comme mentionné précédemment, un message ne contient pas de bloc de données en lui-même, mais comprend seulement un pointeur vers la zone mémoire où est stocké le bloc. À ce stade, l'image générale du fonctionnement du mediastreamer rappelle le dépôt de portes dans le film "Monstres et Cie", où les portes (références aux données — chambres) se déplacent à une vitesse folle sur des tapis roulants, tandis que les chambres elles-mêmes restent immobiles.
Maintenant, en progressant dans la hiérarchie de bas en haut, examinons plus en détail les entités du mécanisme de transfert de données dans le mediastreamer.
Bloc de données dblk_t
Un bloc de données se compose d'un en-tête et d'un tampon de données. L'en-tête est décrit par la structure suivante,
typedef struct datab
{
unsigned char *db_base; // Pointeur vers le début du tampon de données.
unsigned char *db_lim;  // Pointeur vers la fin du tampon de données.
void (*db_freefn)(void*); // Fonction de libération de mémoire lors de la suppression du bloc.
int db_ref; // Compteur de références.
} dblk_t;
Les champs de la structure contiennent des pointeurs vers le début du tampon, la fin du tampon, et une fonction pour supprimer le tampon de données. Le dernier élément dans l'en-tête db_ref — est un compteur de références ; s'il atteint zéro, cela signale la suppression de ce bloc de la mémoire. Si le bloc de données a été créé par la fonction datab_alloc() , alors le tampon de données sera situé en mémoire immédiatement après l'en-tête. Dans tous les autres cas, le tampon peut être situé quelque part ailleurs. Dans le tampon de données se trouveront les échantillons de signal ou d'autres données que nous souhaitons traiter avec des filtres.
Une nouvelle instance du bloc de données est créée à l'aide de la fonction :
dblk_t *datab_alloc(int size);Le paramètre d'entrée est la taille des données que le bloc va stocker. Plus de mémoire est allouée afin que, au début de la mémoire allouée, l'en-tête — la structure datab. Cependant, lorsque d'autres fonctions sont utilisées, cela ne se produit pas toujours ; dans certains cas, le tampon de données peut être situé séparément de l'en-tête du bloc de données. Les champs de la structure sont configurés lors de la création afin que son champ db_base pointe vers le début de la zone de données, et db_lim vers sa fin. Le compteur de références db_ref est initialisé à un. Le pointeur de fonction pour nettoyer les données est initialisé à zéro.
Message mblk_t
Comme indiqué, les éléments de la queue ont le type mblk_t, il est défini comme suit :
typedef struct msgb
{
  struct msgb *b_prev;   // Pointeur vers l'élément précédent de la liste.
  struct msgb *b_next;   // Pointeur vers l'élément suivant de la liste.
  struct msgb *b_cont;   // Pointeur pour relier d'autres messages au message, afin de créer un tuple de messages.
  struct datab *b_datap; // Pointeur vers la structure du bloc de données.
  unsigned char *b_rptr; // Pointeur vers le début de la zone de données pour lire les données du tampon b_datap.
  unsigned char *b_wptr; // Pointeur vers le début de la zone de données pour écrire des données dans le tampon b_datap.
  uint32_t reserved1;    // Champ réservé1, le flux multimédia y place des informations de service.
  uint32_t reserved2;    // Champ réservé2, le flux multimédia y place des informations de service.
  #if defined(ORTP_TIMESTAMP)
  struct timeval timestamp;
  #endif
  ortp_recv_addr_t recv_addr;
} mblk_t;
Structure mblk_t commence par des pointeurs b_prev, b_next, nécessaires pour organiser une liste doublement chaînée (qui est la queue queue_t).
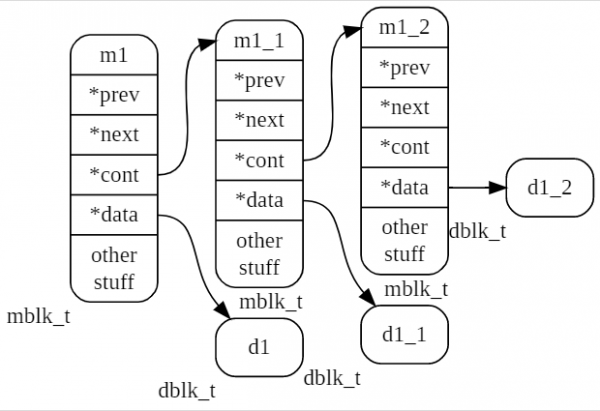
Ensuite vient le pointeur b_cont, qui est utilisé uniquement lorsque le message entre dans le tuple. Pour le dernier message du tuple, ce pointeur reste nul.
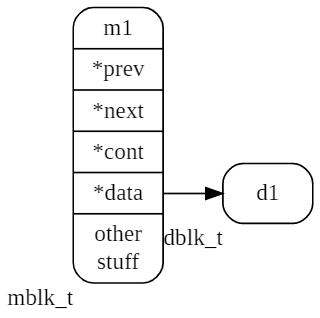
Ensuite, nous voyons un pointeur vers un bloc de données b_datap, pour lequel le message existe. Il est suivi de pointeurs, vers la zone à l'intérieur du tampon de données du bloc. Le champ b_rptr indique le lieu à partir duquel les données seront lues à partir du tampon. Le champ b_wptr indique le lieu à partir duquel l'écriture dans le tampon sera effectuée.
Les champs restants sont d'ordre fonctionnel et ne sont pas liés au mécanisme de transmission des données.
Ci-dessous, un message unique nommé m1 et un bloc de données d1.
À la figure suivante, un tuple de trois messages est montré m1, m1_1, m1_2.
Les fonctions de gestion des messages mblk_t
Un nouveau message mblk_t est créé par la fonction :
mblk_t *allocb(int size, int pri); elle alloue en mémoire un nouveau message mblk_t avec un bloc de données de taille spécifiée taille, le deuxième argument — pri n'est pas utilisé dans la version de la bibliothèque considérée. Il doit rester nul. Pendant l'exécution de la fonction, de la mémoire sera allouée pour la structure du nouveau message et la fonction mblk_init(), qui remettra à zéro tous les champs de l'instance créée de la structure et ensuite, à l'aide de ce qui a été mentionné ci-dessus, datab_alloc(), un tampon de données sera créé. Après cela, les champs de la structure seront configurés :
mp->b_datap=datab;
mp->b_rptr=mp->b_wptr=datab->db_base;
mp->b_next=mp->b_prev=mp->b_cont=NULL;
À la sortie, nous obtenons un nouveau message avec des champs initialisés et un tampon de données vide. Pour ajouter des données au message, il faut les copier dans le tampon du bloc de données :
memcpy(msg->b_rptr, data, size);où data — pointeur vers la source des données, et taille — leur taille.
Ensuite, il faut mettre à jour le pointeur vers le point d'écriture, pour qu'il pointe à nouveau vers le début de la zone libre dans le tampon :
msg->b_wptr = msg->b_wptr + sizeS'il est nécessaire de créer un message à partir d'un tampon déjà existant, sans copier, alors pour cela, on utilise la fonction :
mblk_t *esballoc(uint8_t *buf, int size, int pri, void (*freefn)(void*)); La fonction après la création du message et de la structure du bloc de données, configurera ses pointeurs vers les données à l'adresse buf. C'est-à-dire que, dans ce cas, le tampon de données ne se trouve pas juste après les champs de l'en-tête du bloc de données, comme cela a été fait lors de la création du bloc de données par la fonction. datab_alloc()Le tampon de données passé à la fonction restera à l'endroit où il était, mais grâce aux pointeurs, il sera dirigé vers l'en-tête du bloc de données nouvellement créé, ce dernier étant associé au message.
À un message mblk_t peuvent être successivement attachés plusieurs blocs de données. Cela se fait par la fonction :
mblk_t * appendb(mblk_t *mp, const char *data, int size, bool_t pad); mp — le message auquel un autre bloc de données sera ajouté ;
data — un pointeur vers le bloc, une copie de celui-ci sera ajoutée au message ;
taille — la taille des données ;
pad — un drapeau indiquant que la taille de la mémoire allouée doit être arrondie à la frontière de 4 octets (le remplissage sera effectué avec des zéros).
Si le tampon de données du message existe a suffisamment d'espace, alors les nouvelles données seront collées après les données déjà présentes. Si l'espace libre dans le tampon de données du message est inférieur à taille, un nouveau message est créé avec une taille de tampon adéquate, et les données sont copiées dans son tampon. Ce nouveau message est attaché à l'original à l'aide d'un pointeur b_cont. Dans ce cas, le message se transforme en un tuple.
Si un autre bloc de données doit être ajouté au tuple, il faut utiliser la fonction :
void msgappend(mblk_t *mp, const char *data, int size, bool_t pad);elle recherchera le dernier message dans le tuple (il aura une valeur nulle) et appellera la fonction b_cont appendb() Pour connaître la taille des données dans un message ou un tuple, on peut utiliser la fonction :.
int msgdsize(const mblk_t *mp);
elle parcourra tous les messages du tuple et renverra la quantité totale de données dans les tampons de données de ces messages. Pour chaque message, la quantité de données est calculée ainsi :mp->b_wptr - mp->b_rptr
Pour fusionner deux tuples, on utilise la fonction :mblk_t *concatb(mblk_t *mp, mblk_t *newm);
elle attachera le tuplenewm à la fin du tuple et renverra un pointeur vers le dernier message du tuple résultant. mp Si nécessaire, un tuple peut être transformé en un seul message avec un bloc de données unifié, cela se fait par la fonction :
void msgpullup(mblk_t *mp,int len);
si l'argumentest égal à -1, la taille du tampon alloué est déterminée automatiquement. Si len si égal à -1, alors la taille du tampon de sortie est déterminée automatiquement. Si len S'il s'agit d'un nombre positif, un tampon de cette taille sera créé et les données des messages de tuple y seront copiées. Si le tampon est plein, la copie sera interrompue. Le premier message du tuple obtiendra un tampon de nouvelle taille avec les données copiées. Les autres messages seront supprimés et la mémoire sera restituée au tas.
Lors de la suppression de la structure mblk_t le compteur de références du bloc de données est pris en compte, si lors de l'appel freeb() il est égal à zéro, alors le tampon de données est supprimé avec l'instance mblk_t, qui pointe vers lui.
Initialisation des champs d'un nouveau message :
void mblk_init(mblk_t *mp);Ajout d'une autre portion de données au message :
mblk_t * appendb(mblk_t *mp, const char *data, size_t size, bool_t pad);Si les nouvelles données ne tiennent pas dans l'espace libre du tampon de données du message, un message séparé est attaché avec un tampon de la taille nécessaire (dans le premier message, un pointeur vers le message ajouté est établi) et le message se transforme en tuple.
Ajout d'une portion de données au tuple :
void msgappend(mblk_t *mp, const char *data, size_t size, bool_t pad); La fonction appelle appendb() dans une boucle.
Fusion de deux tuples en un :
elle attachera le tupleMessage à la fin du tuple sera attaché à mp.
Création d'une copie d'un message unique :
mblk_t *copyb(const mblk_t *mp);Copie complète d'un tuple avec tous les blocs de données :
mblk_t *copymsg(const mblk_t *mp);Les éléments du tuple sont alors copiés par la fonction copyb().
Création d'une copie légère d'un message. mblk_tDans ce cas, le bloc de données n'est pas copié, mais son compteur de références est augmenté. db_ref:
mblk_t *dupb(mblk_t *mp);Création d'une copie légère d'un tuple. Les blocs de données ne sont pas copiés, seuls leurs compteurs de références sont augmentés. db_ref:
mblk_t *dupmsg(mblk_t* m);Collage de tous les messages du tuple en un seul message :
void msgpullup(mblk_t *mp,size_t len);Si l'argument len est égal à -1, la taille du tampon alloué est déterminée automatiquement.
Suppression d'un message, d'un tuple :
void freemsg(mblk_t *mp);Le compteur de références du bloc de données est diminué d'une unité. S'il atteint zéro, le bloc de données est également supprimé.
Calcul du volume total de données dans un message ou un tuple.
size_t msgdsize(const mblk_t *mp);Extraction d'un message de la fin de la file d'attente :
mblk_t *ms_queue_peek_last (q);Copie du contenu des champs réservés d'un message dans un autre message (dans ces champs se trouvent en réalité des drapeaux utilisés par le lecteur multimédia) :
mblk_meta_copy(const mblk_t *source, mblk *dest);File d'attente queue_t
La file de messages dans le médiastreamer est réalisée sous la forme d'une liste doublement chaînée circulaire. Chaque élément de la liste contient un pointeur vers un bloc de données avec des échantillons de signal. Cela signifie que seuls les pointeurs vers le bloc de données sont déplacés séquentiellement, tandis que les données elles-mêmes restent immobiles. Autrement dit, seules les références à ces données se déplacent.
Structure décrivant la file queue_t, illustrée ci-dessous :
typedef struct _queue
{
   mblk_t _q_stopper; /* "Élément inactif" de la file, ne pointe pas vers des données, utilisé uniquement pour la gestion de la file. Lors de l'initialisation de la file (qinit()), ses pointeurs sont configurés pour pointer vers lui-même. */
   int q_mcount;        // Nombre d'éléments dans la file.
} queue_t;
La structure contient un champ — un pointeur _q_stopper de type *mblk_t, il pointe vers le premier élément (message) de la file. Le deuxième champ de la structure est un compteur des messages présents dans la file.
La figure ci-dessous montre la file nommée q1, contenant 4 messages m1, m2, m3, m4.
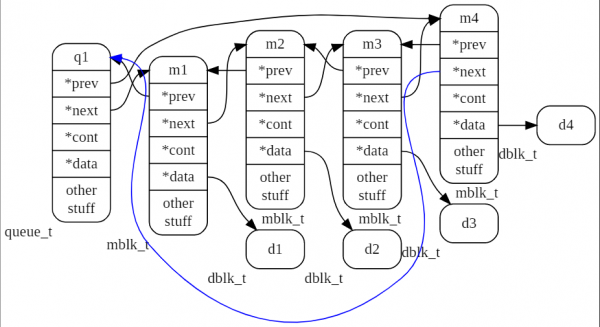
La figure suivante montre la file nommée q1, contenant 4 messages m1, m2, m3, m4. Le message m2 est la tête du tuple, dans lequel sont intégrés deux autres messages m2_1 et m2_2.
Fonctions de gestion des files d'attente queue_t
L'initialisation de la file :
void qinit(queue_t *q);Champ _q_stopper (nous l'appellerons ensuite "stopper") est initialisé par la fonction mblk_init(), son pointeur d'élément précédent et de l'élément suivant est configuré pour pointer vers lui-même. Le compteur des éléments de la file est mis à zéro.
Ajout d'un nouvel élément (message) :
void putq(queue_t *q, mblk_t *m);Un nouvel élément m est ajouté à la fin de la liste, les pointeurs de l'élément sont configurés de sorte que le stopper devienne le suivant pour lui, et lui le précédent pour le stopper. Le compteur des éléments de la file est incrémenté.
Extraction d'un élément de la file :
mblk_t * getq(queue_t *q); le message qui se trouve après le stopper est extrait, le compteur des éléments est décrémenté. Si la file ne contient pas d'éléments à part le stopper, elle retourne 0.
Insertion d'un message dans la file :
void insq(queue_t *q, mblk_t *emp, mblk_t *mp); L'élément mp est inséré avant l'élément emp. Si emp=0, alors le message est ajouté à la fin de la file.
Extraction du message de la tête de la file :
void remq(queue_t *q, mblk_t *mp); Le compteur des éléments est décrémenté.
Lecture du pointeur vers le premier élément de la file :
mblk_t * peekq(queue_t *q); Suppression de tous les éléments de la file avec suppression des éléments eux-mêmes :
void flushq(queue_t *q, int how);Argument how n'est pas utilisé. Le compteur d'éléments de la file d'attente est réglé à zéro.
Macro de lecture du pointeur vers le dernier élément de la file d'attente :
mblk_t * qlast(queue_t *q);Lors de l'utilisation des files d'attente de messages, il faut garder à l'esprit que lors de l'appel de ms_queue_put(q, m) avec un pointeur nul pour le message, la fonction entre dans une boucle infinie. Votre programme sera bloqué. De même se comporte ms_queue_next(q, m).
Connexion de filtres
La file d'attente décrite ci-dessus est utilisée pour transmettre des messages d'un filtre à un autre ou d'un filtre à plusieurs filtres. Les filtres et leurs connexions forment un graphe dirigé. L'entrée ou la sortie d'un filtre sera appelée de manière générale "passe". Pour décrire l'ordre de connexion des filtres entre eux, le médiastreamer utilise le concept de "point de signal". Un point de signal est une structure _MSCPoint, qui contient un pointeur vers le filtre et le numéro de l'un de ses passes, décrivant ainsi la connexion de l'une des entrées ou sorties du filtre.
Point de signalisation du graphe de traitement de données
typedef struct _MSCPoint{
struct _MSFilter *filter; // Pointeur vers le filtre du médiastreamer.
int pin;                        // Numéro de l'une des entrées ou sorties du filtre, c'est-à-dire passe.
} MSCPoint;
Les passes des filtres sont numérotées à partir de zéro.
La connexion de deux passes par une file d'attente de messages est décrite par la structure _MSQueue, qui contient la file d'attente de messages et des pointeurs vers deux points de signal qu'elle connecte :
typedef struct _MSQueue
{
queue_t q;
MSCPoint prev;
MSCPoint next;
}MSQueue;
Appelons cette structure un lien de signal. Chaque filtre du médiastreamer contient une table de liens d'entrée et une table de liens de sortie (MSQueue). La taille des tables est définie lors de la création du filtre, ce que nous avons déjà fait à l'aide de la variable exportée de type MSFilterDesc, lors de la création de notre propre filtre. Ci-dessous est montrée la structure décrivant n'importe quel filtre dans le médiastreamer, MSFilter:
struct _MSFilter{
    MSFilterDesc *desc;
    /* Pointeur vers le descripteur du filtre. */
    /* Attributs protégés, ils ne peuvent pas être déplacés ou supprimés sans perturber le fonctionnement des plugins. */
    ms_mutex_t lock;      /* Sémaphore. */
    MSQueue **inputs;     /* Table des liens d'entrée. */
    MSQueue **outputs;    /* Table des liens de sortie. */
    struct _MSFactory *factory; /* Pointeur vers la fabrique qui a créé cette instance du filtre. */
    void *padding;              /* Non utilisé, sera activé si des champs protégés sont ajoutés. */
    void *data;                 /* Pointeur vers une structure arbitraire pour stocker les données d'état interne du filtre et les calculs intermédiaires. */
    struct _MSTicker *ticker;   /* Pointeur vers l'objet ticker, qui ne doit pas être nul lors de l'appel de la fonction process(). */
    /* Attributs privés, ils peuvent être déplacés et modifiés à tout moment */
    MSList *notify_callbacks; /* Liste des rappels utilisés pour traiter les événements du filtre. */
    uint32_t last_tick;       /* Numéro du dernier tick, lorsque l'appel process() a été exécuté. */
    MSFilterStats *stats;     /* Statistiques de l'exécution du filtre. */
    int postponed_task; /* Nombre de tâches reportées. Certains filtres peuvent reporter le traitement des données (appel process()) pendant plusieurs ticks. */
    bool_t seen;  /* Drapeau que le ticker utilise pour marquer que cette instance du filtre a déjà été traitée lors de ce tick. */
};
typedef struct _MSFilter MSFilter;
Après avoir connecté les filtres dans notre programme C selon notre conception (mais sans connecter le ticker), nous avons ainsi créé un graphe dirigé, dont les nœuds sont des instances de la structure MSFilter, et les arêtes sont des instances de liens MSQueue.
Activité en coulisse du ticker
Quand je vous ai dit que le ticker est un filtre source de ticks, ce n'était pas toute la vérité à son sujet. Le ticker est un objet qui exécute des fonctions selon une horloge process() de tous les filtres du schéma (graphe) auquel il est connecté. Lorsque dans le programme C nous connectons le ticker à un filtre du graphe, nous montrons au ticker le graphe qu'il va gérer à partir de ce moment, jusqu'à ce que nous le déconnectons. Après la connexion, le ticker commence à inspecter le graphe qui lui est confié, en établissant une liste des filtres qui en font partie. Afin de ne pas "compter" le même filtre deux fois, il marque les filtres découverts en leur mettant un drapeau seen. La recherche se fait à travers les tables de liens, qui existent pour chaque filtre.
Lors de sa visite d'introduction au graphique, le ticker vérifie s'il existe parmi les filtres, au moins un qui joue le rôle de source de blocs de données. Si aucun n'est trouvé, le graphique est considéré comme incorrect et le ticker s'arrête d'urgence.
Si le graphique est "correct", pour chaque filtre trouvé, la fonction est appelée pour l'initialisation. preprocess(). Dès qu'il est temps pour le prochain cycle de traitement (par défaut toutes les 10 millisecondes), le ticker appelle la fonction. process() pour tous les filtres sources précédemment trouvés, puis pour les autres filtres de la liste. Si un filtre a des liens d'entrée, le lancement de la fonction. process() est répété jusqu'à ce que les files d'attente des liens d'entrée soient vides. Ensuite, il passe au filtre suivant de la liste et "enchaîne" jusqu'à ce que les liens d'entrée soient dégagés des messages. Le ticker passe d'un filtre à l'autre jusqu'à ce que la liste soit terminée. C'est ainsi que se termine le traitement d'un cycle.
Revenons maintenant aux tuples et parlons de l'ajout d'une telle entité dans le médiastreamer. De manière générale, le volume de données nécessaire à l'algorithme fonctionnant à l'intérieur du filtre ne correspond pas et n'est pas un multiple à la taille des buffers de données entrant. Par exemple, nous écrivons un filtre qui effectue une transformation de Fourier rapide, qui par définition ne peut traiter que des blocs de données dont la taille est égale à une puissance de deux. Supposons qu'il s'agisse de 512 échantillons. Si les données sont générées par un canal téléphonique, alors le buffer de données de chaque message à l'entrée fournira 160 échantillons du signal. Il est tentant de ne pas retirer les données de l'entrée tant qu'il n'y a pas un nombre suffisant de données. Mais dans ce cas, il y aura un conflit avec le ticker, qui tentera sans succès de faire défiler le filtre jusqu'à ce que le lien d'entrée soit vidé. Nous avons déjà désigné cette règle comme le troisième principe de fonctionnement du filtre. Conformément à ce principe, la fonction process() du filtre doit retirer toutes les données des files d'attente d'entrée.
De plus, il ne sera pas possible de récupérer seulement 512 échantillons à partir de l'entrée, car il faut récupérer des blocs complets, c'est-à-dire que le filtre devra récupérer 640 échantillons et en utiliser 512, laissant le reste pour accumuler de nouvelles données. Ainsi, notre filtre, en plus de son fonctionnement principal, doit assurer des actions auxiliaires pour le stockage temporaire des données d'entrée. Les développeurs du médiastreamer ont conçu un objet spécial pour résoudre cette tâche commune : le MSBufferizer, qui s'occupe de cette tâche à l'aide de tuples.
Mise en mémoire tampon (MSBufferizer)
C'est un objet qui va accumuler les données d'entrée à l'intérieur du filtre et commencera à les traiter dès que la quantité d'informations sera suffisante pour exécuter l'algorithme du filtre. Tant que le buffer accumule les données, le filtre fonctionnera en mode idling, sans utiliser la puissance de calcul du processeur. Mais dès que la fonction de lecture du buffer renvoie une valeur différente de zéro, la fonction process() du filtre commence à récupérer et traiter les données du buffer par portions de la taille nécessaire, jusqu'à épuisement.
Les données non encore utilisées restent dans le buffer comme le premier élément du tuple, auquel s'accrochent les blocs suivants de données d'entrée.
La structure qui décrit le buffer :
struct _MSBufferizer{
queue_t q; /* File de messages. */
int size; /* Taille totale des données actuellement dans le buffer. */
};
typedef struct _MSBufferizer MSBufferizer;
Fonctions de gestion du MSBufferizer
Création d'une nouvelle instance du buffer :
MSBufferizer * ms_bufferizer_new(void);La mémoire est allouée, initialisée dans ms_bufferizer_init() et un pointeur est retourné.
Fonction d'initialisation :
void ms_bufferizer_init(MSBufferizer *obj); La file q, champ taille est initialisée à zéro.
Ajout d'un message :
void ms_bufferizer_put(MSBufferizer *obj, mblk_t *m); Le message m est ajouté à la file. La taille calculée des blocs de données est ajoutée à taille.
Translation of all messages from the data link queue to the buffer q:
void ms_bufferizer_put_from_queue(MSBufferizer *obj, MSQueue *q); Le transfert des messages du lien q au buffer se fait à l'aide de la fonction ms_bufferizer_put().
Lecture à partir du buffer :
int ms_bufferizer_read(MSBufferizer *obj, uint8_t *data, int datalen); Si la taille des données accumulées dans le buffer est inférieure à celle demandée (datalen), la fonction renvoie zéro, la copie des données dans data n'est pas effectuée. Sinon, une copie séquentielle des données à partir des tuples dans le tampon s'effectue. Après la copie, le tuple est supprimé et la mémoire est libérée. La copie s'achève dès que datalen octets ont été copiés. Si l'espace se termine au milieu d'un bloc de données, alors dans ce message, le bloc de données sera raccourci à la partie restante non copiée. Lors du prochain appel, la copie se poursuivra à partir de cet endroit.
Lecture de la quantité de données actuellement disponibles dans le tampon :
int ms_bufferizer_get_avail(MSBufferizer *obj); Renvoie le champ taille du tampon.
Élimination d'une partie des données présentes dans le tampon :
void ms_bufferizer_skip_bytes(MSBufferizer *obj, int bytes);Le nombre d'octets de données spécifié est extrait et éliminé. Les données les plus anciennes sont éliminées.
Suppression de tous les messages présents dans le tampon :
void ms_bufferizer_flush(MSBufferizer *obj); Le compteur de données est réinitialisé à zéro.
Suppression de tous les messages présents dans le tampon :
void ms_bufferizer_uninit(MSBufferizer *obj); La réinitialisation du compteur n'est pas effectuée.
Suppression du tampon et libération de la mémoire :
void ms_bufferizer_destroy(MSBufferizer *obj); Des exemples d'utilisation du tampon peuvent être trouvés dans le code source de plusieurs filtres du médiastreamer. Par exemple, dans le filtre MS_L16_ENC, qui effectue une permutation des octets dans les échantillons de l'ordre réseau vers l'ordre hôte :
Dans le prochain article, nous traiterons de l'évaluation de la charge sur le tickeur et des moyens de lutter contre une charge de calcul excessive dans le mediastreamer.
Source : habr.com
