

Je suis sûr que le titre a suscité une réaction saine — « ça recommence encore... » Mais permettez-moi de capter votre attention pendant 5 à 10 minutes, et je ferai de mon mieux pour ne pas décevoir vos attentes.
La structure de l'article sera la suivante : une affirmation stéréotypée sera prise et la « nature » de l'origine de ce stéréotype sera développée. J'espère que cela permettra de voir le choix du paradigme d'échange de données dans vos projets sous un nouvel angle.
Pour clarifier ce qu'est le RPC, je propose d'examiner le standard . Avec REST, il n'y a pas de clarté. Et il ne devrait pas y en avoir. Tout ce que vous devez savoir sur REST, c'est qu'il est indistinguable de .
Les requêtes RPC sont plus rapides et plus efficaces, car elles permettent de faire des requêtes en lot.
Il s'agit de ce que l'on peut faire dans une requête RPC : appeler plusieurs procédures en une seule fois. Par exemple, créer un utilisateur, lui ajouter un avatar et, dans la même requête, l'abonner à certains sujets. Une seule requête, mais quelle utilité !
En effet, si vous n’avez qu’un seul nœud backend, cela semblera plus rapide avec une requête en lot. Parce que trois requêtes REST nécessiteront trois fois plus de ressources d'un seul nœud pour établir des connexions.
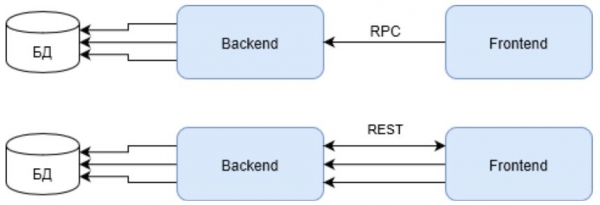
Notez que la première requête dans le cas de REST doit retourner l'identifiant de l'utilisateur pour exécuter les requêtes suivantes. Cela a également un impact négatif sur le résultat global.
Mais de telles infrastructures ne se rencontrent guère que dans des solutions internes et des entreprises. Au pire, dans de petits projets WEB. Cependant, des solutions WEB complètes, surtout celles intitulées HighLoad, ne devraient pas être construites ainsi. Leur infrastructure doit répondre à des critères de haute disponibilité et de charge. Et la donne change.
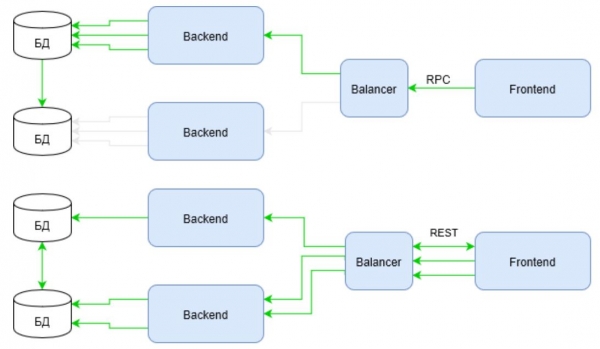
Les canaux d'activité de l'infrastructure sont marqués en vert pour le même scénario. Notez comment le RPC se comporte maintenant. La requête utilise l'infrastructure uniquement sur un seul bras du répartiteur vers le backend. Pendant que REST continue de perdre dans la première requête, il compense le retard en utilisant toute l'infrastructure.
Il suffit d'introduire dans le scénario non pas deux requêtes d'enrichissement, mais peut-être cinq ou dix... et la réponse à la question « qui gagne maintenant ? » devient moins évidente.
Je vous propose d'explorer la problématique plus en profondeur. Le schéma montre comment les canaux d'infrastructure sont utilisés, mais l'infrastructure ne se limite pas aux canaux. Un élément essentiel d'une infrastructure à fort trafic est le cache. Obtenons maintenant un artefact utilisateur. Plusieurs fois. Disons 32 fois.
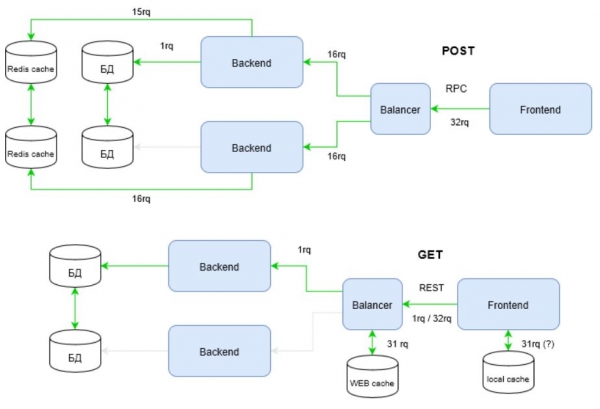
Regardez comment l'infrastructure de RPC a clairement été "améliorée" pour répondre aux exigences de haute charge. Tout réside dans le fait que REST exploite toute la puissance du protocole HTTP contrairement à RPC. Sur le schéma fourni, cette puissance est mise en œuvre par le biais de la méthode de requête — GET.
Les méthodes HTTP ont, entre autres, des stratégies de mise en cache. Vous pouvez les découvrir dans la documentation sur . Pour RPC, on utilise des requêtes POST, qui ne sont pas considérées comme idempotentes, c'est-à-dire que la répétition de la même requête POST peut renvoyer des résultats différents (par exemple, après chaque envoi d'un commentaire, une nouvelle copie de ce commentaire apparaîtra) ().
Par conséquent, RPC ne peut pas utiliser efficacement les caches d'infrastructure. Cela fait qu'il est nécessaire d'introduire des caches logiciels. Sur le schéma, Redis joue ce rôle. Le cache logiciel, à son tour, nécessite un niveau de code supplémentaire de la part du développeur et des modifications notables dans l'architecture.
Calculons maintenant le nombre de requêtes générées par REST et RPC dans l'infrastructure examinée ?
Requêtes
Entrants
au backend
à la base de données
au cache logiciel (Redis)
TOTAL
REST
1/32*
1
1
0
3 / 35
RPC
32
32
1
31
96
[*] dans le meilleur des cas (si le cache local est utilisé) 1 requête (une seule !), au pire 32 requêtes entrantes.
Comparé au premier schéma, la différence est frappante. Il devient maintenant évident que REST a un avantage. Mais je propose de ne pas s'arrêter là. Une infrastructure développée inclut un CDN. Celui-ci règle souvent la question de la lutte contre les attaques DDoS et DoS. Obtenons :
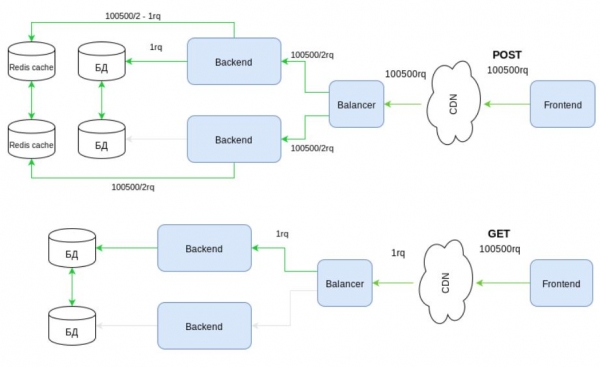
Ici, pour RPC, la situation devient vraiment désastreuse. RPC est simplement incapable de déléguer le travail avec la charge au CDN. Il ne reste plus qu'à compter sur les systèmes de lutte contre les attaques.
Peut-on en rester là ? Encore une fois, non. Les méthodes HTTP, comme mentionné précédemment, ont leur propre « magie ». Ce n'est pas pour rien que la méthode GET est largement utilisée sur Internet. Notez que cette méthode peut accéder à une partie du contenu, imposer des conditions que les éléments d'infrastructure peuvent interpréter avant même de transférer le contrôle à votre code, etc. Tout cela permet de créer des infrastructures flexibles et gérables, capables de traiter d'importants flux de requêtes. Et dans le RPC, cette méthode... est ignorée.
Alors, pourquoi le mythe selon lequel les requêtes par lots (RPC) sont plus rapides est-il si tenace ? Personnellement, je pense que la plupart des projets n'atteignent tout simplement pas un niveau de maturité où REST peut vraiment briller. De plus, dans les petits projets, il montre plus facilement ses faiblesses.
Le choix entre REST ou RPC n'est pas une décision unilatérale d'un individu dans un projet. Ce choix doit répondre aux exigences du projet. Si le projet peut tirer parti de tout ce que REST a à offrir et que c'est réellement nécessaire, alors REST sera un excellent choix.
Mais si pour obtenir tous les avantages de REST, il faut embaucher des DevOps pour une mise à l'échelle rapide de l'infrastructure, des administrateurs pour gérer cette infrastructure, un architecte pour concevoir tous les niveaux d'un service WEB... et que le projet ne vend que trois paquets de margarine par jour... je pencherais plutôt pour le RPC, car ce protocole est plus utilitaire. Il ne nécessitera pas de connaissances approfondies sur le fonctionnement des caches et de l'infrastructure, et concentrera le développeur sur des appels simples et clairs aux procédures dont il a besoin. Les affaires seront satisfaites.
Les requêtes RPC sont plus fiables, car elles peuvent exécuter des requêtes par lots dans le cadre d'une seule transaction.
Cette caractéristique du RPC est sans conteste un avantage, car elle permet de maintenir la base de données dans un état cohérent. Avec REST, c'est plus complexe. Les requêtes peuvent arriver de manière non séquentielle sur différentes nœuds du backend.
Ce « défaut » de REST est l'envers de son avantage décrit ci-dessus : la capacité d'utiliser efficacement toutes les ressources de l'infrastructure. Si l'infrastructure est mal conçue, et surtout si l'architecture du projet et de la base de données en particulier est mal faite, alors cela devient vraiment problématique.
Mais les requêtes en lot sont-elles si fiables qu'elles semblent l'être ? Considérons un cas : nous créons un utilisateur, nous enrichissons son profil avec une description et nous lui envoyons un SMS avec un code secret pour compléter son inscription. C'est-à-dire trois appels dans une seule requête en lot.
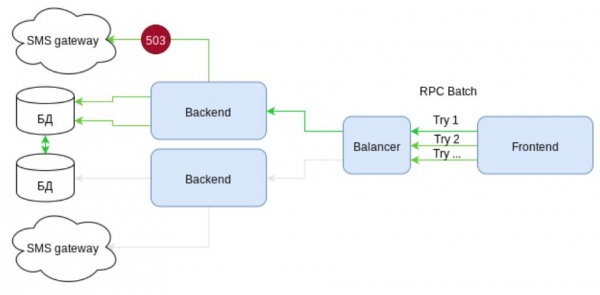
Examinons le schéma. Il présente une infrastructure avec des éléments de haute disponibilité. Il y a deux canaux de communication indépendants avec les passerelles SMS. Mais… que voyons-nous ? Lors de l'envoi d'un SMS, une erreur 503 se produit — le service est temporairement indisponible. Comme l'envoi de SMS est inclus dans une requête en lot, toute la requête doit être annulée. Les actions dans la base de données sont annulées. Le client reçoit une erreur.
La prochaine tentative est une loterie. Soit la requête tombe à nouveau sur le même nœud et renvoie à nouveau une erreur, soit elle a de la chance et s'exécute. Mais le principal, c'est qu'au moins une fois, notre infrastructure a déjà travaillé pour rien. Il y a eu une charge, mais aucun bénéfice.
Bien, imaginons que nous nous soyons creusé la tête (!) et que nous ayons réfléchi à une option où la requête peut être exécutée partiellement avec succès. Et pour le reste, nous allons de nouveau essayer de l'exécuter après un certain intervalle de temps (Quel intervalle ? Le front décide ?). Mais la loterie reste. La requête d'envoi de SMS échouera de nouveau avec une probabilité de 50/50.
Vous en convenez, du point de vue du client, le service ne semble pas aussi fiable qu'on le souhaiterait… qu'en est-il de REST ?
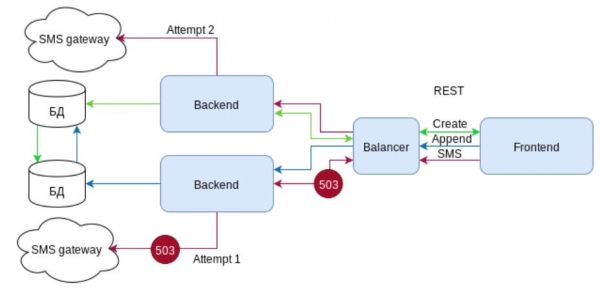
REST utilise à nouveau la "magie" de HTTP, mais cette fois avec des codes de réponse. Lorsqu'une erreur 503 se produit sur la passerelle SMS, le backend transmet cette erreur à l'équilibreur de charge. L'équilibreur, recevant cette erreur et sans rompre la connexion avec le client, dirige la requête vers un autre nœud, qui exécute la requête avec succès. C'est-à-dire que le client obtient le résultat attendu, et l'infrastructure confirme son titre de "haute disponibilité". L'utilisateur est satisfait.
Et ce n'est pas tout. L'équilibreur n'a pas simplement reçu le code de réponse 503. Ce code, lors de la réponse, devrait idéalement être accompagné de l'en-tête "Retry-After". Cet en-tête indique à l'équilibreur qu'il ne faut pas déranger ce nœud par cette route pendant une période donnée. Ainsi, les requêtes suivantes pour l'envoi de SMS seront immédiatement dirigées vers le nœud qui n'a pas de problèmes avec la passerelle SMS.
Comme nous le voyons, la fiabilité de JSON-RPC est surestimée. En effet, il est plus facile d'organiser la cohérence dans la base de données. Mais en retour, la fiabilité du système dans son ensemble en pâtira.
La sortie est en grande partie similaire à la précédente. Lorsque l'infrastructure est simple, la clarté de JSON-RPC est sans aucun doute un avantage. Si le projet implique une haute disponibilité avec une forte charge, REST semble être une solution plus appropriée, bien qu'elle soit plus complexe.
Le seuil d'entrée pour REST est plus bas
Je pense que l'analyse ci-dessus, qui démystifie les stéréotypes établis sur RPC, a clairement montré que le seuil d'entrée pour REST est indéniablement plus élevé que pour RPC. Cela est dû à la nécessité d'une compréhension approfondie du fonctionnement de HTTP, ainsi qu'à l'obligation de posséder des connaissances suffisantes sur les éléments d'infrastructure existants qui peuvent et doivent être appliqués dans les projets WEB.
Alors pourquoi beaucoup pensent-ils que REST sera plus simple ? À mon avis, cette apparente simplicité provient des manifestes mêmes de REST. Autrement dit, REST n'est pas un protocole, mais un concept… REST n'a pas de norme, il existe certaines recommandations… REST n'est pas plus complexe que HTTP. Cette apparente liberté et anarchie attirent les "artistes libres".
Sans aucun doute, REST n'est pas plus compliqué que HTTP. Mais HTTP lui-même est un protocole bien pensé qui a prouvé sa validité depuis des décennies. Sans une compréhension approfondie de HTTP, il n'est pas possible de juger de REST.
Concernant RPC, on peut le faire. Il suffit de consulter sa spécification. Avez-vous vraiment besoin de ? Или все же хитрый REST? Решать вам.
J'espère sincèrement que je n'ai pas perdu votre temps en vain.
Source : habr.com
