

L'échelle du réseau Amazon Web Services s'étend sur 69 zones à travers le monde dans 22 régions : États-Unis, Europe, Asie, Afrique et Australie. Chaque zone abrite jusqu'à 8 centres de données. Dans chaque centre de données, il y a des milliers ou des centaines de milliers de serveurs. Le réseau est conçu pour prendre en compte tous les scénarios d'interruption peu probables. Par exemple, toutes les régions sont isolées les unes des autres, et les zones de disponibilité sont séparées par plusieurs kilomètres. Même si un câble est coupé, le système basculera vers des canaux de secours, et la perte d'informations sera de quelques paquets de données. Les principes sur lesquels le réseau est construit et son fonctionnement seront expliqués par Vasily Pantiukhin.
Vassili Pantioukhine a commencé en tant qu'administrateur Unix dans des entreprises .ru, a passé 6 ans sur de grands équipements Sun Microsystem, et 11 ans à prôner la centralité des données chez EMC. Il a évolué naturellement vers les clouds privés, puis vers les publics. Actuellement, en tant qu'architecte d'Amazon Web Services, il apporte des conseils techniques pour vivre et se développer dans le cloud AWS.
Dans la partie précédente de la trilogie sur l'architecture d'AWS, Vasily s'est plongé dans la structure des serveurs physiques et l'escalade des bases de données. Les cartes Nitro, l'hyperviseur personnalisé basé sur KVM, la base de données Amazon Aurora — tout cela est abordé dans le matériel "". Lisez-le pour plonger dans le contexte, ou regardez des présentations.
Dans cette partie, nous allons parler de l'escalade du réseau — l'un des systèmes les plus complexes d'AWS. L'évolution d'un réseau plat vers le Virtual Private Cloud et sa structure, les services internes Blackfoot et HyperPlane, le problème du voisin bruyant, et à la fin — l'échelle du réseau, le backbone et les câbles physiques. Tout cela est plus loin.
Avertissement : tout ce qui suit est l'avis personnel de Vasily et peut ne pas correspondre à la position d'Amazon Web Services.
Mise à l'échelle du réseau
Le cloud AWS a été lancé en 2006. Son réseau était assez primitif — avec une structure plate. La plage d'adresses privées était commune à tous les locataires du cloud. Lors du lancement d'une nouvelle machine virtuelle, vous receviez accidentellement une adresse IP disponible de cette plage.
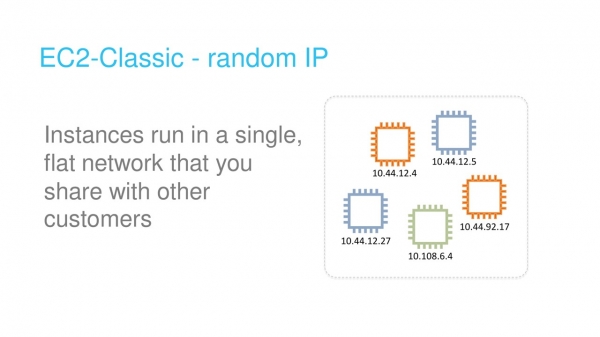
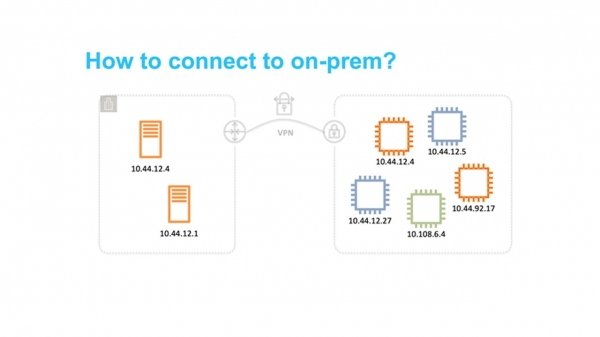
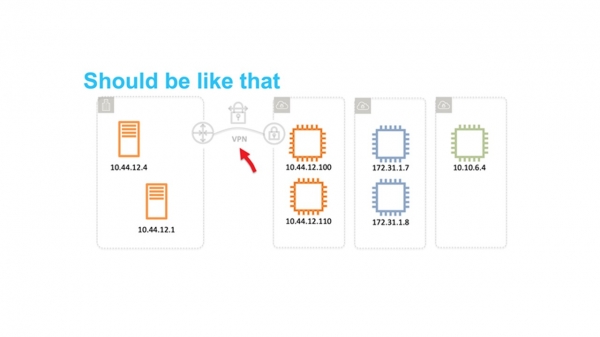
Cette approche était simple à mettre en œuvre, mais limitait fondamentalement l'utilisation du cloud. En particulier, il était assez difficile de développer des solutions hybrides combinant des réseaux privés sur site et dans AWS. Le problème le plus courant était le chevauchement des plages d'adresses IP.
Virtual Private Cloud
Le cloud s'est avéré très demandé. Il est temps de réfléchir à l'évolutivité et à la possibilité de son utilisation par des dizaines de millions de locataires. Le réseau plat est devenu le principal obstacle. C'est pourquoi nous avons réfléchi à la manière d'isoler les utilisateurs les uns des autres au niveau réseau afin qu'ils puissent choisir eux-mêmes leurs plages d'IP.
Que vous vient-il à l'esprit lorsque vous pensez à l'isolation réseau ? Bien sûr VLAN et VRF — Virtual Routing and Forwarding.
Malheureusement, cela n'a pas fonctionné. L'ID VLAN est de seulement 12 bits, ce qui ne nous donne que 4096 segments isolés. Même dans les plus grands commutateurs, on peut utiliser au maximum 1 à 2 milliers de VRF. Le partage de VRF et VLAN ne nous donne que quelques millions de sous-réseaux. C'est définitivement insuffisant pour des dizaines de millions de locataires, chacun d'eux devant avoir la possibilité d'utiliser plusieurs sous-réseaux.
De plus, nous ne pouvons tout simplement pas nous permettre d'acheter le nombre nécessaire de grosses unités, par exemple, chez Cisco ou Juniper. Il y a deux raisons : c'est horriblement cher, et nous ne voulons pas dépendre de leur politique de développement et de mise à jour.
Une conclusion s'impose – il faut créer sa propre solution.
En 2009, nous avons annoncé VPC — Virtual Private Cloud. Le nom a pris racine et maintenant de nombreux fournisseurs de cloud l'utilisent également.
VPC – c'est un réseau virtuel SDN (Software Defined Network). Nous avons décidé de ne pas inventer de protocoles spéciaux aux niveaux L2 et L3. Le réseau fonctionne sur Ethernet et IP standard. Pour le transfert de trafic sur le réseau, le trafic des machines virtuelles est encapsulé dans un wrapper de notre propre protocole. Il spécifie un ID, qui appartient au locataire VPC.
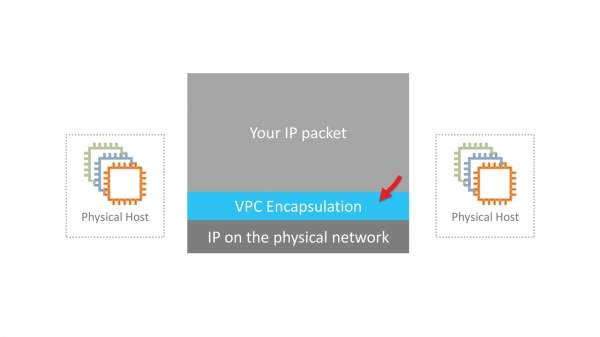
Cela semble simple. Cependant, il faut résoudre plusieurs problèmes techniques sérieux. Par exemple, où et comment stocker les données sur le mappage des adresses MAC/IP virtuelles, l'ID VPC et les MAC/IP physiques correspondants. À l'échelle d'AWS, il s'agit d'une énorme table qui doit fonctionner avec un minimum de latence lors des requêtes. Cela est géré par le service de mappage, qui est réparti en couche fine sur tout le réseau.
Dans les machines de nouvelle génération, l'encapsulation est effectuée par des cartes Nitro au niveau matériel. Dans les anciennes instances, l'encapsulation et la décapsulation sont effectuées par logiciel.
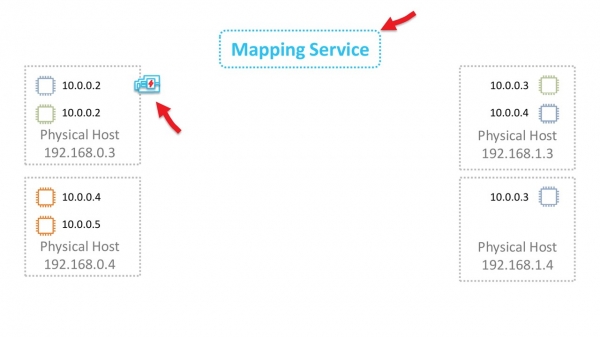
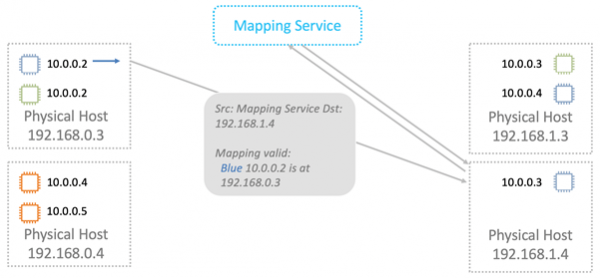
Voyons comment cela fonctionne en termes généraux. Commençons par le niveau L2. Supposons que nous avons une machine virtuelle avec l'IP 10.0.0.2 sur un serveur physique 192.168.0.3. Elle envoie des données à la machine virtuelle 10.0.0.3, qui se trouve à l'adresse 192.168.1.4. Une requête ARP est générée, qui est envoyée à la carte réseau Nitro. Pour simplifier, considérons que les deux machines virtuelles se trouvent dans le même VPC « bleu ».
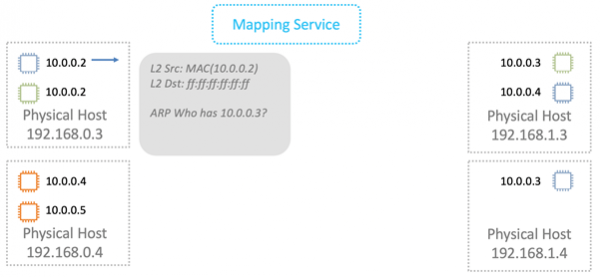
La carte remplace l'adresse source par la sienne et transmet le cadre ARP au service de mappage.
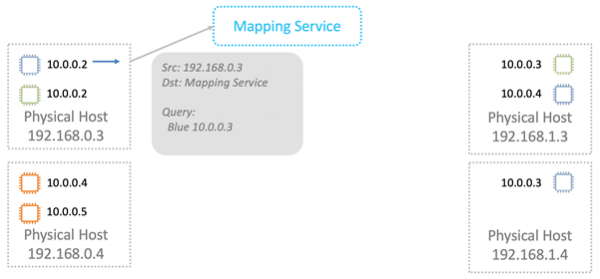
Le service de mappage renvoie les informations nécessaires pour la transmission sur le réseau physique L2.
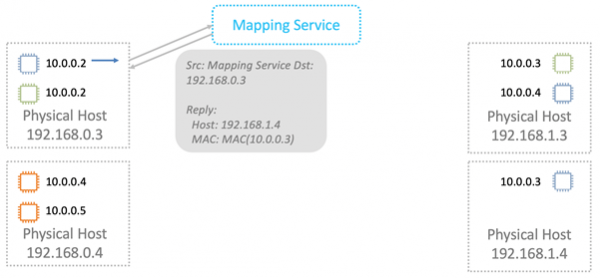
La carte Nitro dans la réponse ARP remplace l'adresse MAC dans le réseau physique par une adresse dans le VPC.
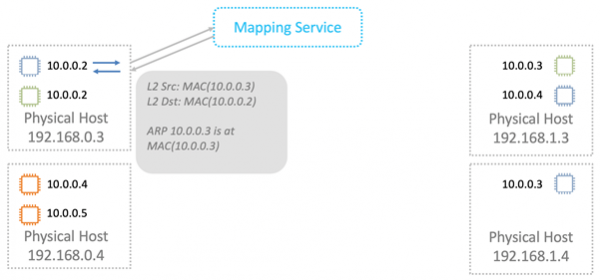
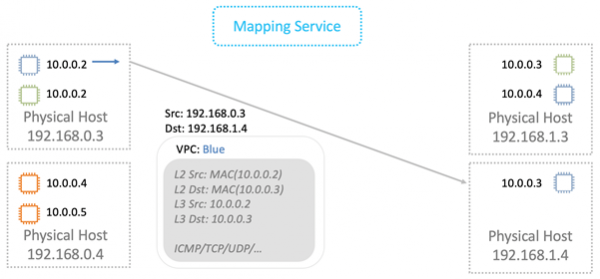
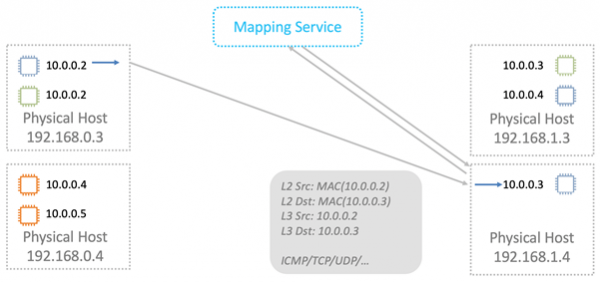
Lors de la transmission de données, nous enveloppons les MAC et les IP logiques dans un wrapper VPC. Nous transmettons tout cela sur le réseau physique à l'aide des adresses IP des cartes Nitro source et destination.
La machine physique à laquelle le paquet est destiné effectue une vérification. Cela est nécessaire pour empêcher toute substitution d'adresses. La machine envoie une requête spéciale au service de mappage et demande : « De la machine physique 192.168.0.3, j'ai reçu un paquet destiné à 10.0.0.3 dans le VPC « bleu ». Est-il légitime ? »
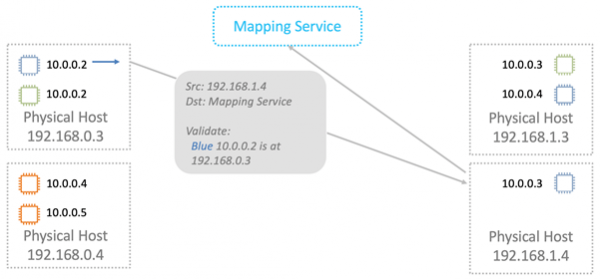
Le service de mappage vérifie sa table d'emplacement des ressources et autorise ou intercepte la transmission du paquet. Dans tous les nouveaux instances, une validation supplémentaire est intégrée dans les cartes Nitro. Celle-ci ne peut pas être contournée même théoriquement. Par conséquent, le spoofing sur des ressources dans un autre VPC ne fonctionnera pas.
Les données sont ensuite envoyées à la machine virtuelle pour laquelle elles sont destinées.
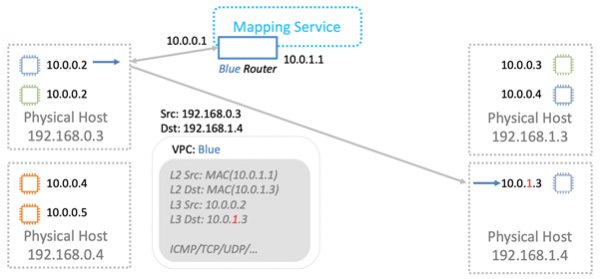
Le service de mappage agit également comme un routeur logique pour la transmission de données entre les machines virtuelles dans différents sous-réseaux. Conceptuellement, c'est assez simple, je ne vais pas le détailler.
Ainsi, à chaque transmission de paquet, les serveurs se dirigent vers le service de mappage. Comment faire face aux délais inévitables ? Par le cache.Bien sûr.
Tout le charme est que vous n'avez pas besoin de mettre en cache l'énorme table entière. Sur le serveur physique vivent des machines virtuelles provenant d'un nombre relativement restreint de VPC. Il n'est nécessaire de mettre en cache que les informations concernant ces VPC. La transmission de données vers d'autres VPC en configuration « par défaut » n'est de toute façon pas légitime. Si une fonctionnalité telle que le VPC-peering est utilisée, des informations sur les VPC correspondants sont ajoutées au cache.
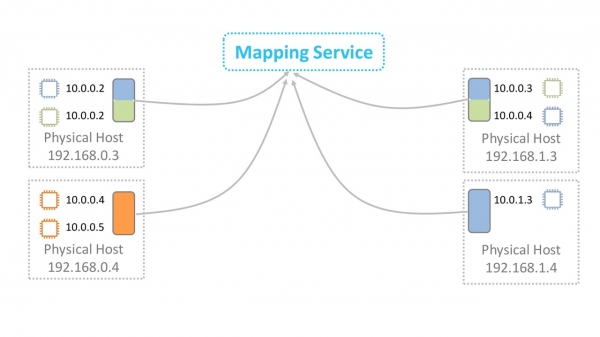
Nous avons compris le transfert de données dans le VPC.
Blackfoot
Que faire dans les cas où le trafic doit être envoyé à l'extérieur, par exemple sur Internet ou via un VPN vers la terre ? Ici, nous sommes sauvés par Blackfoot — un service interne AWS. Il a été développé par notre équipe sud-africaine. C'est pourquoi le service porte le nom d'un pingouin vivant en Afrique du Sud.
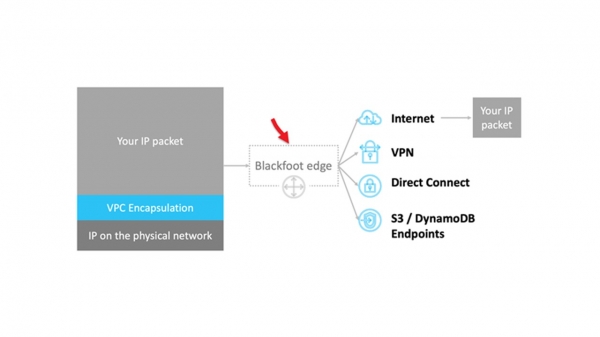
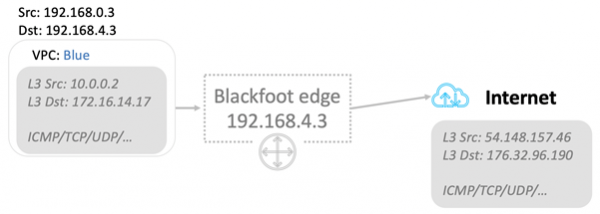
Blackfoot décompresse le trafic et en fait ce qu'il faut. Les données sont envoyées sur Internet telles quelles.
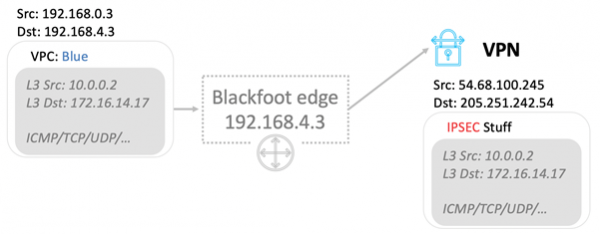
Les données sont décompressées et re-encapsulées dans un emballage IPsec lors de l'utilisation de VPN.
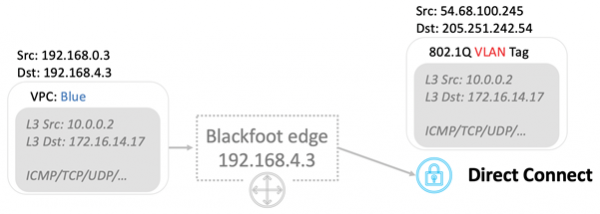
Lors de l'utilisation de Direct Connect, le trafic est étiqueté et transmis dans le VLAN correspondant.
HyperPlane
C'est un service interne de contrôle du flux. De nombreux services réseau nécessitent un contrôle de l'état du flux de données. Par exemple, lors de l'utilisation de NAT, le contrôle du flux doit garantir qu'à chaque paire « IP: port de destination », il correspond un port sortant unique. Dans le cas d'un équilibreur de charge NLB — Network Load Balancer, le flux de données doit toujours être dirigé vers la même machine virtuelle cible. Les Groupes de Sécurité sont un pare-feu avec état. Il surveille le trafic entrant et ouvre implicitement des ports pour le flux sortant de paquets.
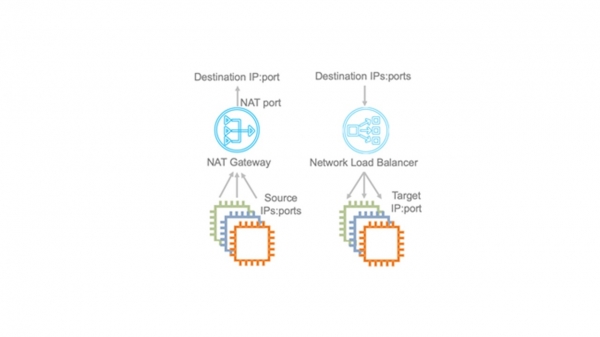
Dans le cloud AWS, les exigences en matière de latence de transmission sont extrêmement élevées. C'est pourquoi HyperPlane est critique pour le bon fonctionnement de l'ensemble du réseau.
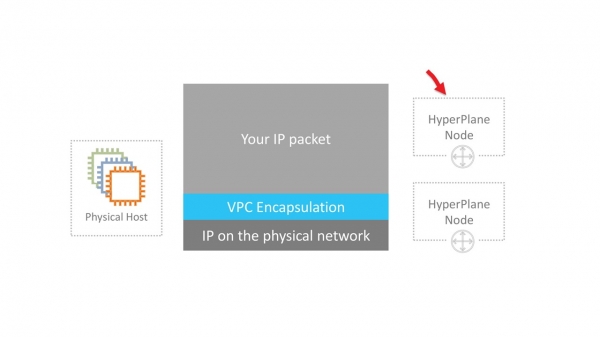
Hyperplane est construit sur des machines virtuelles EC2. Il n'y a pas de magie ici, juste de l'astuce. L'astuce est que ce sont des VM avec une grande RAM. Les opérations sont transactionnelles et se font uniquement en mémoire. Cela permet d'atteindre des latences de quelques dizaines de microsecondes. Travailler avec le disque ruinerait toute performance.
Hyperplane est un système distribué composé d'un grand nombre de machines EC2. Chaque machine virtuelle a une bande passante de 5 Go/s. À l'échelle de l'ensemble du réseau régional, cela offre des téra-octets de bande passante incroyable et permet de traiter des millions de connexions par seconde.
HyperPlane ne fonctionne qu'avec des flux. L'encapsulation de paquets VPC est complètement transparente pour lui. Une éventuelle vulnérabilité dans ce service interne ne permettra pas de briser l'isolement VPC. La sécurité est assurée par les niveaux inférieurs.
Voisin bruyant
Il y a encore un problème de voisin bruyant — voisin bruyant. Supposons que nous ayons 8 nœuds. Ces nœuds traitent les flux de tous les utilisateurs du cloud. Tout semble en ordre et la charge devrait être répartie de manière homogène entre tous les nœuds. Les nœuds sont très puissants et il est difficile de les surcharge.
Mais nous construisons notre architecture en tenant même compte des scénarios peu probables.
Une faible probabilité ne signifie pas impossibilité.
Nous pouvons envisager une situation où un ou plusieurs utilisateurs génèrent une charge trop importante. Toutes les nœuds HyperPlane sont impliquées dans le traitement de cette charge, et d'autres utilisateurs pourraient ressentir une certaine diminution de la performance. Cela détruit le concept de cloud, où les tenants n'ont pas la possibilité d'influencer les autres.
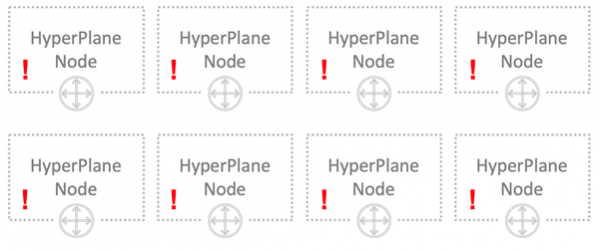
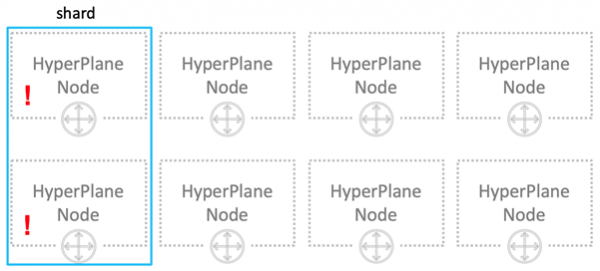
Comment résoudre le problème du voisin bruyant ? La première idée qui vient à l'esprit est le sharding. Nos 8 nœuds sont logiquement divisés en 4 shards de 2 nœuds chacun. Maintenant, le voisin bruyant ne gênera qu’un quart de tous les utilisateurs, mais cela peut être significatif.
Adoptons une approche différente. Allouons uniquement 3 nœuds à chaque utilisateur.
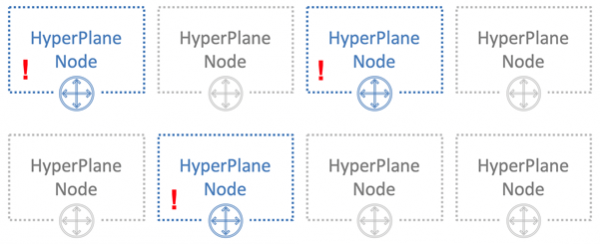
L'astuce consiste à attribuer des nœuds à différents utilisateurs de manière aléatoire. Sur l'image ci-dessous, l'utilisateur bleu partage des nœuds avec l'un des deux autres utilisateurs — le vert et l'orange.
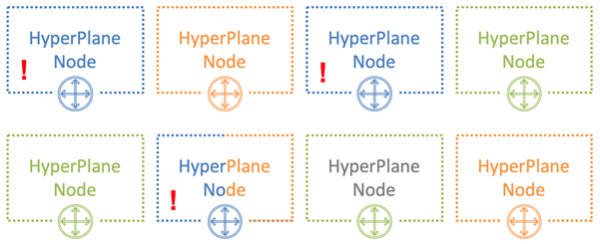
Avec 8 nœuds et 3 utilisateurs, la probabilité de chevauchement du voisin bruyant avec un des utilisateurs est de 54 %. C'est avec cette probabilité que l'utilisateur bleu impactera les autres tenants. Cependant, il ne le fera qu'avec une partie de sa charge. Dans notre exemple, cet impact ne sera pas perceptible pour tout le monde, mais seulement pour un tiers de tous les utilisateurs. C’est déjà un bon résultat.
Le nombre d'utilisateurs qui se chevauchent
La probabilité en pourcentage
0
18%
1
54%
2
26%
3
2%
Rapprochons la situation de la réalité — prenons 100 nœuds et 5 utilisateurs sur 5 nœuds. Dans ce cas, aucune des nœuds ne se chevauchera avec une probabilité de 77%.
Le nombre d'utilisateurs qui se chevauchent
La probabilité en pourcentage
0
77%
1
21%
2
1,8%
3
0,06%
4
0,0006%
5
0,00000013%
Dans une situation réelle avec un grand nombre de nœuds HyperPlane et d'utilisateurs, l'impact potentiel d'un voisin bruyant sur les autres utilisateurs est minimal. Cette méthode s'appelle le sharding aléatoire — shuffle sharding. Elle minimise l'effet négatif du dysfonctionnement de nœuds.
De nombreux services sont construits sur HyperPlane : Network Load Balancer, NAT Gateway, Amazon EFS, AWS PrivateLink, AWS Transit Gateway.
L'échelle du réseau
Parlons maintenant de l'échelle du réseau lui-même. En octobre 2019, AWS propose ses services dans 22 régions, et 9 autres sont prévues.
- Chaque région contient plusieurs zones de disponibilité — Availability Zone. Il y en a au total 69 dans le monde.
- Chaque AZ se compose de Centres de Données. Leur nombre ne dépasse pas 8.
- Dans les centres de données, il y a un nombre énorme de serveurs, certains comptant jusqu'à 300 000.
Maintenant, moyennons tout cela, multiplions-le et nous obtiendrons un chiffre impressionnant qui reflète l'échelle du Cloud Amazon.
Entre les zones de disponibilité et les centres de données, de nombreux canaux optiques sont installés. Dans notre plus grande région, il y a seulement pour la communication entre les AZ et les centres de transit avec d'autres régions 388 canaux. Au total, cela représente un incroyable 5000 Tbits.
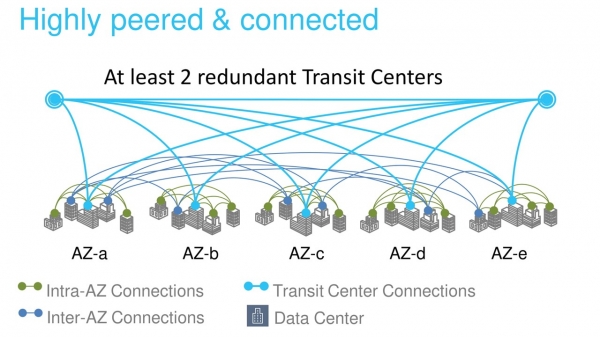
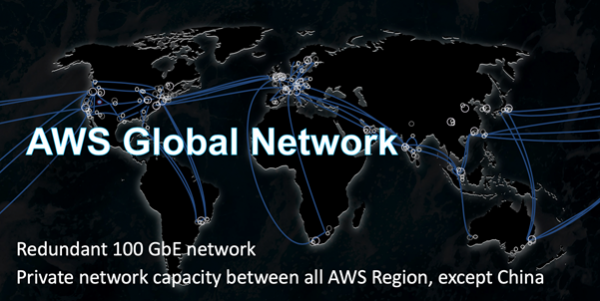
Le backbone AWS est construit spécialement pour le Cloud et optimisé pour y travailler. Nous l'établissons sur des canaux 100 Go/s. Nous les contrôlons entièrement, sauf dans les régions en Chine. Le trafic n'est pas partagé avec les charges d'autres entreprises.
Bien sûr, nous ne sommes pas le seul fournisseur de Cloud avec un réseau backbone privé. De plus en plus de grandes entreprises suivent cette voie. Cela est confirmé par des chercheurs indépendants, par exemple de .
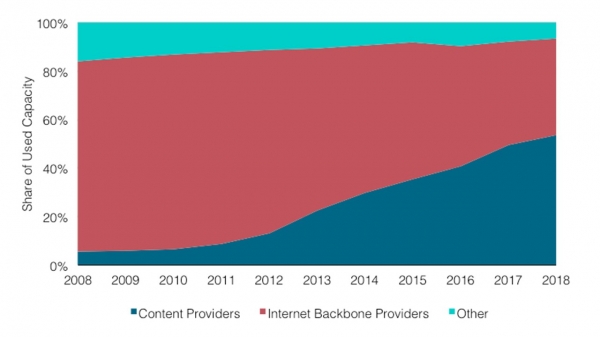
Sur le graphique, on peut voir que la part des fournisseurs de contenu et des fournisseurs de Cloud augmente. En raison de cela, la part du trafic Internet des fournisseurs de backbone diminue constamment.
Je vais expliquer pourquoi cela se produit. Autrefois, la plupart des services web étaient accessibles et consommés directement depuis Internet. Maintenant, de plus en plus de serveurs sont situés dans le Cloud et accessibles via CDN — Content Distribution Network. Pour accéder à la ressource, l'utilisateur passe par Internet jusqu'à la CDN PoP la plus proche — Point de Présence. La plupart du temps, c'est à proximité. Ensuite, il quitte l'Internet public et voyage à travers l'Atlantique par un backbone privé, par exemple, pour arriver directement à la ressource.
Il est intéressant de se demander comment l'Internet évoluera dans 10 ans si cette tendance se maintient.
Canaux physiques
Les scientifiques n'ont pas encore trouvé comment augmenter la vitesse de la lumière dans l'Univers, mais ils ont beaucoup progressé dans les méthodes de transmission à travers la fibre optique. Actuellement, nous utilisons des câbles avec 6912 fibres. Cela aide à optimiser considérablement le coût de leur installation.
Dans certaines régions, nous devons utiliser des câbles spéciaux. Par exemple, dans la région de Sydney, nous utilisons des câbles avec un revêtement spécial contre les termites.
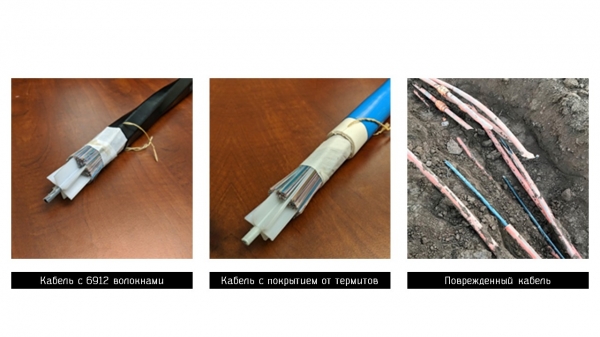
Personne n'est à l'abri des problèmes et parfois nos canaux sont endommagés. Sur la photo à droite, on voit des câbles optiques dans l'une des régions américaines qui ont été coupés par des ouvriers. À la suite de cet incident, seulement 13 paquets de données ont été perdus, ce qui est surprenant. Encore une fois – seulement 13 ! Le système a littéralement basculé instantanément vers les canaux de secours – l'échelle fonctionne.
Nous avons parcouru rapidement certains services et technologies du cloud d'Amazon. J'espère que vous avez au moins une idée de l'ampleur des tâches que nos ingénieurs doivent résoudre. Personnellement, cela m'enthousiasme beaucoup.
C'est la partie finale de la trilogie de Vasily Pantiukhin sur la structure d'AWS. Dans cette partie, il est question de l'optimisation des serveurs et de l'évolutivité des bases de données, tandis que dans l'autre partie, il traite des fonctions serverless et de Firecracker.
Sur En novembre, Vasily Pantiukhin partagera de nouveaux détails sur la structure d'Amazon. Il parlera des causes de défaillance et de la conception de systèmes distribués chez Amazon. Le 24 octobre, vous pouvez encore acheter un billet à un bon prix et payer plus tard. Nous vous attendons à HighLoad++, venez discuter avec nous !
Source : habr.com
