

Bonjour, Habr ! Actuellement, il y a une nouvelle session d'inscription pour le cours sur OTUS. À l'approche du lancement du cours, nous avons traditionnellement préparé pour vous la traduction d'un matériel intéressant.
Chaque jour, plus de cent millions de personnes se rendent sur Twitter pour découvrir ce qui se passe dans le monde et en discuter. Chaque tweet et toute autre action de l'utilisateur génèrent un événement accessible pour l'analyse interne des données sur Twitter. Des centaines d'employés analysent et visualisent ces données, et améliorer leur expérience est la priorité principale pour l'équipe de la plateforme de données de Twitter.
Nous pensons que les utilisateurs ayant une large gamme de compétences techniques doivent pouvoir trouver des données et avoir accès à de bons outils d'analyse et de visualisation basés sur SQL. Cela permettrait à un tout nouveau groupe d'utilisateurs moins techniques, y compris les analystes de données et les chefs de produit, d'extraire des informations des données, leur permettant de mieux comprendre et utiliser les opportunités offertes par Twitter. Ainsi, nous démocratisons l'analyse des données sur Twitter.
À mesure que nos outils et capacités d'analyse interne des données s'améliorent, nous avons été témoins d'une amélioration du service Twitter. Cependant, il y a encore du chemin à parcourir. Les outils actuels, tels que Scalding, nécessitent des compétences en programmation. Les outils d'analyse basés sur SQL, tels que Presto et Vertica, rencontrent des problèmes de performance à grande échelle. Nous avons également un problème de diffusion des données entre plusieurs systèmes sans accès permanent à celles-ci.
L'année dernière, nous avons annoncé , dans le cadre de laquelle nous transférons une partie de notre sur Google Cloud Platform (GCP). Nous en sommes venus à la conclusion que les outils Google Cloud peuvent nous aider dans nos initiatives de démocratisation de l'analyse, de la visualisation et de l'apprentissage automatique sur Twitter :
- : un entrepôt de données d'entreprise avec un moteur SQL basé sur , qui est réputé pour sa rapidité, sa simplicité et qui gère .
- un outil de visualisation de grandes données avec des fonctionnalités de collaboration, comme dans Google Docs.
Dans cet article, vous découvrirez notre expérience avec ces outils : ce que nous avons fait, ce que nous avons appris et ce que nous ferons ensuite. Nous nous concentrerons maintenant sur l'analyse par lots et interactive. L'analyse en temps réel sera abordée dans le prochain article.
L'histoire des entrepôts de données sur Twitter
Avant d'approfondir BigQuery, il vaut la peine de résumer brièvement l'histoire des entrepôts de données chez Twitter. En 2011, l'analyse des données chez Twitter était réalisée avec Vertica et Hadoop. Pour créer des travaux MapReduce sous Hadoop, nous utilisions Pig. En 2012, nous avons remplacé Pig par Scalding, qui offrait une API Scala avec des avantages tels que la possibilité de créer des pipelines complexes et la simplicité des tests. Cependant, pour de nombreux analystes de données et chefs de produit, qui se sentaient plus à l'aise avec SQL, la courbe d'apprentissage était assez escarpée. Environ en 2016, nous avons commencé à utiliser Presto comme interface SQL pour les données Hadoop. Spark offrait une interface Python, ce qui en faisait un bon choix pour les recherches ad hoc et l'apprentissage automatique.
Depuis 2018, nous avons utilisé les outils suivants pour l'analyse et la visualisation des données :
- Scalding pour les pipelines de production
- Scalding et Spark pour l'analyse ad hoc des données et l'apprentissage automatique
- Vertica et Presto pour l'analyse SQL ad hoc et interactive
- Druid pour l'interaction légère, la recherche et l'accès à faible latence aux métriques de séries temporelles
- Tableau, Zeppelin et Pivot pour la visualisation des données
Nous avons découvert que, bien que ces outils offrent des fonctionnalités très puissantes, nous rencontrions des difficultés à rendre ces capacités accessibles à un public plus large au sein de Twitter. En élargissant notre plateforme avec Google Cloud, nous nous concentrons sur la simplification de nos outils d'analyse pour l'ensemble de Twitter.
L'entrepôt de données BigQuery de Google
Plusieurs équipes chez Twitter ont déjà intégré BigQuery dans certains de leurs pipelines de production. En utilisant leur expérience, nous avons commencé à évaluer les possibilités de BigQuery pour tous les cas d'utilisation de Twitter. Notre objectif était d'offrir BigQuery à l'ensemble de l'entreprise, ainsi que de le standardiser et de le soutenir dans le cadre de l'ensemble des outils de la plateforme de données. Cela s'est avéré difficile pour de nombreuses raisons. Nous devions développer une infrastructure pour recevoir de manière fiable de grands volumes de données, prendre en charge la gestion des données à l'échelle de l'entreprise, garantir un contrôle d'accès approprié et assurer la confidentialité des clients. Nous avons également dû créer des systèmes pour la répartition des ressources, la surveillance et la facturation, afin que les équipes puissent utiliser efficacement BigQuery.
En novembre 2018, nous avons lancé la version alpha de BigQuery et Data Studio pour toute l'entreprise. Nous avons proposé à nos employés Twitter certains de nos tableaux les plus fréquemment utilisés, contenant des données personnelles anonymisées. Plus de 250 utilisateurs de différentes équipes, y compris celles de l'ingénierie, des finances et du marketing, ont utilisé BigQuery. Plus récemment, ils ont effectué environ 8 000 requêtes, traitant environ 100 Po de données par mois, sans compter les requêtes planifiées. Après avoir reçu des retours très positifs, nous avons décidé d'aller de l'avant et de proposer BigQuery comme ressource principale pour l'interaction avec les données chez Twitter.
Voici un schéma de l'architecture de haut niveau de notre entrepôt de données Google BigQuery.
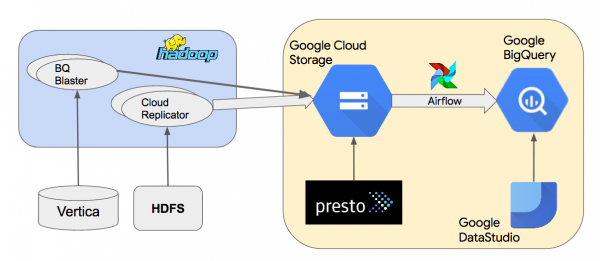
Nous copions des données depuis des clusters Hadoop locaux vers Google Cloud Storage (GCS) en utilisant notre outil interne Cloud Replicator. Nous utilisons ensuite Apache Airflow pour créer des pipelines qui utilisent «» pour charger des données depuis GCS vers BigQuery. Nous utilisons Presto pour interroger des ensembles de données Parquet ou Thrift-LZO dans GCS. BQ Blaster est un outil interne de Scalding pour charger des ensembles de données HDFS Vertica et Thrift-LZO dans BigQuery.
Dans les sections suivantes, nous discuterons de notre approche et de nos connaissances en matière de facilité d'utilisation, de performance, de gestion des données, de disponibilité du système et de coût.
Simplicité d'utilisation
Nous avons constaté qu'il était facile pour les utilisateurs de commencer avec BigQuery, car il ne nécessitait pas d'installation de logiciel et les utilisateurs pouvaient y accéder via une interface web intuitive. Cependant, les utilisateurs devaient se familiariser avec certaines fonctionnalités de GCP et ses concepts, y compris des ressources telles que les projets, les ensembles de données et les tables. Nous avons développé des supports de formation et des tutoriels pour aider les utilisateurs à démarrer. Avec une compréhension de base acquise, les utilisateurs ont trouvé facile de naviguer dans les ensembles de données, d'examiner le schéma et les données des tables, d'exécuter des requêtes simples et de visualiser les résultats dans Data Studio.
Notre objectif concernant l'importation de données dans BigQuery était de permettre le chargement fluide d'ensembles de données HDFS ou GCS en un clic. Nous avons envisagé (Airflow géré), mais nous n'avons pas pu l'utiliser en raison de notre modèle de sécurité «Partage Restreint au Domaine» (plus de détails dans la section «Gestion des données» ci-dessous). Nous avons expérimenté l'utilisation de Google Data Transfer Service (DTS) pour organiser des tâches de charge dans BigQuery. Bien que DTS soit rapide à configurer, il n'était pas flexible pour construire des pipelines avec des dépendances. Pour notre version alpha, nous avons créé notre propre environnement Apache Airflow dans GCE et nous le préparons à être opérationnel en production et capable de prendre en charge davantage de sources de données, comme Vertica.
Pour transformer des données dans BigQuery, les utilisateurs créent de simples pipelines de données SQL, en utilisant des requêtes planifiées. Pour des pipelines complexes avec des dépendances, nous prévoyons d'utiliser soit notre propre infrastructure Airflow, soit Cloud Composer avec .
Performance
BigQuery est conçu pour des requêtes SQL générales qui traitent de grands volumes de données. Il n'est pas destiné à des requêtes à faible latence, à haute bande passante, nécessaires pour une base de données transactionnelle, ou pour l'analyse de séries temporelles à faible latence, réalisée par . Pour des requêtes d'analyse interactive, nos utilisateurs s'attendent à un temps de réponse de moins d'une minute. Nous devions concevoir l'utilisation de BigQuery de manière à satisfaire ces attentes. Pour garantir des performances prévisibles pour nos utilisateurs, nous avons utilisé les fonctionnalités de BigQuery disponibles pour les clients sur un paiement fixe, qui permettent aux propriétaires de projets de réserver des slots minimum pour leurs requêtes. BigQuery est une unité de puissance de calcul nécessaire pour l'exécution de requêtes SQL.
Nous avons analysé plus de 800 requêtes traitant environ 1 To de données chacune et avons constaté que le temps d'exécution moyen était de 30 secondes. Nous avons également découvert que la performance dépendait fortement de l'utilisation de notre créneau dans divers projets et tâches. Nous devions clairement différencier nos réserves de créneaux de production et ad hoc pour maintenir la performance dans les scénarios d'utilisation en production et l'analyse interactive. Cela a eu un impact important sur notre conception de la réservation de créneaux et de la hiérarchie des projets.
Nous aborderons la gestion des données, les fonctionnalités et les coûts des systèmes dans les prochains jours lors de la deuxième partie de la traduction, mais pour l'instant, nous invitons tous les intéressés à participer à , au cours duquel vous pourrez en apprendre davantage sur le cours et poser des questions à notre expert — Egor Mateshuk (Senior Data Engineer, MaximaTelecom).
Lire aussi :
Source : habr.com
