

Salut, Habr !
Aujourd'hui, je souhaite parler de notre expérience d'automatisation de la sauvegarde des grandes quantités de données dans Nextcloud, sous différentes configurations. Je travaille comme CTO chez « Молния АК », où nous nous occupons de la gestion de configuration des systèmes IT, utilisant Nextcloud pour le stockage des données. Cela inclut également des structures distribuées avec sauvegarde.
Les problèmes découlant des spécificités des installations résident dans le fait qu'il y a beaucoup de données. Le versionnage que fournit Nextcloud, la sauvegarde, des raisons subjectives et d'autres facteurs créent de nombreux doublons.
Contexte
Lors de l'administration de Nextcloud, se pose la problématique de l'organisation d'une sauvegarde efficace, qui doit absolument être chiffrée car les données sont précieuses.
Nous proposons des options de stockage des sauvegardes chez nous ou chez le client sur des machines séparées de Nextcloud, nécessitant une approche automatisée flexible en matière d'administration.
Il y a beaucoup de clients, chacun ayant des configurations différentes, chacun sur leurs propres infrastructures et avec leurs propres spécificités. Ici, la méthode standard où l'ensemble de l'infrastructure vous appartient, et où les sauvegardes sont faites via cron, ne s'applique pas bien.
Pour commencer, examinons les données d'entrée. Nous avons besoin de :
- Scalabilité en termes d'une ou plusieurs nœuds. Pour des installations importantes, nous utilisons minio comme stockage.
- Être informé des problèmes liés aux exécutions de sauvegarde.
- Il est nécessaire de stocker la sauvegarde chez les clients et/ou chez nous.
- Résoudre rapidement et facilement les problèmes.
- Les clients et les installations diffèrent grandement les uns des autres - il est impossible d'atteindre l'uniformité.
- La vitesse de restauration doit être minimale selon deux scénarios : restauration complète (désastre) et une seule dossier - supprimée par erreur.
- La fonction de déduplication est obligatoire.
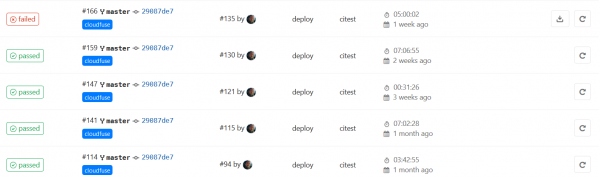
Pour résoudre la gestion des sauvegardes, nous avons intégré GitLab. Plus de détails dans la suite.
Bien sûr, nous ne sommes pas les premiers à résoudre une telle tâche, mais nous pensons que notre expérience pratique éprouvée pourrait être intéressante et nous sommes prêts à la partager.
Étant donné que dans notre entreprise, la politique est open source, nous avons cherché une solution avec un code source ouvert. En retour, nous partageons nos développements et les publions. Par exemple, sur GitHub, il y a , que nous installons chez nos clients, renforçant la protection des données en cas de suppression accidentelle ou intentionnelle.
Outils de sauvegarde
Nous avons commencé notre recherche de méthodes de solution en choisissant un outil de sauvegarde.
Le tar + gzip traditionnel fonctionne mal - les données sont dupliquées. En réalité, l'incrément contient souvent très peu de modifications, et une grande partie des données au sein d'un même fichier se répète.
Il y a aussi un autre problème - la redondance du stockage de données distribué. Nous utilisons MinIO et ses données sont fondamentalement redondantes. Soit il fallait faire une sauvegarde via MinIO lui-même - ce qui le chargerait et utiliserait tous les intermédiaires entre le système de fichiers, et ce qui n'est pas moins important, il existe un risque d'oublier une partie des buckets et des métadonnées. Soit utiliser la déduplication.
Il existe des outils de sauvegarde avec déduplication en open source (sur Habr, il y avait ) et nos finalistes sont et . Nous parlerons ci-dessous de notre comparaison entre les deux applications, mais d'abord, nous allons expliquer comment nous avons organisé tout le système.
Gestion de la création de sauvegardes
Borg et Restic sont bons, mais aucun des deux produits n'a de mécanisme de gestion centralisé. Pour la gestion et le contrôle, nous avons choisi un outil qui est déjà implanté chez nous, sans lequel nous ne pouvons imaginer notre travail, y compris l'automatisation - il s'agit du célèbre CI/CD - GitLab.
L'idée est la suivante : un gitlab-runner est installé sur chaque nœud stockant des données Nextcloud. Le runner exécute selon un calendrier un script surveillant le processus de sauvegarde, et celui-ci lance Borg ou Restic.
Qu'avons-nous obtenu ? Un retour d'information sur l'exécution, un contrôle facile des changements, et des détails en cas d'erreur.
Voici nous avons mis des exemples de script pour différentes tâches, et nous l'avons finalement intégré à la sauvegarde non seulement de Nextcloud, mais aussi de nombreux autres services. Un planificateur y est également inclus, si vous ne voulez pas le configurer manuellement (et nous ne voulons pas), ainsi que le .gitlab-ci.yml
Dans l'API de GitLab, il n'est pas encore possible de changer le timeout CI/CD, et il est assez court. Il doit être augmenté, disons à 1d.
Heureusement, GitLab sait lancer non seulement au moment du commit, mais aussi selon un calendrier, c'est exactement ce dont nous avons besoin.
Maintenant, concernant le script d-wrapper.
Nous avons imposé les conditions suivantes pour ce script :
- Il doit être exécuté à la fois par un runner et manuellement depuis la console, avec les mêmes fonctionnalités.
- Des gestionnaires d'erreurs doivent obligatoirement être présents :
- code de retour.
- recherche de chaîne dans le journal. Par exemple, pour nous, un message qui n'est pas considéré comme critique par le programme peut être une erreur.
- Gestion du timeout. La durée d'exécution doit être raisonnable.
- Nous avons besoin d'un journal détaillé. Mais seulement en cas d'erreur.
- Une série de tests est également effectuée avant le début.
- Quelques petits avantages pour le confort que nous avons trouvés utiles pendant le support :
- Le démarrage et la fin sont enregistrés dans le journal système de la machine locale. Cela aide à relier les erreurs système au fonctionnement de la sauvegarde.
- Une partie du journal d'erreurs, lorsqu'il y en a, est affichée dans stdout, tout le journal est écrit dans un fichier séparé. Il est pratique de jeter un œil dans CI et d'évaluer l'erreur si elle est triviale.
- Modes pour le débogage.
Le journal complet est sauvegardé en tant qu'artéfact dans GitLab, s'il n'y a pas d'erreurs, alors le journal est supprimé. Le script est écrit en bash.
Nous serons ravis d'examiner toute proposition ou commentaire concernant l'open source - bienvenue.
Comment cela fonctionne
Un runner avec un exécuteur bash est lancé sur le nœud à sauvegarder. Un job CI/CD est lancé dans un dépôt spécial selon le planificateur. Le runner exécute un script enveloppe universelle pour de telles tâches, où des vérifications de la validité du dépôt de sauvegarde, des points de montage et de tout ce que nous voulons sont effectuées, puis la sauvegarde est exécutée et la suppression des anciennes est faite. La sauvegarde prête est envoyée sur S3.
Nous travaillons selon ce schéma - c'est un fournisseur externe AWS ou un analogue russe (c'est plus rapide et les données ne quittent pas la Russie). Ou nous installons un cluster minio séparé sur le site du client pour ces objectifs. C'est généralement fait pour des raisons de sécurité, lorsque le client ne veut pas du tout que les données quittent son périmètre.
Nous n'avons pas utilisé la fonction d'envoi de la sauvegarde par ssh. Cela n'ajoute pas de sécurité, et les capacités réseau du fournisseur S3 sont bien supérieures à celles de notre seule machine ssh.
Pour se protéger contre un hacker sur la machine locale - car il peut effacer des données sur S3, il est impératif d'activer le versionnage.
Le sauvegardeur chiffre toujours la sauvegarde.
Borg a un mode sans chiffrement aucun, mais nous ne recommandons absolument pas de l'activer. Dans ce mode, il n'y a non seulement pas de chiffrement, mais la somme de contrôle de ce qui est enregistré n'est pas calculée, donc l'intégrité ne peut être vérifiée qu'indirectement, par les index.
Un vérificateur distinct teste l'intégrité des sauvegardes concernant les index et le contenu. La vérification est lente et prend du temps, c'est pourquoi nous la lançons séparément une fois par mois. Cela peut durer plusieurs jours.
Readme en russe
Fonctions principales
preparepréparationtestcheckvérification de la préparationmaincommandcommande principaleforcepostscriptune fonction qui s'exécute à la fin ou en cas d'erreur. Utilisé pour démonter la partition.
Fonctions de service
cleanupnous enregistrons les erreurs ou supprimons le fichier journal.checklognous analysons le journal pour détecter la présence d'une chaîne d'erreur., et la valeur de retour est prise dans la constantegestionnaire de sortie.checktimeoutvérification du délai d'attente.
Environnement
VERBOSE=1nous affichons immédiatement les erreurs à l'écran (stdout).SAVELOGSONSUCCES=1nous sauvegardons le journal en cas de succès.INIT_REPO_IF_NOT_EXIST=1Nous créons le dépôt s'il n'existe pas. Par défaut désactivé.TIMEOUTtemps maximal pour l'opération principale. Vous pouvez le spécifier en ajoutant ‘m’, ‘h’ ou ‘d’ à la fin.
Mode de conservation des anciennes copies. Par défaut :
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Variables à l'intérieur du script
ERROR_STRING— chaîne à vérifier dans le journal pour une erreur.EXTRACT_ERROR_STRING— expression à montrer en cas d'erreur.KILL_TIMEOUT_SIGNAL— signal pour tuer si délai dépassé.TAIL— combien de chaînes avec des erreurs à afficher à l'écran.COLORMSG— couleur du message (jaune par défaut).
Ce script, connu sous le nom de wordpress, a pour caractéristique d'effectuer également des sauvegardes de la base mysql. Cela signifie qu'il peut être utilisé pour des installations à usage unique de Nexcloud, où il est possible de sauvegarder la base en même temps. L'avantage réside non seulement dans le fait que tout se trouve au même endroit, mais aussi que le contenu de la base est proche du contenu des fichiers, car la différence de temps est minimale.
Restic vs Borg
Les comparaisons entre Borg et Restic se trouvent également , et nous n'avions pas pour objectif de créer simplement une autre comparaison, mais la nôtre. Il était important pour nous de voir comment cela s'applique à nos données, avec notre spécificité. Nous les fournissons.
Nos critères de sélection, en plus de ceux déjà mentionnés (déduplication, restauration rapide, etc.) :
- Résistance au travail non terminé. Vérification sur kill -9.
- Taille sur le disque.
- Exigences en ressources (CPU, mémoire).
- Taille des blobs stockés.
- Travail avec S3.
- Vérification d'intégrité.
Pour les tests, nous avons pris un client avec des données réelles et une taille totale de 1,6 To.
Conditions.
Borg ne peut pas travailler directement avec S3, et nous avons monté un disque comme un fuse via . Restic envoyait directement vers S3.
Goofys fonctionne très rapidement et bien, et il dispose de , ce qui accélère encore le processus. Il est en phase beta, et, il faut l'admettre, nous avons eu des pannes avec perte de données lors des tests (d'autres). Mais l'avantage est que la procédure de sauvegarde ne nécessite pas beaucoup de lectures, mais principalement des écritures, donc nous n'utilisons le cache que lors de la vérification d'intégrité.
Pour réduire l'impact du réseau, nous avons utilisé un fournisseur local — Yandex Cloud.
Résultats des tests de comparaison.
- Kill -9 avec un redémarrage ultérieur, les deux ont réussi.
- Taille sur le disque. Borg sait compresser donc les résultats sont attendus.
Sauvegarde
Taille
Borg
562Go
Restic
628Go
- Concernant le CPU
Borg utilise peu de ressources par lui-même, avec la compression par défaut, mais il faut évaluer cela en conjonction avec le processus goofys. En somme, ils sont comparables et utilisent environ 1,2 cœur sur la même machine virtuelle de test. - Mémoire. Restic utilise environ 0,5 Go, Borg environ 200 Mo. Mais cela reste insignifiant comparé au cache de fichiers du système. Donc, il est préférable de prévoir plus de mémoire.
- La différence de taille des blobs s'est avérée frappante.
Sauvegarde
Taille
Borg
environ 500Mo
Restic
environ 5Mo
- Le travail avec S3 de Restic est excellent. Le travail de Borg via goofys ne pose pas de problèmes, mais il a été remarqué qu'il est conseillé de faire umount après la sauvegarde pour vider complètement le cache. Une particularité du travail avec S3 est que les chunks non téléchargés ne seront jamais envoyés dans le bucket, ce qui signifie que des données non entièrement téléchargées entraînent de grands dommages.
- La vérification d'intégrité fonctionne bien dans les deux cas, mais la vitesse diffère considérablement.
Restic – 3,5 heures.
Borg, avec un cache de fichiers de 100 Go SSD – 5 heures. Un résultat de vitesse à peu près équivalent si les données sont sur un disque local.
Borg lit directement depuis S3 sans cache 33 heures. Terriblement long.
En résumé, Borg sait compresser et a de plus grands blobs — ce qui rend le stockage et les opérations GET/PUT dans S3 moins coûteux. Mais cela implique une vérification plus complexe et plus lente. En ce qui concerne la vitesse de restauration — nous n'avons remarqué aucune différence. Les sauvegardes ultérieures (après la première) que fait Restic prennent un peu plus de temps, mais pas de manière significative.
La taille de la communauté n'était pas en dernier lieu dans notre choix.
Et nous avons choisi Borg.
Quelques mots sur la compression
Borg dispose d'un excellent nouvel algorithme de compression — zstd. En termes de qualité de compression, il n'est pas inférieur à gzip, mais il est beaucoup plus rapide. Et il est comparable en rapidité à l'algorithme par défaut lz4.
Par exemple, un dump de base de données MySQL se compresse deux fois mieux que lz4 à la même vitesse. Cependant, l'expérience avec des données réelles montre qu'il y a une très petite différence dans le taux de compression des nœuds Nextcloud.
Borg propose en fait un mode de compression bonus — si un fichier a une grande entropie, alors la compression n'est pas appliquée, ce qui augmente la vitesse de fonctionnement. Cela s'active avec une option lors de la création
-C auto,zstd
pour l'algorithme zstd
Eh bien, avec cette option, par rapport à la compression par défaut, nous avons obtenu
560 Go et 562 Go respectivement. Les données de l'exemple ci-dessus, je le rappelle, sans compression, donnent un résultat de 628 Go. Le résultat avec 2 Go d'écart nous a quelque peu surpris, mais nous avons décidé de choisir finalement. auto,zstd.
Méthode de vérification de la sauvegarde
La machine virtuelle est lancée directement chez le fournisseur ou chez le client via le planificateur, ce qui réduit considérablement la charge réseau. Au moins, cela coûte moins cher que de le faire chez soi et de transférer le trafic.
goofys --cache "--free:5%:\/mnt\/cache" -o allow_other --endpoint https:\/\/storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com \/mnt\/goofys
export BORG_PASSCOMMAND="cat \/home\/borg\/.borg-passphrase"
borg list \/mnt\/goofys\/borg1\/\nborg check --debug -p --verify-data \/mnt\/goofys\/borg1\/
Nous vérifions également les fichiers avec un antivirus (a posteriori) selon le même schéma. En effet, les utilisateurs téléchargent diverses choses dans Nextcloud et tous n'ont pas d'antivirus. Effectuer la vérification au moment de l'upload prend trop de temps et nuit aux affaires.
L'évolutivité est atteinte par le lancement de runners sur différentes nœuds avec des tags variés.
Dans notre monitoring, nous collectons les états de sauvegarde via l'API GitLab dans une seule fenêtre, et en cas de problème, ceux-ci sont facilement remarquables et tout aussi facilement localisables.
Conclusion
En fin de compte, nous savons exactement que nous faisons des sauvegardes, que nos sauvegardes sont valides, et que les problèmes qui surviennent avec elles prennent peu de temps et sont résolus par l'administrateur de service. Les sauvegardes occupent réellement peu d'espace par rapport à tar.gz ou Bacula.
Source : habr.com
