

Dans cet article, nous expliquerons comment et pourquoi nous avons développé – un mécanisme qui transmet des informations entre les applications clientes et les serveurs 1C:Enterprise – allant de la formulation de la tâche à la conception de l'architecture et des détails de mise en œuvre.
Le Système d'Interaction (ci-après – SI) – est un système de messagerie distribué et tolérant aux pannes avec une livraison garantie. Le SI est conçu comme un service à forte charge avec une grande évolutivité, disponible à la fois en tant que service en ligne (proposé par la société 1C) et en tant que produit sous licence, qui peut être déployé sur ses propres serveurs.
Le SI utilise un stockage distribué et un système de recherche . Nous parlerons également de Java et de la manière dont nous étendons horizontalement PostgreSQL.
Définition du problème
Pour comprendre pourquoi nous avons créé le Système d'Interaction, je vais vous expliquer un peu comment se déroule le développement d'applications commerciales chez 1C.
Pour commencer – un peu sur nous pour ceux qui ne savent pas encore ce que nous faisons :) Nous développons la plateforme technologique «1C:Enterprise». Cette plateforme comprend un outil de développement d'applications commerciales ainsi qu'un runtime, permettant aux applications commerciales de fonctionner dans un environnement multi-plateforme.
La paradigme client-serveur de développement
Les applications commerciales créées sur «1C:Enterprise» fonctionnent dans une architecture à trois niveaux «SGBD – serveur d'applications – client». Le code applicatif, écrit en , peut s'exécuter sur le serveur d'applications ou sur le client. Tout le travail avec les objets applicatifs (référentiels, documents, etc.), ainsi que la lecture et l'écriture de la base de données, s'effectuent uniquement sur le serveur. La fonctionnalité des formulaires et de l'interface utilisateur est également réalisée sur le serveur. Sur le client, les tâches consistent à recevoir, ouvrir et afficher les formulaires, à interagir avec l'utilisateur (avertissements, questions…), à effectuer des calculs mineurs dans les formulaires nécessitant une réaction rapide (par exemple, multiplication du prix par la quantité), à travailler avec des fichiers locaux et à interagir avec le matériel.
Dans le code applicatif, les en-têtes des procédures et fonctions doivent explicitement indiquer où le code sera exécuté – en utilisant les directives &SurClient / &SurServeur (&AtClient / &AtServer dans la version anglaise du langage). Les développeurs sur 1C vont maintenant me corriger en disant que les directives en réalité , mais cela n'est pas essentiel pour nous actuellement.
Il est possible d'appeler du code serveur depuis le code client, mais l'inverse n'est pas vrai. C'est une limitation fondamentale que nous avons mise en place pour plusieurs raisons. En particulier, le code serveur doit être écrit de manière à s'exécuter de la même façon, qu'il soit appelé depuis le client ou le serveur. Dans le cas d'un appel de code serveur par un autre code serveur, le client n'existe pas en tant que tel. De plus, au cours de l'exécution du code serveur, le client ayant lancé cet appel pourrait se fermer ou quitter l'application, laissant le serveur sans appel.

Le code qui gère le clic sur le bouton : appeler une procédure serveur depuis le client fonctionnera, mais appeler une procédure client depuis le serveur ne fonctionnera pas.
Cela signifie que si nous voulons envoyer un message depuis le serveur vers l'application cliente, par exemple, pour indiquer que la génération d'un rapport « long » est terminée et que le rapport peut être consulté, nous n'avons pas de moyen de le faire. Nous devons recourir à des détours, comme interroger le serveur périodiquement depuis le code client. Mais cette approche surcharger le système avec des appels inutiles et ne paraît pas très élégante.
Il y a aussi la nécessité, par exemple, d'informer l'application cliente lors de la réception d'un appel téléphonique pour que celle-ci puisse trouver dans sa base de données le contact correspondant au numéro de l'appelant et afficher des informations sur ce dernier. Ou, par exemple, lorsqu'une commande arrive à l'entrepôt, notifier l'application cliente de l'acheteur. En somme, de nombreux cas où un tel mécanisme serait utile.
La problématique en soi
Créer un mécanisme d'échange de messages. Rapide, fiable, avec une garantie de livraison, et une possibilité de recherche flexible des messages. Sur la base de ce mécanisme, mettre en œuvre un messager (messages, appels vidéo), fonctionnant à l'intérieur des applications 1C.
Concevoir un système horizontalement évolutif. L'augmentation de charge doit être compensée par une augmentation du nombre de nœuds.
Mise en œuvre
Nous avons décidé de ne pas intégrer la partie serveur de la SV directement dans la plateforme 1C:Enterprise, mais de la réaliser en tant que produit distinct, dont l'API peut être appelée à partir du code des solutions applicatives 1C. Cela a été fait pour plusieurs raisons, la principale étant de permettre l'échange de messages entre différentes applications 1C (par exemple, entre la Gestion Commerciale et la Comptabilité). Différentes applications 1C peuvent fonctionner sur différentes versions de la plateforme 1C:Enterprise, être sur différents serveurs, etc. Dans ces conditions, la mise en œuvre de la SV en tant que produit distinct, situé « à côté » des installations 1C, constitue la solution optimale.
Ainsi, nous avons décidé de développer la SV comme un produit séparé. Pour les petites entreprises, nous recommandons d'utiliser le serveur SV que nous avons installé dans notre cloud (wss://1cdialog.com) afin d'éviter les coûts liés à l'installation locale et à la configuration du serveur. Les grands clients, en revanche, peuvent juger utile d'installer leur propre serveur SV sur leurs propres infrastructures. Une approche similaire a été utilisée dans notre produit SaaS cloud. – il est publié en tant que produit standard pour installation chez les clients, et est également déployé dans notre cloud. .
L'application
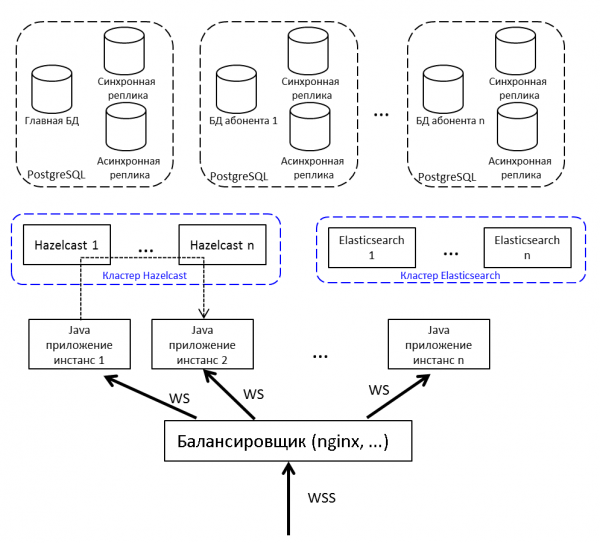
Pour la répartition de la charge et la résistance aux pannes, nous déploierons plusieurs applications Java plutôt qu'une seule, et nous placerons un équilibrateur de charge devant elles. Si un message doit être transmis d'un nœud à un autre, nous utiliserons le publish/subscribe dans Hazelcast.
La communication entre le client et le serveur se fait par websocket. Ce dernier est bien adapté aux systèmes en temps réel.
Cache distribué
Nous avons hésité entre Redis, Hazelcast et Ehcache. Nous sommes en 2015. Redis vient juste de sortir un nouveau cluster (trop nouveau, trop effrayant), il y a Sentinel avec de nombreuses limitations. Ehcache ne peut pas être configuré en cluster (cette fonctionnalité est apparue plus tard). Nous avons décidé d'essayer avec Hazelcast 3.4.
Hazelcast se regroupe en cluster « out of the box ». En mode à un seul nœud, il n'est pas très utile et ne peut servir que de cache – il ne peut pas écrire des données sur disque, si vous perdez le seul nœud, vous perdez les données. Nous déployons plusieurs instances de Hazelcast, entre lesquelles nous sauvegardons les données critiques. Nous ne sauvegardons pas le cache – cela ne vaut pas la peine.
Pour nous, Hazelcast, c'est :
- Un stockage des sessions utilisateur. Aller chercher chaque fois la session dans la base de données prend du temps, donc nous stockons toutes les sessions dans Hazelcast.
- Cache. Si vous cherchez un profil utilisateur, vérifiez dans le cache. Si vous avez écrit un nouveau message, mettez-le dans le cache.
- Sujets de communication d'instances d'application. Le nœud génère un événement et le place dans le sujet Hazelcast. Les autres nœuds de l'application, abonnés à ce sujet, reçoivent et traitent l'événement.
- Verrous cluster. Par exemple, créons une discussion en utilisant une clé unique (discussion singleton dans le cadre de la base 1C) :
conversationKeyChecker.check("BENCOLONNE");

      doInClusterLock("BENCOLONNE", () -> {

          conversationKeyChecker.check("BENCOLONNE");

          createChannel("BENCOLONNE");
      });
Nous avons vérifié qu'il n'y avait pas de canal. Nous avons pris le verrou, vérifié à nouveau, créé. Si après avoir pris le verrou, nous ne vérifions pas, il y a un risque qu'un autre thread vérifie également et essaie de créer la même discussion - alors qu'elle existe déjà. Il est impossible de faire le verrouillage par synchronized ou par un verrou Java ordinaire. Par la base de données, c'est lent, et il est dommage d'utiliser la base, via Hazelcast - c'est ce qu'il faut.
Choisissons le SGBD
Nous avons une grande expérience réussie avec PostgreSQL et une collaboration avec les développeurs de ce SGBD.
Il est difficile de travailler avec un cluster PostgreSQL - il existe , , , mais en général, ce n'est pas du noSQL, qui se scale de manière native. Nous n'avons pas envisagé NoSQL comme solution de stockage principale, Hazelcast étant suffisant, surtout que nous n'avions jamais travaillé avec auparavant.
Puisqu'il faut faire évoluer une base de données relationnelle - cela signifie, . Comme vous le savez, avec le sharding, nous divisons la base de données en parties distinctes de sorte qu chacune d'elles puisse être placée sur un serveur séparé.
La première version de notre sharding prévoyait de répartir chaque table de notre application sur différents serveurs dans différentes proportions. Beaucoup de messages sur le serveur A ? Bien, déplaçons une partie de cette table sur le serveur B. Cette solution était clairement une optimisation prématurée, donc nous avons décidé de nous en tenir à une approche multi-tenant.
Vous pouvez en lire davantage sur le multi-tenant, par exemple, sur le site .
Dans SV, il y a les concepts d'application et d'abonné. Une application est une installation spécifique d'une application métier, par exemple, ERP ou Comptabilité, avec ses utilisateurs et ses données métier. Un abonné est une organisation ou une personne physique au nom de laquelle l'application est enregistrée sur le serveur SV. Un abonné peut avoir plusieurs applications enregistrées, et ces applications peuvent échanger des messages entre elles. L'abonné est devenu un locataire dans notre système. Les messages de plusieurs abonnés peuvent se trouver dans une seule base de données physique ; si nous constatons qu'un abonné génère beaucoup de trafic, nous le déplaçons dans une base de données physique séparée (ou même un serveur de base de données séparé).
Nous avons une base de données principale où est stocké un tableau de routage contenant des informations sur l'emplacement de toutes les bases de données d'abonnés.
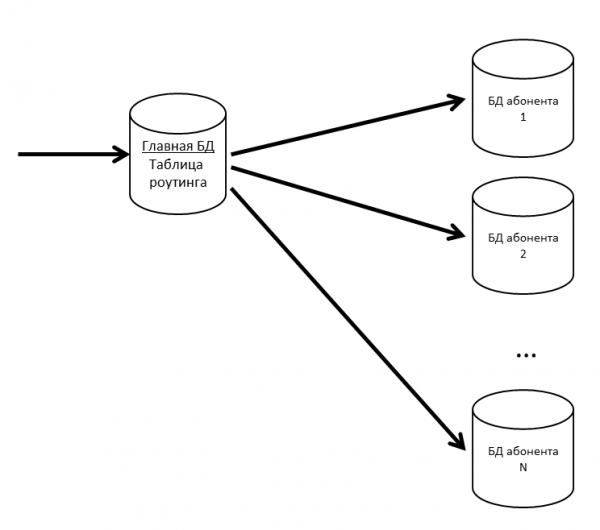
Pour que la base de données principale ne devienne pas un goulot d'étranglement, nous maintenons le tableau de routage (et d'autres données souvent demandées) en cache.
Si la base de données de l'abonné commence à ralentir, nous allons effectuer une partitionnement interne. Sur d'autres projets, nous utilisons la partitionnement pour de grandes tables avec .
Comme il est mauvais de perdre des messages utilisateurs, nous soutenons nos bases de données par des répliques. Une combinaison de répliques synchrones et asynchrones permet de se protéger en cas de perte de la base de données principale. La perte d'un message ne se produira que si la base de données principale et sa réplique synchrone échouent simultanément.
Si la réplique synchrone est perdue, la réplique asynchrone devient synchrone.
Si la base de données principale est perdue, la réplique synchrone devient la base de données principale, la réplique asynchrone devient la réplique synchrone.
Elasticsearch pour la recherche
Puisque, parmi d'autres choses, SV est aussi un messager, nous avons besoin d'une recherche rapide, pratique et flexible, prenant en compte la morphologie, pour des correspondances inexactes. Nous avons décidé de ne pas réinventer la roue et d'utiliser le système de recherche libre Elasticsearch, basé sur la bibliothèque . Nous déployons également Elasticsearch en cluster (master – data – data), afin d'éviter des problèmes en cas de défaillance des nœuds de l'application.
Sur github, nous avons trouvé pour Elasticsearch et l'utilisons. Dans l'index Elasticsearch, nous stockons les racines des mots (définies par le plugin) et les N-grammes. À mesure que l'utilisateur saisit du texte à rechercher, nous recherchons le texte saisi parmi les N-grammes. Lorsqu'il est enregistré dans l'index, le mot « textes » sera divisé en les N-grammes suivants :
[te, tek, teks, texte, textes, ek, eks, ekst, ekstes, ks, kst, ksty, st, sty, ty],
Ainsi, la racine du mot « texte » sera également enregistrée. Cette approche permet de rechercher au début, au milieu et à la fin du mot.
Vue d'ensemble
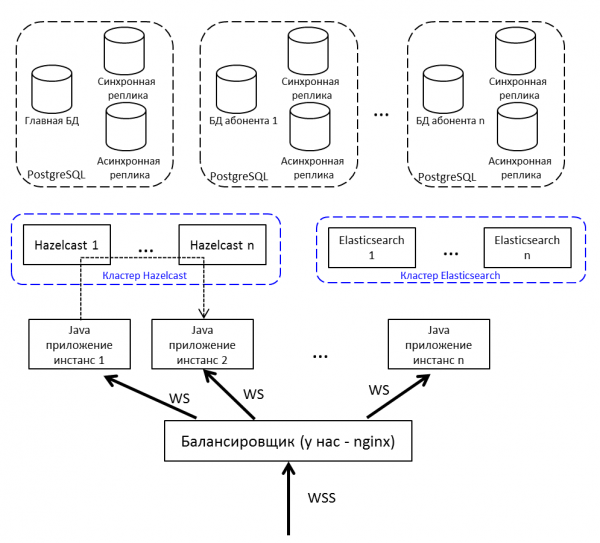
Répétition de l'image du début de l'article, mais avec des explications :
- Un équilibreur de charge exposé sur Internet ; nous avons nginx, cela peut être n'importe quel autre.
- Les instances de l'application Java communiquent entre elles via Hazelcast.
- Pour travailler avec le websocket, nous utilisons .
- L'application Java est écrite en Java 8 et se compose de bundles . Nous prévoyons une migration vers Java 10 et un passage aux modules.
Développement et test
Au cours du développement et du test du SV, nous avons rencontré plusieurs caractéristiques intéressantes des produits que nous utilisons.
Test de charge et fuites de mémoire
Chaque version du SV est précédée d'un test de charge. Il est passé avec succès lorsque :
- Le test a fonctionné pendant plusieurs jours sans interruptions de service
- Le temps de réponse pour les opérations clés n'a pas dépassé un seuil confortable
- La dégradation des performances par rapport à la version précédente n'est pas supérieure à 10%
Nous remplissons la base de test avec des données – pour cela, nous obtenons depuis le serveur de production des informations sur l'abonné le plus actif, multiplions ses chiffres par 5 (nombre de messages, discussions, utilisateurs) et ainsi nous testons.
Nous effectuons le test de charge du système d'interaction dans trois configurations :
- Test de stress
- Seulement des connexions
- Enregistrement des abonnés
Lors du test de stress, nous lançons plusieurs centaines de threads, et ceux-ci chargent le système sans interruption : ils envoient des messages, créent des discussions, obtiennent la liste des messages. Nous imitons les actions des utilisateurs normaux (obtenir la liste de mes messages non lus, écrire à quelqu'un) et des solutions logicielles (transmettre un paquet à une autre configuration, traiter une notification).
Par exemple, voici à quoi ressemble une partie du test de stress :
- Un utilisateur se connecte au système
- Demande ses discussions non lues
- Avec 50 % de probabilité, il lit les messages
- Avec 50 % de probabilité, il écrit des messages
- Ensuite, l'utilisateur :
- Crée une nouvelle discussion avec 20 % de probabilité
- Sélectionne au hasard l'une de ses discussions
- Accède à l'intérieur
- Demande des messages, des profils d'utilisateurs
- Crée cinq messages adressés à des utilisateurs aléatoires de cette discussion
- Sort de la discussion
- Répète 20 fois
- Se déconnecte, revient au début du scénario
- Un chatbot se connecte au système (émule l'échange de messages depuis le code des solutions applicatives)
- Crée un nouveau canal d'échange de données (discussion spéciale) avec 50 % de probabilité
- Écrit un message dans l'un des canaux existants avec 50 % de probabilité
Le scénario « Connexions uniquement » n'est pas apparu par hasard. Il arrive que les utilisateurs aient connecté le système, mais ne se soient pas encore impliqués. Chaque utilisateur allume son ordinateur le matin à 09h00, établit une connexion au serveur et reste silencieux. Ces gens sont dangereux, ils sont nombreux – dans les paquets, il n'y a que PING/PONG, mais ils maintiennent la connexion au serveur (ils ne peuvent pas s'en passer – et si un nouveau message arrive). Le test reproduit une situation où un grand nombre de ces utilisateurs tentent de se connecter au système en trente minutes. Cela ressemble à un test de stress, mais son accent est mis précisément sur cette première connexion – pour éviter les défaillances (la personne ne se sert pas du système, mais celui-ci tombe déjà en panne – difficile de penser à quelque chose de pire).
Le scénario d'enregistrement des abonnés commence dès le premier lancement. Nous avons effectué un test de stress et étions convaincus que le système ne ralentissait pas lors de la messagerie. Mais les utilisateurs sont arrivés et l'enregistrement a commencé à tomber par timeout. Lors de l'enregistrement, nous avons utilisé , qui est lié à l'entropie du système. Le serveur ne parvenait pas à accumuler suffisamment d'entropie et, lors de la demande d'un nouveau SecureRandom, se gelait pendant des dizaines de secondes. Il existe de nombreuses solutions à cette situation, par exemple : passer à un /dev/urandom moins sécurisé, installer une carte spéciale qui génère de l'entropie, générer des nombres aléatoires à l'avance et les stocker dans un pool. Nous avons temporairement résolu le problème avec un pool, mais depuis nous exécutons un test distinct pour l'enregistrement de nouveaux abonnés.
Comme générateur de charge, nous utilisons . Il ne sait pas travailler avec WebSocket, un plugin est nécessaire. Les premiers résultats de recherche pour « jmeter websocket » sont , qui recommandent .
C'est de là que nous avons décidé de commencer.
Peu après le début des tests sérieux, nous avons découvert que JMeter avait des fuites de mémoire.
Le plugin - c'est une grande histoire à part, avec 176 étoiles et 132 forks sur github. L'auteur n'y a pas commis depuis 2015 (nous l'avons pris en 2015, ce qui ne suscitait pas de soupçons), plusieurs problèmes sur github concernant les fuites de mémoire, 7 pull requests non résolues.
Si vous décidez de faire des tests de charge avec ce plugin, faites attention aux discussions suivantes :
- Dans un environnement multithread, une LinkedList classique a été utilisée, et en conséquence, nous avons obtenu en temps d'exécution. Cela peut être résolu soit en utilisant ConcurrentLinkedDeque, soit avec des blocs synchronisés. Nous avons choisi la première option ().
- Fuite de mémoire, lors de la déconnexion, les informations sur la connexion ne sont pas supprimées ().
- En mode streaming (quand le websocket n'est pas fermé à la fin de l'échantillon, mais utilisé plus tard dans le plan), les modèles de réponse ne fonctionnent pas ().
C'est l'un de ceux sur github. Ce que nous avons fait :
- Nous avons pris (@elyrank) - qui a résolu les problèmes 1 et 3
- Nous avons résolu le problème 2
- Nous avons mis à jour jetty de 9.2.14 à 9.3.12
- Nous avons enveloppé SimpleDateFormat dans ThreadLocal ; SimpleDateFormat n'est pas thread-safe, ce qui a conduit à un NPE en temps d'exécution
- Nous avons résolu une autre fuite de mémoire (la connexion n'était pas fermée correctement lors de la déconnexion)
Et pourtant, il fuit !
La mémoire ne se terminait plus en un jour, mais en deux. Nous n'avions plus de temps, nous avons décidé de lancer moins de threads, mais sur quatre agents. Cela devait suffire, au moins, pour une semaine.
Deux jours se sont écoulés...
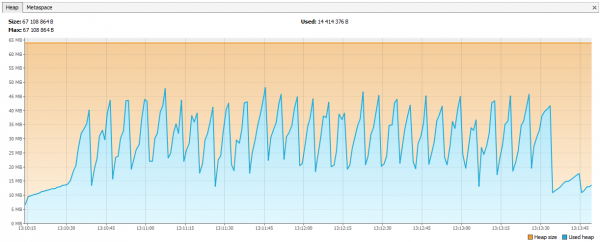
Maintenant, la mémoire se termine chez Hazelcast. Dans les logs, il était visible qu'après quelques jours de tests, Hazelcast commençait à se plaindre d'un manque de mémoire, et peu après, le cluster s'effondrait, et les nœuds continuaient à mourir un par un. Nous avons connecté JVisualVM à Hazelcast et avons vu une « scie montante » – il appelait régulièrement le GC, mais n'arrivait pas à libérer la mémoire.
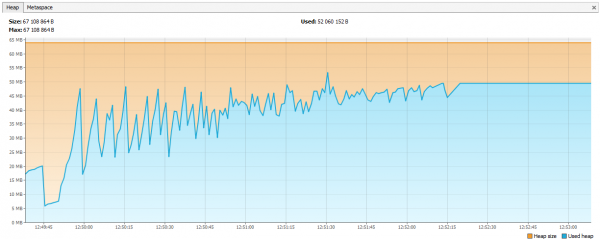
Il s'est avéré que dans hazelcast 3.4, lors de la suppression d'une map / multiMap (map.destroy()), la mémoire n'était pas complètement libérée :
Le problème est maintenant corrigé dans 3.5, mais à l'époque, c'était un problème. Nous créions de nouvelles multiMap avec des noms dynamiques et les supprimions selon notre logique. Le code ressemblait à peu près à cela :
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Appel :
service.join(auth1, "NOUVEAUX_MESSAGES_DANS_LE_DISCUS_UUID1");
service.join(auth2, "NOUVEAUX_MESSAGES_DANS_LE_DISCUS_UUID1");
multiMap a été créé pour chaque abonnement et supprimé lorsqu'il n'était plus nécessaire. Nous avons décidé de créer un Map, avec comme clé le nom de l'abonnement et comme valeurs les identifiants de session (à partir desquelles il est possible d'obtenir les identifiants d'utilisateur si nécessaire).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Les graphiques se sont stabilisés.
Qu'avons-nous appris d'autre sur les tests de charge
- JSR223 doit être écrit en groovy et inclure le cache de compilation - c'est beaucoup plus rapide. .
- Les graphiques Jmeter-Plugins sont plus faciles à comprendre que les standards. .
Notre expérience avec Hazelcast
Hazelcast était un nouveau produit pour nous, nous avons commencé à travailler avec lui à partir de la version 3.4.1, actuellement notre serveur de production utilise la version 3.9.2 (au moment de la rédaction de cet article, la dernière version de Hazelcast est 3.10).
Génération d'ID
Nous avons commencé avec des identifiants numériques. Imaginons que nous avons besoin d'un nouveau Long pour une nouvelle entité. Les séquences dans la base de données ne conviennent pas, les tables participent au sharding - il pourrait y avoir un message ID=1 dans DB1 et un message ID=1 dans DB2 ; cela ne fonctionne pas dans Elasticsearch, ni dans Hazelcast, et le plus grave, c'est si vous voulez fusionner les données de deux bases de données en une seule (par exemple, en décidant qu'une seule base suffit pour ces abonnés). On peut créer plusieurs AtomicLong dans Hazelcast et garder un compteur là-bas, alors la performance d'obtention d'un nouvel ID est - incrementAndGet plus le temps de la requête dans Hazelcast. Mais dans Hazelcast, il y a quelque chose de plus optimal - FlakeIdGenerator. À chaque requête du client, un intervalle d'ID est attribué, par exemple au premier - de 1 à 10 000, au second - de 10 001 à 20 000, et ainsi de suite. Le client peut maintenant générer de nouveaux identifiants de manière autonome jusqu'à épuisement de l'intervalle qui lui a été attribué. Cela fonctionne rapidement, mais lors du redémarrage de l'application (et du client Hazelcast), une nouvelle séquence commence - d'où les sauts, etc. De plus, il n'est pas très clair pour les développeurs pourquoi les ID sont numériques, mais varient tant. Nous avons tout pesé et sommes passés aux UUID.
Au fait, pour ceux qui veulent faire comme Twitter, il existe une bibliothèque Snowcast – c'est une implémentation de Snowflake sur Hazelcast. Vous pouvez la consulter ici :
Mais nous n'y avons pas encore eu le temps.
TransactionalMap.replace
Une autre surprise : TransactionalMap.replace ne fonctionne pas. Voici un test :
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Attendu : newValue
Actuel : oldValue
Nous avons dû écrire notre propre replace, en utilisant getForUpdate :
protected <K,V> boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Remplacement de la valeur dans une carte transactionnelle");
        TransactionalMap<K, V> map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Remplacement de la valeur dans une carte non transactionnelle");
    IMap<K, V> map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testez non seulement les structures de données classiques, mais aussi leurs versions transactionnelles. Parfois, IMap fonctionne, alors que TransactionalMap ne fonctionne pas.
Déployer un nouveau JAR sans temps d'arrêt
Au départ, nous avons décidé d'enregistrer dans Hazelcast des objets de nos propres classes. Par exemple, nous avons une classe Application, nous souhaitons la sauvegarder et la lire. Sauvegarde :
IMap<UUID, Application> map = hazelcastInstance.getMap("application");
map.set(id, application);
Lecture :
IMap<UUID, Application> map = hazelcastInstance.getMap("application");
return map.get(id);
Tout fonctionne. Ensuite, nous avons décidé de construire un index dans Hazelcast pour pouvoir le rechercher :
map.addIndex("subscriberId", false);Et lors de l'enregistrement d'une nouvelle entité, nous avons commencé à recevoir une ClassNotFoundException. Hazelcast tentait de compléter l'index, mais ne connaissait rien de notre classe et voulait qu'on lui fournisse le JAR avec cette classe. Nous l'avons fait, tout a fonctionné, mais un nouveau problème est apparu : comment mettre à jour le JAR sans arrêter complètement le cluster ? Hazelcast ne prend pas en charge le nouveau JAR lors d'une mise à jour progressive. À ce moment-là, nous avons décidé que nous pouvions vivre sans recherche par index. Après tout, si l'on utilise Hazelcast comme un stockage clé-valeur, tout devrait fonctionner, n'est-ce pas ? Pas tout à fait. Ici, il y a encore un comportement différent entre IMap et TransactionalMap. Là où IMap s'en fiche, TransactionalMap génère une erreur.
IMap. Nous enregistrons 5000 objets, nous les lisons. Tout est comme prévu.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
Et cela ne fonctionne pas dans une transaction, nous obtenons ClassNotFoundException :
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
La version 3.8 a introduit le mécanisme de déploiement de classes utilisateur. Vous pouvez désigner un nœud principal et mettre à jour le fichier JAR dessus.
Nous avons complètement changé d'approche : nous sérialisons nous-mêmes en JSON et sauvegardons dans Hazelcast. Hazelcast n'a pas besoin de connaître la structure de nos classes, et nous pouvons mettre à jour sans temps d'arrêt. La gestion des versions des objets de domaine est effectuée par l'application. Différentes versions de l'application peuvent être exécutées simultanément, et il peut y avoir des situations où la nouvelle application écrit des objets avec de nouveaux champs, tandis que l'ancienne ne connaît pas encore ces champs. En même temps, la nouvelle application lit des objets écrits par l'ancienne application qui ne contiennent pas de nouveaux champs. Nous gérons de telles situations à l'intérieur de l'application, mais pour simplifier, nous ne changeons ni ne supprimons les champs, nous élargissons simplement les classes en ajoutant de nouveaux champs.
Comment nous assurons une haute performance
Quatre accès à Hazelcast – c'est bien, deux à la base de données – c'est mauvais
Il est toujours préférable de récupérer des données depuis le cache plutôt que depuis la base de données, mais nous ne voulons pas non plus conserver des enregistrements inutilisés. La décision sur ce que nous devons mettre en cache est reportée à la dernière étape du développement. Une fois que la nouvelle fonctionnalité est codée, nous activons dans PostgreSQL l'enregistrement de toutes les requêtes (log_min_duration_statement à 0) et exécutons des tests de charge pendant environ 20 minutes. Les outils comme pgFouine et pgBadger peuvent créer des rapports analytiques à partir des journaux collectés. Dans les rapports, nous recherchons d'abord les requêtes lentes et fréquentes. Pour les requêtes lentes, nous établissons un plan d'exécution (EXPLAIN) et évaluons s'il est possible d'accélérer cette requête. Les requêtes fréquentes avec les mêmes données d'entrée se cachent bien dans le cache. Nous essayons de garder les requêtes "plates", en limitant chaque requête à une seule table.
Exploitation
SV, en tant que service en ligne, a été mise en service au printemps 2017, et le produit distinct SV est sorti en novembre 2017 (à l'époque en version bêta).
Plus d'un an d'exploitation, il n'y a eu aucun problème grave avec le fonctionnement du service en ligne SV. Nous surveillons le service en ligne via , collectons et déployons depuis .
Le package serveur SV est livré sous forme de paquets natifs : RPM, DEB, MSI. De plus, pour Windows, nous proposons un installateur unique sous la forme d'un seul EXE, qui installe le serveur, Hazelcast et Elasticsearch sur une seule machine. Au départ, nous appelions cette version d'installation "démonstration", mais il est désormais clair que c'est l'option de déploiement la plus populaire.
Source : habr.com
