

Salut, Habr !
Je fais partie de l'équipe Tinkoff, qui développe notre propre centre de notifications. Pour la plupart, je développe en Java avec Spring Boot et résous divers problèmes techniques qui surviennent dans le projet.
La plupart de nos microservices interagissent de manière asynchrone entre eux via un courtier de messages. Auparavant, nous utilisions IBM MQ comme courtier, qui n'a plus été en mesure de gérer la charge, mais qui garantissait des livraisons de haute qualité.
En remplacement, on nous a proposé Apache Kafka, qui a un fort potentiel de scalabilité, mais qui nécessite malheureusement une approche quasiment sur mesure pour la configuration selon différents scénarios. De plus, le mécanisme de livraison au moins une fois, qui fonctionne par défaut dans Kafka, ne permettait pas de maintenir le niveau de cohérence nécessaire directement en sortie de boîte. Ensuite, je vais partager notre expérience de configuration de Kafka, en particulier comment configurer et vivre avec la livraison exactement une fois.
Livraison garantie et plus encore
Les paramètres dont il sera question par la suite aideront à prévenir plusieurs problèmes liés aux paramètres de connexion par défaut. Mais d'abord, je voudrais attirer l'attention sur un paramètre qui facilitera le débogage éventuel.
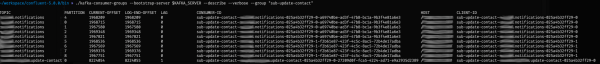
Cela aidera client.id pour le Producer et le Consumer. À première vue, vous pouvez utiliser le nom de l'application comme valeur, et dans la plupart des cas, cela fonctionnera. Cependant, le cas où plusieurs Consumers sont utilisés dans l'application et que vous leur attribuez le même client.id entraîne le message d'avertissement suivant :
org.apache.kafka.common.utils.AppInfoParser — Error registering AppInfo mbean javax.management.InstanceAlreadyExistsException: kafka.consumer:type=app-info,id=kafka.test-0Si vous souhaitez utiliser JMX dans une application avec Kafka, cela peut poser problème. Pour ce cas, il est préférable d'utiliser comme valeur client.id une combinaison du nom de l'application et, par exemple, du nom du topic. Le résultat de notre configuration peut être consulté dans la sortie de la commande kafka-consumer-groups des utilitaires Confluent :
Analysons maintenant le scénario de la livraison garantie du message. Le Producer Kafka dispose d'un paramètre acks, qui permet de configurer, après combien de confirmations le leader du cluster doit considérer le message comme écrit avec succès. Ce paramètre peut prendre les valeurs suivantes :
- 0 — les confirmations ne seront pas prises en compte.
- 1 — paramètre par défaut, nécessite une confirmation uniquement d'1 réplique.
- −1 — des acks sont nécessaires de toutes les replicas synchronisées (configuration du cluster min.insync.replicas).
D'après les valeurs énumérées, un acks égal à −1 offre les garanties les plus fortes qu'un message ne sera pas perdu.
Comme nous le savons tous, les systèmes distribués ne sont pas fiables. Pour se protéger contre les pannes temporaires, le Kafka Producer propose le paramètre retries, qui permet de spécifier le nombre de tentatives de ré-envoi dans delivery.timeout.ms. Étant donné que le paramètre retries a comme valeur par défaut Integer.MAX_VALUE (2147483647), le nombre de tentatives de ré-envoi peut être ajusté en modifiant uniquement delivery.timeout.ms.
Passons à la livraison exactement une fois
Les paramètres énumérés permettent à notre Producer de livrer des messages avec une forte garantie. Parlons maintenant de la façon de garantir que seule une copie d'un message est écrite dans un topic Kafka ? Dans le cas le plus simple, il suffit de régler le paramètre enable.idempotence sur true. L'idempotence garantit qu'un seul message est écrit dans une partition d'un topic donné. Les conditions préalables à l'activation de l'idempotence sont les valeurs acks = all, retry > 0, max.in.flight.requests.per.connection ≤ 5. Si ces paramètres ne sont pas définis par le développeur, les valeurs mentionnées ci-dessus seront automatiquement appliquées.
Lorsque l'idempotence est configurée, il est nécessaire de s'assurer que les messages identiques arrivent toujours dans les mêmes partitions. Cela peut être accompli en configurant la clé et le paramètre partitioner.class sur le Producer. Commençons par la clé. Pour chaque envoi, elle doit être identique. Cela est facilement réalisable en utilisant un identifiant commercial provenant du message original. Le paramètre partitioner.class a pour valeur par défaut — . Avec cette stratégie de partitionnement par défaut, nous agissons comme suit :
- Si la partition est spécifiée lors de l'envoi du message, nous l'utilisons.
- Si la partition n'est pas spécifiée, mais que la clé est précisée — nous choisissons la partition sur la base du hachage de la clé.
- Si ni la partition ni la clé ne sont spécifiées — nous choisissons les partitions par ordre (round-robin).
De plus, l'utilisation d'une clé et l'envoi idempotent avec le paramètre max.in.flight.requests.per.connection = 1 vous permet de traiter les messages sur le Consumer de manière organisée. Il convient de noter que si votre cluster est configuré avec un contrôle d'accès, vous aurez besoin de droits pour écrire de manière idempotente dans le topic.
Si vous manqueriez de fonctionnalités d'envoi idempotent par clé ou si la logique du côté du Producer nécessite de maintenir la cohérence des données entre différentes partitions, les transactions vous aideront. De plus, grâce à la transaction en chaîne, vous pouvez conditionnellement synchroniser l'écriture dans Kafka, par exemple, avec l'écriture dans la base de données. Pour activer l'envoi transactionnel sur le Producer, il doit être idempotent, et vous devez également définir transactional.id. Si votre cluster Kafka est configuré avec un contrôle d'accès, des droits d'écriture seront nécessaires pour l'écriture transactionnelle, tout comme pour l'idempotente, qui peuvent être fournis via un masque en utilisant la valeur stockée dans transactional.id.
Formellement, n'importe quelle chaîne peut être utilisée comme identifiant de transaction, par exemple le nom de l'application. Cependant, si vous exécutez plusieurs instances de la même application avec le même transactional.id, la première instance lancée sera arrêtée avec une erreur, car Kafka la considérera comme un processus zombie.
org.apache.kafka.common.errors.ProducerFencedException : le Producer a tenté d'effectuer une opération avec une ancienne époque. Soit il y a un nouveau producer avec le même transactionalId, soit la transaction du producer a expiré par le courtier.Pour résoudre ce problème, nous ajoutons un suffixe au nom de l'application sous la forme du nom d'hôte, que nous obtenons à partir des variables d'environnement.
Le Producer est configuré, mais les transactions dans Kafka ne gèrent que la portée du message. Quel que soit le statut de la transaction, le message entre immédiatement dans le topic, mais possède des attributs système supplémentaires.
Pour que ces messages ne soient pas lus par le Consumer trop tôt, il doit définir le paramètre isolation.level à la valeur read_committed. Ce Consumer pourra lire les messages non transactionnels comme auparavant, et les transactionnels uniquement après engagement.
Si vous avez configuré tous les paramètres énumérés précédemment, vous avez configuré une livraison exactement une fois. Félicitations !
Mais il y a une autre nuance. Le transactional.id que nous avons configuré ci-dessus est en fait un préfixe de la transaction. Un numéro de séquence lui est ajouté sur le gestionnaire de transactions. L'identifiant obtenu est émis à transactional.id.expiration.ms, qui est configuré sur un cluster Kafka et a une valeur par défaut de « 7 jours ». Si l'application ne reçoit aucun message pendant cette période, alors lors de la prochaine tentative d'envoi transactionnel, vous obtiendrez InvalidPidMappingException. Après cela, le coordinateur de transactions attribuera un nouveau numéro de séquence pour la prochaine transaction. Cependant, le message peut être perdu si l'InvalidPidMappingException n'est pas correctement traité.
Au lieu des résultats
Comme vous pouvez le constater, il ne suffit pas d'envoyer simplement des messages dans Kafka. Vous devez choisir une combinaison de paramètres et être prêt à apporter des modifications rapides. Dans cet article, j'ai essayé de montrer en détail la configuration de la livraison exactly once et décrit quelques problèmes de configuration client.id et transactional.id que nous avons rencontrés. Ces paramètres de Producteur et de Consommateur sont résumés ci-dessous.
Producteur :
- acks = all
- retries > 0
- enable.idempotence = true
- max.in.flight.requests.per.connection ≤ 5 (1 — pour un envoi ordonné)
- transactional.id = ${application-name}-${hostname}
Consommateur :
- isolation.level = read_committed
Pour minimiser les erreurs dans les futures applications, nous avons créé notre propre wrapper autour de la configuration de Spring, où certaines des valeurs de ces paramètres sont déjà définies.
Voici quelques ressources pour étudier par vous-même :
Source : habr.com
