

Nous avons conçu une architecture de centre de données qui permet de déployer des clusters de calcul de plus de 100 000 serveurs, avec une bande passante de bisection supérieure à un pétaoctet par seconde.
Dans le rapport de Dmitri Afanassiev, vous découvrirez les principaux principes de ce nouveau design, l'évolutivité des topologies, les problèmes qui en découlent, les options de solution, ainsi que les spécificités du routage et de l'évolutivité des fonctions de plan de transfert des appareils réseau modernes dans des topologies « densément connectées » avec un grand nombre de chemins ECMP. De plus, Dima a brièvement parlé de l'organisation de la connectivité externe, du niveau physique, du système de câblage et des moyens d'augmenter davantage la capacité.
— Bonjour à tous ! Je m'appelle Dmitri Afanassiev, je suis architecte réseau chez Yandex et je suis principalement responsable de la conception des réseaux de centres de données.
Mon exposé portera sur le réseau de centres de données mis à jour de Yandex. C'est en grande partie une évolution du design que nous avions, mais il y a également de nouveaux éléments. C'est une présentation générale, car il a fallu condenser beaucoup d'informations en peu de temps. Nous commencerons par le choix de la topologie logique. Ensuite, il y aura un aperçu du plan de contrôle et des problèmes d'évolutivité du plan de données, le choix de ce qui se produira au niveau physique, et nous examinerons certaines spécificités des dispositifs. Nous aborderons également les événements dans le centre de données avec l'MPLS, dont nous avions parlé il y a quelque temps.
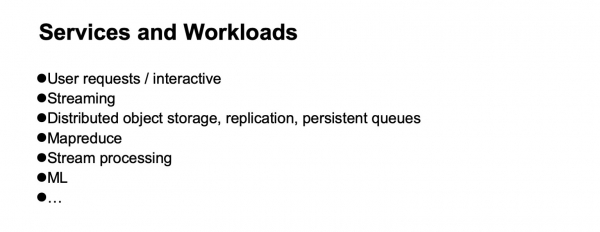
Alors, qu'est-ce que Yandex en termes de charges et de services ? Yandex est un hyper-scalper typique. Du point de vue des utilisateurs, nous traitons principalement les demandes des utilisateurs. Il y a également divers services de streaming et de fourniture de données, car nous avons aussi des services de stockage. Du côté de l'arrière-plan, il s'agit de charges et de services d'infrastructure, tels que des systèmes de stockage d'objets distribués, la réplication de données et, bien sûr, des files d'attente persistantes. L'un des principaux types de charges est MapReduce et des systèmes similaires, traitement de flux, apprentissage automatique, etc.
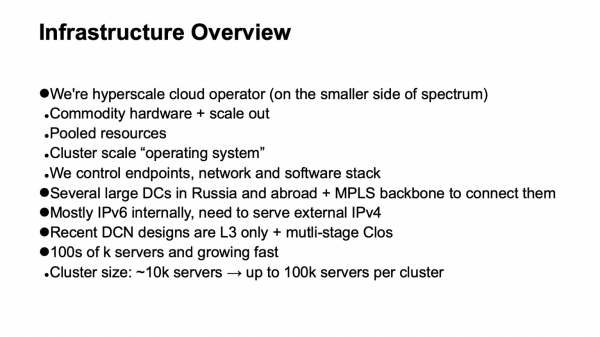
Comment est structurée l'infrastructure sur laquelle tout cela repose ? Encore une fois, nous sommes un hyper-scalable typique, bien que nous soyons peut-être un peu plus près de ce côté du spectre où se trouvent les hyper-scalables plus petits. Mais nous avons tous les attributs. Nous utilisons du matériel standard et un масштабирование horizontal partout où cela est possible. Nous avons une mise en commun des ressources en pleine expansion : nous ne travaillons pas avec des machines ou des racks séparés, mais les combinons en un grand pool de ressources interchangeables avec des services supplémentaires qui s'occupent de la planification et de l'allocation, et nous travaillons avec tout ce pool.
Ainsi, nous passons au niveau suivant - le système d'exploitation du cluster de calcul. Il est très important que nous contrôlions entièrement la pile technologique utilisée. Nous contrôlons les points de terminaison (hôtes), le réseau et la pile logicielle.
Nous avons plusieurs grands centres de données en Russie et à l'étranger. Ils sont reliés par un backbone utilisant la technologie MPLS. Notre infrastructure interne est pratiquement entièrement construite sur IPv6, mais comme nous devons gérer le trafic externe, qui arrive encore principalement par IPv4, nous devons d'une certaine manière acheminer les requêtes arrivant en IPv4 jusqu'au front-end-serveurs, et aussi naviguer un peu dans l'Internet IPv4 externe - par exemple, pour l'indexation.
Les dernières itérations de la conception des réseaux de centres de données utilisent des topologies Clos multilayer, et elles n'appliquent que L3. Nous avons abandonné L2 il y a quelque temps et avons respiré un soupir de soulagement. Enfin, notre infrastructure comprend des centaines de milliers d'instances de calcul (serveurs). La taille maximale du cluster était d'environ 10 000 serveurs il y a quelque temps. Cela est en grande partie déterminé par la façon dont ces systèmes d'exploitation de cluster peuvent fonctionner, les planificateurs, l'allocation des ressources, etc. Avec les progrès réalisés du côté des logiciels d'infrastructure, la taille cible est désormais d'environ 100 000 serveurs dans un seul cluster de calcul, et nous avons eu pour tâche de construire des fabrications réseau qui permettent un pooling efficace des ressources dans un tel cluster.
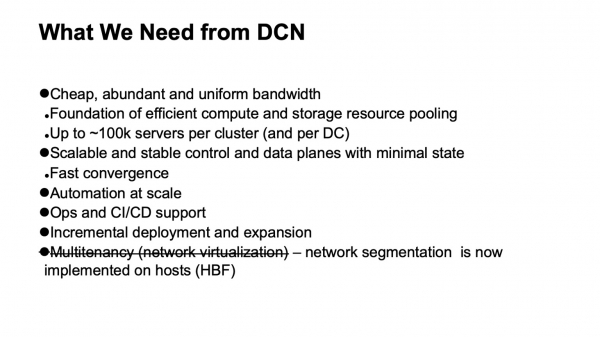
Que voulons-nous d'un réseau de centres de données? Avant tout, beaucoup de bande passante à faible coût et suffisamment répartie de manière homogène. Car le réseau est la base à partir de laquelle nous pouvons agréger des ressources. La nouvelle taille cible est d'environ 100 000 serveurs dans un seul cluster.
Nous souhaitons également, bien sûr, un plan de contrôle évolutif et stable, car dans une infrastructure aussi vaste, il y a déjà beaucoup de douleurs à la tête causées par des événements aléatoires, et nous ne voulons pas que le plan de contrôle nous cause encore plus de tracas. En même temps, nous voulons minimiser l'état dans celui-ci. Moins il y a d'état, mieux tout fonctionne, et plus il est facile de diagnostiquer.
Bien sûr, nous avons besoin d'automatisation, car il est impossible de gérer une telle infrastructure manuellement, ce qui n'était déjà plus possible depuis un certain temps. Nous avons besoin, autant que possible, de soutien aux opérations et de soutien CI/CD, dans la mesure du possible.
Avec une telle taille des centres de données et des clusters, la question du déploiement incrémental et de l'expansion sans interruption de service est devenue assez pressante. Si pour des clusters de taille d'un millier de machines, il était encore possible de déployer presque une dizaine de milliers de machines comme une seule opération — c'est-à-dire que nous planifions l'expansion de l'infrastructure et que plusieurs milliers de machines sont ajoutées comme une seule opération — alors un cluster de taille proche de cent mille machines ne se construit pas d'un seul coup, il se construit sur une certaine période. Il est donc souhaitable que tout au long de ce temps, ce qui est déjà déployé, l'infrastructure qui a été mise en place, soit accessible.
Et une exigence que nous avions et qui a disparu : c'est le support de la multitenance, c'est-à-dire de la virtualisation ou de la segmentation du réseau. Maintenant, nous n'avons plus besoin de le faire au niveau de la fabrique réseau, car la segmentation a été transférée aux hôtes, ce qui a grandement facilité notre mise à l'échelle. Grâce à l'IPv6 et à un grand espace d'adressage, nous n'avons pas eu besoin d'utiliser des adresses dupliquées dans l'infrastructure interne, tout l'adressage était déjà unique. Et grâce au fait que nous avons déplacé le filtrage et la segmentation du réseau vers les hôtes, nous n'avons pas eu besoin de créer des entités réseau virtuelles dans les réseaux des centres de données.
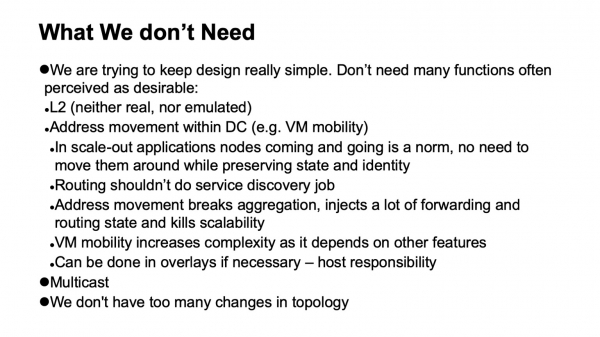
Une chose très importante est ce dont nous n'avons pas besoin. Si certaines fonctions peuvent être supprimées du réseau, cela facilite grandement la vie et, en général, élargit le choix du matériel et des logiciels disponibles, simplifiant beaucoup le diagnostic.
Alors, de quoi n'avons-nous pas besoin, sur quoi avons-nous pu faire l'impasse, parfois sans joie au moment où cela se produisait, mais avec un grand soulagement une fois le processus terminé ?
Tout d'abord, l'abandon du L2. Nous n'avons pas besoin de L2, qu'il soit réel ou émulé. Cela n'est pas largement utilisé grâce au fait que nous contrôlons la pile d'applications. Nos applications sont évolutives horizontalement, elles fonctionnent avec une adressage L3, elles ne s'inquiètent pas trop qu'une instance particulière soit éteinte, elles déploient simplement une nouvelle instance, il n'est pas nécessaire de déployer sur l'ancienne adresse, car il existe un niveau séparé de découverte de services et de surveillance des machines au sein du cluster. Nous ne transférons pas cette tâche au réseau. La tâche du réseau est de livrer des paquets d'un point A à un point B.
Nous n'avons également pas de situations où les adresses se déplacent à l'intérieur du réseau et où cela doit être suivi. Dans de nombreux designs, cela est généralement nécessaire pour soutenir la mobilité des VM. Nous n'utilisons pas la mobilité des machines virtuelles dans l'infrastructure interne de Yandex, et de plus, nous pensons que, même si cela est fait, cela ne devrait pas se faire avec le support du réseau. Si cela doit être fait, cela doit se faire au niveau des hôtes, et il faut diriger les adresses susceptibles de migrer dans des overlay pour ne pas toucher et ne pas introduire trop de changements dynamiques dans le système de routage du réseau sous-jacent.
Une autre technologie que nous n'utilisons pas est le multicast. Je peux expliquer en détail pourquoi à ceux que cela intéresse. Cela facilite énormément la vie, car si quelqu'un a eu affaire à cela et a vu à quoi ressemble le plan de contrôle du multicast - dans toutes les installations, sauf les plus simples, c'est un véritable casse-tête. De plus, il est difficile de trouver une bonne mise en œuvre ouverte qui fonctionne bien, par exemple.
Enfin, nous concevons nos réseaux de manière à ce qu'il n'y ait pas trop de changements. Nous pouvons compter sur le fait que le flux d'événements externes dans le système de routage est faible.
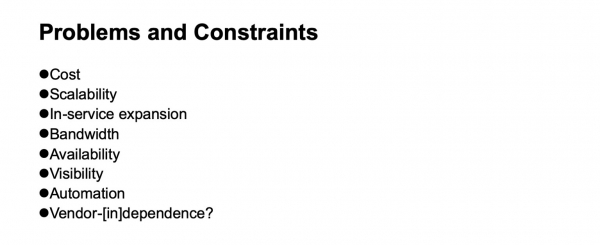
Quels problèmes et quelles limitations devons-nous prendre en compte lors de la conception d'un réseau de centre de données ? Le coût, bien sûr. La scalabilité, jusqu'à quel niveau souhaitons-nous croître. La nécessité d'étendre sans arrêter le service. La bande passante, la disponibilité. La visibilité de ce qui se passe dans le réseau pour les systèmes de surveillance, pour les équipes opérationnelles. Le soutien à l'automatisation — encore une fois, dans la mesure du possible, car différentes tâches peuvent être résolues à différents niveaux, y compris l'introduction de couches supplémentaires. Et la dépendance aux fournisseurs, qui, selon les périodes historiques et le segment de marché considéré, a pu être plus ou moins atteignable. Si l'on prend le segment des puces d'appareils réseau, jusqu'à récemment, parler d'indépendance vis-à-vis des fournisseurs, lorsque l'on souhaitait également des puces à grande largeur de bande, était très conditionnel.
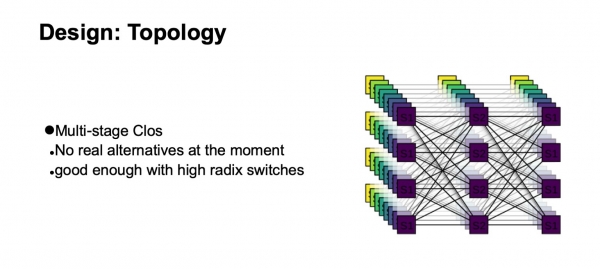
Quelle topologie logique allons-nous adopter pour construire notre réseau ? Ce sera un Clos multi-niveaux. En réalité, il n'y a actuellement pas d'alternatives réelles. Et la topologie Clos est assez bonne, même si on la compare à diverses topologies avancées qui sont maintenant davantage dans le domaine d'un intérêt académique, si nous avons des commutateurs avec un grand radix.
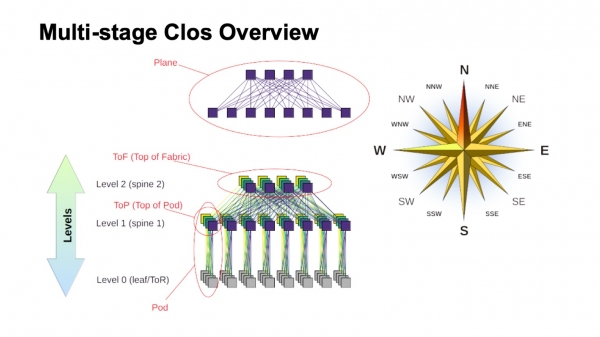
Comment fonctionne approximativement un réseau Clos multi-niveaux et comment les divers éléments sont-ils appelés ? En premier lieu, une rose des vents pour s'orienter, où se trouvent le nord, le sud, l'est et l'ouest. Les réseaux de ce type sont généralement construits par ceux qui ont un très gros trafic d'est en ouest. En ce qui concerne les autres éléments, en haut se trouve un commutateur virtuel constitué de plus petits commutateurs. C'est l'idée principale de la construction récursive des réseaux Clos. Nous prenons des éléments avec un certain radix et les connectons de manière à ce que le résultat puisse être considéré comme un commutateur avec un radix plus grand. Si besoin de plus, la procédure peut être répétée.
Dans le cas des Clos à deux niveaux, où il est possible de distinguer clairement les composants qui sont verticaux dans mon schéma, on a tendance à les appeler des plans. Si nous construisions un Clos avec trois niveaux de commutateurs spine (tous ceux qui ne sont pas frontaux et ne sont pas des ToR et qui sont utilisés uniquement pour le transit), les plans apparaîtraient comme plus compliqués, alors que les plans à deux niveaux ressemblent exactement à cela. Le bloc des commutateurs ToR ou leaf et les commutateurs spine de premier niveau qui leur sont associés sont appelés Pod. Les commutateurs spine de niveau spine-1 en haut du Pod sont le sommet du Pod. Les commutateurs qui se trouvent au sommet de l'ensemble de l'architecture sont la couche supérieure, le sommet de l'architecture.
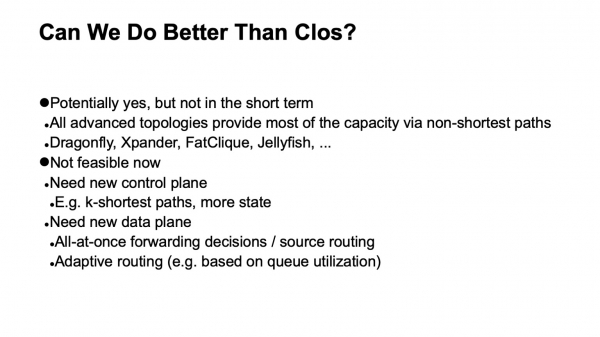
Bien sûr, la question se pose : les réseaux Clos existent depuis un certain temps, et l'idée elle-même vient de l'époque de la téléphonie classique, des réseaux TDM. Peut-être qu'il y a mieux, peut-être qu'on peut faire mieux d'une certaine manière ? Oui et non. Théoriquement, oui, mais pratiquement, pas dans un avenir proche. Cela est dû à l'existence de plusieurs topologies intéressantes, dont certaines sont même utilisées en production, par exemple, Dragonfly est utilisé dans des applications HPC ; il existe également des topologies intéressantes telles que Xpander, FatClique, Jellyfish. Si l'on consulte les présentations lors de conférences telles que SIGCOMM ou NSDI récemment, on peut découvrir un nombre assez conséquent de travaux sur des topologies alternatives possédant de meilleures propriétés (à divers égards) que Clos.
Cependant, toutes ces topologies présentent une caractéristique intéressante. Elle empêche leur mise en œuvre dans les réseaux de centres de données que nous tentons de construire sur du matériel standard et qui coûtent des sommes raisonnables. Dans toutes ces topologies alternatives, une grande partie de la bande passante, malheureusement, n'est pas accessible par les chemins les plus courts. Par conséquent, nous perdons immédiatement la possibilité d'utiliser un plan de contrôle traditionnel.
Théoriquement, la solution à ce problème est connue. Ce sont, par exemple, des modifications de l'état des liens utilisant des chemins k-plus courts, mais encore une fois, il n'existe pas de protocoles qui ont été mis en œuvre en production et qui soient largement disponibles sur le matériel.
De plus, comme la majorité de la capacité n'est pas disponible par les chemins les plus courts, nous devons modifier non seulement le plan de contrôle pour qu'il choisisse tous ces chemins (et, soit dit en passant, cela représente un état nettement plus important dans le plan de contrôle). Nous devons également modifier le plan de transfert, et il faut généralement au moins deux fonctionnalités supplémentaires. La première est la possibilité de prendre toutes les décisions de transfert de paquets d'un seul coup, par exemple, sur l'hôte. En fait, il s'agit de routage source, qui est parfois appelé décision de transfert simultanée dans la littérature sur les réseaux d'interconnexion. Et le second est le routage adaptatif — c'est une fonctionnalité dont nous avons besoin au niveau des dispositifs réseau, qui consiste, par exemple, à choisir le prochain saut en se basant sur des informations concernant la moindre charge de la file d'attente. D'autres options peuvent également être envisagées.
Ainsi, la direction est intéressante, mais hélas, nous ne pouvons pas l'appliquer immédiatement.
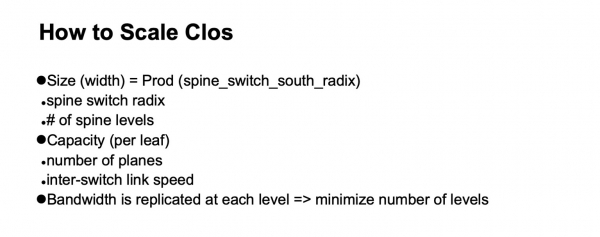
D'accord, nous nous sommes arrêtés sur la topologie logique Clos. Comment allons-nous la mettre à l'échelle ? Voyons comment elle est structurée et ce que nous pouvons faire.
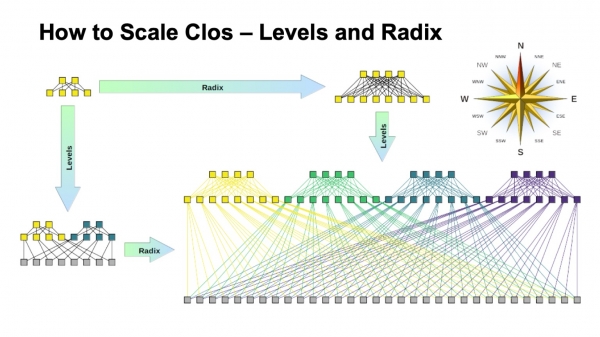
Dans un réseau Clos, il y a deux paramètres principaux que nous pouvons varier pour obtenir différents résultats : le radice des éléments et le nombre de niveaux dans le réseau. J'ai schématiquement représenté comment les deux influencent la taille. Idéalement, nous combinons les deux.
On voit que la largeur finale d'un réseau Clos est le produit de tous les niveaux de commutateurs de spine du radice sud, c'est-à-dire combien de liaisons nous avons en bas et comment il se ramifie. Voici comment nous mettons à l'échelle la taille du réseau.
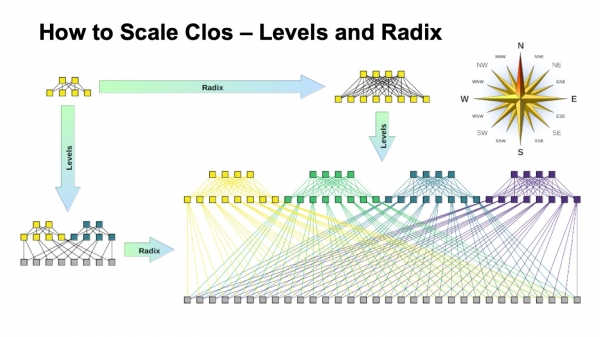
Concernant la capacité, surtout sur les commutateurs ToR, il y a deux options de mise à l'échelle. Nous pouvons soit, en gardant la topologie générale, utiliser des liaisons plus rapides, soit ajouter un plus grand nombre de plans.
Si l'on regarde la version déployée d'un réseau Clos (dans le coin inférieur droit) et que l'on revient à cette image d'un réseau Clos en bas...
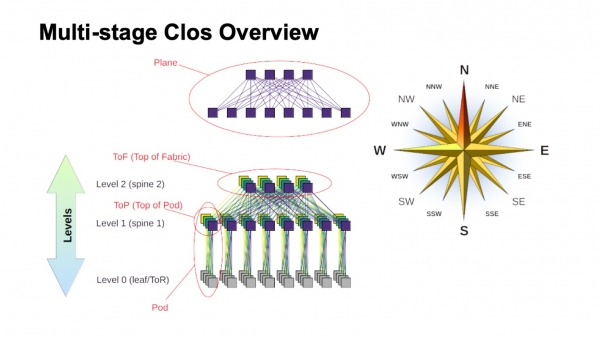
… c'est exactement la même topologie, mais sur cette diapositive elle est compressée plus compactement et les plans de la fabrique se superposent. C'est la même chose.
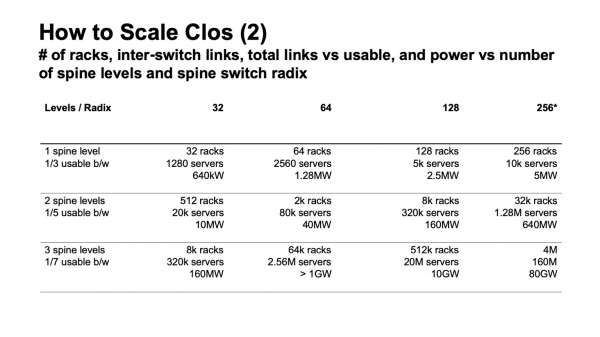
À quoi ressemble la mise à l'échelle d'un réseau Clos en chiffres ? Ici, je fournis des données sur quelle largeur maximale pourrait atteindre le réseau, quel est le nombre maximal de racks, de commutateurs ToR ou de commutateurs leaf, s'ils ne se trouvent pas dans des racks, que nous pouvons obtenir en fonction de quel radice de commutateurs est utilisé pour les niveaux de spine et combien de niveaux nous utilisons.
Voici un aperçu du nombre de racks que nous pouvons avoir, combien de serveurs et environ combien cela peut consommer sur la base de 20 kW par rack. J'ai mentionné plus tôt que nous visons une taille de cluster d'environ 100 000 serveurs.
Il est clair que dans toute cette construction, deux variantes et demie sont intéressantes. Il existe une version avec deux niveaux de spine et des commutateurs 64 ports, qui est légèrement insuffisante. Ensuite, des options bien adaptées pour des commutateurs spine 128 ports (avec un radix de 128) avec deux niveaux, ou des commutateurs avec un radix de 32 avec trois niveaux. Dans tous les cas, où le radix est plus élevé et où il y a plus de niveaux, il est possible de créer un très grand réseau, mais si vous regardez la consommation prévue, cela atteint généralement des gigawatts. Les câbles peuvent être installés, mais nous ne pourrons probablement pas obtenir autant d'électricité sur un seul site. Si l'on examine les statistiques, il est très rare de trouver des centres de données avec une puissance maximale supérieure à 150 MW. Ce qui dépasse cette puissance concerne généralement des campus de centres de données, avec plusieurs grands centres de données situés assez près les uns des autres.
Il y a aussi un paramètre important. Si vous regardez la colonne de gauche, elle indique la bande passante utilisable. Il est facile de voir que dans un réseau Clos, une part significative des ports est utilisée pour connecter les commutateurs entre eux. La bande passante utilisable est celle qui peut être envoyée vers l'extérieur, vers les serveurs. Naturellement, je parle des ports conditionnels et précisément de la bande passante. En général, les liaisons à l'intérieur du réseau sont plus rapides que les liaisons vers les serveurs, mais pour chaque unité de bande passante que nous pouvons délivrer vers notre équipement serveur, il y a un certain montant de bande passante à l'intérieur même du réseau. Plus nous ajoutons de niveaux, plus les coûts spécifiques pour fournir cette bande passante vers l'extérieur augmentent.
De plus, même cette bande passante supplémentaire n'est pas tout à fait uniforme. Tant que les liaisons sont courtes, nous pouvons utiliser quelque chose comme DAC (copper direct attach, c'est-à-dire des câbles twinax) ou de l'optique multimode, qui sont encore relativement abordables. Dès que nous passons à des liaisons plus longues — en général, il s'agit d'optique monomode, et le coût de cette bande passante supplémentaire augmente considérablement.
Et encore une fois, en revenant à la diapositive précédente, si nous construisons un réseau Clos sans sous-signer, il est facile de regarder le schéma et de voir comment le réseau est construit — en ajoutant chaque niveau de commutateurs spine, nous répétons toute la bande passante qui était en bas. Plus un niveau — plus la même bande passante, encore autant qu'il y avait au niveau précédent, ports sur les commutateurs, encore autant de transceivers. Par conséquent, le nombre de niveaux de commutateurs spine doit être minimisé autant que possible.
À partir de cette image, il est clair que nous voulons construire sur quelque chose de type commutateurs avec un radix de 128.
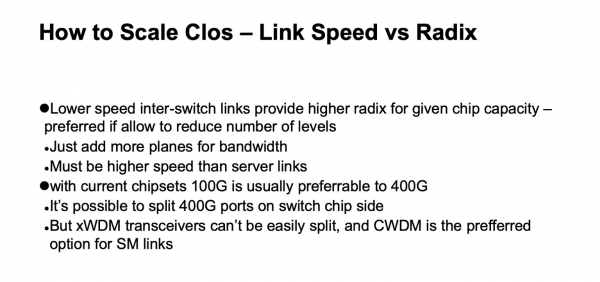
Ici, c'est en principe la même chose que je viens d'expliquer, cette diapositive est plutôt à considérer plus tard.
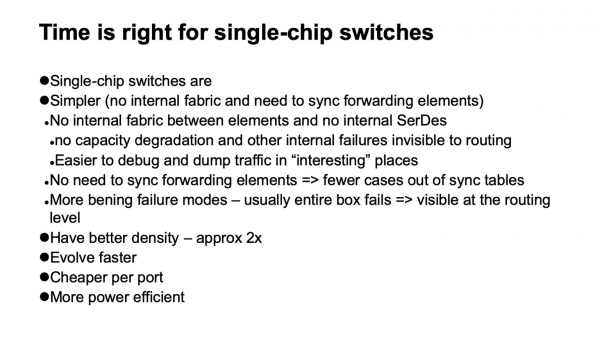
Quelles options avons-nous pour choisir de tels commutateurs ? Une bonne nouvelle pour nous est que nous pouvons enfin construire de tels réseaux sur des commutateurs à puce unique. Et c'est génial, ils ont beaucoup d'avantages agréables. Par exemple, ils ont presque une absence de structure interne. Cela signifie qu'ils sont plus faciles à casser. Ils se cassent, bien sûr, mais heureusement, en entier. Dans les dispositifs modulaires, il y a de nombreux types de pannes (très désagréables), lorsque du point de vue des voisins et du control plane, cela semble fonctionner, mais par exemple, une partie de la fabrique est tombée en panne, et il ne fonctionne pas à pleine capacité. Et le trafic est équilibré sur la base de ce qui semble entièrement fonctionnel, et nous pouvons nous retrouver en surcharge.
Ou, par exemple, des problèmes surviennent avec le backplane, car l'appareil modulaire contient également des SerDes à haute vitesse - il est vraiment complexe à l'intérieur. Ou ses tables se synchronisent ou ne se synchronisent pas entre les éléments de forwarding. En gros, tout appareil modulaire performant, composé d'un grand nombre d'éléments, contient généralement le même réseau Clos, mais qui est très difficile à diagnostiquer. Souvent, même au fournisseur, il est difficile de diagnostiquer.
Il existe de nombreux scénarios de défaillance où l'appareil se dégrade sans toutefois disparaître complètement de la topologie. Étant donné que notre réseau est vaste, avec une utilisation active de l'équilibrage entre des éléments identiques, et que le réseau est très régulier — c'est-à-dire qu'un chemin où tout va bien ne diffère en rien d'un autre chemin — il est plus avantageux pour nous de perdre simplement une partie des appareils de la topologie que de se retrouver dans une situation où certains semblent fonctionner, mais pas d'autres.
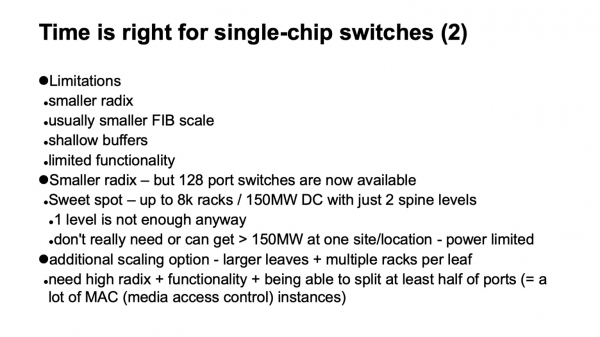
Une autre caractéristique agréable des appareils à puce unique est qu'ils évoluent mieux et plus rapidement. En outre, ils ont généralement une meilleure capacité. Si l'on considère de grandes structures assemblées, la capacité par unité de rack pour des ports de la même vitesse s'avère presque deux fois meilleure que celle des appareils modulaires. Les appareils construits autour d'une seule puce sont nettement moins coûteux que les modulaire et consomment moins d'énergie.
Mais, bien sûr, tout cela n'est pas sans inconvénients. Tout d'abord, il y a presque toujours un radix plus petit que celui des appareils modulaires. Si nous pouvons obtenir un appareil construit autour d'une seule puce avec 128 ports, un appareil modulaire peut en accepter plusieurs centaines sans trop de problèmes.
C'est une taille de table de routage nettement plus petite et, en général, cela concerne la scalabilité du plan de données. Tampons peu profonds. Et, en général, une fonctionnalité assez limitée. Cependant, il s'avère que si l'on connaît ces limites et qu'on prend la peine de les contourner ou simplement de les prendre en compte, ce n'est pas si alarmant. Avec un radix plus petit, les appareils récemment apparus avec un radix de 128 ne posent déjà plus de problème, nous pouvons établir une architecture avec deux couches de spines. Et avec moins de deux, il n'est de toute façon pas possible de construire quelque chose d'intéressant pour nous. Avec un seul niveau, on se retrouve avec des clusters très petits. Même nos conceptions et exigences précédentes les dépassaient toujours.
En réalité, s'il arrive qu'une solution soit à la limite, il existe encore une façon de se redimensionner. Étant donné que le dernier (ou premier) niveau le plus bas, où sont connectés les serveurs, concerne les commutateurs ToR ou les commutateurs leaf, nous ne sommes pas obligés de connecter une seule armoire à eux. Donc, si la solution n'est pas à la hauteur, on peut envisager simplement d'utiliser un commutateur avec un plus grand radix au niveau inférieur et de connecter, par exemple, deux à trois armoires à un seul commutateur. C'est aussi une option, qui a ses propres coûts, mais qui fonctionne tout à fait et peut s'avérer être une bonne solution lorsque l'on a besoin de doubler la taille.
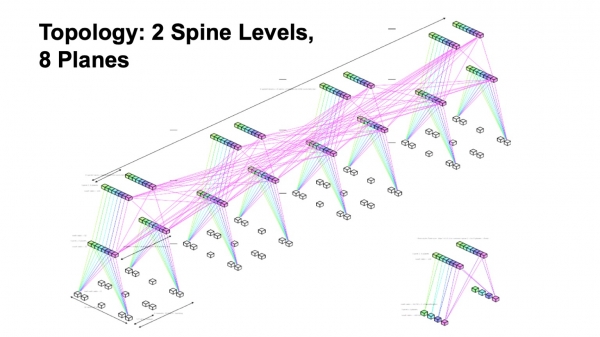
Pour résumer, nous construisons selon une topologie à deux niveaux de spine, avec huit couches de fabric.
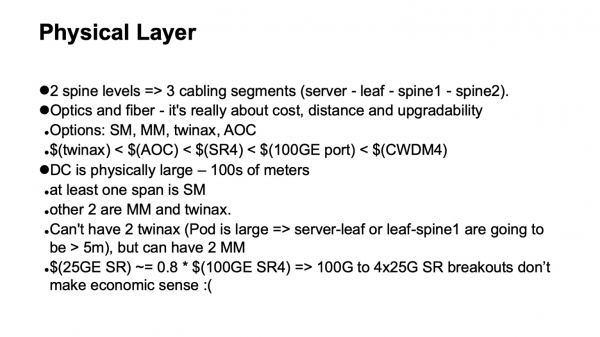
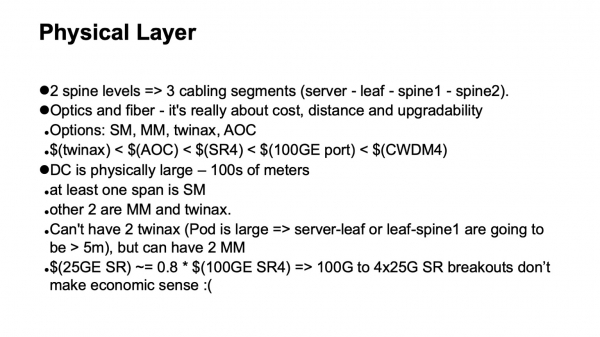
Qu'en est-il de la physique ? Des calculs très simples. Si nous avons deux niveaux de spine, cela signifie que nous avons trois niveaux de commutateurs au total, et nous nous attendons à ce qu'il y ait trois segments de câbles dans le réseau : des serveurs aux commutateurs leaf, à spine 1, à spine 2. Les options que nous pouvons utiliser sont le twinax, le multimode et le mode simple. Et ici, il faut tenir compte de la bande passante disponible, du coût, des dimensions physiques, des portées que nous pouvons atteindre, et de la manière dont nous allons nous mettre à niveau.
En termes de coûts, tout peut être aligné. Les twinax coûtent sensiblement moins cher que l'optique active, moins cher que les transceivers multimode, si l'on prend en compte la portée, légèrement moins cher qu'un port de commutateur à 100 gigabits. Et il est, attention, moins cher que l'optique en mode simple, car sur les portées où le mode simple est requis, il est logiquement judicieux d’utiliser le CWDM dans les centres de données pour diverses raisons, travailler avec le mode simple parallèle (PSM) n'est pas très pratique, cela produit de très grandes quantités de fibre, et si on s'arrête à ces technologies, on obtient à peu près cette hiérarchie de prix.
Une autre remarque : malheureusement, il n'est pas très facile d'utiliser les ports multimodes de 100 divisés en 4x25. En raison des particularités de conception, les transceivers SFP28 ne coûtent pas beaucoup moins cher que le QSFP28 à 100 Gbits. Et ce démantèlement ne fonctionne pas très bien pour le multimode.
Une autre limitation est que, en raison de la taille des clusters de calcul et du nombre de serveurs, nos centres de données deviennent physiquement très grands. Cela signifie qu'au moins un segment devra être réalisé avec du mono-mode. De plus, en raison de la taille physique des Pods, il ne sera pas possible de passer deux segments twinax (câbles cuivre).
En fin de compte, si nous optimisons le coût et considérons la géométrie de cette construction, nous obtenons un segment twinax, un segment multimode et un segment mono-mode utilisant CWDM. Cela prend en compte les chemins de mise à niveau possibles.
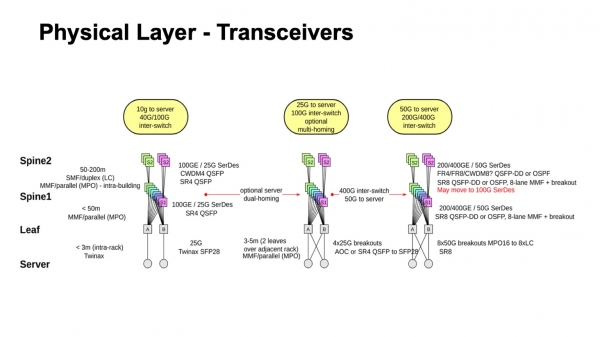
C'est à peu près ce à quoi cela ressemble, ce qu'il y avait récemment, où nous allons et ce qui est possible. Il est clair, au moins, comment avancer vers les SerDes de 50 gigabits, à la fois pour le multimode et le mono-mode. De plus, si nous regardons ce qui existe actuellement dans les émetteurs-récepteurs mono-mode et les perspectives pour 400 G, il arrive souvent que, lorsque des SerDes de 50 G arrivent côté électrique, la fibre peut déjà sortir à 100 Gbps par voie. Il est donc tout à fait possible qu'au lieu de passer à 50, nous soyons passés à des SerDes de 100 gigabits et 100 Gbps par voie, car de nombreux fournisseurs annoncent leur disponibilité relativement bientôt. La période où les SerDes de 50 G étaient les plus rapides semble ne pas durer très longtemps, car les premiers exemplaires de SerDes de 100 G devraient être lancés l'année prochaine. Et peu de temps après cela, ils pourraient coûter un prix raisonnable.
Un autre point concernant le choix de la physique. En principe, nous pouvons déjà utiliser des ports de 400 ou 200 gigabits avec des SerDes de 50 G. Mais il s'avère qu'il n'y a pas de sens particulier à cela, car, comme je l'ai dit précédemment, nous voulons une assez grande radix sur les commutateurs, dans des limites raisonnables, bien sûr. Nous voulons 128. Et si notre capacité de puce est limitée et que nous augmentons la vitesse du lien, la radix diminue naturellement, il n'y a pas de miracle.
Et nous pouvons augmenter la capacité totale grâce aux plans, et il n'y a pas de coûts particuliers, nous pouvons ajouter le nombre de plans. Et si nous perdons la radix, nous devrons introduire un niveau supplémentaire, donc avec les dispositions actuelles, avec la capacité maximale disponible par puce, il s'avère qu'il est plus efficace d'utiliser des ports de 100 gigabits, car ils permettent d'obtenir une plus grande radix.
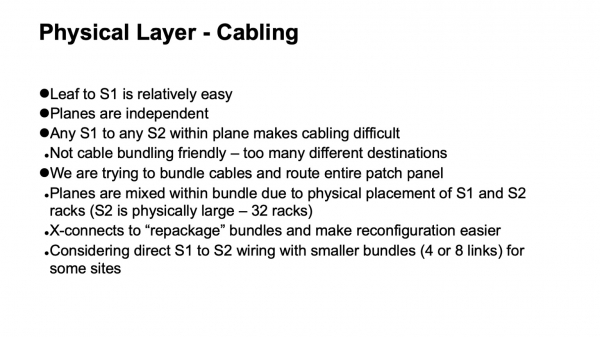
La question suivante concerne l'organisation physique, mais déjà du point de vue de l'infrastructure des câbles. Il s'avère qu'elle est organisée de manière assez amusante. Le câblage entre les commutateurs leaf et les spines de premier niveau — il n'y a pas tant de liens, tout est construit relativement simplement. En revanche, si nous prenons un plan, ce qui se passe à l'intérieur — il faut connecter tous les spines de premier niveau avec tous les spines de second niveau.
De plus, il y a généralement certaines exigences quant à l'apparence à l'intérieur du data center. Par exemple, nous tenions beaucoup à regrouper les câbles en faisceau et à les tirer de telle sorte qu'un panneau de brassage haute densité aille entièrement à un panneau de brassage, afin d'éviter le désordre des longueurs. Nous avons réussi à résoudre ce problème. Si l'on regarde la topologie logique à première vue, on constate que les plans sont indépendants, chaque plan peut être construit par lui-même. Mais lorsque nous ajoutons un tel regroupement et que nous voulons tirer entièrement un panneau de brassage dans un autre, il faut alors mélanger différents plans à l'intérieur d'un même faisceau et introduire une construction intermédiaire sous forme de connexions optiques croisées, afin de les reconditionner de la manière dont ils avaient été assemblés dans un segment, vers la manière dont ils seront assemblés dans un autre segment. Grâce à cela, nous obtenons une caractéristique intéressante : toute la commutation complexe ne sort pas des limites des racks. Lorsque quelque chose doit être très fortement entremêlé, «déployer les plans», comme on l'appelle parfois dans les réseaux Clos, tout cela est concentré à l'intérieur d'un même rack. Nous n'avons pas de commutations très dispersées, allant jusqu'à des liens individuels, entre les racks.
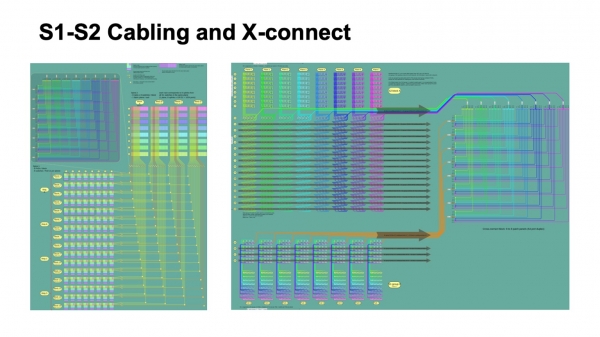
Voici à quoi cela ressemble du point de vue de l'organisation logique de l'infrastructure des câbles. Sur l'image à gauche, les blocs colorés représentent les blocs de commutateurs de cœur de premier niveau, au nombre de huit, et les quatre faisceaux de câbles qui en sortent, qui se croisent avec les faisceaux provenant des blocs de commutateurs de cœur de second niveau.
Les petits carrés représentent des intersections. En haut à gauche, vous trouverez le déploiement de chaque intersection. Il s'agit en fait d'un module de cross-connect de 512 à 512 ports, qui réorganise les câbles de manière à se rassembler complètement dans une seule armoire, où il n'y a qu'un seul plan spine-2. À droite, le déploiement de cette image est légèrement plus détaillé en ce qui concerne plusieurs Pods au niveau spine-1, et comment cela s'assemble dans le cross-connect, comment cela arrive au niveau spine-2.
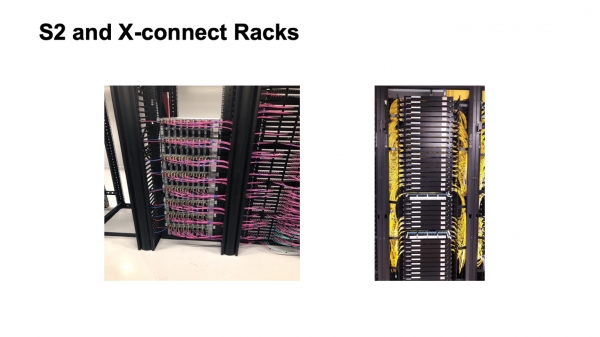
Voici à quoi cela ressemble. Une armoire spine-2 pas encore complètement assemblée (à gauche) et l'armoire de cross-connect. Malheureusement, il n'y a pas grand-chose à voir. Toute cette structure est en cours de déploiement en ce moment dans l'un de nos grands centres de données, qui est en expansion. C'est un travail en cours, cela sera plus esthétique et mieux rempli.
Une question importante : nous avons choisi la topologie logique, construit la physique. Que va-t-il se passer avec le plan de contrôle ? Il est assez bien connu par l'expérience opérationnelle qu'il y a un certain nombre de retours d'expérience, que les protocoles link state sont bons, qu'ils sont agréables à utiliser, mais en raison des topologies densément connectées, ils ont du mal à évoluer. Et il y a un facteur principal qui entrave cela : c'est la façon dont le flooding fonctionne dans les protocoles link state. Si l'on prend simplement l'algorithme de flooding et qu'on examine comment notre réseau est construit, on voit qu'à chaque étape, il y aura un très grand fan-out, ce qui inondera simplement le plan de contrôle sous des mises à jour. Ces types de topologies avec un algorithme de flooding traditionnel dans les protocoles link state se mélangent très mal.
Le choix est d'utiliser BGP. Comment le préparer correctement est décrit dans le RFC 7938 concernant l'utilisation de BGP dans de grands centres de données. Les idées de base sont simples : un nombre minimal de préfixes par hôte et, en général, un nombre minimal de préfixes dans le réseau, utiliser l'agrégation si possible et supprimer le path hunting. Nous voulons une diffusion d'updates très prudente, très contrôlée, ce que l'on appelle valley free. Nous voulons que les updates, en parcourant le réseau, se déploient exactement une fois. S'ils proviennent du bas, ils montent, se déploient pas plus d'une fois. Il ne devrait pas y avoir de zigzags. Les zigzags sont très mauvais.
Pour ce faire, nous utilisons un schéma assez simple pour exploiter les mécanismes BGP de base. Cela signifie que nous utilisons l'eBGP, fonctionnant sur le lien local, et les systèmes autonomes sont attribués comme suit : un système autonome sur le ToR, un système autonome pour tout le bloc de commutateurs spine-1 d'un Pod, et un système autonome commun pour tout le Top of Fabric. Il n'est pas difficile de voir et de constater qu'avec cela, même le comportement normal de BGP nous donne la diffusion des mises à jour que nous souhaitons.
Naturellement, il est nécessaire de concevoir l'adressage et l'agrégation des adresses de manière à ce que cela soit compatible avec la façon dont le routage est structuré, afin d'assurer la stabilité du plan de contrôle. L'adressage L3 dans le transport est lié à la topologie, car sans cela, il n'est pas possible d'obtenir l'agrégation ; sans cela, les adresses individuelles pénétreront dans le système de routage. Une autre chose est que l'agrégation, malheureusement, ne s'associe pas très bien avec le multi-path, car lorsque nous avons du multi-path et de l'agrégation, tout va bien tant que tout le réseau fonctionne, sans pannes. Malheureusement, dès qu'il y a des pannes dans le réseau et que la symétrie de la topologie est perdue, nous pouvons arriver à un point d'où le groupe est annoncé, mais d'où il est impossible de passer là où nous devons aller. C'est pourquoi il est préférable d'agréger là où il n'y a plus de multi-path, dans notre cas, ce sont les commutateurs ToR.
En réalité, il est possible d'agréger, mais prudemment. Si nous pouvons effectuer une désagrégation contrôlée lors de pannes dans le réseau. Mais c'est une tâche assez complexe ; nous avons même envisagé si cela pourrait être possible, si nous pouvions ajouter une automatisation supplémentaire, et des automates qui pourraient sérieusement gérer BGP pour obtenir le comportement souhaité. Malheureusement, le traitement des cas particuliers est très obscur et complexe, et en attachant du matériel externe à BGP, cette tâche n'est pas bien résolue.
Un travail très intéressant a été réalisé à cet égard dans le cadre du protocole RIFT, qui sera abordé dans la prochaine présentation.
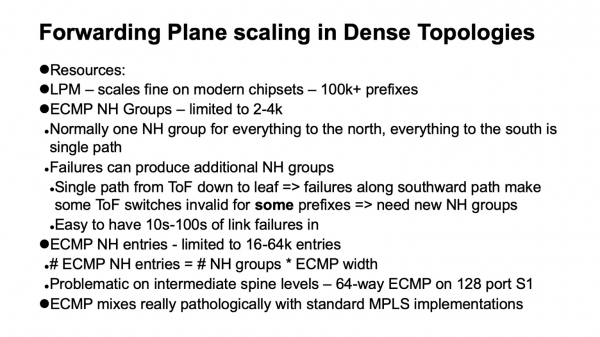
Une autre chose importante est comment les plans de données se scalent dans des topologies denses, où il y a de nombreux chemins alternatifs. Cela implique plusieurs structures de données supplémentaires : des groupes ECMP, qui décrivent à leur tour les groupes Next Hop.
Dans un réseau fonctionnant normalement, sans pannes, lorsque nous avançons dans la topologie Clos, il suffit d'utiliser un seul groupe, car tout ce qui n'est pas local est décrit par défaut, ce qui permet de monter. Lorsque nous descendons vers le sud, tous les chemins ne sont pas ECMP, ce sont des chemins uniques. Tout va bien. Le problème, et la spécificité de la topologie Clos classique, c'est que si nous regardons le Top of fabric, chaque élément a un seul chemin vers n'importe quel élément en bas. Si des pannes se produisent le long de ce chemin, cet élément en haut du fabric devient invalide pour les préfixes qui se trouvent derrière le chemin défaillant. Et pour les autres, il est valide, ce qui nous oblige à décomposer les groupes ECMP et à introduire un nouvel état.
À quoi ressemble la scalabilité du data plane sur les équipements modernes ? Si nous faisons un LPM (longest prefix match), tout fonctionne assez bien, au-delà de 100 000 préfixes. Si nous parlons des groupes Next Hop, c'est moins bien, entre 2 000 et 4 000. En ce qui concerne la table contenant la description des Next Hops (ou adjacences), cela varie de 16 000 à 64 000. Et cela peut devenir problématique. Nous en venons ainsi à une réflexion intéressante : qu'est-il arrivé à MPLS dans les data centers ? En principe, nous voulions le mettre en place.
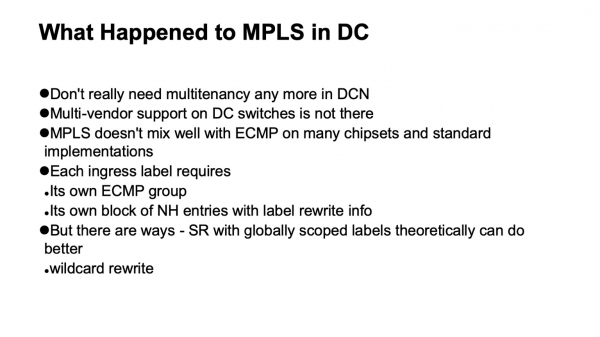
Deux choses se sont produites. Nous avons mis en œuvre la micro-segmentation sur les hôtes, nous n'avions donc plus besoin de le faire sur le réseau. Ce n'était pas très bien soutenu par différents fournisseurs, surtout avec des implémentations ouvertes sur des white boxes avec MPLS. De plus, MPLS, du moins ses implémentations traditionnelles, s'accorde malheureusement très mal avec ECMP. Et voilà pourquoi.
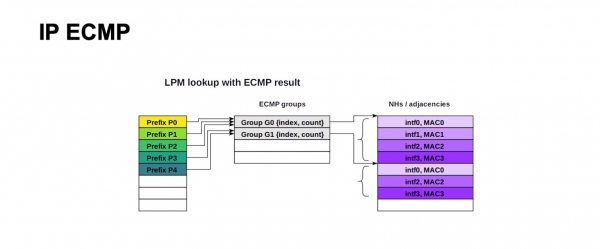
Voici à quoi ressemble la structure du routage ECMP pour IP. Un grand nombre de préfixes peut utiliser le même groupe et le même bloc de Next Hops (ou adjacences, qui peuvent être appelés différemment dans la documentation selon les appareils). L'idée est que cela est décrit comme un port sortant et sur quoi réécrire l'adresse MAC pour atteindre le bon Next Hop. Pour IP, c'est assez simple, on peut utiliser un très grand nombre de préfixes pour un même groupe, le même bloc de Next Hops.
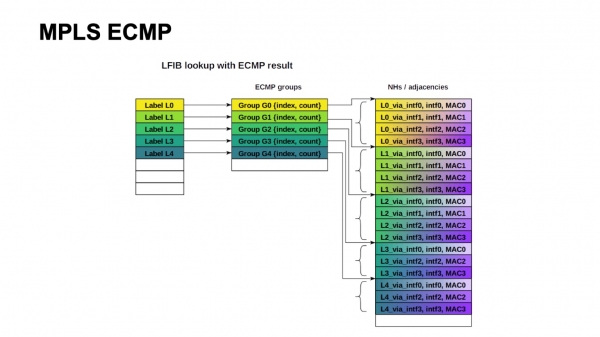
L'architecture classique de MPLS implique que selon l'interface sortante, l'étiquette peut être réécrite avec différentes valeurs. Par conséquent, nous devons conserver un groupe et un bloc de Next Hops pour chaque étiquette entrante. Et cela, hélas, ne se scalable pas.
Il est facile de voir que notre conception nécessitait environ 4000 switchs ToR, avec une largeur maximale de 64 chemins ECMP, si l'on passe d'un spine-1 à un spine-2. Nous avons du mal à rentrer, à la limite, dans une seule table de groupes ECMP, si un seul préfixe avec ToR est utilisé, et nous ne rentrons pas du tout dans la table Next Hops.
Tout n'est pas désespéré, car des architectures comme le Segment Routing impliquent des étiquettes globales. Formellemnt, il serait possible de regrouper à nouveau tous ces blocs Next Hops. Pour cela, une opération de type wildcard serait nécessaire : prendre une étiquette et la réécrire sans valeur spécifique. Mais malheureusement, ce n'est pas très présent dans les implémentations disponibles.
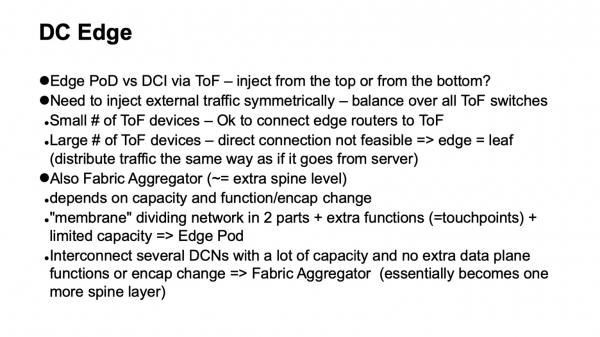
Enfin, nous devons faire entrer le trafic externe dans le data center. Comment faire cela ? Auparavant, le trafic était introduit dans les réseaux Clos par le haut. C’est-à-dire qu'il y avait des routeurs de frontière qui se connectaient à tous les dispositifs en haut du tissu. Cette solution fonctionne très bien à des échelles petites et moyennes. Malheureusement, pour injecter le trafic de manière symétrique dans tout le réseau, il faut intervenir simultanément sur tous les éléments en haut du tissu, et lorsque leur nombre dépasse une centaine, il s'avère que nous avons besoin d'un grand radix aussi sur les routeurs de frontière. En réalité, cela coûte cher, car les routeurs de frontière sont plus fonctionnels, et leurs ports sont plus coûteux, ce qui donne une construction peu élégante.
Une autre option consiste à introduire le trafic de bas en haut. Il est facile de constater que la topologie Clos est conçue de manière à ce que le trafic entrant par le bas, c'est-à-dire du côté du ToR, soit réparti uniformément sur les niveaux de tout le tissu en deux itérations, chargeant ainsi tout le réseau. C'est pourquoi nous introduisons un type spécial de Pod, l'Edge Pod, qui assure la connectivité externe.
Il existe une autre option. Par exemple, c'est ce que fait Facebook. Ils appellent cela Fabric Aggregator ou HGRID. Un niveau de spine supplémentaire est introduit pour connecter plusieurs centres de données. Cette configuration est possible si nous n'avons pas d'autres fonctions ou de changement d'encapsulation aux intersections. S'il y en a, ce sont des points de contact supplémentaires, et c'est complexe. En général, il y a plus de fonctionnalités et une sorte de membrane séparant différentes parties du centre de données. Il ne vaut pas la peine de faire cette membrane trop grande, mais s'il est nécessaire de l'avoir pour une raison quelconque, il est judicieux d'envisager de l'étendre, de la rendre aussi large que possible et de la transférer sur des hôtes. C'est ce que font de nombreux opérateurs cloud. Ils ont des overlays qui commencent avec des hôtes.
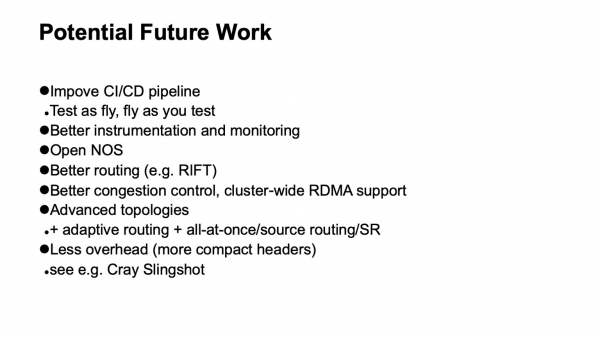
Quelles opportunités de développement voyons-nous ? Tout d'abord, l'amélioration du support du pipeline CI/CD. Nous voulons voler comme nous testons, et tester comme nous volons. Ce n'est pas très bien réussi, car l'infrastructure est grande, il est impossible de la dupliquer pour les tests. Il faut comprendre comment introduire des éléments de test dans l'infrastructure de production sans la faire tomber.
Un meilleur instrumentage, une meilleure surveillance ne sont presque jamais superflus. La question réside dans l'équilibre entre les efforts et le rendement. Si l'on peut ajouter des moyens raisonnables, c'est très bien.
Systèmes d'exploitation ouverts pour appareils réseau. Les meilleurs protocoles et les meilleurs systèmes de routage, par exemple RIFT. Des recherches sont également nécessaires sur l'application des meilleures schémas de contrôle de congestion et, peut-être, l'introduction, au moins à certains points, du support RDMA au sein du cluster.
En regardant vers un futur plus lointain, des topologies avancées seront nécessaires et, peut-être, des réseaux utilisant moins de surcharge. Parmi les nouveautés, il y a eu récemment des publications sur la technologie de fabrication pour HPC Cray Slingshot, qui repose sur l'Ethernet standard, mais avec l'option d'utiliser des en-têtes beaucoup plus courts. Cela réduit la surcharge.
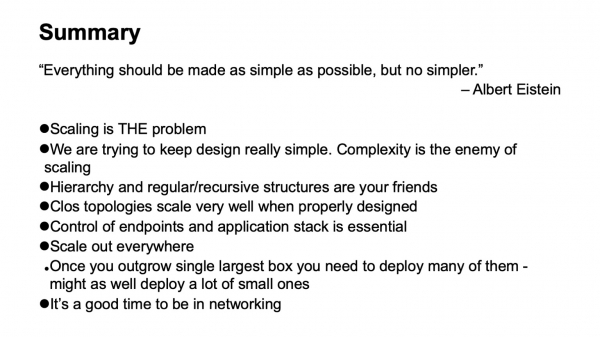
Tout doit être fait aussi simplement que possible, mais pas plus simplement. La complexité est l'ennemi de la scalabilité. La simplicité et les structures régulières sont nos alliées. Si vous pouvez effectuer un scale out quelque part, faites-le. Et en général, c'est formidable de s'occuper des technologies réseau. Beaucoup de choses intéressantes se passent. Merci.
Source : habr.com
