

Nous vivons une époque incroyable où il est possible de relier rapidement et simplement plusieurs outils open source prêts à l'emploi, de les configurer avec un « esprit déconnecté » selon les conseils de stackoverflow, sans se plonger dans des termes complexes, et de les lancer en exploitation commerciale. Et quand il faudra mettre à jour/étendre ou si quelqu'un redémarre accidentellement quelques machines, on réalisera que l'on a commencé à rêver un mauvais rêve obsédant, que tout est devenu étrangement compliqué à en devenir méconnaissable, qu'il n'y a pas de retour en arrière, que l'avenir est incertain et qu'il vaut mieux, plutôt que de programmer, se consacrer à l'apiculture et à la fabrication de fromage.
Ce n'est pas en vain que des collègues plus expérimentés, les cheveux déjà grisonnants à force de faire face à de nombreux bugs, contemplent le déploiement incroyablement rapide de paquets « containers » dans des « cubes » sur des dizaines de serveurs dans des « langages à la mode » avec un support intégré pour l'entrée/sortie asynchrone non bloquante — ils sourient modestement. Et ils continuent silencieusement à relire le « man ps », se plongent jusqu'à avoir les yeux en sang dans le code source de « nginx » et écrivent, écrivent, écrivent des tests unitaires. Les collègues savent que le plus intéressant est à venir, lorsque « tout cela » deviendra un cauchemar au réveillon du Nouvel An. Et la seule chose qui les sauvera sera une compréhension profonde de la nature d'unix, de la table d'états TCP/IP dans la tête et des algorithmes de tri et de recherche de base. Pour redonner vie au système au son des cloches.
Ah oui, je me suis un peu éloigné, mais j'espère avoir transmis un état d'anticipation.
Aujourd'hui, je veux partager notre expérience de déploiement d'une pile pratique et abordable pour DataLake, répondant à la majorité des besoins analytiques de l'entreprise pour des départements structurels très variés.
Il y a quelque temps, nous avons réalisé que les entreprises avaient de plus en plus besoin des résultats tant de l'analytique produit que technique (sans parler des cerises sur le gâteau que sont le machine learning) et qu'il fallait collecter et analyser de plus en plus de métriques pour comprendre les tendances et les risques.
L'analytique technique de base dans « Bitrix24 »
Il y a quelques années, en même temps que le lancement du service « Bitrix24 », nous avons investi activement du temps et des ressources dans la création d'une plateforme analytique simple et fiable, qui permettrait de repérer rapidement les problèmes dans l'infrastructure et de planifier les étapes suivantes. Bien entendu, il était préférable de choisir des outils prêts à l'emploi, simples et compréhensibles. En fin de compte, nous avons choisi nagios pour le monitoring et munin pour l'analyse et la visualisation. Maintenant, nous avons des milliers de vérifications dans nagios, des centaines de graphiques dans munin, et nos collègues les utilisent quotidiennement et avec succès. Les métriques sont claires, les graphiques sont limpides, le système fonctionne de manière fiable depuis plusieurs années et de nouveaux tests et graphiques y sont régulièrement ajoutés : lorsque nous mettons un nouveau service en production, nous ajoutons quelques tests et graphiques. Bon voyage.
Avoir le pouls — analytics techniques avancées
Le désir d'obtenir des informations sur les problèmes « le plus rapidement possible » nous a conduits à expérimenter activement avec des outils simples et compréhensibles — pinba et xhprof.
Pinba nous envoyait par paquets UDP des statistiques sur la vitesse de fonctionnement des parties des pages web sur PHP et il était possible de voir en temps réel dans le stockage MySQL (pinba utilise son propre moteur MySQL pour une analyse rapide des événements) une courte liste de problèmes et d’y réagir. Xhprof permettait en mode automatique de collecter les graphes d'exécution des pages PHP les plus lentes chez les clients et d'analyser ce qui pouvait en être la cause — tranquillement, en se servant une tasse de thé ou quelque chose de plus fort.
Il y a quelque temps, les outils ont été enrichis d'un autre moteur assez simple et compréhensible basé sur un algorithme d'indexation inversée, magnifiquement réalisé dans la légendaire bibliothèque Lucene — Elastic/Kibana. La simple idée d'enregistrement multithread de documents dans l'index inversé de Lucene basé sur des événements dans les journaux et de recherche rapide à l'aide d'une division en facettes s'est avérée, en effet, très utile.
Malgré l'aspect assez technique des visualisations dans Kibana avec des concepts de bas niveau tels que « bucket » et un langage réinventé de l'algèbre relationnelle qui n'est pas encore oublié — l'outil nous a été très utile pour les tâches suivantes :
- Combien d'erreurs PHP a eu le client Bitrix24 sur le portail p1 au cours de la dernière heure et lesquelles ? Comprendre, pardonner et corriger rapidement.
- Combien d'appels vidéo ont été effectués sur les portails en Allemagne au cours des dernières 24 heures, avec quelle qualité et y a-t-il eu des problèmes avec le canal/réseau ?
- Comment fonctionne la fonctionnalité système (notre extension en C pour PHP), compilée à partir des sources dans la dernière mise à jour du service et déployée aux clients ? Y a-t-il des segfaults ?
- Les données des clients sont-elles stockées dans la mémoire PHP ? Y a-t-il des erreurs de dépassement de mémoire allouée aux processus : « out of memory » ? Trouvez et corrigez-le.
Voici un exemple concret. Malgré des tests approfondis et multilbles, un client a rencontré une erreur déroutante et inattendue dans un cas très atypique avec des données d'entrée corrompues, une alarme s'est déclenchée et le processus de correction rapide a commencé :
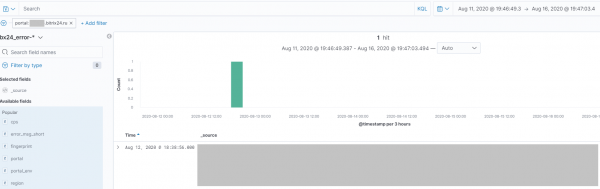
De plus, Kibana permet d'organiser des alertes sur des événements spécifiés et en peu de temps, des dizaines d'employés de différents départements — de l'assistance technique au développement en passant par le QA — ont commencé à utiliser cet outil.
L'activité de chaque département au sein de l'entreprise est désormais facile à suivre et à mesurer — au lieu d'une analyse manuelle des journaux sur les serveurs, il suffit de configurer une fois le parsing des journaux et leur envoi vers un cluster Elastic, pour apprécier, par exemple, le nombre de chatons à deux têtes imprimés en 3D vendus au cours du dernier mois lunaire sur un tableau de bord Kibana.
Analyse d'affaires de base
Tout le monde sait que l'analyse d'affaires dans les entreprises commence souvent par une utilisation extrêmement active, oui, oui, d'Excel. Mais, surtout, il ne faut pas que cela s'arrête là. Le cloud Google Analytics alimente encore un peu plus le feu — on s'habitue rapidement aux bonnes choses.
Dans notre entreprise en pleine croissance, des « prophètes » d'une travail plus intensif avec des données plus volumineuses ont commencé à apparaître ici et là. Il est devenu nécessaire de produire des rapports plus approfondis et variés et, grâce aux efforts des équipes de différents départements, une solution simple et pratique a été mise en place il y a quelque temps — la combinaison de ClickHouse et PowerBI.
Pendant un certain temps, cette solution flexible a bien fonctionné, mais il est devenu progressivement clair que ClickHouse n'est pas élastique et qu'on ne peut pas l'exploiter de cette manière.
Il est important de comprendre que ClickHouse, tout comme Druid, Vertica et Amazon RedShift (qui est basé sur Postgres), sont des moteurs d'analyse optimisés pour une analyse assez conviviale (sommes, agrégations, minimum-maximum sur une colonne et quelques jointures), car ils sont conçus pour un stockage efficace des colonnes des tables relationnelles, contrairement à MySQL et aux autres bases de données orientées ligne.
En essence, ClickHouse n'est rien de plus qu'une « base » de données plus spacieuse, avec une insertion ponctuelle pas très pratique (c'est intentionnel, tout va bien), mais avec une analyse agréable et un ensemble de fonctions puissantes pour travailler avec les données. Oui, on peut même créer un cluster — mais vous comprenez que battre des clous avec un microscope n'est pas tout à fait correct et nous avons commencé à chercher d'autres solutions.
La demande pour Python et les analystes
Dans notre entreprise, il y a beaucoup de développeurs qui codent presque tous les jours depuis 10 à 20 ans en PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash. Il y a également de nombreux administrateurs systèmes expérimentés, ayant vécu des catastrophes incroyables qui ne rentrent pas dans les lois de la statistique (par exemple, quand la plupart des disques en RAID-10 sont détruits par un coup de foudre). Dans ces conditions, il était longtemps difficile de comprendre ce qu'était un « analyste Python ». Python, c'est comme PHP, juste un nom un peu plus long et avec moins de traces de substances altérant la conscience dans le code source de l'interpréteur. Cependant, alors que de nouveaux rapports analytiques étaient continuellement créés, les développeurs expérimentés ont réalisé de plus en plus l'importance d'une spécialisation dans des outils comme numpy, pandas, matplotlib, seaborn.
Le rôle décisif a probablement été joué par les évanouissements soudains des employés à cause de l'association des mots « régression logistique » et la démonstration de la construction efficace de rapports sur de grands volumes de données grâce à, oui, pyspark.
Apache Spark, sa paradigme fonctionnelle sur laquelle l'algèbre relationnelle s'applique parfaitement, a tellement impressionné les développeurs habitués à MySQL que la nécessité de renforcer les rangs avec des analystes expérimentés est devenue aussi claire que le jour.
Les tentatives ultérieures d'Apache Spark/Hadoop de réussir et ce qui ne s'est pas exactement passé comme prévu
Cependant, il est vite devenu clair qu'il y avait quelque chose de systémique qui clochait avec Spark, ou peut-être qu'il fallait simplement mieux se laver les mains. Si la stack Hadoop/MapReduce/Lucene était développée par des programmeurs expérimentés, ce qui est évident si l'on examine minutieusement le code source en Java ou les idées de Doug Cutting dans Lucene, Spark, lui, est soudainement écrit dans un langage exotique en voie de disparition et discutable du point de vue de la praticité : Scala. La chute régulière des calculs sur un cluster Spark due à une gestion de la mémoire pour les opérations de réduction (un grand nombre de clés apparaissent d'un coup) a créé autour de lui une aura de quelque chose qui a encore beaucoup de chemin à parcourir. De plus, la situation était aggravée par un grand nombre de ports ouverts étranges, de fichiers temporaires qui poussaient dans les endroits les plus incompréhensibles et une multitude de dépendances jar — ce qui suscitait chez les administrateurs systèmes un sentiment bien connu depuis l'enfance : une haine féroce (à moins qu'il n'ait fallu se laver les mains avec du savon).
Nous avons donc "survécu" à plusieurs projets internes d'analyse, utilisant activement Apache Spark (y compris Spark Streaming, Spark SQL) et l'écosystème Hadoop (et tout le reste). Bien que, avec le temps, nous ayons appris à "préparer" cela correctement et à le surveiller, et qu'il ait pratiquement cessé de tomber de manière inattendue à cause de la nature changeante des données et du déséquilibre du hachage uniforme des RDD, le désir de prendre quelque chose de déjà prêt, mis à jour et administré quelque part dans le cloud est devenu de plus en plus pressant. C'est à cette époque que nous avons essayé d'utiliser une distribution cloud prête d'Amazon Web Services — et, par la suite, nous avons essayé de résoudre des problèmes sur cette plateforme. EMR c'est une version d'Apache Spark préparée par Amazon avec un logiciel supplémentaire de l'écosystème, un peu comme les distributions Cloudera/Hortonworks.
Un espace de stockage "flexible" pour l'analytique — un besoin urgent
L'expérience de "préparer" Hadoop/Spark avec des brûlures sur différentes parties du corps n'est pas passée inaperçue. La nécessité de créer un espace de stockage fiable et peu coûteux, résistant aux pannes matérielles, se dessinait de plus en plus clairement. Cet espace devrait permettre de stocker des fichiers dans différents formats en provenance de différents systèmes et d'effectuer des requêtes efficaces et exécutables dans des délais raisonnables pour les rapports.
Il était également souhaitable que la mise à jour des logiciels de cette plateforme ne devienne pas un cauchemar nocturne de Noël, avec la lecture de trace Java de 20 pages et l'analyse de kilomètres de journaux détaillés du fonctionnement du cluster à l'aide de Spark History Server et d'une loupe avec un éclairage. Nous voulions un outil simple et transparent, qui ne nécessite pas de plonger régulièrement sous le capot, si un développeur cesse d'exécuter une requête MapReduce standard lorsque les données de réduction sortent de la mémoire du worker à cause d'un algorithme de partitionnement mal choisi.
Amazon S3 — candidat pour un DataLake ?
L'expérience de travail avec Hadoop/MapReduce m'a appris qu'une système de fichiers fiable et évolutif est nécessaire, ainsi que des workers scalables, "proches" des données, afin de ne pas faire circuler les données sur le réseau. Les workers doivent être capables de lire des données dans différents formats, mais idéalement, sans lire d'informations superflues et en permettant de stocker les données au préalable dans des formats adaptés aux workers.
Encore une fois — l'idée principale. Nous n'avons pas envie de « déverser » de grandes données dans un moteur analytique clusterisé unique, qui finira par se noyer tôt ou tard et qu'il faudra alors shard mal. Nous souhaitons stocker des fichiers, juste des fichiers, dans un format compréhensible et exécuter sur eux des requêtes analytiques efficaces avec divers outils, mais clairs. Et le nombre de fichiers dans différents formats ne fera qu'augmenter. Il vaut donc mieux shard les données source que le moteur lui-même. Nous avons besoin d'un DataLake extensible et universel, avons-nous décidé...
Et si nous stockions des fichiers dans le traditionnel et bien connu stockage cloud évolutif d'Amazon S3, sans avoir à préparer nous-mêmes des côtelettes à partir de Hadoop ?
D'accord, les données personnelles ne peuvent pas être stockées là, mais d'autres données, si elles sont transférées et « efficacement traitées » ?
L'écosystème d'analyse big data clusterisé d'Amazon Web Services — en des termes très simples
D'après notre expérience avec AWS, Apache Hadoop/MapReduce est utilisé depuis longtemps et activement sous différentes formes, par exemple dans le service DataPipeline (je jalouse mes collègues, ils ont vraiment appris à bien le préparer). Ici, nous avons configuré des sauvegardes à partir de différents services des tables DynamoDB :
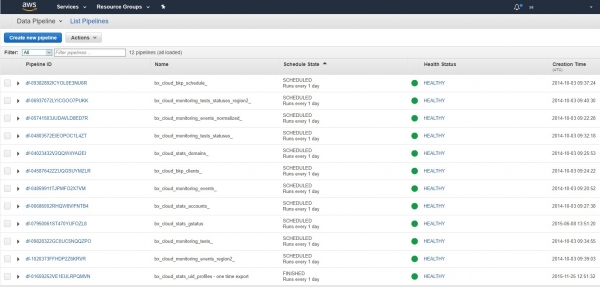
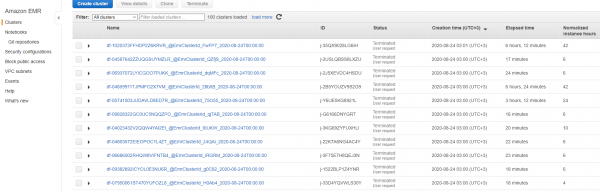
Et elles s'exécutent régulièrement sur des clusters Hadoop/MapReduce intégrés comme une horloge depuis plusieurs années. « Configuré et oublié » :
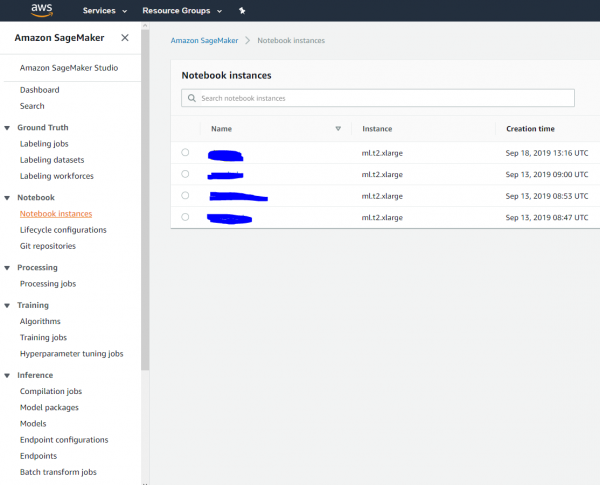
Il est également possible de pratiquer efficacement le data-satanisme en déployant des notebooks Jupiter dans le cloud pour les analystes et en utilisant le service AWS SageMaker pour l'entraînement et le déploiement des modèles d'IA. Voici à quoi cela ressemble chez nous :
Et oui, on peut déployer un notebook dans le cloud pour soi ou pour un analyste et le connecter à un cluster Hadoop/Spark, effectuer des calculs et ensuite tout "clouer" :
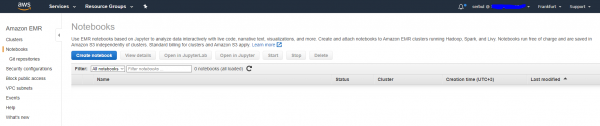
C'est vraiment pratique pour des projets analytiques individuels et pour certains, nous avons réussi à utiliser le service EMR pour des calculs et des analyses à grande échelle. Qu'en est-il de la solution systémique pour DataLake, sera-t-elle possible ? À ce moment-là, nous étions à la frontière de l'espoir et du désespoir et nous poursuivions notre recherche.
AWS Glue - une version d'Apache Spark "stéroïdée" bien emballée
Il s'est avéré qu'AWS a sa propre version de la stack "Hive/Pig/Spark". Le rôle de Hive, c'est-à-dire le catalogue des fichiers et de leurs types dans le DataLake, est rempli par le service "Data catalog", qui ne cache pas sa compatibilité avec le format Apache Hive. Il faut ajouter des informations à ce service sur l'emplacement de vos fichiers et sur leur format. Les données peuvent se trouver non seulement dans S3, mais aussi dans une base de données, mais ce n'est pas le sujet de ce post. Voici comment notre catalogue de données DataLake est organisé :
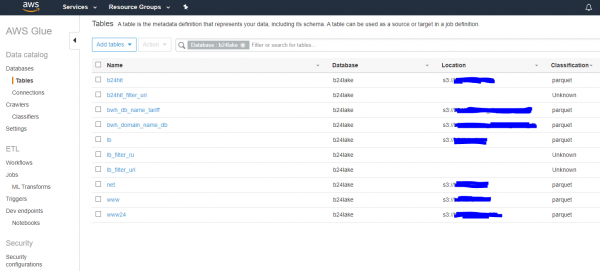
Les fichiers sont enregistrés, excellent. Si les fichiers sont mis à jour, nous lançons soit manuellement soit selon un calendrier des crawlers qui mettront à jour les informations à leur sujet depuis le lac et les sauvegarderont. Ensuite, les données du lac peuvent être traitées et les résultats peuvent être exportés quelque part. Dans le cas le plus simple, nous les exportons aussi vers S3. Le traitement des données peut être effectué n'importe où, mais il est suggéré de configurer le processus de traitement sur un cluster Apache Spark en utilisant les fonctionnalités avancées via l'API AWS Glue. En fait, on peut prendre le vieux et familier code en Python avec la bibliothèque pyspark et configurer son exécution sur N nœuds d'un cluster d'une certaine puissance avec monitoring, sans avoir à fouiller dans les entrailles de Hadoop, traîner des conteneurs Docker et résoudre les conflits de dépendances.
Encore une fois - une idée simple. Il n'est pas nécessaire de configurer Apache Spark, il suffit d'écrire du code en Python pour pyspark, de le tester localement sur le bureau, puis de le lancer sur un grand cluster dans le cloud, en indiquant où se trouvent les données sources et où mettre le résultat. Parfois, c'est nécessaire et utile, et voici comment cela est configuré chez nous :
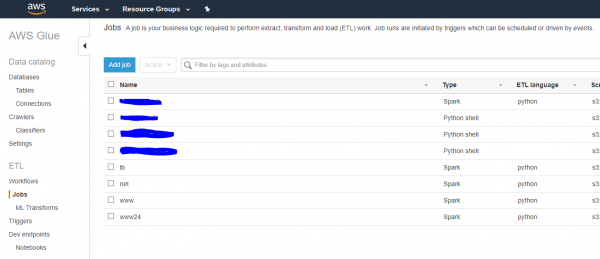
Ainsi, si vous devez effectuer des calculs sur un cluster Spark avec des données dans S3, écrivez du code en Python/pyspark, testez-le et en route vers le cloud.
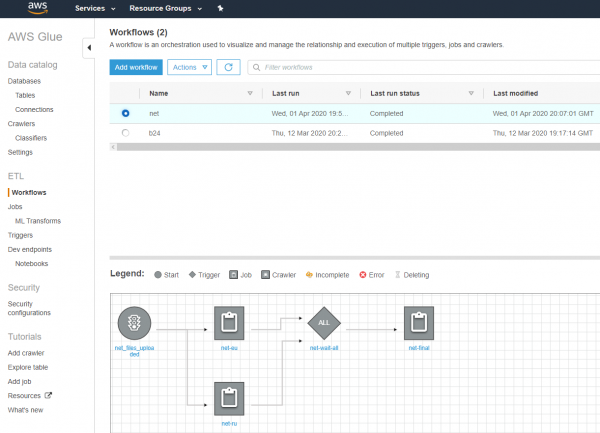
Qu'en est-il de l'orchestration ? Que se passe-t-il si une tâche échoue et disparaît ? Oui, on propose de créer un pipeline esthétique à la manière d'Apache Pig, et nous l'avons même essayé, mais nous avons décidé de continuer à utiliser notre orchestration profondément personnalisée en PHP et JavaScript (je comprends qu'il y a un décalage cognitif, mais ça fonctionne, et ce, sans erreurs depuis des années).
Le format des fichiers stockés dans le lac de données est la clé de la performance.
Il est très, très important de comprendre deux autres points clés. Afin que les requêtes sur les fichiers dans le lac de données soient exécutées le plus rapidement possible et que la performance ne se dégrade pas lors de l'ajout de nouvelles informations, il faut :
- Stocker les colonnes des fichiers séparément (pour ne pas avoir à lire toutes les lignes pour comprendre ce qu'il y a dans les colonnes). Pour cela, nous avons choisi le format Parquet avec compression.
- Il est très important de shard les fichiers en dossiers comme : langue, année, mois, jour, semaine. Les moteurs qui comprennent ce type de sharding ne regarderont que dans les bons dossiers, sans avoir à fouiller dans toutes les données en continu.
En fait, de cette manière, vous préparez les données brutes dans le format le plus efficace pour les moteurs analytiques qui peuvent accéder sélectivement aux dossiers shardés et lire uniquement les colonnes nécessaires. Il n'est pas nécessaire de "charger" les données ailleurs (le stockage finirait par exploser) — il suffit de les placer directement dans le système de fichiers dans le bon format. Bien entendu, il doit être clair qu'il n'est pas très judicieux de stocker un énorme fichier CSV dans un DataLake, qui doit d'abord être lu ligne par ligne par le cluster pour en extraire les colonnes. Réfléchissez encore une fois à ces deux points mentionnés ci-dessus si cela n'est pas encore clair.
AWS Athena — le "diable" dans la boîte.
Et ici, en créant le lac de données, nous sommes tombés presque par hasard sur Amazon Athena. Il s'est avéré que, en rangeant soigneusement nos fichiers de journaux énormes par dossiers shardés dans le bon format (Parquet), il est possible d'effectuer des sélections très informatives et de générer des rapports SANS cluster Apache Spark/Glue très rapidement.
Le moteur Athena, qui fonctionne sur les données dans S3, est basé sur la légendaire. — représentant de la famille MPP (traitement parallèle massif) pour le traitement des données, prenant les données là où elles sont, de s3 et Hadoop à Cassandra et des fichiers texte ordinaires. Il suffit de demander à Athena d'exécuter une requête SQL, et ensuite tout « fonctionne rapidement et tout seul ». Il est important de noter qu'Athena est « intelligente », elle ne va que dans les dossiers shardés nécessaires et ne lit que les colonnes requises dans la requête.
Les requêtes à Athena sont également tarifées de manière intéressante. Nous payons pour . C'est-à-dire, pas pour le nombre de machines dans le cluster par minute, mais… pour les données réellement scannées sur 100-500 machines, uniquement celles nécessaires à l'exécution de la requête.
Et en ne demandant que les colonnes nécessaires des bons dossiers shardés, il s'est avéré que le service Athena nous coûte des dizaines de dollars par mois. Eh bien, c'est presque gratuit, comparé à l'analyse sur des clusters !
Voici comment nous shardons nos données dans s3 :
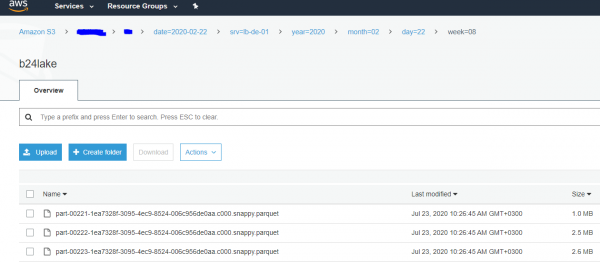
En conséquence, en peu de temps, des départements très différents au sein de l'entreprise, de la sécurité de l'information à l'analyse, ont commencé à faire des requêtes à Athena et à obtenir rapidement, en quelques secondes, des réponses utiles à partir de « grandes » données sur des périodes assez longues : mois, semestre, etc.
Mais nous sommes allés plus loin et avons commencé à chercher des réponses dans le cloud : un analyste dans sa console habituelle écrit une requête SQL, qui scrute les données dans s3 sur 100-500 machines « pour quelques centimes » et retourne généralement une réponse en moins de secondes. Pratique. Et rapide. Je n'arrive toujours pas à y croire.
En fin de compte, ayant décidé de stocker les données dans s3, dans un format colonne efficace et avec un sharding raisonnable des données par dossiers… nous avons obtenu un DataLake et un moteur analytique rapide et bon marché — gratuitement. Et il est devenu très populaire dans l'entreprise, car il comprend SQL et fonctionne des ordres de grandeurs plus rapidement que par le biais de lancements/arrêts/réglages de clusters. « Et si le résultat est le même, pourquoi payer plus ? »
Une requête à Athena ressemble à peu près à cela. Si on le souhaite, bien sûr, on peut formuler une requête SQL assez , mais nous nous limiterons à un simple regroupement. Voyons quels codes réponses le client avait il y a quelques semaines dans les journaux de fonctionnement du serveur web et vérifions qu'il n'y a pas d'erreurs :
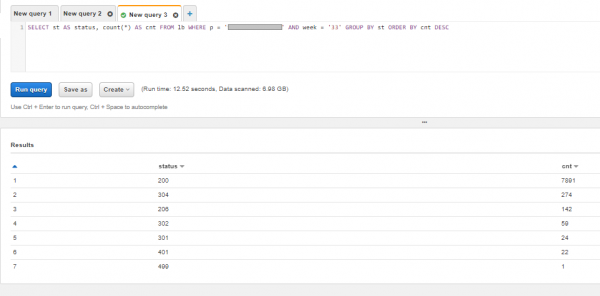
Conclusions
Après un parcours qui n'était pas si long mais douloureux, en évaluant constamment les risques et le niveau de complexité ainsi que le coût de maintenance, nous avons trouvé une solution pour le DataLake et l'analyse qui nous ravit tant par sa rapidité que par son coût de possession.
Il s'est avéré que construire un DataLake efficace, rapide et peu coûteux à exploiter pour les besoins de différentes unités de l'entreprise est parfaitement réalisable même pour des développeurs expérimentés, qui n'ont jamais été architectes et qui ne savent pas dessiner des carrés avec des flèches tout en connaissant 50 termes de l'écosystème Hadoop.
Au début, j'étais complètement perdu face à la multitude de logiciels open source et propriétaires, et à la lourdeur de la responsabilité envers les générations futures. Commencez simplement à construire votre DataLake avec des outils basiques : nagios/munin -> elastic/kibana -> Hadoop/Spark/s3..., en collectant des retours et en comprenant profondément la physique des processus. Laissez les aspects complexes et flous à vos concurrents.
Si vous ne souhaitez pas passer au cloud et préférez maintenir, mettre à jour et patcher des projets open source, vous pouvez construire une architecture similaire à la nôtre localement, sur de petites machines de bureau avec Hadoop et Presto au-dessus. L'essentiel est de ne pas s'arrêter, d'aller de l'avant, de compter, de rechercher des solutions simples et claires, et tout ira bien ! Bonne chance à tous et à bientôt !
Source : habr.com
