

Je m'appelle Pavel Parkhomenko, je suis développeur ML. Dans cet article, je voudrais expliquer comment fonctionne le service Yandex.Zen et partager les améliorations techniques mises en œuvre qui ont permis d'augmenter la qualité des recommandations. À travers cet article, vous découvrirez comment, en seulement quelques millisecondes, nous trouvons parmi des millions de documents ceux qui sont les plus pertinents pour l'utilisateur ; comment effectuer une décomposition continue d'une grande matrice (constituée de millions de colonnes et de dizaines de millions de lignes), afin que les nouveaux documents obtiennent leur vecteur en quelques dizaines de minutes ; comment réutiliser la décomposition de la matrice utilisateur-article pour obtenir une bonne représentation vectorielle pour les vidéos.
Notre base de recommandations contient des millions de documents de différents formats : articles textuels créés sur notre plateforme et provenant de sites externes, vidéos, récits et courts messages. Le développement d'un tel service est lié à un grand nombre de défis techniques. Voici quelques-uns d'entre eux :
- Diviser les tâches de calcul : effectuer toutes les opérations lourdes hors ligne, et n'appliquer que rapidement les modèles en temps réel, afin de garantir des temps de réponse de 100 à 200 ms.
- Prendre rapidement en compte les actions de l'utilisateur. Pour cela, il est nécessaire que tous les événements soient immédiatement transmis au système de recommandation et aient une influence sur le résultat des modèles.
- Adapter rapidement le fil d'actualités pour que les nouveaux utilisateurs se sentent en phase avec leur comportement. Les personnes nouvellement arrivées dans le système doivent sentir que leurs retours influencent les recommandations.
- Comprendre rapidement à qui recommander un nouvel article.
- Réagir rapidement à l'apparition constante de nouveaux contenus. Des dizaines de milliers d'articles sont publiés chaque jour, et beaucoup d'entre eux ont une durée de vie limitée (par exemple, des actualités). C'est ce qui les distingue des films, de la musique et d'autres contenus de longue durée coûteux à créer.
- Transférer les connaissances d'un domaine à un autre. Si le système de recommandation dispose de modèles entraînés pour des articles textuels et que nous y ajoutons des vidéos, nous pouvons réutiliser les modèles existants pour mieux classer le nouveau type de contenu.
Je vais expliquer comment nous avons résolu ces défis.
Sélection des candidats
Comment réduire en quelques millisecondes le nombre de documents examinés de milliers de fois, sans pratiquement altérer la qualité du classement ?
Supposons que nous avons formé plusieurs modèles de ML, généré des caractéristiques sur leur base et formé un autre modèle qui classe les documents pour l'utilisateur. Tout semble aller bien, mais on ne peut pas simplement calculer toutes les caractéristiques pour tous les documents en temps réel si ces documents sont au nombre de millions et que les recommandations doivent être établies en 100-200 ms. La tâche consiste à sélectionner un sous-ensemble parmi des millions de documents qui seront classés pour l'utilisateur. Cette étape est généralement appelée filtration des candidats. Elle doit répondre à plusieurs exigences. Tout d'abord, la filtration doit se faire très rapidement, afin de laisser le plus de temps possible pour le classement. De plus, en réduisant considérablement le nombre de documents à classer, nous devons maximiser la conservation des documents pertinents pour l'utilisateur.
Notre principe de filtration des candidats a évolué au fil du temps, et à l'heure actuelle, nous avons adopté un schéma à plusieurs niveaux :
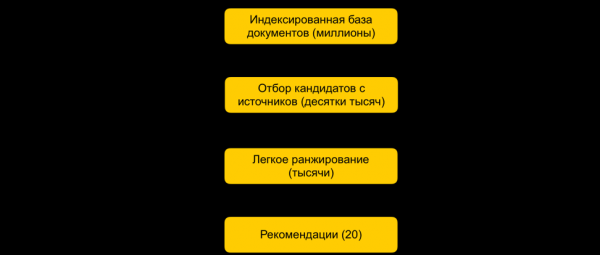
Dans un premier temps, tous les documents sont regroupés, et les documents les plus populaires sont sélectionnés dans chaque groupe. Les groupes peuvent être des sites, des thèmes, des clusters. Pour chaque utilisateur, les groupes les plus proches de son historique sont sélectionnés et les meilleurs documents sont extraits de ceux-ci. Nous utilisons également un index kNN pour trouver en temps réel les documents les plus proches de l'utilisateur. Il existe plusieurs méthodes pour construire un index kNN, et la meilleure pour nous a été (Hierarchical Navigable Small World graphs). C'est un modèle hiérarchique qui permet de trouver en quelques millisecondes N vecteurs les plus proches pour l'utilisateur à partir d'une base de millions. Nous indexons préalablement l'ensemble de notre base documentaire hors ligne. Étant donné que la recherche dans l'index est assez rapide, avec plusieurs embeddings performants, nous pouvons créer plusieurs indices (un pour chaque embedding) et interroger chacun d'eux en temps réel.
Nous disposons de dizaines de milliers de documents pour chaque utilisateur. Cela reste beaucoup pour le calcul de toutes les caractéristiques, donc à ce stade, nous appliquons un classement léger — un modèle simplifié de classement lourd avec moins de caractéristiques. L'objectif est de prédire quels documents seront en tête selon le modèle lourd. Les documents avec la plus grande prédiction seront utilisés dans le modèle lourd, c'est-à-dire à la dernière étape du classement. Cette approche permet de réduire en quelques millisecondes la base des documents examinés par l'utilisateur, passant de millions à des milliers.
Étape ALS en temps réel
Comment prendre en compte le feedback de l'utilisateur immédiatement après le clic ?
Un facteur important dans les recommandations est le temps de réponse au feedback de l'utilisateur. Cela est particulièrement important pour les nouveaux utilisateurs : lorsqu'une personne commence à utiliser le système de recommandation, elle reçoit un flux de documents variés non personnalisés. Dès qu'elle effectue son premier clic, il est nécessaire de prendre cela en compte immédiatement et de s'adapter à ses intérêts. Si tous les facteurs sont calculés hors ligne, la réaction rapide du système deviendra impossible en raison du délai. Il est donc nécessaire de traiter les actions de l'utilisateur en temps réel. Pour cela, nous utilisons l'étape ALS en temps réel pour construire une représentation vectorielle de l'utilisateur.
Supposons que nous avons une représentation vectorielle pour tous les documents. Par exemple, nous pouvons hors ligne, sur la base du texte de l'article, construire des embeddings à l'aide de ELMo, BERT ou d'autres modèles de machine learning. Comment obtenir une représentation vectorielle des utilisateurs dans le même espace basé sur leurs interactions dans le système ?
Principe général de création et de décomposition de la matrice utilisateur-documentConsidérons m utilisateurs et n documents. Pour certains utilisateurs, leur intérêt pour quelques documents est connu. Cette information peut alors être présentée sous la forme d'une matrice m x n : les lignes correspondent aux utilisateurs, et les colonnes — aux documents. Étant donné que la plupart des documents n'ont pas été vus par l'utilisateur, la majorité des cellules de la matrice restera vide, tandis que d'autres seront remplies. Pour chaque événement (like, dislike, clic) dans la matrice, il est prévu une certaine valeur — mais considérons un modèle simplifié où un like correspond à 1, et un dislike à -1.
Décomposons la matrice en deux : P (m x d) et Q (d x n), où d est la dimension de la représentation vectorielle (généralement un petit nombre). Ainsi, chaque objet correspondra à un vecteur de dimension d (l'utilisateur — une ligne dans la matrice P, le document — une colonne dans la matrice Q). Ces vecteurs seront les embeddings des objets correspondants. Pour prédire si un utilisateur aimera un document, il suffit de multiplier leurs embeddings.
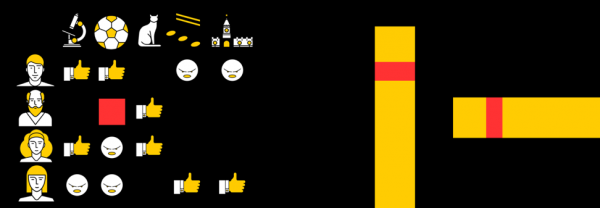
Une des méthodes possibles pour la décomposition de la matrice est ALS (Alternating Least Squares). Nous allons optimiser la fonction de perte suivante :

Ici, rui est l'interaction de l'utilisateur u avec le document i, qi est le vecteur du document i, pu est le vecteur de l'utilisateur u.
Ainsi, le vecteur utilisateur optimal du point de vue de l'erreur quadratique moyenne (avec les vecteurs des documents fixes) est trouvé analytiquement en résolvant la régression linéaire correspondante.
Cela s'appelle un « pas ALS ». L'algorithme ALS consiste à fixer alternativement une des matrices (utilisateurs et articles) et à mettre à jour l'autre pour trouver la solution optimale.
Heureusement, trouver la représentation vectorielle d'un utilisateur est une opération assez rapide qui peut être effectuée en temps réel, en utilisant des instructions vectorielles. Ce truc permet de tenir immédiatement compte des retours des utilisateurs dans le classement. Le même embedding peut être utilisé dans l'index kNN pour améliorer la sélection de candidats.
Filtration collaborative distribuée
Comment effectuer une factorisation matricielle distribuée incrémentale et trouver rapidement la représentation vectorielle de nouveaux articles ?
Le contenu n'est pas la seule source de signaux pour les recommandations. Une autre source importante est l'information collaborative. De bons indicateurs pour le classement peuvent traditionnellement être obtenus à partir de la décomposition de la matrice utilisateur-document. Toutefois, en essayant de réaliser cette décomposition, nous avons rencontré des problèmes :
1. Nous avons des millions de documents et des dizaines de millions d'utilisateurs. La matrice ne peut pas tenir sur une seule machine dans son ensemble, et la décomposition sera très longue.
2. La plupart des contenus dans le système ont une courte durée de vie : les documents restent pertinents pendant seulement quelques heures. Il est donc essentiel de construire leur représentation vectorielle le plus rapidement possible.
3. Si nous effectuons la décomposition juste après la publication d'un document, il n'aura pas été évalué par un nombre suffisant d'utilisateurs. Par conséquent, sa représentation vectorielle sera très probablement médiocre.
4. Si un utilisateur aime ou n'aime pas, nous ne pourrons pas immédiatement tenir compte de cela dans la décomposition.
Pour résoudre les problèmes mentionnés, nous avons mis en œuvre une décomposition distribuée de la matrice utilisateur-document avec des mises à jour incrémentielles fréquentes. Comment cela fonctionne-t-il ?
Supposons que nous avons un cluster de N machines (N est dans les centaines) et que nous souhaitons faire une décomposition distribuée de la matrice qui ne tient pas sur une seule machine. La question est de savoir comment réaliser cette décomposition pour que, d'une part, chaque machine ait suffisamment de données et, d'autre part, que les calculs soient indépendants ?
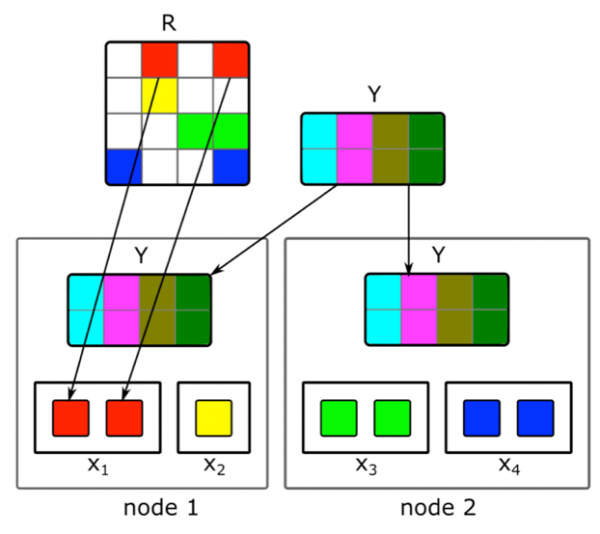
Nous allons utiliser l'algorithme de décomposition ALS décrit ci-dessus. Examinons comment réaliser un pas d'ALS de manière distribuée — les autres étapes seront similaires. Supposons que nous ayons une matrice de documents fixée et que nous souhaitions construire la matrice des utilisateurs. Pour cela, nous la diviserons en N parties par lignes, chaque partie contenant environ le même nombre de lignes. Nous enverrons à chaque machine les cellules non vides des lignes correspondantes, ainsi que la matrice d'embeddings des documents (dans son intégralité). Étant donné sa taille relativement petite, et que la matrice utilisateur-document est généralement très sparse, ces données tiendront sur une machine ordinaire.
Ce truc peut être répété pendant plusieurs époques jusqu'à la convergence du modèle, en changeant tour à tour la matrice fixe. Mais même dans ce cas, la décomposition de la matrice peut durer plusieurs heures. Et cela ne résout pas le problème qu'il faut obtenir rapidement les embeddings de nouveaux documents et mettre à jour les embeddings de ceux d'entre eux pour lesquels il y avait peu d'informations lors de la construction du modèle.
Nous avons bénéficié de l'implémentation d'une mise à jour incrémentale rapide du modèle. Supposons que nous ayons un modèle entraîné actuellement. Depuis son entraînement, de nouveaux articles sont apparus, avec lesquels nos utilisateurs ont interagi, ainsi que des articles qui avaient peu d'interactions lors de l'entraînement. Pour obtenir rapidement l'embedding de ces articles, nous utilisons les embeddings des utilisateurs obtenus lors du premier grand entraînement du modèle et faisons un pas ALS pour calculer la matrice des documents avec la matrice des utilisateurs fixe. Cela permet d'obtenir des embeddings assez rapidement — dans les minutes qui suivent la publication d'un document — et de mettre souvent à jour les embeddings des nouveaux documents.
Pour que les recommandations prennent immédiatement en compte les actions de l'utilisateur, nous n'utilisons pas les embeddings des utilisateurs obtenus hors ligne au moment de l'exécution. Au lieu de cela, nous faisons un pas ALS et obtenons le vecteur utilisateur actuel.
Transfert vers un autre domaine
Comment utiliser le retour d'information des utilisateurs sur les articles textuels pour construire une représentation vectorielle des vidéos ?
Au départ, nous ne recommandions que des articles textuels, c'est pourquoi de nombreux algorithmes sont adaptés à ce type de contenu. Mais avec l'ajout de contenus d'un autre type, nous avons rencontré le besoin d'adapter les modèles. Comment avons-nous résolu cette tâche pour les vidéos ? Une des options consiste à réentraîner tous les modèles depuis le début. Mais c'est long, et de plus, une partie des algorithmes exige beaucoup d'exemples d'entraînement, qui ne sont pas encore disponibles en quantité suffisante pour les nouveaux types de contenus dans les premiers moments de leur vie sur le service.
Nous avons emprunté une autre voie en réutilisant des modèles de textes pour les vidéos. La création de représentations vectorielles des vidéos a été facilitée par le même truc avec l'ALS. Nous avons pris la représentation vectorielle des utilisateurs basée sur des articles texte et avons réalisé une étape d'ALS en utilisant les informations sur les vues des vidéos. De cette façon, nous avons facilement obtenu la représentation vectorielle des vidéos. En cours d'exécution, nous calculons simplement la proximité entre le vecteur utilisateur, obtenu à partir des articles texte, et le vecteur vidéo.
Conclusion
Le développement du noyau d'un système de recommandations en temps réel est associé à de nombreuses tâches. Il faut traiter les données rapidement et appliquer des méthodes ML pour une utilisation efficace de ces données ; construire des systèmes distribués complexes capables de traiter les signaux utilisateurs et les nouvelles unités de contenu en un minimum de temps ; et bien d'autres tâches.
Dans le système actuel, dont j'ai décrit le fonctionnement, la qualité des recommandations pour l'utilisateur augmente avec son activité et sa durée de présence sur le service. Mais bien sûr, ici réside aussi la principale difficulté : il est difficile pour le système de comprendre rapidement les intérêts d'une personne qui a peu interagi avec le contenu. Améliorer les recommandations pour les nouveaux utilisateurs est notre tâche clé. Nous continuerons à optimiser les algorithmes pour que le contenu pertinent arrive plus rapidement dans leur fil d'actualité, tandis que le contenu non pertinent ne soit pas montré.
Source : habr.com
