

Je m'appelle Anton Baderin. Je travaille au Centre des Hautes Technologies et je m'occupe de l'administration système. Il y a un mois, notre conférence d'entreprise a eu lieu, où nous avons partagé notre expérience accumulée avec la communauté IT de notre ville. J'ai parlé de la surveillance des applications web. Le matériel était destiné à un niveau junior ou intermédiaire, qui n'avait pas mis en place ce processus depuis le début.
La pierre angulaire de tout système de surveillance est la résolution des problèmes d'entreprise. La surveillance pour la surveillance n'intéresse personne. Que veut l'entreprise ? Que tout fonctionne rapidement et sans erreurs. L'entreprise souhaite de la proactivité, afin que nous puissions identifier les problèmes dans le fonctionnement du service et les résoudre aussi rapidement que possible. C'est, en substance, les défis que j'ai relevés tout au long de l'année précédente pour le projet d'un de nos clients.
À propos du projet
Le projet est l'un des plus grands programmes de fidélité du pays. Nous aidons les chaînes de vente au détail à augmenter la fréquence des ventes par divers outils marketing tels que les cartes de fidélité. Au total, le projet comprend 14 applications qui fonctionnent sur dix serveurs.
Au cours des entretiens, j'ai souvent remarqué que les administrateurs ne s'approchent pas toujours correctement de la surveillance des applications web : beaucoup se limitent encore aux métriques du système d'exploitation et surveillent occasionnellement les services.
Dans mon cas, la solution de surveillance du client reposait auparavant sur Icinga. Elle ne répondait en rien aux défis susmentionnés. Souvent, le client nous informait lui-même des problèmes et il nous manquait souvent des données pour comprendre la cause.
De plus, il était clair qu'il n'y avait pas d'avenir pour son développement ultérieur. Je pense que ceux qui connaissent Icinga comprendront. Donc, nous avons décidé de retravailler complètement le système de surveillance des applications web pour le projet.
Prometheus
Nous avons choisi Prometheus sur la base de trois indicateurs principaux :
- Un grand nombre de métriques disponibles. Dans notre cas, il y en a 60 000. Bien sûr, il convient de noter que la grande majorité d'entre elles ne sont pas utilisées (probablement environ 95 %). D'autre part, elles sont toutes relativement bon marché. Pour nous, c'est l'autre extrême, comparé à Icinga que nous utilisions auparavant. Dans celui-ci, l'ajout de métriques posait un réel problème : celles existantes étaient coûteuses (il suffit de regarder le code source de n'importe quel plugin). Chaque plugin était un script en Bash ou en Python, dont l'exécution n'est pas bon marché en termes de ressources consommées.
- Ce système consomme relativement peu de ressources. Pour toutes nos métriques, 600 Mo de RAM, 15 % d'un cœur et quelques dizaines d'IOPS suffisent. Bien sûr, il faut exécuter des exportateurs de métriques, mais tous sont écrits en Go et ne sont pas non plus très gourmands. Je ne pense pas que ce soit un problème dans les réalités modernes.
- Permet de passer à Kubernetes. Étant donné les plans du client, le choix est évident.
ELK
Nous ne collectons ni ne traitons les logs auparavant. Les inconvénients sont clairs pour tout le monde. Nous avons choisi ELK, car nous avions déjà de l'expérience avec ce système. Nous n'y stockons que les logs des applications. Les principaux critères de choix étaient la recherche full-text et sa rapidité.
Clickhouse
Au départ, nous avons opté pour InfluxDB. Nous étions conscients de la nécessité de collecter les logs Nginx, les statistiques de pg_stat_statements et de stocker les données historiques de Prometheus. L'Influx ne nous a pas plu, car il commençait périodiquement à consommer une grande quantité de mémoire et s'effondrait. De plus, nous voulions regrouper les requêtes par remote_addr, mais cette SGBD ne permet le regroupement que par tags. Les tags sont coûteux (en mémoire), leur nombre est conditionnellement limité.
Nous avons recommencé les recherches. Il nous fallait une base analytique avec une consommation minimale de ressources, de préférence avec compression des données sur disque.
Clickhouse répond à tous ces critères, et nous n'avons jamais regretté notre choix. Nous n'écrivons pas des volumes de données exceptionnels (le nombre d'inserts est d'environ cinq mille par minute).
NewRelic
NewRelic a historiquement été avec nous, car c'était le choix du client. Nous l'utilisons comme APM.
Zabbix
Nous utilisons Zabbix exclusivement pour surveiller la Black Box de diverses API.
Définition de l'approche de monitoring
Nous souhaitions décomposer la tâche pour systématiser l'approche de monitoring.
Pour cela, j'ai divisé notre système en plusieurs niveaux :
- matériel et VMS ;
- système d'exploitation ;
- services système, stack logiciel ;
- application ;
- logique métier.
Les avantages de cette approche :
- nous savons qui est responsable du fonctionnement de chaque niveau et, en fonction de cela, nous pouvons envoyer des alertes ;
- nous pouvons utiliser la structure lors de la suppression d'alertes - il serait étrange d'envoyer une alerte sur l'indisponibilité de la base de données alors que la machine virtuelle dans son ensemble est indisponible.
Étant donné que notre tâche est d'identifier les anomalies dans le fonctionnement du système, nous devons définir un ensemble de métriques à chaque niveau, sur lesquelles il est essentiel de se concentrer lors de la rédaction des règles d'alerte. Nous passerons ensuite en revue les niveaux « VMS », « Système d'exploitation » et « Services système, stack logiciel ».
Machines virtuelles
Hébergement il nous attribue le processeur, le disque, la mémoire et le réseau. Et nous avons eu des problèmes avec les deux premiers. Donc, les métriques :
Temps de CPU volé - lorsque vous achetez une machine virtuelle sur Amazon (t2.micro, par exemple), il faut comprendre que vous ne obtenez pas un cœur de processeur complet, mais seulement un quota de son temps. Et lorsque vous atteignez cette limite, le processeur commencera à vous être retiré.
Cette métrique permet de suivre de tels moments et de prendre des décisions. Par exemple, faut-il choisir un tarif plus élevé ou répartir le traitement des tâches en arrière-plan et les requêtes API sur différentes de serveurs.
IOPS + temps d'attente CPU - pour une raison quelconque, de nombreux hébergeurs cloud commettent l'erreur de sous-estimer les IOPS. De plus, un graphique avec des IOPS faibles ne leur pose pas de problème. C'est pourquoi il est utile de collecter également le temps d'attente CPU. Avec cette paire de graphiques - IOPS faibles et attente d'entrée-sortie élevée - il est possible de discuter avec l'hébergeur et de résoudre le problème.
Système d'exploitation
Métriques du système d'exploitation :
- pourcentage de mémoire disponible ;
- activité d'utilisation du swap : vmstat swapin, swapout ;
- nombre d'inodes disponibles et d'espace libre sur le système de fichiers en % ;
- charge moyenne ;
- nombre de connexions en état tw ;
- remplissage de la table conntrack ;
- la qualité du réseau peut être surveillée à l'aide de l'utilitaire ss, avec le paquet iproute2 - obtenir à partir de sa sortie une mesure RTT des connexions et regrouper par port de destination.
De plus, au niveau du système d'exploitation, nous avons une entité comme les processus. Il est important de définir dans le système un ensemble de processus qui jouent un rôle clé dans son fonctionnement. Par exemple, si vous avez plusieurs pgpool, il est nécessaire de collecter des informations sur chacun d'entre eux.
L'ensemble des métriques est le suivant :
- CPU ;
- la mémoire — avant tout, résidente ;
- IO — de préférence en IOPS ;
- FileFd — ouverts et limite ;
- échecs majeurs des pages — cela vous permettra de comprendre quel processus est échangé.
Toute notre surveillance est déployée dans Docker, pour collecter les données métriques, nous utilisons Cadvisor. Sur les autres machines, nous utilisons process-exporter.
Services système, stack logiciel
Chaque application a sa propre spécificité, et il est difficile de distinguer un ensemble de métriques particulier.
L'ensemble universel est :
- le taux de requêtes ;
- le nombre d'erreurs ;
- la latence ;
- saturation.
Les exemples les plus marquants de ce niveau de surveillance chez nous sont Nginx et PostgreSQL.
Le service le plus chargé dans notre système est la base de données. Auparavant, nous avions souvent des problèmes pour comprendre ce que faisait la base de données.
Nous avons observé une forte charge sur les disques, mais les slow logs ne montraient rien de significatif. Nous avons résolu ce problème grâce à pg_stat_statements, une vue qui compile les statistiques sur les requêtes.
C'est tout ce dont un admin a besoin.
Nous construisons des graphiques d'activité des requêtes en lecture et en écriture :
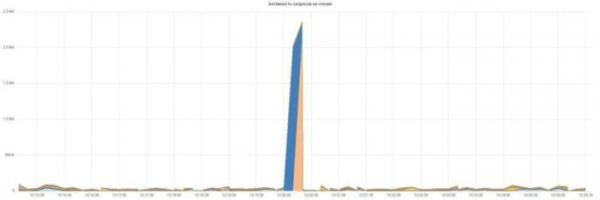
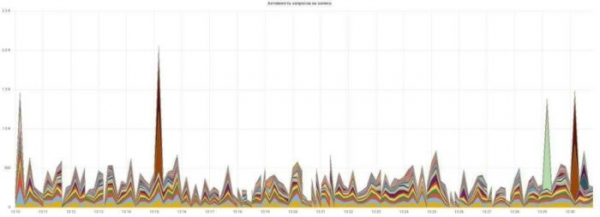
Tout est simple et clair, chaque requête a sa couleur.
Un autre exemple marquant — les logs Nginx. Il n'est pas surprenant que peu de gens les analysent ou les mentionnent dans la liste des incontournables. Le format standard n'est pas très informatif et doit être étendu.
Personnellement, j'ai ajouté request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Nous construisons des graphiques du temps de réponse et du nombre d'erreurs :
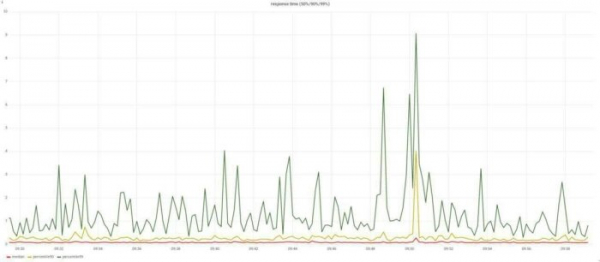
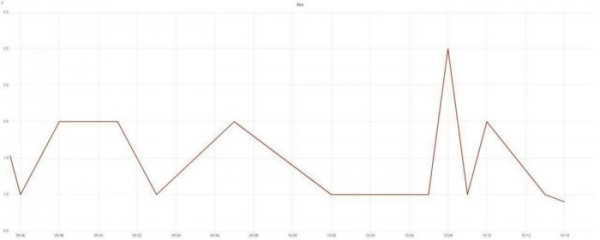
Nous construisons des graphiques du temps de réponse et du nombre d'erreurs. Vous vous souvenez ? Je parlais des enjeux de l'entreprise ? Pour être rapide et sans erreurs ? Nous avons déjà résolu ces questions avec deux graphiques. Et à partir d'eux, nous pouvons déjà appeler les administrateurs de garde.
Mais il reste un problème — assurer une résolution rapide des causes de l'incident.
Résolution des incidents
Tout le processus, de l'identification à la résolution du problème, peut être divisé en plusieurs étapes :
- identification du problème ;
- notification de l'administrateur de garde ;
- réaction à l'incident ;
- élimination des causes.
Il est important que nous le fassions le plus rapidement possible. Et si nous ne pouvons pas gagner de temps aux étapes d'identification du problème et d'envoi de notifications — deux minutes y vont de toute façon, alors les étapes suivantes sont simplement un vaste champ d'améliorations.
Imaginons simplement que le téléphone du personne de garde sonne. Que va-t-il faire ? Chercher des réponses aux questions - qu'est-ce qui est cassé, où cela s'est-il produit, comment réagir ? Voici comment nous répondons à ces questions :
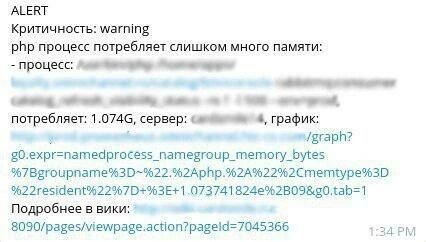
Nous incluons simplement toutes ces informations dans le texte de la notification, en y ajoutant un lien vers la page Wiki qui décrit comment réagir à ce problème, comment le résoudre et le transmettre.
Je n'ai toujours rien dit sur le niveau de l'application et la logique métier. Malheureusement, nos applications n'ont pas encore mis en place la collecte de métriques. La seule source d'informations, même partielles, à ces niveaux - ce sont les journaux.
Quelques points.
Premièrement, écrivez des journaux structurés. Ne mettez pas le contexte dans le texte du message. Cela complique leur regroupement et leur analyse. Logstash nécessite beaucoup de temps pour normaliser tout cela.
Deuxièmement, utilisez correctement les niveaux de gravité. Chaque langage a sa propre norme. Personnellement, je distingue quatre niveaux :
- pas d'erreur;
- erreur côté client;
- erreur de notre côté, nous ne perdons pas d'argent, nous ne prenons pas de risques;
- erreur de notre côté, nous perdons de l'argent.
En résumé. Nous devons nous efforcer de construire le monitoring en fonction de la logique métier. Essayer de monitorer l'application elle-même et de travailler avec des métriques telles que le nombre de ventes, le nombre de nouvelles inscriptions d'utilisateurs, le nombre d'utilisateurs actifs à ce moment-là, etc.
Si votre entreprise est simplement un bouton dans un navigateur, il est nécessaire de surveiller si celui-ci est cliqué et fonctionne correctement. Tout le reste n'est pas important.
Si vous ne l'avez pas, vous pouvez essayer de le rattraper dans les journaux de l'application, les journaux Nginx, etc., comme nous l'avons fait. Vous devez être aussi proche de l'application que possible.
Les métriques du système d'exploitation sont bien sûr importantes, mais elles n'intéressent pas le business, nous ne sommes pas payés pour elles.
Source : habr.com
