

Bonjour ! Je m'appelle Alexey Pyankov, je suis développeur chez Sportmaster. Dans ce j'ai parlé de la façon dont le travail sur le site de Sportmaster a commencé en 2012, quelles initiatives nous avons réussi à « propulser » et, au contraire, quels obstacles nous avons rencontrés.
Aujourd'hui, je veux partager des réflexions qui suivent un autre sujet : le choix du système de mise en cache pour le backend Java de l'administration du site. Ce sujet a une signification particulière pour moi – bien que l'histoire ait duré seulement 2 mois, nous avons travaillé 12 à 16 heures par jour sans un seul jour de repos. Je n'avais jamais pensé ni imaginé qu'il était possible de travailler autant.
C'est pourquoi je divise le texte en 2 parties, pour ne pas trop surcharger. Au contraire, la première partie sera très légère – une introduction, quelques réflexions sur ce qu'est la mise en cache. Si vous êtes déjà un développeur expérimenté ou avez travaillé avec des caches, il n'y aura probablement rien de nouveau sur le plan technique dans cet article. Mais pour un junior, un petit aperçu comme celui-ci peut lui indiquer dans quelle direction regarder, s'il se retrouve à un tel carrefour.
Lorsque la nouvelle version du site Sportmaster a été mise en production, les données étaient transmises d'une manière, pour le dire poliment, peu pratique. Des tables préparées pour l'ancienne version du site (Bitrix) servaient de base, qu'il fallait intégrer dans ETL, modifier dans un nouveau format et enrichir avec divers détails provenant d'une dizaine de systèmes. Pour qu'une nouvelle image ou description de produit apparaisse sur le site, il fallait attendre jusqu'au lendemain – la mise à jour n'ayant lieu qu'une fois par nuit, une fois par jour.
Au début, il y avait tellement de soucis durant les premières semaines de mise en production que ces désagréments pour les gestionnaires de contenu semblaient mineurs. Mais, une fois que tout s'est stabilisé, le développement du projet s'est poursuivi – quelques mois plus tard, début 2015, nous avons commencé à développer activement l'administration. En 2015 et 2016, tout se passait bien, nous publions régulièrement, l'administration couvre une partie de plus en plus importante de la préparation des données et nous nous préparons à ce que notre équipe se voie bientôt confier la tâche la plus importante et la plus complexe : le circuit des produits (préparation complète et gestion des données pour tous les produits). Mais à l'été 2017, juste avant le lancement du circuit des produits, le projet se retrouvera dans une situation très complexe – justement à cause de problèmes de mise en cache. C'est cet épisode que je veux raconter dans la deuxième partie de cette publication en deux parties.
Mais dans ce post, je vais commencer par le début, en résumant certaines pensées - des idées sur la mise en cache, qu'il serait bon d'explorer avant de se lancer dans un grand projet.
Quand la question de la mise en cache se pose
Le besoin de mise en cache ne surgit pas par hasard. En tant que développeurs, nous créons des produits logiciels et voulons qu'ils soient demandés. Si le produit est prisé et réussi, les utilisateurs affluent. Et encore et encore. À un moment donné, il y a tellement d'utilisateurs que le produit devient très sollicité.
Au début, nous ne pensons pas à l'optimisation et à la performance du code. L'essentiel est la fonctionnalité, il faut rapidement lancer un prototype et tester des hypothèses. Et si la charge augmente, nous améliorons le matériel. Nous doublons, triplons, quintuple le potentiel, voire le décuplons. À un certain point, les finances ne le permettront plus. Et de combien le nombre d'utilisateurs pourrait-il augmenter ? Ce ne sera pas juste 2-5-10, mais en cas de succès — cela pourrait aller de 100 à 1000 et jusqu'à 100 000 fois. Donc, tôt ou tard, nous devrons nous attaquer à l'optimisation.
Supposons qu'une certaine partie du code (appelons-la une fonction) prenne de manière inacceptable beaucoup de temps, et que nous souhaitions réduire ce temps d'exécution. Une fonction peut impliquer un accès à une base de données, ou l'exécution d'une logique complexe - l'essentiel étant qu'elle prenne beaucoup de temps. Jusqu'où pouvons-nous réduire le temps d'exécution ? En théorie, nous pouvons le réduire à zéro, mais pas moins que cela. Comment peut-on réduire le temps d'exécution à zéro ? Réponse : en éliminant complètement l'exécution. À la place, il faut juste renvoyer le résultat. Mais comment connaître ce résultat ? Réponse : soit le calculer, soit le consulter à quelque part. Le calcul peut prendre du temps. Et le consulter consiste, par exemple, à mémoriser le résultat que la fonction a donné lors de la dernière invocation avec les mêmes paramètres.
C'est-à-dire, la mise en œuvre de la fonction ne nous importe pas. Il suffit de savoir de quels paramètres dépend le résultat. Donc, si les valeurs des paramètres sont présentées sous la forme d'un objet pouvant être utilisé comme clé dans un certain stockage, nous pouvons sauvegarder le résultat du calcul et le récupérer lors de la prochaine demande. Si ces opérations d'enregistrement et de lecture du résultat sont plus rapides que l'exécution de la fonction, nous avons un gain en vitesse. Le gain peut atteindre 100, 1000 et même 100 000 fois (10^5 est plutôt une exception, mais dans le cas d'une base assez laggée, c'est tout à fait possible).
Exigences principales pour le système de cache
La première exigence potentielle pour un système de cache est une vitesse de lecture rapide et, dans une moindre mesure, une vitesse d'écriture. C'est vrai, mais seulement jusqu'à ce que nous déployions le système en production.
Imaginons un tel cas.
Supposons que nous avons équipé le matériel pour la charge actuelle et que nous commençons maintenant à introduire progressivement le cache. Le nombre d'utilisateurs augmente un peu, la charge croît - nous ajoutons un peu de caches, les installant ici et là. Cela dure un certain temps, et voilà, les fonctions lourdes ne sont presque plus appelées - toute la charge principale repose sur le cache. Le nombre d'utilisateurs a augmenté de N fois pendant ce temps.
Et si le stock initial de matériel pouvait être de 2 à 5 fois, grâce au cache, nous avons pu multiplier les performances par 10 ou, dans le meilleur des cas, par 100, et parfois même par 1000. Autrement dit, sur le même matériel, nous traitons 100 fois plus de requêtes. Génial, nous avons mérité une récompense !
Mais maintenant, à un certain moment opportun, la système a échoué et le cache s'est effondré. Rien de particulier - le cache avait été choisi selon les exigences de «vitesse de lecture et d'écriture élevée, le reste n'est pas important».
Par rapport à la charge initiale, nous avions un stock de matériel de 2 à 5 fois, et la charge a depuis augmenté de 10 à 100 fois. Grâce au cache, nous avons exclu les appels aux fonctions lourdes, et c'est pourquoi tout fonctionnait parfaitement. Mais maintenant, sans cache - de combien de fois notre système va-t-il s'effondrer ? Que va-t-il se passer ? Le système va tomber.
Même si notre cache ne s'est pas effondré, mais s'est simplement vidé pendant un certain temps - il faudra le réchauffer, et cela prendra un certain temps. Et durant ce temps, la charge principale retombera sur la fonctionnalité.
Sortie : les projets à forte charge en production exigent d'un système de mise en cache non seulement une vitesse de lecture et d'écriture élevées, mais aussi la sécurité des données et une résistance aux pannes.
Les douleurs du choix
Dans le projet avec une interface d'administration, le choix s'est fait comme suit : au départ, nous avons installé Hazelcast, car nous étions déjà familiarisés avec ce produit grâce à notre expérience avec le site principal. Cependant, ce choix s'est avéré peu judicieux : pour notre profil de charge, Hazelcast fonctionne non seulement lentement, mais atrocement lentement. Et au moment où nous étions engagés à respecter les délais de mise en production, nous avions déjà signé.
Alerte spoiler : comment les circonstances ont fait que nous avons raté un tel fiasco et avons obtenu une situation aiguë et tendue - je raconterai cela dans la deuxième partie - et comment nous nous sommes retrouvés et comment nous sommes sortis. Mais pour l'instant, je dirai simplement que cela a été un fort stress, et "penser - ça ne vient pas, on secoue la bouteille". "Secouer la bouteille" - c'est aussi un spoiler, j'en parlerai un peu plus loin.
Ce que nous avons fait :
- Nous dressons une liste de tous les systèmes suggérés par Google et StackOverflow. Un peu plus de 30.
- Nous écrivons des tests avec une charge caractéristique pour la production. Pour cela, nous avons enregistré les données qui passent par le système en environnement de production - une sorte de sniffer pour les données non en ligne, mais à l'intérieur du système. Nous avons testé exactement ces données.
- Toute l'équipe, chacun choisit le système suivant dans la liste, le configure et exécute les tests. Si le test échoue, si cela ne supporte pas la charge - nous le rejetons et passons au suivant.
- Sur le 17ème système, il est devenu clair que tout était désespéré. Assez de "secouer la bouteille", il est temps de réfléchir sérieusement.
Mais cela est une option lorsque vous devez choisir un système qui "passera en vitesse" dans des tests préparés à l'avance. Et si de tels tests n'existent pas encore et que vous voulez choisir plus rapidement ?
Modélisons un tel cas (il est difficile d'imaginer qu'un développeur de niveau intermédaire soit dans le vide, et au moment du choix n'ait pas encore formé de préférence quant à quel produit essayer en premier - donc, les réflexions suivantes relèvent plutôt de la théorie / philosophie / sur un junior).
Après avoir défini les exigences, commençons à choisir une solution clé en main. Pourquoi réinventer la roue : nous allons prendre un système de cache prêt à l'emploi.
Si vous débutez et que vous effectuez quelques recherches, l'ordre peut varier, mais en gros, voici ce à quoi vous pouvez vous attendre. Vous tomberez d'abord sur Redis, car il est partout mentionné. Ensuite, vous découvrirez EhCache, qui est le système le plus ancien et éprouvé. Par la suite, il sera question de Tarantool - un développement national avec un aspect unique de la solution. Et aussi Ignite, car il est en pleine ascension et bénéficie du soutien de SberTech. Enfin, il y a aussi Hazelcast, car il apparaît souvent dans le monde de l'entreprise, notamment parmi les grandes entreprises.
Cette liste n'est pas exhaustive, il existe des dizaines de systèmes. Mais nous allons nous concentrer sur une seule. Prenons les 5 systèmes sélectionnés pour un « concours de beauté » et faisons une sélection. Qui sera le gagnant ?
Redis
Lisons ce qui est écrit sur le site officiel.
— projet open-source. Propose un stockage de données en mémoire, la possibilité de sauvegarde sur disque, un partitionnement automatique, une haute disponibilité et une récupération après les coupures réseau.
Tout semble parfait, on peut l'adopter et l'adapter — il fait tout ce qu'on attend de lui. Mais par curiosité, examinons les autres candidats.
EhCache
— « le cache Java le plus largement utilisé » (traduction du slogan du site officiel). Également open-source. Ici, nous réalisons que Redis n'est pas spécifique à Java mais est général, et qu'une couche d'abstraction est nécessaire pour interagir avec. EhCache s'avère être plus pratique. Que promet encore le système ? Fiabilité, éprouvé et fonctionnalité complète. De plus, c'est le plus répandu. Et il met en cache des téraoctets de données.
Redis est mis de côté, je suis prêt à choisir EhCache.
Mais mon sentiment patriotique me pousse à explorer les avantages de Tarantool.
Tarantool
— décrit comme une « plateforme d'intégration de données en temps réel ». Cela semble compliqué, alors lisons la page en détail et trouvons une déclaration audacieuse : « Cache 100 % des données en mémoire vive ». Cela suscite des questions — car les données peuvent largement dépasser la mémoire. En réalité, cela signifie qu'à l'heure d'écrire des données sur disque depuis la mémoire, Tarantool ne passe pas par la sérialisation. Au lieu de cela, il utilise des caractéristiques de bas niveau du système, lorsque la mémoire est simplement mappée sur le système de fichiers avec des performances I/O très satisfaisantes. Globalement, ils ont fait quelque chose de remarquable et d'incroyable.
Regardons les mises en œuvre : Mail.ru, le réseau corporatif, Avito, Beeline, MegaFon, Alfa-Bank, Gazprom…
S'il restait des doutes concernant Tarantool, le cas d'implémentation chez Mastercard me confirme le contraire. Je prends Tarantool.
Mais tout de même…
Ignite
… il y a encore , annoncé comme « une plateforme de calcul in-memory… vitesses in-memory sur des pétaoctets de données ». Il y a aussi beaucoup d'avantages : cache distributed in-memory, le stockage key-value le plus rapide et cache, évolutivité horizontale, haute disponibilité, intégrité stricte. En résumé, il s'avère que le plus rapide – c'est Ignite.
Implémentations : Sberbank, American Airlines, Yahoo! Japan. De plus, j'apprends que Ignite n'est pas seulement implémenté chez Sberbank, l'équipe de SberTech envoie ses employés dans l'équipe même d'Ignite pour améliorer le produit. Cela me convainc totalement et je suis prêt à prendre Ignite.
Il est totalement incompréhensible pourquoi je regarde le cinquième point.
Hazelcast
Je vais sur le site , je lis. Et il s'avère que la solution la plus rapide pour le caching distribué – c'est Hazelcast. Il est plusieurs ordres de grandeur plus rapide que toutes les autres solutions et c'est en fait le leader dans le domaine des grilles de données in-memory. Dans ce contexte, prendre quelque chose d'autre serait un manque de respect envers soi-même. De plus, il utilise le stockage redondant des données pour un fonctionnement continu du cluster sans perte de données.
Voilà, je suis prêt à prendre Hazelcast.
Comparaison
Mais si l'on regarde, tous les cinq candidats sont décrits de telle sorte que chacun d'eux est le meilleur. Comment choisir ? Nous pouvons voir lequel est le plus populaire, chercher des comparaisons, et la douleur de tête disparaîtra.
Nous trouvons cela , nous choisissons nos 5 systèmes.
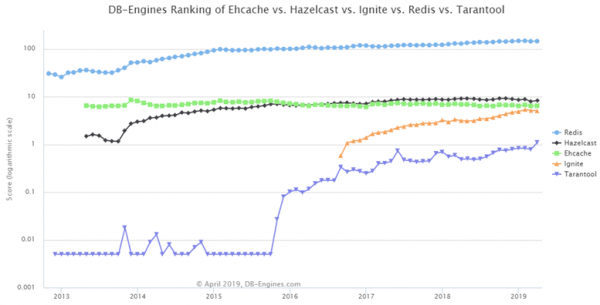
Ici, ils sont triés : en haut Redis, en deuxième position – Hazelcast, Tarantool et Ignite gagnent en popularité, EhCache reste comme il était.
Mais regardons le : liens vers des sites web, intérêt général pour le système, offres d'emploi – super ! Cela signifie que, quand mon système va tomber, je pourrai dire : « Non, il est fiable ! Voilà plein d'offres d'emploi… ». Une telle comparaison simple ne conviendra pas.
Tous ces systèmes ne sont pas simplement des systèmes de cache. Ils ont aussi beaucoup de fonctionnalités, notamment – lorsque ce ne sont pas des données qui sont transférées au client pour traitement, mais à l'inverse : le code devant être exécuté sur les données se déplace vers le serveur, y est exécuté, et le résultat est retourné. En tant que système de cache à part entière, ils ne sont pas souvent regardés.
Bien, ne nous décourageons pas, trouvons une comparaison directe des systèmes. Prenons les deux meilleures options – Redis et Hazelcast. Nous nous intéressons à la vitesse, et c'est sur ce critère que nous allons les comparer.
Hz vs Redis
Nous trouvons cela :
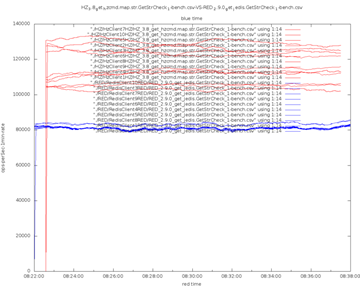
Le bleu représente Redis, le rouge Hazelcast. Hazelcast l'emporte partout, et cela est justifié : il est multithreadé, hautement optimisé, chaque thread fonctionne avec sa propre partition, donc il n'y a pas de blocages. Redis, en revanche, est monocœur, il ne tire pas profit des CPU modernes à plusieurs cœurs. Hazelcast utilise l'I/O asynchrone, tandis que Redis-Jedis utilise des sockets bloquants. En fin de compte, Hazelcast emploie un protocole binaire, alors que Redis est basé sur du texte, ce qui le rend moins efficace.
Pour être sûr, posons à nouveau la question à une autre source de comparaison. Que va-t-il nous montrer ?
Redis vs Hz
Encore une autre :
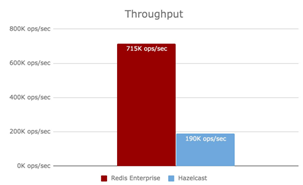
Ici, c'est l'inverse, le rouge représente Redis. Cela signifie que Redis surpasse Hazelcast en termes de performance. Dans la première comparaison, Hazelcast l'emportait, dans la seconde, c'est Redis. il a été très clairement expliqué pourquoi Hazelcast a gagné dans la comparaison précédente.
Il s'avère que le résultat du premier test était en fait truqué : Redis a été évalué dans sa version de base, tandis que Hazelcast a été ajusté pour le cas de test. Donc, il s'avère que, d'une part, personne n'est vraiment fiable, et d'autre part, lorsque nous choisissons finalement un système, nous devons également le configurer correctement. Ces réglages comprennent des dizaines, voire des centaines de paramètres.
Secouons la bouteille
Et tout le processus que nous venons de décrire, je peux l'expliquer par cette métaphore : « Secouons la bouteille ». En d'autres termes, actuellement, il n'est pas nécessaire de programmer, l'essentiel est de savoir lire stackoverflow. Dans mon équipe, j'ai un professionnel qui fonctionne précisément comme cela dans les moments critiques.
Que fait-il ? Il voit une chose qui ne fonctionne pas, remarque la trace de pile, prend certains mots de celle-ci (lesquels exactement, c'est son expertise dans le programme), cherche sur Google, trouve stackoverflow parmi les réponses. Sans lire ni réfléchir, parmi les réponses à la question, il choisit quelque chose qui ressemble le plus à « faire ceci ou cela » (choisir cette réponse est son talent, car ce n'est pas toujours celle qui a recueilli le plus de likes), applique, regarde : si quelque chose a changé, alors c'est super. Si rien n’a changé, nous revenons en arrière. Et nous répétons le lancement-vérification-recherche. De cette manière intuitive, il parvient à faire en sorte que, après un certain temps, le code fonctionne. Il ne sait pas pourquoi, il ne sait pas ce qu'il a fait, il ne peut pas l'expliquer. Mais ! Cette chose fonctionne. Et « le feu est éteint ». Maintenant, nous examinons ce que nous avons fait. Quand le programme fonctionne, c'est beaucoup plus facile. Et cela fait économiser beaucoup de temps.
Cette méthode est très bien expliquée par cet exemple.
Il fut un temps où il était très populaire de construire un voilier dans une bouteille. Le voilier est grand et fragile, tandis que le goulot de la bouteille est très étroit, impossible de le faire passer à l'intérieur. Comment le monter ?
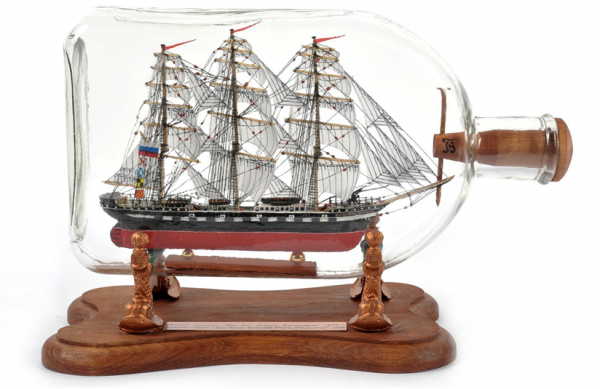
Il existe une méthode, très rapide et très efficace.
Le bateau est composé de nombreux petits éléments : bâtons, ficelles, voiles, colle. Nous mettons tout cela dans la bouteille.
Nous prenons la bouteille à deux mains et commençons à secouer. Nous secouons, secouons. Et généralement, ça donne un résultat complètement raté, bien sûr. Mais parfois. Parfois, ça donne un bateau ! Plus précisément, quelque chose qui ressemble à un bateau.
Nous montrons ce quelque chose à quelqu'un : « Sergueï, tu vois !? ». Et en effet, de loin, on dirait un bateau. Mais après, il ne faut pas le lâcher.
Il existe une autre méthode. Les gars plus avancés, comme des hackers, l'utilisent.
J'ai confié une tâche à un tel gars, il a tout fait et est parti. Et en regardant, on dirait que c'est fait. Mais au bout d'un certain temps, quand il faut retravailler le code, c'est là que ça commence à devenir compliqué à cause de lui... Heureusement, il avait déjà eu le temps de s'éloigner. Ce sont ces gars qui, sur l'exemple de la bouteille, font ça : voyez, là où se trouve le fond, le verre se courbe. Et il n'est pas tout à fait clair s'il est transparent ou non. Alors, les « hackers » coupent ce fond, insèrent le bateau à l'intérieur, recollent ensuite le fond, et ça a l'air comme si c'était prévu.
D'un point de vue de formulation de tâche, cela semble tout à fait correct. Mais en ce qui concerne les bateaux : à quoi bon construire ce bateau, à qui en a-t-on vraiment besoin ? Il n'a aucune fonctionnalité. En général, ces bateaux sont des cadeaux pour des personnes très haut placées, qui les mettent sur une étagère, comme un symbole, un signe. Et si une telle personne, un directeur d'une grande entreprise ou un fonctionnaire de haut rang, a un tel produit de qualité inférieure, avec le goulot coupé, cela serait mieux qu'il n'en sache jamais rien. Alors, comment fabriquent-ils ces bateaux qui peuvent être offerts à une personne importante ?
Le seul endroit, clé, avec lequel il n'y a vraiment rien à faire, c'est la coque. Et la coque du navire passe précisément par le goulot. Alors que le navire est assemblé en dehors de la bouteille. Mais ce n'est pas simplement assembler le navire, c'est un véritable art de la bijouterie. Des leviers spéciaux sont ajoutés aux pièces qui permettent de les soulever par la suite. Par exemple, les voiles sont pliées, soigneusement mises à l'intérieur, et ensuite, à l'aide d'une pince, elles sont très délicatement, précisément, tirées et levées. En guise de résultat, on obtient une œuvre d'art, que l'on peut offrir avec une conscience tranquille et fierté.
Et si nous voulons que le projet soit réussi - il doit y avoir au moins une personne bijoutier dans l'équipe. Celui qui se soucie de la qualité du produit et prend en compte tous les aspects, sans sacrifier aucun, même dans des moments de stress, lorsque les circonstances exigent de faire quelque chose en urgence au détriment de l'important. Tous les projets réussis, qui sont durables, qui ont résisté à l'épreuve du temps, sont construits sur ce principe. Ils ont quelque chose de très précis et unique, quelque chose qui utilise toutes les possibilités disponibles. Dans l'exemple du navire dans une bouteille - cela joue sur le fait que la coque du navire passe par le goulot.
Revenant à la tâche de choisir notre serveur de mise en cache, comment ce procédé pourrait-il être appliqué ? Je propose une option de sélection parmi tous les systèmes disponibles : ne pas secouer la bouteille, ne pas choisir, mais examiner ce qu'il y a fondamentalement dans chacun d'eux, les points à considérer lors du choix du système.
Où chercher le goulet d'étranglement
Essayons de ne pas secouer la bouteille, ne pas passer en revue tout ce qu'il y a, mais examinons les tâches qui pourraient survenir si, par hasard, pour notre tâche - nous devions concevoir un tel système par nous-mêmes. Bien sûr, nous ne reconstruirons pas le vélo, mais nous utiliserons ce schéma pour nous orienter sur quels points prêter attention dans les descriptions des produits. Ébauchons un tel schéma.
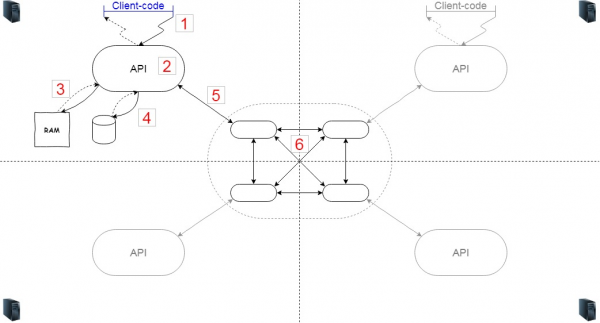
Si le système est distribué, alors nous aurons plusieurs serveurs (6). Supposons quatre (pratique à représenter sur l'image, mais bien sûr, il peut y en avoir autant que nécessaire). Si les serveurs sont sur différents nœuds, cela signifie que certains codes tournent sur chacun d'eux, responsables de l'agencement de ces nœuds en un cluster et, en cas de rupture - se connectant, se reconnaissant mutuellement.
Il faut encore un code de logique (2) qui concerne le cache. Ce code interagit avec les clients via une certaine API. Le code client (1) peut être exécuté à l'intérieur de la même JVM ou l'appeler à distance. La logique mise en œuvre détermine quels objets conserver dans le cache et lesquels éliminer. Pour stocker le cache, nous utilisons la mémoire (3), mais si nécessaire, nous pouvons également sauvegarder certaines données sur le disque (4).
Examinons où la charge va apparaître. En fait, chaque flèche et chaque nœud va être chargé. Tout d'abord, entre le code client et l'API, si c'est une interaction réseau, le ralentissement peut être assez perceptible. Deuxièmement, à l'intérieur même de l'API - si nous complexifions trop la logique, nous pouvons être limités par le CPU. Il serait préférable que la logique ne sollicite pas la mémoire inutilement. Et il reste l'interaction avec le système de fichiers - généralement, cela consiste à sérialiser / récupérer et écrire / lire.
Ensuite, l'interaction avec le cluster. Très probablement, il sera sur le même système, mais il peut aussi être séparé. Ici, il faut également prendre en compte le transfert de données vers lui, la vitesse de sérialisation des données et l'interaction entre le cluster.
Maintenant, d'une part, nous pouvons visualiser «quelles roues vont tourner» dans le système de cache lors du traitement des requêtes de notre code, et d'autre part, nous pouvons estimer quels types et combien de requêtes notre code générera vers ce système. C'est suffisant pour faire un choix plutôt éclairé - adapter le système à notre cas d'utilisation.
Hazelcast
Voyons comment appliquer ce type de décomposition à notre liste. Par exemple, Hazelcast.
Pour stocker / récupérer des données de Hazelcast, le code client fait appel (1) à l'API. Hz permet de démarrer le serveur en mode embarqué, et dans ce cas, l'appel à l'API est un appel de méthode à l'intérieur de la JVM, ce qui peut être considéré comme gratuit.
Pour que la logique dans (2) fonctionne, Hz s'appuie sur le hachage d'un tableau de bytes sérialisé comme clé - en d'autres termes, la sérialisation de la clé se produira dans tous les cas. C'est une surcharge inévitable pour Hz.
Les stratégies d'éviction sont bien mises en œuvre, mais pour des cas particuliers, on peut brancher les siennes. Il n'y a pas lieu de s'inquiéter pour cette partie.
Le stockage (4) peut être connecté. Excellent. L'interaction (5) pour embedded peut être considérée comme instantanée. L'échange de données entre les nœuds du cluster (6) – oui, cela existe. C'est une contribution en faveur de la résilience au prix de la vitesse. La fonction Hz Near-cache permet de réduire le coût – les données obtenues à partir d'autres nœuds du cluster seront mises en cache.
Que peut-on faire dans de telles conditions pour augmenter la vitesse?
Par exemple, pour éviter la sérialisation de la clé dans (2) – ajouter un autre cache au-dessus de Hazelcast pour les données les plus chaudes. Chez Sportmaster, ils ont choisi Caffeine pour cet objectif.
Pour le tuning au niveau (6), deux types de stockage sont proposés dans Hz : IMap et ReplicatedMap.
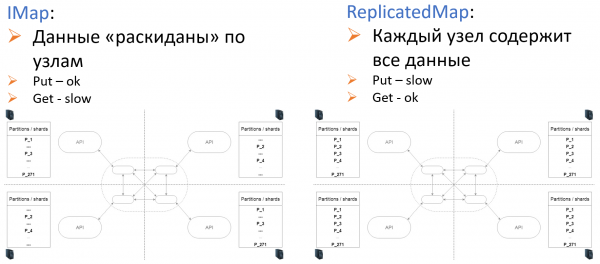
Il convient de dire comment Hazelcast est entré dans la pile technologique de Sportmaster.
En 2012, lorsque nous travaillions sur le tout premier pilote du futur site, c'est Hazelcast qui s'est avéré être le premier lien fourni par le moteur de recherche. La rencontre s'est faite à 'première vue' - ce qui nous a séduits, c'est qu'après seulement deux heures d'intégration de Hz dans le système - il fonctionnait. Et ça fonctionnait bien. D'ici la fin de la journée, nous avons ajouté plusieurs tests, ravis. Et cet élan nous a permis de surmonter les surprises que Hz a révélées avec le temps. Actuellement, l'équipe de Sportmaster n'a aucune raison de se séparer de Hazelcast.
Mais des arguments tels que 'premier lien dans le moteur de recherche' et 'nous avons rapidement construit HelloWorld' - sont bien sûr l'exception et le contexte particulier dans lequel s'est déroulé le choix. Les véritables épreuves pour le système choisi commencent avec le passage en production, et c'est à cette étape qu'il faut prêter attention lors du choix de tout système, y compris le cache. En fait, dans notre cas, on peut dire que nous avons choisi Hazelcast par hasard, mais il s'est avéré que nous avons fait le bon choix.
Pour la production, il est beaucoup plus important : la surveillance, le traitement des pannes sur des nœuds individuels, la réplication des données, le coût de mise à l'échelle. En d'autres termes, il faut prêter attention aux problèmes qui surgiront lors de l'exploitation du système - lorsque la charge dépassera de plusieurs dizaines de fois la charge prévue, lorsque nous téléchargerons accidentellement quelque chose de faux et au mauvais endroit, lorsque nous devrons déployer une nouvelle version du code, remplacer des données et le faire sans que les clients le remarquent.
Pour tous ces besoins, Hazelcast convient sans aucun doute.
À suivre
Mais Hazelcast n'est pas une panacée. En 2017, nous avons choisi Hazelcast pour le cache de l'interface d'administration, simplement sur la base d'une bonne impression d'expériences passées. Cela a joué un rôle clé dans une très mauvaise blague, ce qui nous a mis dans une situation difficile et nous avons mis 60 jours à en sortir « héroïquement ». Mais nous en parlerons dans la prochaine partie.
En attendant… Joyeux Nouveau Code !
Source : habr.com
