

Si vous ne comprenez pas ce qu'est DevOps, voici un bref rappel. DevOps est un ensemble de pratiques qui réduisent les craintes des ingénieurs et diminuent le nombre de pannes dans la production de logiciels. En général, elles réduisent le temps de mise sur le marché — la période entre l'idée et la livraison du produit final aux clients, ce qui permet d'effectuer rapidement des expériences commerciales..
Comment commencer la transformation DevOps ? En bref : choisissons le service à partir duquel nous allons entamer le processus, identifions ceux qui sont concernés par le service, construisons une carte de flux de valeur, formons une équipe temporaire qui s'occupera de la transformation pendant un certain temps et lui fixons une tâche. Répétons le cycle autant de fois que nécessaire.
Un plan détaillé de la transformation DevOps avec des exemples et des instructions est disponible sous le spoiler — dans la transcription Andrei Alexandrov — d'un ingénieur de l'entreprise Express42, qui conseille sur la mise en place de DevOps, en accélérant ce processus, car elle a déjà construit une carte des écueils. Si vous pensez que la transformation n'est pas nécessaire, ou que votre spécificité fait que les pratiques DevOps ne conviennent pas, utilisez le rapport comme un guide pour identifier et résoudre les contraintes.
Si la question de la transformation DevOps vous préoccupe, c'est que vous avez une grande entreprise, et il est nécessaire d'élargir progressivement ce processus à toute la structure. Tant qu'il est nécessaire de transformer l'équipe ou de résoudre une contrainte, l'algorithme ci-dessous peut être répété.
Choix du service
Nous avons esquissé un plan, commençons par la première étape : choisir le service. Le premier critère est la durée de vie: il y a des anciens services — legacy, et des nouveaux. On peut commencer avec l'un ou l'autre.
Choisir un service jeune est logique.Il est nouveau, il n'y a pas encore de processus établi au sein de l'équipe qui s'en occupe. Il n'y a pas une montagne de dettes techniques, il n'est pas nécessaire de le réparer constamment. Nous pouvons faire tout ce que nous voulons avec.
Dans le cas d'un ancien service, des problèmes se posent, car le changement est toujours difficile.Il y a déjà un ensemble de contraintes sérieuses, mais peut-être que des personnes s'en occupent qui sont prêtes à tout reprendre — elles sont fatiguées et veulent faire les choses différemment, parce qu'elles souffrent.
Travailler avec un ancien service crée un puissant précédent dans votre entreprise — on peut changer quelque chose. Si vous avez modifié un nouveau service, qui est en production 100 fois par heure, et que tout va bien, alors les gens dans votre entreprise peuvent dire :
— C'est un nouveau service ! C'était si simple avant, essayez de faire quelque chose avec notre vieux tas de ferraille.
Un service legacy a du sens à transformer, lorsque vous le faites avec quelqu'un, par exemple, si vous avez invité un consultant externe. Soyons honnêtes, la transformation va bouleverser tout ce qui peut l'être.. Vous expérimentez et vous ne savez pas où vous allez, quelles technologies vous allez utiliser et pourquoi, où et quels pièges vous rencontrerez dans les processus. C'est pourquoi il est plus facile de changer pour un nouveau.
Si vous faites tout vous-même et qu'il n'y a pas de compétence sérieuse dans l'entreprise — prenons un nouveau service. Si vous connaissez un consultant externe et avez des fonds — choisissez l'ancien.
Il y a des services qui ne sont qu'une interface pour les utilisateurs, comme un simple site web ou une application mobile. Mais il y a des choses sérieuses comme la facturation. Si quelque chose va mal avec la facturation, il sera difficile de résoudre le problème. Ici aussi, nous avons le choix.
Nous travaillons soit avec un service critique, mais déjà à cause de lui nous souffrons, il crée des limitations, soit nous travaillons avec une interface. C'est le deuxième critère de choix. De même, il est possible de faire appel à un consultant expérimenté — nous travaillons avec l'option la plus complexe.
Mais même dans ce cas, je ne recommanderais pas de le faire, car tant que nous n'avons pas compris sur quoi nous travaillons et dans quelle direction transformer, prendre quelque chose de critique et le chambouler — ce n'est pas une très bonne idée. C'est pourquoi dans ce cas nous préférons travailler avec une interface, dont la panne n'est pas critique.
Ensuite, examinons l'équipe de service. Avec ceux qui s'occupent de ce service, nous devrons travailler constamment et interagir dans un contact très étroit.
Les gens dans l'équipe se divisent en deux catégories : les conservateurs — ils vivent dans l'ancien monde, ou ne savent tout simplement rien sur le DevOps, et les innovateurs, qui tirent toutes les pratiques à la mode. Les seconds ne comprennent pas toujours le sujet, mais au moins ils sont prêts à s'y attaquer.
D'un côté, les conservateurs — ce sont des gens expérimentés : ils sont dans l'entreprise depuis longtemps, ils comprennent de bout en bout, mais ne connaissent pas vraiment les pratiques. D'un autre côté — les innovateurs, qui ont entendu parler de certains sujets, mais qui travaillent probablement dans l'entreprise depuis pas très longtemps. Avec qui est-il préférable de travailler ?
Il faudra interagir avec les conservateurs de toute façon, car c'est leur service. Nous devrons communiquer avec eux, clarifier les spécificités du service, ce qui peut être fait d'une manière ou d'une autre. Nous dépendons de leurs conseils. Il est probable que nous devrons leur confier certaines tâches, car ils connaissent leur service mieux que quiconque. Il est donc important de savoir avec quelle équipe nous aurons finalement contact.
Il est logique de choisir une équipe d'innovaturs, car les conservateurs pourraient poser problème.
Dans la pratique, il arrive souvent que les personnes conservatrices aient une expérience significative, mais qu'elles ne sachent pas comment avancer. Elles ont simplement peur qu'après la transformation et la refonte du service, elles soient licenciées par manque de besoin. Parfois, simplement par mécompréhension de ce qui se passe, elles sabotent le travail.
J'ai eu un cas où un gars de l'équipe réparait tout ce qui lui passait par la tête, car cela semblait plus critique que ce que nous faisions à ce moment-là. Nous avons une tâche : réaliser cette partie aujourd'hui — non, il y a un incendie à l'autre bout du monde, nous allons le réparer. Travailler avec ce genre de personnes est difficile.
Les gens de l'équipe des conservateurs ont souvent tendance à ignorer les tâches, ou à les remettre à plus tard. Et si, par malheur, vous avez fait une erreur et leur avez imposé des KPI en fonction du nombre de tâches accomplies, et qu'une certaine partie n'est pas incluse dans les KPI pour une raison quelconque, alors ils ne feront absolument rien. En réalité, ils auraient raison, car ils perdraient alors leur prime.
Avec les innovateurs, c'est plus simple — ils sont plus loyaux.. Ils ont déjà entendu parler de quelque chose, ils veulent aller de l'avant, donc ils aideront. Nous avons besoin de personnes prêtes à souffrir au début : si le service change, tous les problèmes et embûches seront ressentis par les innovateurs en tant que pionniers. Les innovateurs veulent le plus récent et le plus tendance, même si cela implique de souffrir.
Les conservateurs peuvent être convertis plus tard à notre vision. Lorsque vous montrerez qu'une petite partie a été changée et que tout fonctionne bien, il est probable qu'ils voudront aussi essayer et accepter la nouvelle religion DevOps.
En résumé. Si nous faisons toute la transformation dans notre entreprise nous-mêmes, alors nous choisissons : un nouveau service, de préférence avec une interface simple, afin de ne pas trop souffrir des pannes, et une équipe d'innovateurs.
S'il est possible de faire appel à un consultant externe, plutôt que de prendre un nouveau service, utilisons l'ancien service dont nous souffrons déjà. Les personnes qui ont travaillé sur des transformations pendant un certain temps dans différentes entreprises ont vu divers cas et comprennent déjà comment faire les choses correctement et dans quelle direction aller.
Qui est impliqué ?
Nous devons trouver toutes les personnes ayant un lien avec le service : développeurs, testeurs, administrateurs, spécialistes de la sécurité, gestionnaires et, peut-être, Product Owners. Bien que les Product Owners ne soient pas des techniciens, ils ont un lien avec le service : ils prennent des décisions et définissent des tâches.
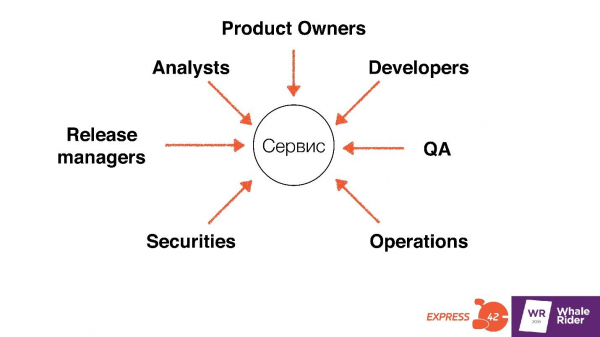
Nous devons trouver, rencontrer et discuter avec tous ceux qui prennent des décisions et influencent ce qui se passe avec le service.
Pourquoi en avons-nous besoin ? Pour savoir avec qui négocier.. Pendant la transformation, lorsque le principe de fonctionnement habituel du service change, il sera inévitable d'avoir des interruptions. Pendant un certain temps, il y aura des pannes pendant que nous testons de nouvelles approches. Les gens doivent être préparés à cela et y consentir.
Ensuite, il faudra construire une carte de flux de valeur et sans ces personnes, cela ne pourra pas être réalisé, car eux seuls connaissent l'ensemble du tableau de ce qui se passe. Une seule personne ne sait jamais tout ce qui se passe avec le service.
Ils recommanderont des personnes pour l'équipe. Plus tard, nous discuterons de la nécessité d'une équipe distincte. Il faudra prendre des personnes des départements existants. Ceux qui ont un lien avec le service pourront recommander des collègues pensant dans notre sens, qui peuvent nous aider et ont la compétence dont nous avons besoin.
Ensuite, nous rassemblons toutes ces personnes de différents départements dans une même pièce et nous commençons à construire la carte de flux de valeur.
Construire une carte de flux de valeur
La carte de flux de valeur est un schéma ou une carte qui montre le flux de valeur vers le client.C'est l'ensemble du processus, de l'idée à sa réalisation, y compris toutes les étapes intermédiaires et comment la valeur parvient finalement à nos clients.
La carte de flux de valeur est nécessaire pour visualiser toutes les étapes du développement,localiser les problèmes à travers les mesures existantes dans le processus actuel et commencer à les résoudre, et établir un objectif initial.. C'est l'endroit où nous allons réellement commencer à agir.
Métriques
Dans la littérature sur la carte de flux de valeur, il existe de nombreuses métriques différentes, mais pour commencer, trois suffisent.
Lead Time — délai / attente. — un moment où nous attendons quelque chose. Par exemple, un testeur attend qu'un stand soit disponible pour les tests, et pendant ce temps, il ne peut rien faire.
Temps de valeur ajoutée — temps de travail utile — celui que nous avons passé à une certaine étape pour créer de la valeur finale pour l'utilisateur. Par exemple, le testeur a lancé son test et a commencé à vérifier quelque chose. C'est ce que l'on appelle le temps de travail utile, lorsque nous faisons réellement quelque chose pour le produit. C'est ce pour quoi les clients paient — pour un logiciel de qualité.
%C/A — pourcentage de travail accepté. Nous avons une étape — le développement, et une deuxième étape — le test. Combien de fonctionnalités les testeurs ont reçues des développeurs, et voici ce pourcentage.
Voici à quoi ressemble notre carte.
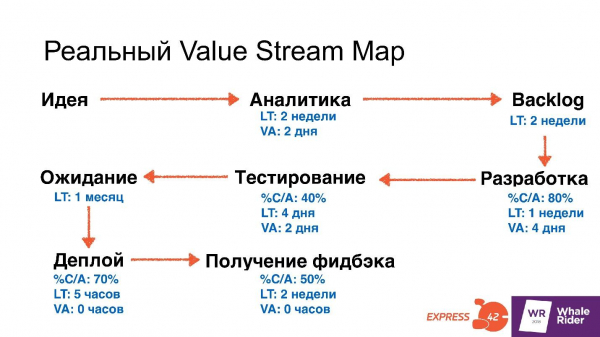
Elle peut sembler différente en fonction de la structure de l'organisation, du nombre de départements et de ce que vous faites. Mais dans l'ensemble, la carte aura deux étapes : idée et analyse. À ce stade, des données sont attendues, par exemple, un Lead Time de 2 semaines et un Temps de valeur ajoutée de 2 jours.
Les métriques couvrent absolument toutes les étapes.
Backlog — combien de tâches sont restées après que les analystes les ont imaginées.
Développement — combien de semaines les développeurs ont attendu des précisions sur les tâches, les stands ou l'équipement — peu importe, mais ils attendent quelque chose. Par exemple, ils mettent 4 jours à réaliser une fonctionnalité. Ici apparaît la métrique %C/A. Les développeurs ont pris dans le Backlog seulement 80 % des tâches. Ils estiment que pour les 20 % restants, le cahier des charges n'est pas assez clair, et les ont renvoyées pour réajustement.
Test. Dans le schéma, LT est fixé à 4 jours. Par exemple, les testeurs ont attendu la libération du stand de test, VA 2 jours ils testent réellement quelque chose, et %C/A = 40 %. — seulement 40 % du code ou des fonctionnalités envoyés par les développeurs ont été jugés adéquats par les testeurs. Tout le reste ne leur a pas convenu pour une raison quelconque.
Je ne vais pas entrer dans les détails sur la façon de réaliser ces mesures, à la fin de l'article, je recommanderai des lectures pour en apprendre davantage.
La seule chose que je conseille — ne croyez pas les personnes qui vont établir avec vous une Value Stream Map. Elles évaluent combien de temps prennent différents processus, mais ces estimations ne sont pas toujours correctes, il vaut donc mieux mesurer soi-même.
Il y a eu un cas où nous sommes allés au service des opérations et avons demandé combien de temps il fallait pour déployer une nouvelle fonctionnalité en production. On nous a répondu 10 minutes, et nous avons pensé, pourquoi sommes-nous venus dans cette entreprise ? Il s'est avéré que 10 minutes, c'est le temps que met le script pour prendre le code et le déployer sur le serveur. Mais avant cela, la version reste trois jours sur le serveur sans rien faire — une tâche est en attente dans le Backlog, qu'il faut déployer. En fait, avant la phase de déploiement, il y a une phase d'attente où le projet reste inactif. Si nous n'étions pas allés avec un carnet, si nous n'avions pas remarqué la tâche dans Jira et commencé à la suivre étape par étape, nous aurions cru que tout allait bien et qu'il n'y avait pas de problème.
Il faudra donc faire des mesures vous-même, de préférence pas qu'une seule fois, afin d'avoir une idée proche de la réalité. Selon la Value Stream Map, vous prendrez la décision d'où commencer et quoi corriger en premier.
Équipe temporaire
De nombreuses entreprises qui ont décidé d'implémenter le DevOps créent une équipe, mais ce n'est pas temporaire, elle existe depuis plusieurs années. Si vous consultez un service DevOps qui décrit différents modèles de structures organisationnelles en DevOps, vous comprendrez que c'est un antipattern.
Quand une équipe DevOps existe de manière permanente pendant plusieurs années, c'est une grande erreur, car DevOps concerne la communication entre les départements, la rapidité et l'efficacité.
Si l'équipe existe entre les départements seulement pour réaliser quelque chose de séparé et dure longtemps, elle crée une barrière inutile. Maintenant, au lieu que le programmeur aille directement voir l'administrateur pour résoudre un problème, il doit d'abord passer par le service DevOps, et ce dernier s'en occupera ensuite.
Donc, pour commencer, il faut créer une équipe temporaire.. Elle existe en principe pendant six mois, au maximum un an, en fonction de l'objectif fixé, uniquement pour éliminer une restriction que nous avons choisie. Ensuite, elle mourra. Si nous déterminons un autre point où nous éprouvons une grande douleur et que nous comprenons qu'une autre équipe est aussi nécessaire pour cela, nous la créerons à nouveau. Mais de telles équipes ne devraient pas exister en « permanence » — sinon, elles perturbent la communication et prennent en charge des tâches distinctes juste pour faire quelque chose. Ces tâches peuvent ne pas être en rapport avec DevOps et la transformation. Pourquoi ne pas confier cette tâche aux départements existants ?
Pourquoi une équipe temporaire est nécessaire
Conflit avec les processus actuels. La transformation DevOps implique non seulement des changements dans les technologies et les outils que nous utilisons, mais aussi un changement dans le processus de travail, la pensée et les valeurs. Si l'équipe continue de travailler comme elle en a l'habitude, elle ne pourra pas explorer d'autres approches.
Ces personnes doivent vivre selon d'autres règles : ignorer tous les KPI de l'entreprise, car elles tentent de travailler différemment. Les équipes temporaires ne rempliront pas de demandes pour obtenir un serveur, mais iront directement au service responsable avec l'exigence de leur donner en premier ce qui est nécessaire, car c'est une tâche prioritaire et parce qu'elles tentent de vivre différemment. L'équipe est en plein conflit avec tous les processus en cours. Pour que les méthodes de travail existantes ne leur posent pas problème actuellement, et qu'elles ne perturbent pas les autres, nous isolons ces personnes en les regroupant dans une équipe distincte.
Éviter la bureaucratie dans les expérimentations. Dans les équipes temporaires, il n'y a pas de bureaucratie, elles ne remplissent pas de rapports sur les heures de travail, elles ne rendent pas compte aux gestionnaires. C'est un monde absolument séparé, où les gens vivent et pensent différemment, et s'occupent de choses totalement autres. Il ne faut pas les déranger inutilement.
Travail continu sur le service. Dans le premier point, nous avons choisi quelque chose sur lequel nous allons expérimenter. Les expérimentations et la recherche de meilleures méthodes de travail sont bonnes, mais nous voulons aussi créer des fonctionnalités. Si toute l'équipe se consacre à la transformation au lieu des fonctionnalités, nous commencerons à perdre des revenus, les bugs resteront longtemps non résolus — ce n'est pas ce que nous voulons. La création d'une équipe temporaire permet d'expérimenter sans interrompre le travail sur le produit.
Ne pas perdre de temps sur des tâches de travail. C'est encore une fois au sujet du produit. Il faut beaucoup de temps pour que l'équipe essaie d'autres outils, etc. Pour que les gens se familiarisent avec les outils, commencent à les intégrer et à les utiliser correctement, il faudra au moins six mois. Si en plus ils doivent s'occuper du produit, ces six mois s'étireront indéfiniment. Si les gens s'occupent du produit, ils travaillent encore avec les anciens processus — ce n'est pas ce dont nous avons besoin.
C'est pourquoi nous recrutons des personnes de différents départements pour constituer une équipe distincte qui s'occupera de la transformation du service. En conséquence, le service fonctionne, continue de se développer, et par ailleurs, nous faisons quelques expériences dessus.
L'équipe temporaire se concentre uniquement sur la transformation DevOps — sur l'élimination des limitations que nous avons identifiées, et rien de plus.
L'équipe se compose de personnes polyvalentes. Cela signifie que nous n'avons pas pris uniquement des développeurs. Nous ne sommes pas arrivés dans le service en retirant la moitié de l'équipe — non, nous avons pris des gens de différents départements. Quelques points plus tôt, nous avons trouvé différents départements et différents employés concernés par le service en cours de transformation. Nous composons l'équipe à partir de ces personnes, car elle doit être polyvalente — nous allons changer le processus de test, le processus de développement, et le processus de maintenance du service. Des compétences variées sont nécessaires.
En général, nous prenons un développeur, un testeur et un ingénieur — un de chaque, et avec eux, nous concevons une solution qui permet de fonctionner autrement.
De préférence, ces personnes devraient avoir du poids dans l'organisation. Il peut être nécessaire de prendre un conservateur, même si ce n'est pas idéal. Si nous avons une grande entreprise, tout le monde ne croira pas à notre idée, et certains peuvent mettre des bâtons dans les roues, par exemple en ne fournissant pas de stand. C'est là qu'intervient « l'autorité » — une personne respectée avec une grande expérience, qui a gagné la confiance de ses collègues. L'autorité d'un collaborateur au sein de l'équipe facilitera la tâche et le travail de l'équipe temporaire. Les gens penseront :
— Ah, ce mec génial que nous connaissons tous et aimons, il y est impliqué — il doit y avoir quelque chose à voir avec DevOps !
Nous fixons un objectif
Nous avons réuni des gens, choisi un service, examiné les limitations, déterminé sur qui nous pouvons avoir une influence. Maintenant, nous devons définir un objectif et il doit être clairement défini selon SMART — tout comme nous aimons.
Spécifique — spécifique.
Mesurable — mesurable. C'est un point très important du SMART. Si vous ne pouvez pas mesurer quelque chose, vous ne pouvez pas le changer et comprendre ce que vous avez amélioré ou détérioré.
Atteignable — atteignable. Prenez en compte votre spécificité. Si vous êtes une entreprise avec une longue histoire et beaucoup de responsabilités, qui sort une version de produit par an, vous ne pourrez pas atteindre la sortie de nouvelles versions chaque heure en six mois. Cela ne fonctionnera pas. Donc, fixez un objectif réaliste qui peut être atteint dans un délai acceptable.
Pertinent — pertinent. Nous éliminons uniquement la contrainte qui affecte réellement nos objectifs actuels.
Temporellement limité — limité dans le temps. S'il n'y a pas de délai, l'équipe va faire n'importe quoi : essayer 15 technologies au lieu de 3, rédiger d'énormes rapports, mener des recherches inutiles, peaufiner leur implémentation à la perfection alors que l'objectif est déjà atteint.
Nous définissons l'objectif précisément avec l'aide du Value Stream Map — nous rassemblons à nouveau toutes les personnes et dessinerons. Mais cette fois, sur la base de la précédente Value Stream Map, nous allons dessiner ce que nous voulons obtenir.
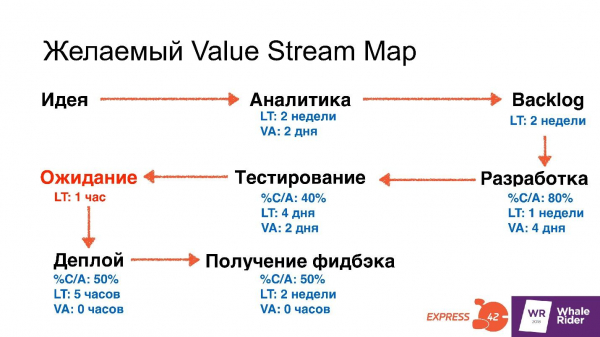
Nous identifions une contrainte que nous allons éliminer immédiatement — c'est ce que l'équipe va faire. Par exemple, j'ai pris l'attente entre la sortie d'une version finale et son déploiement en production — c'est la contrainte la plus fréquente pour laquelle les gens font appel à des consultants.
À partir de cela, nous formons la tâche : nous voulons que l'attente entre la version finale prête et son lancement soit d'un maximum d'une heure.
Exemples de tâches.
- Réduire le Lead Time des tests de 4 jours à 1 heure.
- Réduire le Value Added Time pour les tests de 2 jours à 3 heures.
- Réduire le Lead Time de déploiement de 5 heures à 10 minutes.
- Augmenter le C/A de 50 % à 95 %, c'est-à-dire augmenter le nombre de fonctionnalités acceptées par les testeurs, en d'autres termes, améliorer la qualité du travail des développeurs.
Les exemples de tâches ne sont pas tirés de nulle part — ils sont basés sur des mesures que nous avons prises lors de l'élaboration du Value Stream Map.
Nous fixons une tâche similaire à notre équipe avec une contrainte de temps. Selon l'état de votre entreprise, vous fixez différents délais. En moyenne, pour éliminer une contrainte, si les personnes s'attaquent à cela pour la première fois et ne savent pas encore quelles technologies et comment précisément elles vont résoudre le problème, cela prend généralement six mois.
Planification courte
Alors, notre équipe est constituée, elle a un objectif, les gens commencent à travailler. Un élément important est la planification courte des tâches : des sprints d'une à deux semaineset pas plus, des améliorations mesurables chaque semaine et un ajustement de cap.
Par exemple, nous utilisons souvent l'approche moving-moving, où toute l'équipe se réunit au début de chaque semaine, rédige dans un fichier ce que chacun fera. Après une semaine, nous notons : ce qui a été fait et ce qui ne l'a pas été, si ce n'est pas le cas, pourquoi, et réfléchissons à ce qu'il faut faire ensuite.
Les sprints permettent d'ajuster le cap à temps.
Nous avons essayé quelque chose pendant une ou deux semaines : des technologies, des méthodes, des façons de travailler, après cela, vous évaluez à nouveau et regardez — cette approche a-t-elle été meilleure ou pire ? Si c'est pire, cela signifie que nous ne sommes pas sur la bonne voie, il faut ajuster le cap : définir un autre objectif, adopter une autre technologie ou faire autre chose. Les sprints courts de 1 à 2 semaines permettent de naviguer et d'éviter à temps de mauvaises décisions.
Nous partageons le succès
L'équipe atteint certains succès, petits ou grands — peu importe, il y a toujours un résultat. Tout le monde doit être au courant de ce résultat : ceux qui sont impliqués dans DevOps, ainsi que les départements voisins. Dans un monde idéal, il serait souhaitable que cela atteigne vraiment tous les membres de l'entreprise.
Pourquoi ? Si nous voulons transformer non pas une partie de l'entreprise, éliminer une seule contrainte, mais tout, pour que l'entreprise devienne agile, que le code arrive rapidement au client et que rien ne casse, il faut que tout le monde adhère à l'idée de DevOps. Vous ne pourrez pas appliquer cette approche aux services et aux équipes qui sont catégoriquement contre.
Pour créer de la loyauté, nous devons raconter à tout le monde ce que nous avons essayé — nous avons des résultats, essayez aussi ! Cela augmentera l'intérêt et la loyauté pour ce que nous faisons, les gens commenceront à essayer de faire quelque chose dès maintenant. Comme le montre la pratique, lorsque nous partageons ce que nous avons essayé et ce que nous avons réussi, d'autres équipes commencent à demander comment et ce que nous avons fait. Elles regardent les mises en œuvre, le code, la documentation, viennent avec des questions et essaient de changer quelque chose chez elles.
Parler de ce que vous avez réussi est important. Ainsi, vous convaincrez de rejoindre votre camp des conservateurs qui voulaient tout faire à l'ancienne et les transformerez en innovateurs.
Au total
Nous choisissons un service, comme point de départ — l'endroit où nous commencerons les changements dans l'entreprise. Nous identifions tous ceux qui ont un lien avec le service et travaillons avec eux pour construire une Value Stream Map, mesurons et observons où et quels sont les points de blocage.
Nous créons une nouvelle équipe temporaire, qui sera chargée de la tâche assignée. Sur la base des mesures et de la Value Stream Map , nous dessinons une nouvelle carte où nous mettons en évidence la contrainte que nous allons résoudre. Sur la base de cette contrainte nous fixons un objectif, sur lequel l'équipe va travailler. L'objectif doit être obligatoirement SMART — spécifique, mesurable, pertinent par rapport aux tâches actuelles et limité dans le temps.
Nous répétons le processus, jusqu'à ce que nous transformions tous nos services dans la manière requise et éliminions toutes les contraintes.
Bonus. Matériaux utiles
Pour ceux qui ont décidé de se lancer dans le DevOps par eux-mêmes.
Projet «Phénix»
Le titre original est «The Phoenix Project: A Novel about It, Devops, and Helping Your Business Win». C'est un roman sur le DevOps - l'histoire d'un employé qui est devenu chef de département dans un environnement en crise. Le nouveau chef a reçu la tâche :
— Vous avez plusieurs années pour tout corriger afin que nous puissions enfin livrer notre produit à nos clients de manière rapide et efficace.
«Projet “Phénix”. Un roman sur la façon dont le DevOps change la vie pour le mieux» — un livre pour tous les dirigeants, car ce sont eux qui prennent les décisions sur ce qui se passe dans l'entreprise. Si vous êtes ingénieur ou développeur et que vous souhaitez initier le changement et la transformation dans votre entreprise — achetez le livre et offrez-le à la direction. Ce roman explique tout et se lit rapidement et facilement.
Guide sur DevOps
Un livre un peu plus complexe. Publié il y a quelques années en anglais sous le titre «The DevOps Handbook: How to create world-class agility, reliability, and security in technology organizations», mais il est maintenant disponible en russe. C'est un véritable manuel — un guide pratique: sur la façon de prendre des mesures, ce qu'est une Value Stream Map et à quoi elle sert, vers où se diriger et dans quel ordre. Ce livre est fait pour ceux qui veulent tout réaliser par eux-mêmes. La meilleure chose, c'est qu'il contient des exemples d'autres entreprises.
Par exemple, il y est expliqué comment une entreprise a construit une Value Stream Map et a compris que sa limitation n'était pas dans le produit, mais dans le fait que le caissier se déplace du magasin au bureau voisin pour utiliser ce produit. Au lieu de résoudre le problème avec le logiciel, ils ont simplement acheté des tablettes pour leurs vendeurs, et maintenant personne n'a besoin de bouger, toutes les actions se font sur le lieu de travail. Conclusion : la Value Stream Map peut être appliquée non seulement aux logiciels, mais aussi à tous les processus de l'organisation.
Accélérer
Titre complet : « Accélérer : La Science du Lean Software et du DevOps : Construire et Élargir des Organisations Technologiques Performantes ». C'est le niveau supérieur — hardcore. Le livre est sorti l'année dernière, pour l'instant seulement en anglais et il traite de recherches. Les auteurs — Nicole Forsgren, Jez Humble et Gene Kim — ont appliqué différentes pratiques dans diverses entreprises pendant de nombreuses années et ont étudié quelles pratiques influencent comment et sur quoi.
Dans le deuxième chapitre, consacré aux mesures, on mentionne la Value Stream Map, les métriques que j'ai évoquées, et beaucoup d'autres, ainsi qu'un descriptif détaillé du processus de mesure. Les auteurs effectuent des mesures à l'aide de questionnaires et d'un suivi autonome des tâches. Il est expliqué en détail quelles métriques mesurer correctement, lesquelles éviter, et les erreurs humaines dans les mesures. Si vous avez des difficultés avec les mesures, consultez le deuxième chapitre du livre « Accélérer ». Si votre équipe possède de nombreuses pratiques, mais qu'il est difficile de savoir lesquelles appliquer maintenant, lesquelles plus tard, lesquelles sont véritablement efficaces et lesquelles ne le sont pas — lisez, tout y est expliqué dans le livre.
La transformation est une question à l'intersection du DevOps et de la gestion. C'est dans cette même zone de convergence entre le développement, l'exploitation et les tests que se trouvent les thèmes que nous essayons de discuter à , la même intégration est nécessaire pour créer un produit de qualité – le principal thème . Gestion au festival ont été présentés — signifie qu'il faut aller chercher des idées pour la transformation là-bas. Rejoignez-nous les 27 et 28 mai, nous allons nous intégrer et nous transformer.
Source : habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish