

Jamais vu, et voilà encore !
Lors d'un projet récent, nous avons décidé d'utiliser Liquibase dès le départ pour éviter des problèmes à l'avenir. Il s'est avéré que tous les jeunes membres de l'équipe ne savent pas l'utiliser correctement. J'ai donc animé un atelier interne que j'ai décidé de transformer en article.
Cet article contient des conseils utiles et décrit les trois pièges les plus évidents dans lesquels on peut tomber en travaillant avec des outils de migration de bases de données relationnelles, en particulier Liquibase. Il est destiné aux développeurs Java de niveau Junior et Middle ; pour les développeurs plus expérimentés, cela pourrait être intéressant pour structurer et revoir ce qui est probablement déjà connu.
Liquibase et Flyway sont les deux technologies concurrentes principales pour le contrôle de version des structures relationnelles dans le monde Java. La première est entièrement gratuite et, dans la pratique, elle est souvent choisie pour son utilisation, c'est donc Liquibase qui est mis en avant dans cette publication. Cependant, certaines des pratiques décrites peuvent être universelles, selon l'architecture de votre application.
Les migrations de structures relationnelles sont une réponse inévitable à la faible flexibilité des entrepôts de données relationnelles. À une époque où la mode était à la POO, le travail avec les bases de données impliquait de définir un schéma une fois et de ne plus y toucher. Mais la réalité est toujours telle que tout change, et des modifications dans la structure des tables sont souvent nécessaires. Naturellement, le processus peut être douloureux et désagréable.
Je ne vais pas approfondir la technologie ni donner des instructions pour ajouter la bibliothèque à votre projet, de nombreux articles ont déjà été écrits à ce sujet :
De plus, il y avait déjà un excellent article sur les conseils utiles :
Si je ne pouvais donner qu'un seul conseil, ce serait celui-ci :
Je souhaite partager mes conseils et commentaires, qui sont nés de la sueur, du sang et de la douleur de résoudre des problèmes de migration.
1. Avant de commencer, il convient de consulter la section des meilleures pratiques sur Liquibase
Il s'agit de choses simples mais très importantes, sans lesquelles l'utilisation de la bibliothèque peut compliquer votre vie. Par exemple, une approche non structurée de la gestion des changelogs conduira tôt ou tard à la confusion et à des migrations rompues. Si vous appliquez des modifications inter-dépendantes de la structure de la base de données et de la logique des services sans le faire simultanément, il y a de fortes chances que cela entraîne des tests échoués ou un environnement cassé. De plus, les recommandations concernant l'utilisation de Liquibase sur le site officiel contiennent un point sur le développement et la vérification des scripts de rollback en parallèle avec les scripts de migration principaux. Enfin, dans l'article il y a des exemples de code concernant les migrations et le mécanisme de rollback.
2. Si vous avez commencé à utiliser des outils de migration, n'autorisez pas de corrections manuelles dans la structure de la base.
Comme on dit : « Une fois Persil — toujours Persil ». Si la base de votre application commence à être gérée par Liquibase, toute modification manuelle entraîne instantanément un état incohérent, et le niveau de confiance dans les changelogs tombe à zéro. Les risques potentiels incluent plusieurs heures passées à restaurer la base, et au pire, un serveur fichu. Si dans votre équipe se trouve un DBA Architect de la vieille école, expliquez-lui patiemment et attentivement à quel point tout ira mal s'il modifie simplement la base selon son propre jugement à partir d'un supposé SQL Developer.
3. Si le changelog a déjà été poussé dans le référentiel, évitez de le modifier.
Si un autre développeur a fait un pull et a appliqué un changelog qui sera ensuite modifié, il vous remerciera sans doute lorsque qu'il obtiendra une erreur au démarrage de l'application. Si la modification d'un changelog fuit d'une manière ou d'une autre dans le développement — il faudra cheminer sur une route glissante de correctifs. Le cœur du problème réside dans la validation des changements par la somme de contrôle — le mécanisme principal de Liquibase. Lors de la modification du code d'un changelog, la somme de contrôle change. La modification des changelogs est possible uniquement lorsqu'il est possible de redéployer toute la base sans perte de données. Dans ce cas, le refactoring du code SQL ou XML peut, au contraire, faciliter la vie et rendre les migrations plus lisibles. Un exemple pourrait être la situation où, au démarrage de l'application, le schéma de la base de données initiale était convenu au sein de l'équipe.
4. Ayez des sauvegardes de bases de données vérifiées, si possible.
Ici, je pense que tout est clair. En cas de migration ratée, tout peut être restauré. Liquibase a un outil de retour en arrière, mais les scripts de retour sont également écrits par le développeur, et il peut y avoir des problèmes dans ces scripts avec la même probabilité que dans les scripts du changelog principal. Cela signifie qu'il est utile de prendre des précautions avec les sauvegardes dans tous les cas.
5. Utilisez des sauvegardes de bases de données vérifiées dans le développement, si possible.
Si cela ne contrevient pas aux contrats et à la confidentialité, qu'il n'y a pas de données personnelles dans la base et qu'elle ne pèse pas lourd — avant d'appliquer des migrations sur des serveurs en production, vous pouvez vérifier comment cela fonctionne sur la machine du développeur et identifier presque 100% des problèmes potentiels lors de la migration.
6. Communiquez avec les autres développeurs de l'équipe.
Dans un processus de développement bien organisé, tout le monde dans l'équipe sait qui fait quoi. En réalité, ce n'est souvent pas le cas, donc si vous préparez des modifications dans la structure de la base de données dans le cadre de votre tâche, il est souhaitable d'en informer toute l'équipe. Si quelqu'un fait des modifications en parallèle, vous devez vous organiser avec précaution. Il est important de communiquer avec vos collègues même après avoir terminé le travail, pas seulement au début. De nombreux problèmes potentiels avec les changelogs peuvent être résolus lors de l'examen du code.
7. Réfléchissez à ce que vous faites !
Cela semble être un conseil évident, applicable à toutes les situations. Cependant, de nombreux problèmes auraient pu être évités si le développeur avait analysé une fois de plus ce qu'il faisait et quel impact cela pourrait avoir. Travailler avec des migrations nécessite toujours une attention et une prudence supplémentaires.
Pièges
Examinons maintenant les pièges typiques dans lesquels on peut tomber en ne suivant pas les conseils ci-dessus, et que faire en fait ?
Situation 1. Deux développeurs essaient d'ajouter simultanément de nouveaux changelogs.
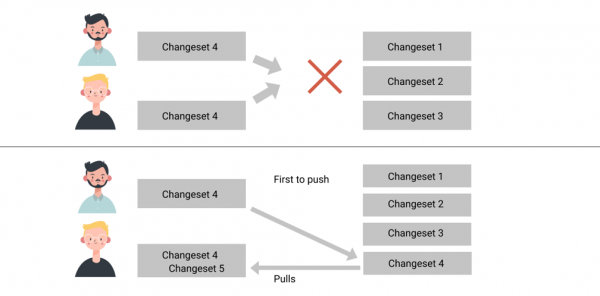
Vassia et Petia veulent créer un changelog version 4, sans savoir l’un de l’autre. Ils ont effectué des modifications dans la structure de la base de données et ont proposé un pull request, avec des fichiers de changelog différents. Voici le mécanisme d'action proposé :
Comment résoudre
- D'une manière ou d'une autre, les collègues doivent convenir dans quel ordre leurs changelogs doivent être appliqués, par exemple, celui de Petia doit être appliqué en premier.
- Une personne doit ajouter un second changement au sien et marquer le changelog de Vasya avec la version 5. Cela peut être fait via Cherry Pick ou un merge soigné.
- Après les modifications, il est impératif de vérifier la validité des actions effectuées.
En réalité, les mécanismes de Liquibase permettent d'avoir dans le dépôt deux changelogs de la version 4, donc vous pouvez laisser les choses telles qu'elles sont. Cela signifie simplement que vous aurez deux modifications de la version 4 avec des noms différents. Avec cette approche, il devient très difficile de s'orienter dans les versions de la base de données par la suite.
De plus, Liquibase, tel le foyer des hobbits, renferme de nombreux secrets. L'un d'eux est la clé validCheckSum, introduite avec la version 1.7, qui permet de spécifier une valeur de hachage valide pour un changelog, quelle que soit ce qui est stocké dans la base de données. La documentation indique ce qui suit :
Ajoutez une somme de contrôle considérée comme valide pour ce changelog, quelle que soit ce qui est stocké dans la base de données. Utilisé principalement lorsque vous devez modifier un changelog et que vous ne souhaitez pas provoquer d'erreurs sur les bases de données sur lesquelles il a déjà été exécuté (procédure non recommandée)
Oui, cette procédure n'est pas recommandée. Mais parfois, un puissant magicien de lumière maîtrise également les techniques sombres.
Situation 2. Migration dépendant des données
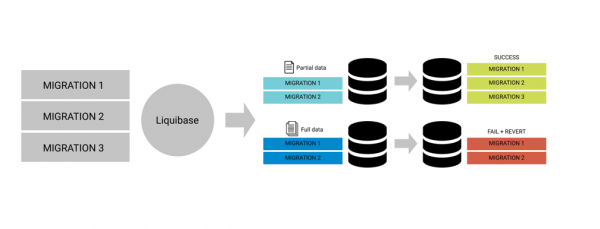
Supposons que vous n'ayez pas la possibilité d'utiliser des sauvegardes des bases sur des serveurs en production. Petya a créé un changelog, l'a vérifié localement et, avec une grande confiance en sa justesse, a fait une pull request sur le développement. Le chef de projet a pris la peine de vérifier si Petya l'avait vérifié, puis a intégré. Mais le déploiement sur le serveur de développement a échoué.
En réalité, cela peut se produire, et personne n'est à l'abri. Cela arrive lorsque les modifications de la structure des tables sont en quelque sorte liées à des données spécifiques de la base de données. Évidemment, si la base de Petya est remplie uniquement de données de test, elle peut ne pas couvrir tous les cas problématiques. Par exemple, lors de la suppression d'une table, il ressort que des enregistrements dans d'autres tables sont liés, par Foreign Key, à des enregistrements dans la table supprimée. Ou en changeant le type d'une colonne, il apparaît que 100% des données ne peuvent pas être converties au nouveau type.
Comment résoudre
- Écrire des scripts spéciaux qui seront appliqués une seule fois lors de la migration et mettront les données dans un format approprié. C'est une solution générale au problème du transfert de données vers de nouvelles structures après application des migrations, mais quelque chose de similaire peut être appliqué avant, dans certains cas particuliers. Bien sûr, cette approche n'est pas toujours disponible, car éditer des données sur des serveurs en production peut être dangereux et même destructeur.
- Une autre voie complexe consiste à modifier le changelog existant. La difficulté réside dans le fait que toutes les bases de données où il a déjà été appliqué dans sa forme actuelle devront être restaurées. Il est tout à fait possible que toute l'équipe back-end doive localement recréer la base de données à partir de zéro.
- Et la solution la plus universelle consiste à transférer le problème des données vers l'environnement du développeur avec la recréation de la même situation et l'ajout d'un nouveau changelog, jusqu'à celui qui était cassé, permettant de contourner le problème.

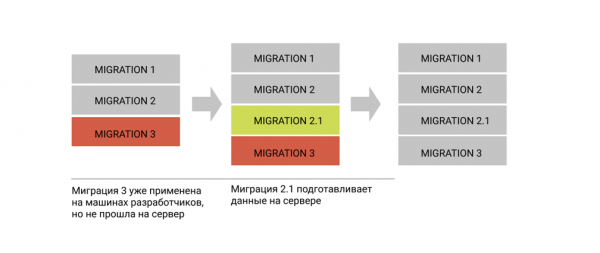
En général, plus la base de données est similaire à celle du serveur de production, moins il y a de chances que les problèmes de migration se produisent largement. Et bien sûr, avant d'envoyer le changelog dans le dépôt, il vaut mieux réfléchir plusieurs fois à la possibilité qu'il casse quelque chose.
Situation 3. Liquibase commence à être appliqué après le passage en production
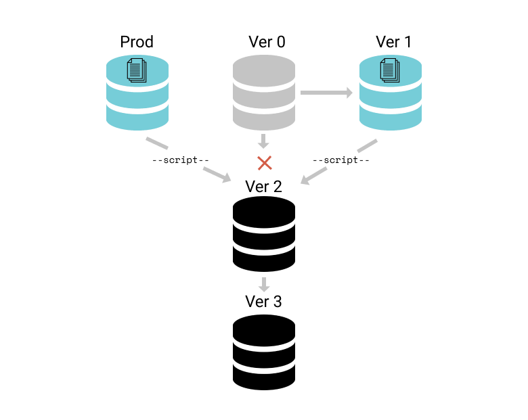
Supposons que le chef d'équipe ait demandé à Pétia d'intégrer Liquibase dans le projet, cependant, le projet est déjà en production et une structure de base existante existe.
Par conséquent, le problème est que sur tous les nouveaux serveurs ou machines des développeurs, les données des tables doivent être recréées à partir de zéro, tandis que l'environnement existant doit rester dans un état cohérent, prêt à accepter de nouveaux changelogs.
Comment résoudre
Il existe également plusieurs voies :
- La première et la plus évidente consiste à avoir un script distinct qui doit être appliqué manuellement lors de l'initialisation d'un nouvel environnement.
- La seconde — moins évidente, consiste à avoir une migration Liquibase qui se trouve dans un autre contexte Liquibase et à l'appliquer. Vous pouvez en lire plus sur le contexte Liquibase ici : . Dans l'ensemble, c'est un mécanisme intéressant qui peut être appliqué avec succès, par exemple, pour les tests.
- Le troisième chemin consiste en plusieurs étapes. Tout d'abord, une migration doit être créée pour les tables déjà existantes. Ensuite, elle doit être appliquée sur un environnement donné pour obtenir son hachage. L'étape suivante consiste à initialiser sur notre serveur non vide des tables Liquibase vides, et on peut manuellement insérer dans la table à l'historique d'application des changements une entrée pour un changement « appliqué » qui aurait été déjà fait dans la base. Ainsi, sur un serveur existant, l'historique commencera avec la version 2, tandis que tous les nouveaux environnements se comporteront de manière identique.

Situation 4. Les migrations deviennent énormes et ne s'exécutent pas à temps.
Au début du développement du service, Liquibase est généralement utilisé comme dépendance externe, et toutes les migrations sont traitées au démarrage de l'application. Cependant, avec le temps, vous pouvez rencontrer les cas suivants :
- Les migrations deviennent énormes et prennent beaucoup de temps à s'exécuter.
- Il devient nécessaire de migrer dans des environnements distribués, par exemple sur plusieurs instances de serveurs de bases de données en même temps.
Dans ce cas, une application trop longue des migrations entraînera un timeout au démarrage de l'application. De plus, appliquer les migrations pour chaque instance de l'application séparément peut entraîner une désynchronisation entre les différents serveurs.
Comment résoudre
Dans de tels cas, votre projet est déjà grand, peut-être même mature, et Liquibase commence à fonctionner comme un outil externe indépendant. En effet, Liquibase en tant que bibliothèque est empaqueté dans un fichier jar et peut fonctionner comme dépendance à l'intérieur du projet, ou de manière autonome.
En mode autonome, vous pouvez confier l'application des migrations à votre environnement CI/CD ou aux épaules solides de vos administrateurs système/experts en déploiement. Pour cela, vous aurez besoin de l'interface de ligne de commande de Liquibase. Dans ce mode, il est possible de lancer l'application juste après que toutes les migrations nécessaires aient été effectuées.
Sortie
En réalité, il peut y avoir beaucoup plus de pièges lors de la migration des bases de données, et beaucoup d'entre eux nécessitent une approche créative. Il est important de comprendre que si l'on utilise correctement l'outil, la plupart de ces pièges peuvent être évités. Personnellement, j'ai rencontré toutes les problèmes mentionnées sous différentes formes, et certains d'entre eux étaient le résultat de mes propres erreurs. En général, cela se produit, bien sûr, par inattention, mais parfois à cause d'une incapacité criminelle à utiliser l'outil.
Source : habr.com
