

Nous aimons tous les histoires. Nous aimons nous asseoir autour du feu et raconter nos anciennes victoires, combats ou simplement partager notre expérience professionnelle.
Aujourd'hui est précisément un de ces jours. Même si vous n'êtes pas autour d'un feu, nous avons une histoire pour vous. L'histoire de la façon dont nous avons commencé à travailler avec le stockage sur Tarantool.
Il était une fois, dans notre entreprise, quelques « monolithes » et un « plafond » commun qui approchait lentement mais sûrement ces monolithes, limitant l'essor de notre entreprise, notre développement. Nous avions une compréhension claire : un jour, nous nous heurterions violemment à ce plafond.
Aujourd'hui, l'idée de diviser tout et n'importe quoi prévaut, de l'équipement à la logique métier. Par conséquent, nous avons, par exemple, deux centres de données pratiquement indépendants au niveau réseau. À l'époque, tout était complètement différent.
De nos jours, il existe un tas d'outils et de moyens pour apporter des modifications sous la forme de CI/CD, K8S, etc. À l'époque « monolithique », nous n'avions pas besoin de tant de mots étrangers. Il suffisait de modifier simplement la « petite base » dans la base de données.
Mais le temps avançait, et le nombre de requêtes augmentait avec lui, atteignant parfois des RPS au-delà de nos capacités. Lorsque nous sommes entrés sur le marché des pays de la CEI, la charge sur le processeur de la base de données du premier monolithe ne descendait pas en dessous de 90 %, tandis que les RPS se maintenaient autour de 2400. Et ce n'étaient pas de simples requêtes, mais de grosses requêtes avec de nombreuses vérifications et JOINs, qui pouvaient parcourir presque la moitié des données dans un grand I/O.
Quand de vraies promotions ont commencé à apparaître pour le « Black Friday », et que Wildberries a été parmi les premiers à les organiser en Russie, la situation est devenue très préoccupante. En effet, la charge triple ces jours-là.
Oh, ces « temps monolithiques » ! Je suis sûr que vous avez également été confronté à cela, et que vous ne comprenez toujours pas comment cela a pu vous arriver.
Que peut-on y faire ? La mode touche aussi les technologies. Il y a cinq ans, nous avons dû repenser l'une de ces modes sous la forme d'un site existant basé sur .NET et MS SQL Server, qui stockait précieusement toute la logique de fonctionnement du site. Si précieusement, qu'il s'est avéré long et assez compliqué de déchirer un tel monolithe.
Petite digression.
Lors de divers événements, je dis : « si vous n'avez pas découpé le monolithe, cela signifie que vous ne vous êtes pas développé ! » J'aimerais connaître votre avis à ce sujet, merci de le partager dans les commentaires.
Et le tonnerre retentit
Revenons à notre « feu de camp ». Pour répartir la charge de la fonctionnalité « monolithique », nous avons décidé de diviser le système en microservices basés sur des technologies opensource. Parce que, au minimum, leur mise à l'échelle est moins coûteuse. Et nous étions pleinement conscients qu'il nous faudrait les faire évoluer (et pas qu'un peu). En effet, à ce moment-là, nous avions déjà réussi à entrer sur les marchés des pays voisins, et le nombre d'inscriptions, tout comme le nombre de commandes, a commencé à croître encore plus.
En analysant les premiers candidats pour passer du monolithe aux microservices, nous avons compris que 80 % des écritures dans ces systèmes provenaient à 99 % des systèmes back office, tandis que les lectures venaient du front office. Cela concernait principalement deux sous-systèmes importants pour nous : les données utilisateur et le système de calcul du prix final des produits en fonction des informations sur les remises et coupons supplémentaires pour les clients.
Pour transitionner. Il est difficile de l'imaginer maintenant, mais en plus des sous-systèmes mentionnés ci-dessus, nos catalogues de produits, le panier utilisateur, le système de recherche de produits, le système de filtrage des catalogues de produits et divers systèmes de recommandation ont également été extraits de notre monolithe. Chacun d'eux a ses propres classes de systèmes spécialisés, mais autrefois, tous vivaient dans une même « maison ».
Nous avons immédiatement prévu d'extraire les données sur nos clients vers un système de sharding. L'extraction des fonctionnalités pour le calcul du prix final des produits nécessitait une bonne scalabilité pour les lectures, car elle créait la plus grande charge en termes de RPS et était la plus complexe à réaliser pour la base de données (beaucoup de données sont impliquées dans le processus de calcul).
C'est ainsi qu'est née notre architecture, bien adaptée à Tarantool.
À l'époque, pour faire fonctionner les microservices, nous avons choisi des schémas d'opération avec plusieurs centres de données sur des machines virtuelles et physiques. Comme illustré dans les images, des variantes de réplication Tarantool ont été appliquées à la fois en mode master-master et master-slave.
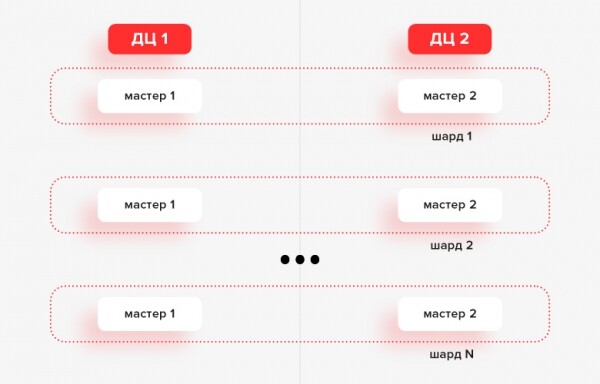
Architecture. Option 1. Service des utilisateurs
À l'heure actuelle, il y a 24 shards, chacun avec 2 instances (une par centre de données), toutes en mode master-master.
Au-dessus de la base de données se trouvent des applications qui accèdent aux répliques de base de données. Les applications interagissent avec Tarantool via notre bibliothèque personnalisée, qui implémente l'interface du pilote Go pour Tarantool. Elle détecte toutes les répliques et peut travailler avec le maître en lecture et écriture. Essentiellement, elle met en œuvre un modèle de jeu de répliques, dans lequel la logique de sélection des répliques, la gestion des nouvelles tentatives, le circuit breaker et le rate limit ont été ajoutés.
Il est possible de configurer la politique de sélection des répliques au niveau du shard. Par exemple, en utilisant un round robin.
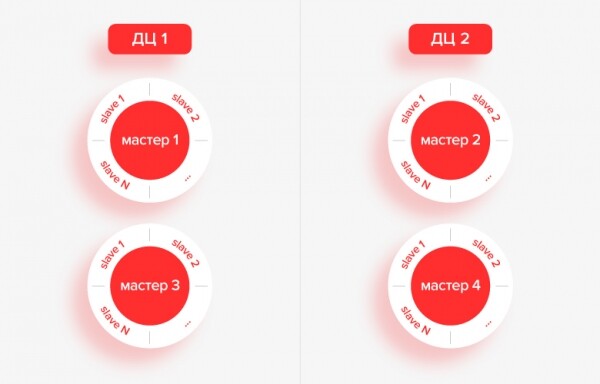
Architecture. Variante 2. Service de calcul du coût final d'un produit.
Il y a quelques mois, la majorité des demandes concernant le calcul du coût final des produits ont été transférées vers un nouveau service qui fonctionne sans base de données. Cependant, auparavant, 100 % du traitement était effectué par un service avec Tarantool en arrière-plan.
La base de données du service consiste en 4 maîtres, dans lesquels un synchronisateur collecte les données, et chacun de ces maîtres distribue les données à des répliques en lecture seule par réplication. Chaque maître a environ 15 de ces répliques.
Dans les deux schémas, en cas d'indisponibilité d'un centre de données, l'application peut obtenir des données à partir du second.
Il convient de noter que dans Tarantool, la réplication est assez flexible et peut être configurée en temps réel. Dans d'autres systèmes, des difficultés peuvent survenir. Par exemple, le changement des paramètres max_wal_senders et max_replication_slots dans PostgreSQL nécessite un redémarrage du maître, ce qui peut parfois entraîner une rupture des connexions entre l'application et le SGBD.
Cherchez et vous trouverez !
Pourquoi n'avons-nous pas fait « comme les gens normaux », mais avons choisi une méthode atypique ? Tout dépend de ce que l'on considère comme normal. Beaucoup de gens mettent en place un cluster Mongo et le répartissent sur trois centres de données géographiquement distribués.
À l'époque, nous avions déjà deux projets sur Redis. Le premier était un cache, et le second était un stockage persistant pour des données pas trop critiques. Avec ce dernier, il était assez difficile de travailler, en partie à notre faute. Parfois, des volumes assez importants restaient dans la clé, et de temps en temps, le site devenait lent. Nous avons utilisé ce système en mode maître-esclave. Et il y a eu de nombreux cas où quelque chose se passait avec le maître et que la réplication échouait.
Cela signifie que Redis est bon pour des tâches stateless, et non pour des tâches stateful. En principe, il permettait de résoudre la plupart des problèmes, mais uniquement s'il s'agissait de solutions key-value avec quelques index. Cependant, à ce moment-là, Redis avait des problèmes de persistance et de réplication. De plus, des plaintes ont été formulées concernant ses performances.
Nous avons envisagé MySQL et PostgreSQL. Mais le premier ne s'est pas vraiment implanté chez nous, et le deuxième est en soi un produit plutôt complexe, il serait donc peu judicieux d'y construire des services simples.
Nous avons essayé RIAK, Cassandra, et même une base de données graphique. Tout cela représente des solutions assez de niche qui ne conviennent pas comme un outil universel général pour créer des services.
En fin de compte, nous nous sommes arrêtés sur Tarantool.
Nous nous y sommes intéressés lorsqu'il était à la version 1.6. Nous avons été séduits par le mélange de key-value et des fonctionnalités d'une base de données relationnelle. Il dispose d'index secondaires, de transactions et de spaces, qui sont comme des tables, mais pas simples, car il est possible d'y stocker un nombre variable de colonnes. Mais la fonctionnalité centrale de Tarantool était les index secondaires combinés avec le key-value et la capacité de transaction.
La communauté russophone réactive, prête à aider dans le chat, a également joué un rôle. Nous en avons profité activement et avons vraiment vécu dans le chat. Et il ne faut pas oublier la bonne persistance sans défauts ni erreurs évidents. Si l'on regarde notre histoire avec Tarantool, nous avons eu beaucoup de douleurs et de faux pas avec la réplication, mais nous n'avons jamais perdu de données à cause de lui !
L'implémentation a débuté difficilement.
À l'époque, notre stack de développement principal était .NET, pour lequel il n'y avait pas de connecteur pour Tarantool. Nous avons immédiatement commencé à travailler en Go. Avec Lua, c'était également assez bon. Le principal problème à ce moment-là était le débogage : avec .NET, tout est parfait, mais ensuite plonger dans le monde de Lua embarqué, avec seulement des logs et aucun débogage, était difficile. De plus, la réplication échouait parfois, il a donc fallu se plonger dans la structure du moteur Tarantool. Le chat a été utile, dans une moindre mesure la documentation, et parfois nous avons consulté le code. À cette époque, la documentation était assez médiocre.
Ainsi, pendant plusieurs mois, nous avons réussi à accumuler de l'expérience et à obtenir des résultats satisfaisants avec Tarantool. Nous avons organisé dans git des travaux de référence qui ont aidé à la création de nouveaux microservices. Par exemple, lorsqu'il s'agissait de créer un nouveau microservice, le développeur se référerait aux sources de la solution de référence dans le dépôt, et la création d'un nouveau ne prenait pas plus d'une semaine.
C'étaient des temps particuliers. On pouvait, par exemple, s'approcher de l'administrateur au bureau voisin et demander : « Donne-moi une machine virtuelle ». Environ trente minutes plus tard, la machine était déjà à toi. Tu te connectais, tu installais tout, et on te redirigeait le trafic.
Aujourd'hui, cela ne fonctionne plus ainsi : il faut installer un système de surveillance pour le service, tenir un journal, couvrir les fonctionnalités avec des tests, commander une machine virtuelle ou une installation dans Kubernetes, etc. En général, cela sera mieux, même si c'est plus long et plus compliqué.
Diviser pour régner. Comment ça se passe avec Lua ?
Il y avait un dilemme sérieux : certaines équipes ne parvenaient pas à déployer des modifications de manière fiable dans un service avec beaucoup de logique en Lua. Souvent, cela était accompagné d'une non-fonctionnalité du service.
C'est-à-dire que les développeurs préparent une modification. Tarantool commence à effectuer une migration, tandis que la réplique a encore l'ancien code ; un DDL arrive par réplication, quelque chose d'autre, et le code s'effondre simplement parce que cela n'est pas pris en compte. En conséquence, la procédure de mise à jour des administrateurs était notée sur une feuille A4 : arrêter la réplication, mettre à jour cela, relancer la réplication, déconnecter ici, mettre à jour là. Un vrai cauchemar !
En fin de compte, nous essayons le plus souvent de ne rien faire en Lua. Simplement via iproto (protocole binaire pour interagir avec le serveur), et c'est tout. C'est peut-être un manque de connaissances des développeurs, mais de ce point de vue, le système est complexe.
Nous ne suivons pas toujours ce scénario à la lettre. Aujourd'hui, nous n'avons pas de noir et de blanc : soit tout en Lua, soit tout en Go. Nous comprenons déjà comment combiner les deux pour ne pas rencontrer de problèmes de migration ensuite.
Où trouve-t-on maintenant Tarantool ?
Tarantool est utilisé dans le service de calcul du prix final des produits en tenant compte des coupons de réduction, connu sous le nom de «Promoteur». Comme mentionné précédemment, il est maintenant sur le point d'être remplacé : un nouveau service de catalogue avec des prix pré-calculés prend le relais, mais il y a encore six mois, tous les calculs étaient effectués dans le «Promoteur». Auparavant, la moitié de sa logique était écrite en Lua. Il y a deux ans, le service a été transformé en stockage, et la logique a été réécrite en Go, car la mécanique des remises a légèrement changé et le service manquait de performance.
L'un des services les plus critiques est le profil utilisateur. Cela signifie que tous les utilisateurs de Wildberries sont stockés dans Tarantool, et ils sont environ 50 millions. Système partitionné par ID utilisateur, réparti sur plusieurs centres de données avec des intégrations sur des services Go.
Auparavant, le «Promoteur» était le leader en RPS, atteignant jusqu'à 6000 requêtes. À un moment donné, nous avions 50-60 instances. Actuellement, le leader en RPS est le profil utilisateur, avec environ 12000 requêtes. Ce service utilise un sharding personnalisé avec une répartition par plages d'ID utilisateur. Il gère plus de 20 machines, mais c'est trop, nous prévoyons de réduire les ressources allouées, car 4-5 machines suffisent.
Le service de sessions est notre premier service sur vshard et Cartridge. La configuration de vshard et la mise à jour de Cartridge ont nécessité un certain investissement en temps, mais au final, tout a fonctionné.
Le service pour l'affichage de différentes bannières sur le site et dans l'application mobile était l'un des premiers à sortir directement sur Tarantool. Ce service est remarquable car il a environ 6-7 ans, il est toujours en service et n'a jamais été redémarré. Une réplication master-master a été utilisée. Rien ne s'est jamais cassé.
Il existe un exemple d'utilisation de Tarantool pour la fonctionnalité de répertoires rapides dans le système d'entrepôt, afin de vérifier rapidement certaines informations. Nous avons essayé d'utiliser Redis pour cela, mais les données en mémoire prenaient plus de place que dans Tarantool.
Les services de file d'attente, d'abonnements clients, de stories tendance et de produits en attente fonctionnent également avec Tarantool. Le dernier service occupe environ 120 Go en mémoire. C'est le service le plus volumineux parmi ceux mentionnés.
Conclusion
Grâce aux index secondaires combinés avec le key-value et la gestion des transactions, Tarantool est idéal pour les architectures basées sur des microservices. Cependant, nous avons rencontré des difficultés lors du déploiement de modifications dans des services contenant une logique complexe en Lua : ces services cessaient souvent de fonctionner. Nous n'avons pas réussi à surmonter ce problème et avec le temps, nous avons trouvé différentes combinaisons de Lua et de Go : nous savons où il convient d'utiliser l'un ou l'autre langage.
Suggestions de lecture supplémentaires
- Nous créons une application à fort trafic sur Tarantool depuis zéro
- Un choix fiable du leader dans Tarantool Cartridge
- Canal Telegram Tarantool avec des nouvelles sur le produit
- Discuter de Tarantool dans le chat de la communauté
Source : habr.com
