

Une équipe d'ingénieurs du MIT a développé une hiérarchie de mémoire orientée objet pour un traitement des données plus efficace. Cet article examine son fonctionnement.
/ / PD
Comme on le sait, l'augmentation de la performance des CPU modernes n'est pas accompagnée d'une réduction correspondante de la latence d'accès à la mémoire. L'écart dans les chiffres d'une année à l'autre peut atteindre jusqu'à 10 fois (). En conséquence, un goulot d'étranglement se forme, ce qui empêche l'utilisation complète des ressources disponibles et ralentit le traitement des données.
La performance est affectée par ce qu'on appelle la latence de décompression. Dans certains cas, jusqu'à 64 cycles de processeur peuvent être nécessaires pour la préparation à la décompression des données.
Pour comparaison : l'addition et la multiplication de nombres à virgule flottante pas plus de dix cycles. Le problème est que la mémoire opère avec des blocs de données de taille fixe, tandis que les applications manipulent des objets qui peuvent contenir divers types de données et varier en taille. Pour résoudre ce problème, les ingénieurs du MIT ont élaboré une hiérarchie de mémoire orientée objet qui optimise le traitement des données.
Comment fonctionne la technologie
La solution repose sur trois technologies : Hotpads, Zippads et l'algorithme de compression COCO.
Les Hotpads sont une hiérarchie de mémoire à accès rapide gérée par logiciel (). Ces registres sont appelés pads et il y en a trois : de L1 à L3. Ils stockent des objets de tailles variées, des métadonnées et des tableaux de pointeurs.
Essentiellement, l'architecture représente un système de caches, mais optimisé pour le travail avec des objets. Le niveau du pad auquel un objet appartient dépend de la fréquence de son utilisation. Si l'un des niveaux est « saturé », le système déclenche un mécanisme similaire aux « ramasse-miettes » dans les langages Java ou Go. Il analyse quels objets sont moins utilisés que les autres et les déplace automatiquement entre les niveaux.
Les Zippads fonctionnent sur la base des Hotpads : ils archiviennent et désarchiviennent les données qui entrent ou sortent des deux derniers niveaux de la hiérarchie — le pad L3 et la mémoire principale. Dans le premier et le deuxième pad, les données sont conservées sous leur forme originale.
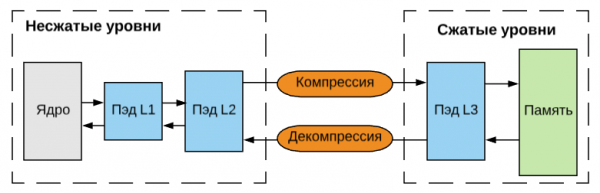
Zippads compresse les objets dont la taille ne dépasse pas 128 octets. Les objets plus volumineux sont divisés en parties, qui sont ensuite placées à différents emplacements en mémoire. Selon les développeurs, cette approche augmente le coefficient d'utilisation efficace de la mémoire.
Pour compresser les objets, l'algorithme COCO (Cross-Object COmpression) est utilisé, dont nous parlerons plus loin, bien que le système soit également capable de travailler avec ou . L'algorithme COCO est une variante de la compression différentielle (). Il compare les objets avec des « objets de base » et supprime les bits redondants — voir le schéma ci-dessous :
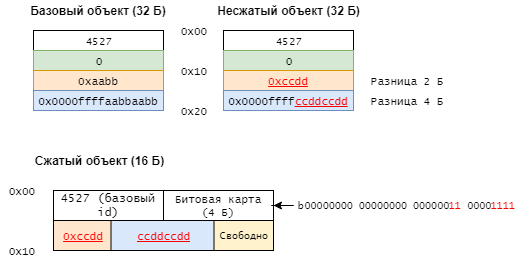
Selon les ingénieurs du MIT, leur hiérarchie de mémoire orientée objet est 17 % plus performante que les approches classiques. Elle est beaucoup plus proche de l'architecture des applications modernes, donc cette nouvelle méthode a du potentiel.
Il est prévu que la technologie soit d'abord adoptée par les entreprises travaillant avec de grandes données et des algorithmes d'apprentissage automatique. Un autre domaine potentiel est celui des plateformes cloud. Les fournisseurs IaaS pourront travailler plus efficacement avec la virtualisation, les systèmes de stockage de données et les ressources informatiques.
Nos ressources et sources supplémentaires :


Source : habr.com
