

Bonjour, Habr ! Je suis Artem Karamyshev, responsable de l'équipe d'administration système. . Au cours de la dernière année, nous avons lancé de nombreux nouveaux produits. Nous voulions nous assurer que les services API soient facilement évolutifs, fiables et prêts à répondre rapidement à une charge d'utilisateur croissante. Notre plateforme est basée sur OpenStack, et je souhaite partager les problèmes de résilience des composants que nous avons dû résoudre pour obtenir un système résilient. Je pense que cela intéressera ceux qui développent également des produits sur OpenStack.
La résilience globale de la plateforme dépend de la fiabilité de ses composants. Nous allons donc passer progressivement par tous les niveaux où nous avons identifié des risques et les avons atténués.
Vous pouvez visionner la version vidéo de cette histoire, qui est issue d'une présentation lors de la conférence Uptime Day 4, organisée par , sur la chaîne YouTube de Uptime Community. .
La partie publique du cloud MCS est actuellement basée dans deux centres de données de niveau Tier III, entre lesquels il existe une fibre sombre réservée au niveau physique par différentes liaisons, avec une capacité de 200 Gbit/s. Le niveau Tier III garantit le niveau nécessaire de résilience pour l'infrastructure physique.
La fibre sombre est réservée à la fois au niveau physique et logique. Le processus de réservation des canaux a été itératif, avec des problèmes surgissant, et nous améliorons constamment la connexion entre les centres de données.
Par exemple, récemment, lors de travaux dans un puits près de l'un des centres de données, un excavateur a percé un tuyau, à l'intérieur duquel se trouvaient à la fois un câble optique principal et de secours. Notre canal de communication résilient avec le centre de données s'est avéré vulnérable à un point, dans le puits. Par conséquent, nous avons perdu une partie de l'infrastructure. Nous avons tiré des leçons de cette expérience et avons entrepris certaines actions, notamment en installant de la fibre optique supplémentaire dans le puits voisin.
Par exemple, il n'y a pas si longtemps, lors des travaux dans un puits près de l'un des centres de données, une pelle a percuté un tuyau. À l'intérieur de ce tuyau se trouvaient à la fois le câble de fibre optique principal et le câble de secours. Notre canal de communication redondant avec le centre de données s'est avéré vulnérable à un point, dans le puits. Par conséquent, nous avons perdu une partie de notre infrastructure. Nous avons tiré des leçons de cet incident et avons pris plusieurs mesures, y compris l'installation d'une fibre optique supplémentaire dans le puits voisin.
Dans les centres de données, il y a des points de présence des fournisseurs de services, auxquels nous transmettons nos préfixes via BGP. Pour chaque direction de réseau, la meilleure métrique est choisie, permettant d'assurer la meilleure qualité de connexion à nos différents clients. Si la connexion via un fournisseur est interrompue, nous réajustons notre routage à travers les fournisseurs disponibles.
En cas de défaillance d'un fournisseur, nous basculons automatiquement vers le suivant. En cas de défaillance d'un des centres de données, nous disposons d'une copie miroir de nos services dans un second centre de données, qui prend toute la charge.
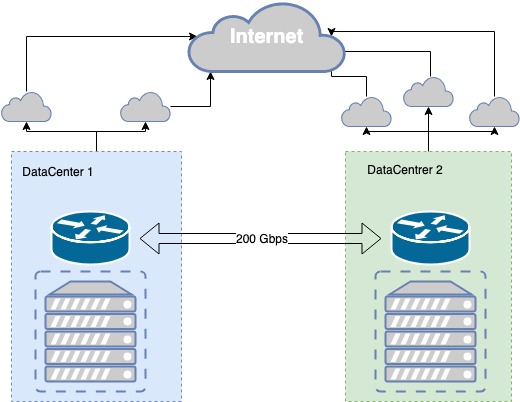
Résilience de l'infrastructure physique
Ce que nous utilisons pour la résilience au niveau des applications
Notre service est construit sur un certain nombre de composants opensource.
ExaBGP — un service qui implémente un certain nombre de fonctions en utilisant le protocole de routage dynamique basé sur BGP. Nous l'utilisons activement pour annoncer nos adresses IP publiques, grâce auxquelles les utilisateurs accèdent à l'API.
HAProxy — un équilibrage de charge hautement chargé permettant de configurer des règles d'équilibrage du trafic très flexibles à différents niveaux du modèle OSI. Nous l'utilisons pour équilibrer devant tous les services : bases de données, courtiers de messages, services API, services web, nos projets internes — tout repose sur HAProxy.
Application API — une application web écrite en python, qui permet à l'utilisateur de gérer son infrastructure, son service.
Application Worker (ci-après simplement worker) — dans les services OpenStack, c'est un démon d'infrastructure qui permet de traduire les commandes API en infrastructure. Par exemple, la création d'un disque se produit justement dans le worker, tandis que la demande de création se fait dans l'application API.
Architecture standard de l'application OpenStack
La plupart des services développés sous OpenStack tentent de suivre une seule et même paradigm. Un service se compose généralement de 2 parties : l'API et les workers (exécutants du backend). En règle générale, l'API est une application WSGI en python qui s'exécute soit comme un processus autonome (daemon), soit à l'aide d'un serveur web déjà prêt comme Nginx ou Apache. L'API traite les requêtes des utilisateurs et transmet des instructions supplémentaires à l'application worker. La transmission se fait par le biais d'un broker de messages, généralement RabbitMQ, les autres étant peu soutenus. Lorsque les messages parviennent au broker, ils sont traités par les workers qui, si besoin, retournent une réponse.
Ce paradigme implique des points de défaillance isolés : RabbitMQ et la base de données. Cependant, RabbitMQ est isolé dans le cadre d'un seul service et peut idéalement être individuel pour chaque service. Ainsi, chez MCS, nous séparons au maximum ces services, en créant une base séparée et un RabbitMQ pour chaque projet distinct. Cette approche a l'avantage que, en cas d'incident dans certaines zones vulnérables, seul une partie du service est affectée, et non l'ensemble.
Le nombre d'applications worker n'est limité par rien, donc l'API peut facilement se mettre à l'échelle horizontalement derrière des équilibres de charge pour améliorer les performances et la tolérance aux pannes.
Dans certains services, une coordination au sein du service est nécessaire - lorsque des opérations séquentielles complexes se déroulent entre l'API et les workers. Dans ce cas, un centre de coordination unique est utilisé, un système cluster tel que Redis, Memcache, etcd, qui permet à un worker de dire à un autre que cette tâche lui est assignée (« toi, ne la prends pas »). Nous utilisons etcd. En général, les workers communiquent activement avec la base de données, écrivant et lisant des informations. Pour cela, nous utilisons mariadb, qui se trouve dans un cluster multimaster.
Un service classique et isolé est organisé de manière standard pour OpenStack. Il peut être considéré comme un système autonome, pour lequel les méthodes d'évolutivité et de tolérance aux pannes sont suffisamment évidentes. Par exemple, pour garantir la tolérance aux pannes, il suffit de mettre un équilibreur de charge devant l'API. L'évolutivité des workers est atteinte en augmentant leur nombre.
Le point faible de tout le système réside dans RabbitMQ et MariaDB. Leur architecture mérite un article à part. Dans cet article, je souhaite me concentrer sur la résilience de l'API.
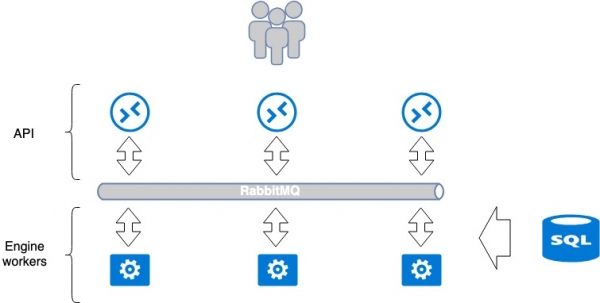
Architecture de l'application Openstack. Équilibrage de charge et résilience de la plateforme cloud.
Rendre le répartiteur HAProxy résilient grâce à ExaBGP.
Pour que nos API soient évolutives, rapides et résilientes, nous avons placé un répartiteur devant elles. Nous avons choisi HAProxy. À mon avis, il possède toutes les caractéristiques nécessaires pour notre tâche : équilibrage à plusieurs niveaux de l'OSI, interface de gestion, flexibilité et évolutivité, de nombreuses méthodes d'équilibrage, prise en charge des tables de session.
Le premier problème à résoudre était la résilience du répartiteur lui-même. Installer simplement un répartiteur crée aussi un point de défaillance : si le répartiteur tombe en panne, le service s'arrête. Pour éviter cela, nous avons utilisé HAProxy avec ExaBGP.
ExaBGP permet de mettre en œuvre un mécanisme de vérification de l'état du service. Nous avons utilisé ce mécanisme pour vérifier le bon fonctionnement de HAProxy et, en cas de problème, désactiver le service HAProxy depuis BGP.
Schéma ExaBGP+HAProxy.
- Installer le logiciel nécessaire, ExaBGP et HAProxy, sur trois serveurs.
- Créer une interface de boucle sur chacun des serveurs.
- Sur les trois serveurs, configurer cette interface avec la même adresse IP publique.
- L'adresse IP publique est annoncée sur Internet via ExaBGP.
La résilience est obtenue en annonçant la même adresse IP depuis les trois serveurs. Du point de vue du réseau, la même adresse est accessible depuis trois différents next hops. Le routeur voit trois routes identiques et choisit la plus prioritaire selon sa propre métrique (généralement la même option), et le trafic est dirigé uniquement vers l'un des serveurs.
En cas de problème avec le fonctionnement de HAProxy ou de défaillance d'un serveur, ExaBGP cesse d'annoncer la route, et le trafic bascule en douceur vers un autre serveur.
Ainsi, nous avons atteint la résilience du répartiteur.
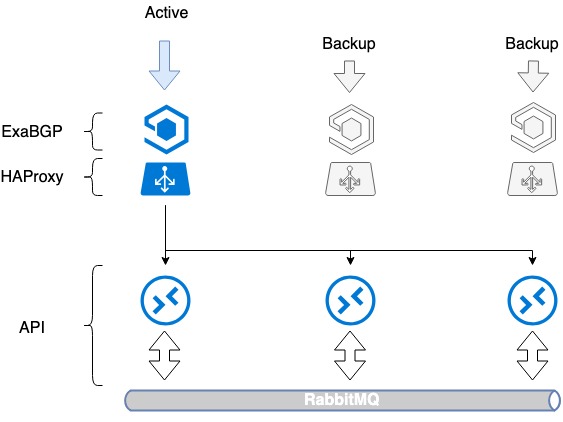
Résilience des répartiteurs HAProxy.
Le schéma n'est pas idéal : nous avons appris à rendre HAProxy redondant, mais nous n'avons pas su répartir la charge au sein des services. Nous avons donc élargi ce schéma : nous avons opté pour un équilibrage entre plusieurs adresses IP publiques.
Équilibrage basé sur DNS et BGP
La question de l'équilibrage de charge devant nos HAProxy reste à résoudre. Néanmoins, il est assez simple de le faire, comme nous l'avons fait chez nous.
Pour équilibrer trois serveurs, il faudra trois adresses IP publiques et le bon vieux DNS. Chacune de ces adresses est définie sur l'interface loopback de chaque HAProxy et annoncée sur Internet.
Dans OpenStack, un répertoire de services est utilisé pour gérer les ressources, dans lequel est défini le point de terminaison API de chaque service. Dans ce répertoire, nous inscrivons le nom de domaine — public.infra.mail.ru, qui est résolu via DNS avec trois adresses IP différentes. En conséquence, nous obtenons une répartition de charge entre les trois adresses par le biais de DNS.
Cependant, lorsque nous annonçons des adresses IP publiques, nous ne gérons pas les priorités de sélection du serveur, ce qui n'est pas encore de l'équilibrage. En général, un seul serveur sera choisi selon la hiérarchie de l'adresse IP, tandis que les deux autres resteront inactifs, car aucune métrique n'est spécifiée dans BGP.
Nous avons commencé à annoncer des routes via ExaBGP avec différentes métriques. Chaque équilibrage annonce les trois adresses IP publiques, mais l'une d'entre elles, celle principale pour cet équilibrage, est annoncée avec la métrique minimale. Donc, tant que les trois équilibrages sont en fonctionnement, les demandes à la première adresse IP atteignent le premier équilibrage, celles à la seconde vont au second, et ainsi de suite.
Que se passe-t-il lorsque l'un des équilibrages échoue ? Lorsque n'importe quel équilibrage échoue, son adresse principale est toujours annoncée par les deux autres, et le trafic entre eux est redistribué. Ainsi, nous fournissons à l'utilisateur plusieurs adresses IP via DNS. Grâce à un équilibrage par DNS et à une métrique différente, nous obtenons une répartition uniforme de la charge sur les trois équilibreurs. Et nous ne perdons pas en tolérance aux pannes.
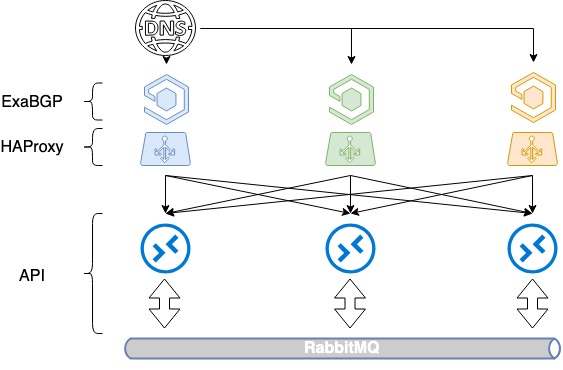
Équilibrage HAProxy basé sur DNS + BGP
Interaction entre ExaBGP et HAProxy
Nous avons donc mis en place une tolérance aux pannes en cas de défaillance d'un serveur, basée sur l'arrêt de l'annonce des routes. Mais HAProxy peut aussi tomber pour d'autres raisons que la défaillance d'un serveur : erreurs d'administration, pannes au sein du service. Nous souhaitons retirer un équilibrage défaillant de la charge et dans ces cas-là, un autre mécanisme est nécessaire.
Ainsi, en élargissant le schéma précédent, nous avons mis en œuvre un heartbeat entre ExaBGP et HAProxy. C'est une implémentation logicielle de l'interaction entre ExaBGP et HAProxy, lorsque ExaBGP utilise des scripts personnalisés pour vérifier l'état des applications.
Pour cela, il est nécessaire de configurer un vérificateur d'état dans la configuration d'ExaBGP qui pourra contrôler le statut de HAProxy. Dans notre cas, nous avons configuré un backend de vérification d'état dans HAProxy, et côté ExaBGP, nous vérifions avec une simple requête GET. Si l'annonce cesse d'avoir lieu, cela signifie que HAProxy ne fonctionne probablement pas, et il ne faut pas l'annoncer.
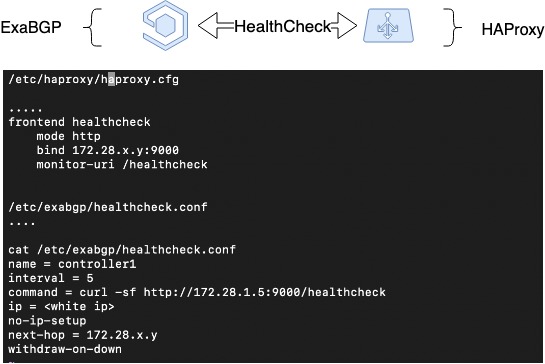
Vérification d'état de HAProxy
Paires HAProxy : synchronisation des sessions
La prochaine étape consistait à synchroniser les sessions. Lorsqu'on utilise des répartiteurs de charge distribués, il est difficile d'organiser la conservation des informations sur les sessions des clients. Mais HAProxy est l'un des rares répartiteurs capable de le faire grâce à la fonctionnalité Peers — la possibilité de transférer des tables de sessions entre différents processus HAProxy.
Il existe différentes méthodes de répartition : des méthodes simples, telles que , et des méthodes avancées, où la session du client est mémorisée, et il est dirigé à chaque fois vers le même serveur qu'auparavant. Nous souhaitions mettre en œuvre la seconde option.
Dans HAProxy, pour la conservation des sessions clients, on utilise des stick-tables. Elles sauvegardent l'adresse IP d'origine du client, l'adresse cible choisie (backend) et certaines informations auxiliaires. En général, les stick-tables sont utilisées pour enregistrer les paires source-IP + destination-IP, ce qui est particulièrement utile pour les applications qui ne peuvent pas transmettre le contexte de la session utilisateur lors du passage à un autre répartiteur, par exemple — en mode de répartition RoundRobin.
Si l'on apprend à la stick-table à se déplacer entre différents processus HAProxy (entre lesquels la répartition s'effectue), nos répartiteurs pourront travailler avec un seul pool de stick-tables. Cela permettra un passage fluide du réseau client en cas de défaillance de l'un des répartiteurs ; le travail sur les sessions des clients continuera sur les mêmes backends qui avaient été choisis précédemment.
Pour un bon fonctionnement, il est nécessaire de résoudre le problème de l'adresse IP source du répartiteur à partir duquel la session a été établie. Dans notre cas, il s'agit d'une adresse dynamique sur l'interface loopback.
Le bon fonctionnement des pairs n'est possible que dans certaines conditions. En d'autres termes, les délais d'attente TCP doivent être suffisamment longs ou le basculement doit être assez rapide pour éviter que la session TCP ne se rompe. Cela permet néanmoins un basculement transparent.
Nous avons un service dans l'IaaS basé sur la même technologie. Il s'agit de , qui s'appelle Octavia. Il est basé sur une infrastructure de deux processus HAProxy, avec une prise en charge initiale des pairs. Dans ce service, ils ont fait leurs preuves.
L'image illustre schématiquement le déplacement des tables de pairs entre trois instances HAProxy, avec une configuration proposée pour la mise en place :
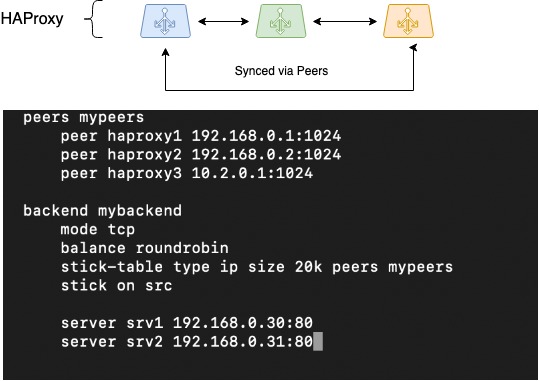
HAProxy Peers (synchronisation des sessions)
Si vous implémentez un schéma similaire, il faut le tester attentivement. Il n'est pas garanti que cela fonctionne de la même manière dans 100 % des cas. Cependant, vous ne perdrez pas les tables de stick lorsque vous devez vous souvenir de l'adresse IP source du client.
Limitation du nombre de requêtes simultanées d'un même client
Tous les services accessibles publiquement, y compris nos API, peuvent être sujets à des vagues de requêtes. Les raisons peuvent être variées, allant d'erreurs des utilisateurs à des attaques ciblées. Nous subissons périodiquement des attaques DDoS par adresses IP. Les clients se trompent souvent dans leurs scripts, ce qui nous cause de mini-DDoS.
Quoi qu'il en soit, il est nécessaire de prévoir une protection supplémentaire. Une solution évidente consiste à limiter le nombre de requêtes à l'API et à ne pas perdre de temps processeur à traiter des requêtes malveillantes.
Pour mettre en place de telles limitations, nous appliquons des taux limites, organisés sur la base d'HAProxy, en utilisant les mêmes tables de stick. Les limites sont configurées assez simplement et permettent de restreindre l'utilisateur par le nombre de requêtes à l'API. L'algorithme mémorise l'adresse IP source d'où proviennent les requêtes et limite le nombre de requêtes simultanées d'un même utilisateur. Bien sûr, nous avons calculé le profil moyen de charge sur l'API pour chaque service et avons établi une limite d'environ 10 fois supérieure à cette valeur. Nous continuons à surveiller attentivement la situation, en gardant un œil sur le pouls.
Quel est le rendu en pratique ? Nous avons des clients qui utilisent constamment nos API pour l'autoscaling. Ils créent environ deux à trois cents machines virtuelles le matin et les suppriment le soir. Pour OpenStack, créer une machine virtuelle avec des services PaaS nécessite au moins 1000 requêtes API, car l'interaction entre les services se fait également via API.
Ces transferts de tâches génèrent une charge assez importante. Nous avons évalué cette charge, collecté les pics quotidiens, les avons multipliés par dix, et cela est devenu notre taux limite. Nous restons vigilants. Nous voyons souvent des bots, des scanners qui essaient de vérifier s'il y a des scripts CGA à lancer, et nous les bloquons activement.
Comment mettre à jour la base de code sans que les utilisateurs le remarquent
Nous mettons en œuvre la résilience également au niveau des processus de déploiement du code. Des pannes peuvent survenir lors des déploiements, mais leur impact sur la disponibilité des services peut être minimisé.
Nous mettons constamment à jour nos services et devons garantir le processus de mise à jour de la base de code sans impact pour les utilisateurs. Nous avons pu résoudre cette tâche en utilisant les fonctionnalités de gestion de HAProxy et la mise en œuvre du Graceful Shutdown dans nos services.
Pour résoudre cette tâche, il était nécessaire d'assurer la gestion du répartiteur de charge et l'arrêt 'correct' des services :
- Dans le cas de HAProxy, la gestion se fait via un fichier stats, qui est essentiellement un socket défini dans la configuration de HAProxy. Les commandes peuvent y être transmises via stdio. Mais notre principal outil de contrôle des configurations est Ansible, donc il contient un module intégré pour gérer HAProxy. Que nous utilisons activement.
- La plupart de nos services API et Engine prennent en charge les technologies de graceful shutdown : lors de l'arrêt, ils attendent l'achèvement total de la tâche en cours, qu'il s'agisse d'une requête http ou d'une tâche administrative. Il en va de même pour le worker. Il connaît toutes les tâches qu'il exécute et se termine lorsqu'il a tout réussi.
Grâce à ces deux points, notre algorithme de déploiement sécurisé est le suivant.
- Le développeur assemble un nouveau paquet de code (pour nous, c'est un RPM), le teste dans l'environnement de développement, le teste dans l'environnement de pré-production, et le laisse dans le dépôt de pré-production.
- Le développeur établit la tâche de déploiement avec une description aussi détaillée que possible des « artefacts » : version du nouveau package, description des nouvelles fonctionnalités et d'autres détails sur le déploiement si nécessaire.
- L'administrateur système commence la mise à jour. Il lance le playbook Ansible, qui, à son tour, effectue les actions suivantes :
- Il prend le package du dépôt de staging et met à jour la version du package dans le dépôt de production.
- Il dresse la liste des backends du service en cours de mise à jour.
- Il désactive le premier service à mettre à jour dans HAProxy et attend la fin de ses processus. Grâce à un arrêt en douceur, nous sommes assurés que toutes les demandes en cours des clients seront traitées avec succès.
- Après l'arrêt complet de l'API, des worker, et l'arrêt de HAProxy, la mise à jour du code a lieu.
- Ansible démarre les services.
- Pour chaque service, il exécute des « hooks » spécifiques qui effectuent des tests unitaires sur un certain nombre de tests clés prédéfinis. Une vérification de base du nouveau code est réalisée.
- Si aucune erreur n'est détectée à l'étape précédente, le backend est activé.
- Nous passons au backend suivant.
- Après la mise à jour de tous les backends, des tests fonctionnels sont lancés. S'il en manque, le développeur examine toute nouvelle fonctionnalité qu'il a développée.
Le déploiement est maintenant terminé.
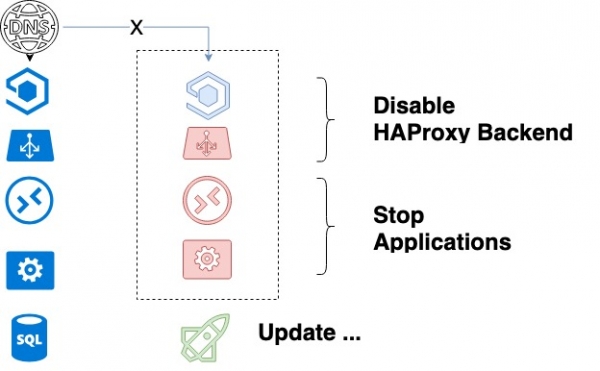
Le cycle de mise à jour du service
Ce schéma ne fonctionnerait pas s'il n'y avait pas une règle. Nous faisons fonctionner simultanément l'ancienne et la nouvelle version. Au préalable, au stade de développement du logiciel, il est prévu que même s'il y a des modifications dans la base de données du service, elles ne casseront pas le code précédent. En conséquence, il y a une mise à jour progressive de la base de code.
Conclusion
En partageant mes réflexions sur l'architecture web tolérante aux pannes, je souhaite souligner à nouveau ses points clés :
- tolérance aux pannes physiques ;
- tolérance aux pannes réseau (équilibreurs, BGP) ;
- tolérance aux pannes des logiciels utilisés et développés.
À tous, un uptime stable !
Source : habr.com
