

Image :
Pour les sites agrégateurs dans le domaine du commerce électronique, il est crucial de maintenir des informations à jour. Sinon, leur principal avantage disparaît : la possibilité de voir les données les plus pertinentes en un seul endroit.
Pour résoudre ce problème, il est nécessaire d'utiliser la technique du web scraping. Le principe consiste à créer un logiciel spécial – un crawler, qui parcourt les sites nécessaires de la liste, extrait les informations et les télécharge sur le site agrégateur.
Le problème est que souvent, les propriétaires des sites dont les données sont collectées par les agrégateurs ne souhaitent pas leur donner un accès aussi facile. On peut le comprendre : si les informations sur les prix dans une boutique en ligne apparaissent sur un site agrégateur et sont plus élevées que celles des concurrents également présentés, l'entreprise perdra des clients.
Méthodes de lutte contre le scraping
Ainsi, il arrive souvent que les propriétaires de ces sites s'opposent au scraping – c'est-à-dire au téléchargement de leurs données. Ils peuvent détecter les requêtes envoyées par les bots crawlers selon leur adresse IP. En général, ce logiciel utilise ce qu'on appelle des IP serveur, qui sont facilement identifiables et bloquables.
De plus, au lieu de bloquer les requêtes, une autre méthode est souvent utilisée : les bots identifiés se voient montrer des informations non pertinentes. Par exemple, les prix des produits peuvent être gonflés ou réduits, ou leurs descriptions modifiées.
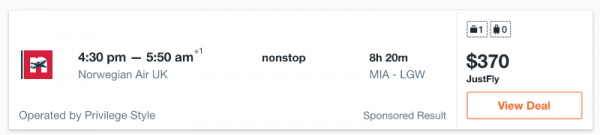
Un exemple souvent cité à cet égard est celui des prix des billets d'avion. En effet, il est assez fréquent que les compagnies aériennes et les agences de voyages affichent des résultats différents pour les mêmes vols en fonction de l'adresse IP. Un cas réel : la recherche d'un vol de Miami à Londres à la même date avec une adresse IP d'Europe de l'Est et d'Asie renvoie des résultats différents.
Pour l'adresse IP d'Europe de l'Est, le prix apparaît comme suit :
Et pour une adresse IP d'Asie, cela donne :
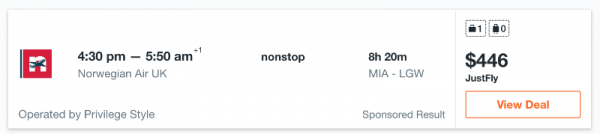
Comme on peut le voir, le prix pour le même vol diffère considérablement – la différence est de 76 $, ce qui est vraiment beaucoup. Pour un site agrégateur, il n'y a rien de pire que cela : s'il présente de fausses informations, les utilisateurs ne l'utiliseront pas. De plus, si sur l'agrégateur un produit affiche un prix et qu'en cliquant sur le site du vendeur il change, cela affecte également négativement la réputation du projet.
Solution : utilisation de proxies résidentiels
Éviter les problèmes lors du scraping de données pour l'agrégation peut être réalisé grâce à l'utilisation de proxies résidentiels. Les IP serveurs sont fournies par des hébergeurs. Il est assez simple de déterminer l'appartenance d'une adresse à un pool d'un fournisseur particulier - chaque IP a un numéro ASN qui contient cette information.
Il existe de nombreux services pour analyser les numéros ASN. Souvent, ils s'intègrent à des systèmes anti-bots qui bloquent l'accès aux crawlers ou falsifient les données renvoyées en réponse à leurs requêtes.
Les adresses IP résidentielle aident à contourner ces systèmes. Ces IP sont attribuées par les fournisseurs d'accès Internet aux propriétaires de logements, avec les notes appropriées dans toutes les bases de données associées. Il existe des services spéciaux de proxies résidentiels qui permettent d'utiliser des adresses résidentielles. – c'est justement ce service.
Les requêtes que les crawlers de sites agrégateurs envoient via des IP résidentiels semblent provenir d'utilisateurs ordinaires d'une région donnée. Et aucun blocage n'est appliqué aux visiteurs normaux – dans le cas des magasins en ligne, ce sont des clients potentiels.
En fin de compte, l'utilisation de proxies rotatifs d'Infatica permet aux sites agrégateurs d'obtenir des données précises garantie et d'éviter les blocages et les difficultés de parsing.
D'autres articles sur le sujet de l'utilisation de proxies résidentiels pour les affaires :
Source : habr.com
