

Les images au format JPEG sont omniprésentes dans notre vie numérique, mais derrière ce voile de familiarité se cachent des algorithmes qui éliminent les détails non perçus par l'œil humain. Cela permet d'obtenir une qualité visuelle exceptionnelle tout en minimisant la taille des fichiers - mais comment cela fonctionne-t-il exactement ? Regardons ce que nos yeux ne voient pas !
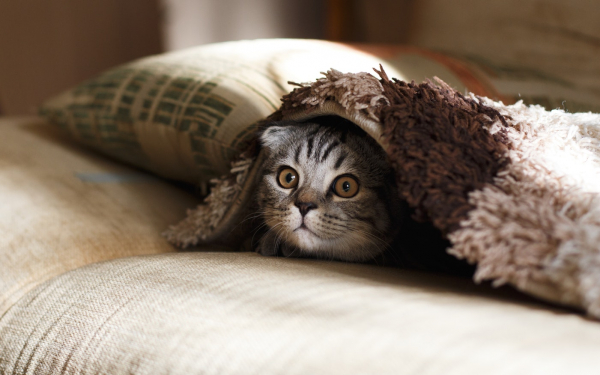
Il est facile de tenir pour acquis la possibilité d'envoyer une photo à un ami sans se soucier de l'appareil qu'il utilise, de son navigateur ou de son système d'exploitation - pourtant, cela n'a pas toujours été le cas. Au début des années 1980, les ordinateurs pouvaient stocker et afficher des images numériques, mais il existait de nombreuses idées concurrentes sur la meilleure façon de le faire. On ne pouvait pas simplement envoyer une image d'un ordinateur à un autre en espérant que tout fonctionne.
Pour résoudre ce problème, en 1986, un comité d'experts du monde entier a été formé sous le nom de «» (Joint Photographic Experts Group, JPEG), établi dans le cadre d'un partenariat entre l'Organisation internationale de normalisation (ISO) et la Commission électrotechnique internationale (IEC) - deux organisations internationales de normalisation dont le siège est à Genève (Suisse).
Un groupe de personnes appelé JPEG a créé la norme de compression des images numériques JPEG en 1992. Quiconque a utilisé Internet a probablement rencontré des images au format JPEG. C'est la méthode la plus répandue pour coder, envoyer et stocker des images. Des pages Web aux courriels en passant par les réseaux sociaux, le JPEG est utilisé des milliards de fois par jour – pratiquement chaque fois que nous regardons ou envoyons une image en ligne. Sans JPEG, le web serait moins coloré, plus lent et, probablement, il y aurait moins de photos de chats !
Cet article porte sur la manière de décoder une image JPEG. Autrement dit, il explique ce qui est nécessaire pour transformer des données compressées, stockées sur un ordinateur, en une image affichée à l'écran. Il est important non seulement pour comprendre la technologie que nous utilisons quotidiennement, mais aussi parce qu'en révélant les niveaux de compression, nous apprenons davantage sur la perception et la vision, ainsi que sur les détails auxquels nos yeux sont particulièrement sensibles.
De plus, jouer avec les images de cette façon est très intéressant.
Un regard à l'intérieur du JPEG
Sur un ordinateur, tout est stocké sous forme de séquences de chiffres binaires. Généralement, ces bits, zéros et uns, sont regroupés par huit pour former des octets. Lorsque vous ouvrez une image JPEG sur votre ordinateur, quelque chose (un navigateur, un système d'exploitation, ou autre) doit décoder les octets, restaurant l'image d'origine sous la forme d'une liste de couleurs pouvant être affichées.
Si vous téléchargez cette adorable et que vous l'ouvrez dans un éditeur de texte, vous verrez une multitude de symboles incohérents.
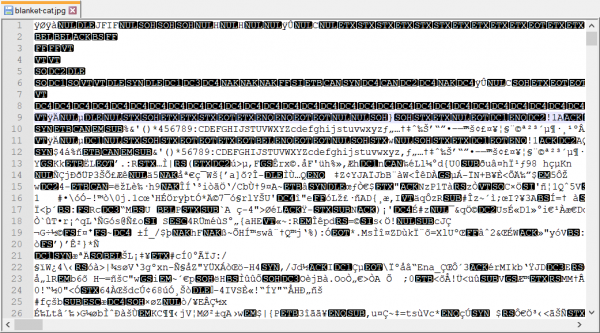
Ici, j'utilise Notepad++ pour examiner le contenu du fichier, car les éditeurs de texte ordinaires, comme Notepad de Windows, endommageront le fichier binaire après enregistrement, et il ne respectera plus le format JPEG.
En ouvrant une image dans un éditeur de texte, vous embrouillez l'ordinateur, tout comme vous embrouillez votre cerveau en frottant vos yeux et en commençant à voir des taches colorées !
Ces taches que vous voyez sont connues sous le nom de , et ne sont pas le résultat d'un stimulus lumineux ou d'hallucinations générées par l'esprit. Elles se produisent parce que votre cerveau suppose que tout signal électrique dans les nerfs oculaires transmet des informations sur la lumière. Le cerveau doit faire de telles hypothèses, car il est impossible de savoir si le signal est un son, une vision ou autre chose. Tous les nerfs du corps transmettent exactement les mêmes impulsions électriques. En appuyant sur vos yeux, vous envoyez des signaux qui ne sont pas visuels, mais qui activent les récepteurs des yeux, que votre cerveau interprète – en l'occurrence, incorrectement – comme quelque chose de visuel. Vous êtes littéralement capable de voir la pression !
Il est intéressant de penser à quel point les ordinateurs ressemblent au cerveau, mais c'est aussi une analogie utile qui illustre à quel point la signification des données – qu'elles soient transmises à travers le corps par les nerfs ou stockées sur un ordinateur – dépend de leur interprétation. Toutes les données binaires sont constituées de zéros et de uns, des composants de base capables de transmettre des informations de tout type. Votre ordinateur devine souvent comment les interpréter à l'aide d'indices, comme les extensions de fichiers. Et maintenant, nous lui demandons de les interpréter comme du texte, car c'est ce que le traitement de texte attend.
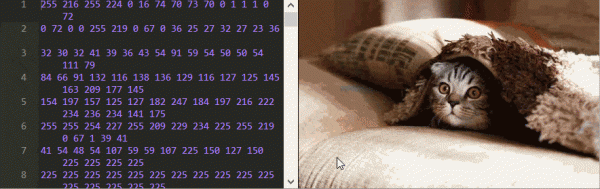
Pour comprendre comment décoder un JPEG, nous devons voir les signaux bruts – les données binaires. Cela peut se faire à l'aide d'un éditeur hexadécimal, ou directement sur ! Il y a une image à côté de laquelle tous ses octets (sauf l'en-tête) sont présentés sous forme décimale dans le champ de texte. Vous pouvez les modifier, et le script les recode et génère une nouvelle image à la volée.
On peut apprendre beaucoup simplement en jouant avec cet éditeur. Par exemple, pouvez-vous dire dans quel ordre les pixels sont stockés ?
Dans cet exemple, ce qui est étrange, c'est que la modification de certains nombres n'affecte pas l'image, mais par exemple, si vous remplacez le nombre 17 par 0 dans la première ligne, l'image sera complètement ruinée !
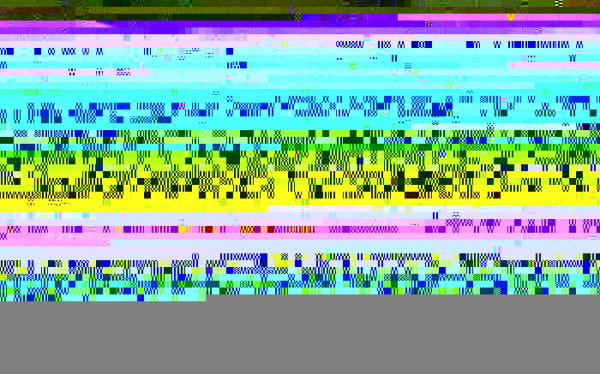
D'autres modifications, comme changer le 7 de la ligne 1988 en 254, modifient la couleur, mais seulement des pixels suivants.
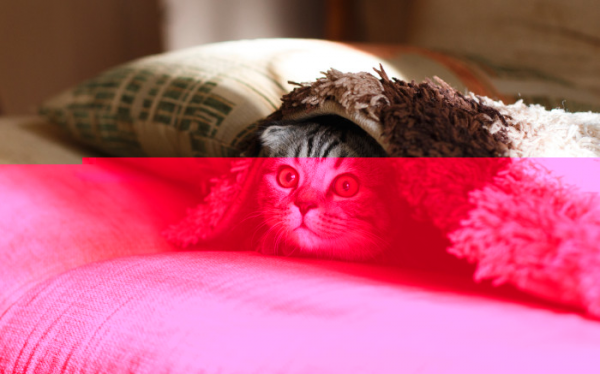
Peut-être le plus étrange est que certains nombres modifient non seulement la couleur, mais aussi la forme de l'image. Changez 70 à la ligne 12 en 2 et regardez la rangée supérieure de l'image pour voir ce que je veux dire.
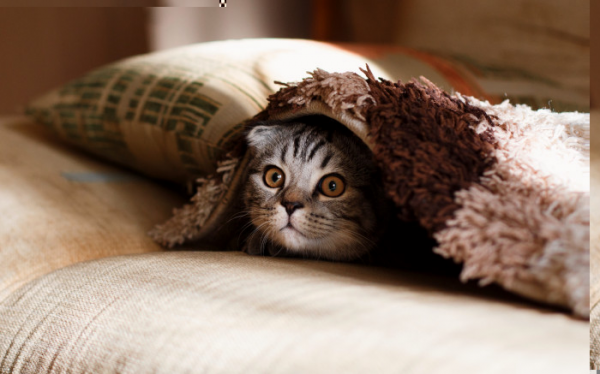
Et peu importe quelle image JPEG vous utilisez, vous trouverez toujours ces mystérieuses séquences de damiers en éditant les octets.
En jouant avec l'éditeur, il est difficile de comprendre comment une image est recréée à partir de ces octets, car la compression JPEG consiste en trois technologies différentes appliquées successivement par niveaux. Nous étudierons chacune d'elles séparément pour révéler ce comportement mystérieux que nous observons.
Trois niveaux de compression JPEG :
- .
- .
- , et
Pour vous donner une idée de l'ampleur de la compression, notez que l'image ci-dessus représente 79 819 nombres, soit environ 79 Ko. Si nous l'avions stockée sans compression, il aurait fallu trois nombres pour chaque pixel – pour la composante rouge, verte et bleue. Cela aurait donné 917 700 nombres, ou environ 917 Ko. Grâce à la compression JPEG, le fichier final a été réduit de plus de 10 fois !
En réalité, cette image peut être compressée beaucoup plus. En dessous, deux images côte à côte – la photo à droite a été compressée à 16 Ko, soit 57 fois moins que la version non compressée !
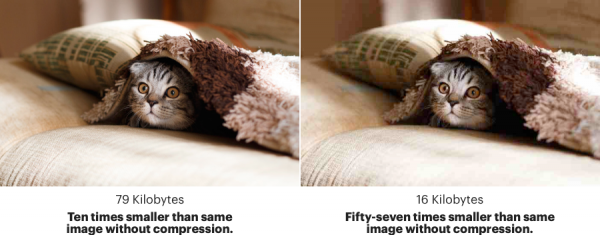
Si vous regardez de plus près, vous verrez que ces images ne sont pas identiques. Les deux sont des images compressées en JPEG, mais celle de droite est beaucoup plus légère. Elle a aussi un aspect légèrement moins bon (regardez les carrés de couleur de fond). C'est pourquoi on appelle aussi le JPEG compression avec perte ; au cours du processus de compression, l'image change et perd certains détails.
1. Sous-échantillonnage de la couleur
Voici une image avec seulement le premier niveau de compression.
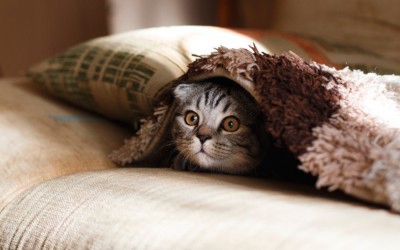
(Version interactive – dans l' de l'article). La suppression d'un seul nombre détruit toutes les couleurs. Cependant, si six nombres sont supprimés, cela n'a pratiquement aucun impact sur l'image.
Maintenant, les nombres sont un peu plus simples à déchiffrer. C'est presque une liste simple de couleurs, où chaque octet modifie exactement un pixel, mais elle est déjà deux fois plus petite que l'image non compressée (qui aurait occupé environ 300 Ko à cette taille réduite). Devinez pourquoi ?
On peut voir que ces nombres ne représentent pas les composants standard rouge, vert et bleu, car si l'on remplace tous les nombres par des zéros, nous obtenirons une image verte (et non blanche).

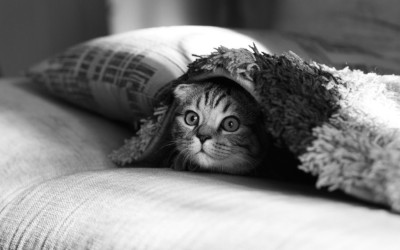
C'est parce que ces octets représentent Y (luminosité),
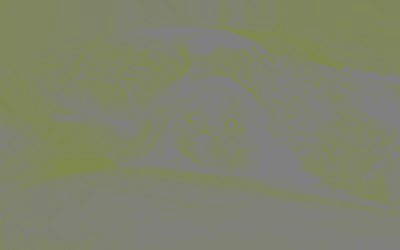
Cb (bleu relatif),
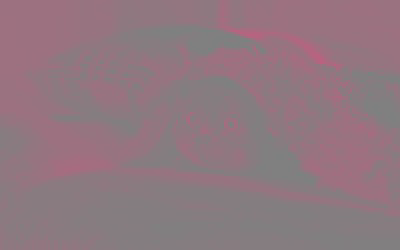
et Cr (rouge relatif) de l'image.
Pourquoi ne pas utiliser RGB ? En effet, c'est comme cela que la plupart des écrans modernes fonctionnent. Votre moniteur peut afficher n'importe quelle couleur, y compris rouge, vert et bleu avec différentes intensités pour chaque pixel. Le blanc est obtenu par l'activation de toutes les trois à pleine luminosité, et le noir par leur désactivation.
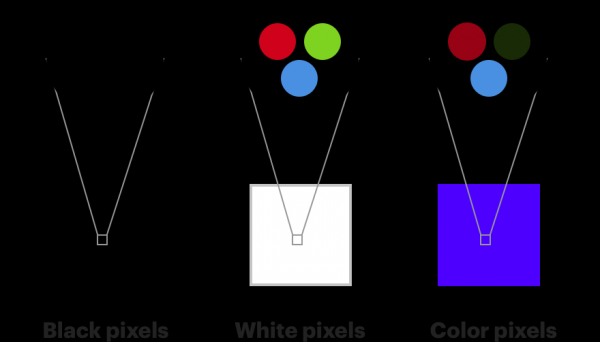
C'est aussi très similaire au fonctionnement de l'œil humain. Les récepteurs de couleur dans nos yeux s'appellent des «Les cônes se divisent en trois types, chacun étant plus sensible à la couleur rouge, verte ou bleue. [Les cônes de type S sont sensibles dans la partie violet-bleu (S de l'anglais Short — spectre à courte longueur d'onde), les cônes de type M dans la partie vert-jaune (M de l'anglais Medium — spectre à longueur d'onde moyenne), et les cônes de type L dans la partie jaune-rouge (L de l'anglais Long — spectre à longue longueur d'onde). La présence de ces trois types de cônes (et de bâtonnets, sensibles dans la partie vert émeraude du spectre) donne à l'homme la vision des couleurs. / note du traducteur] , un autre type de photorécepteurs dans nos yeux, peuvent détecter des changements de luminosité, mais sont beaucoup plus sensibles à la couleur. Il y a environ 120 millions de bâtonnets et seulement 6 millions de cônes dans nos yeux.
C'est pourquoi nos yeux détectent beaucoup mieux les changements de luminosité que les changements de couleur. Si on dissocie la couleur de la luminosité, on peut enlever un peu de couleur, et personne ne remarquera. La sous-discrétisation des couleurs est un processus qui représente les composants colorés d'une image à une résolution inférieure par rapport aux composants de luminosité. Dans l'exemple ci-dessus, chaque pixel a exactement un composant Y, alors que chaque groupe de quatre pixels a exactement un composant Cb et un Cr. Donc, l'image contient quatre fois moins d'informations colorées que l'original.
L'espace colorimétrique YCbCr n'est pas seulement utilisé dans le JPEG. Il a été initialement conçu en 1938 pour les transmissions télévisées. Étant donné que tout le monde n'avait pas de télévision couleur, la séparation de la couleur et de la luminosité a permis à tous de recevoir le même signal, tandis que les téléviseurs en noir et blanc utilisaient seulement le composant de luminosité.
C'est pourquoi la suppression d'un seul chiffre dans l'éditeur détruit complètement toutes les couleurs. Les composants sont stockés sous la forme Y Y Y Y Cb Cr (en réalité, pas nécessairement dans cet ordre – l'ordre de stockage est défini dans l'en-tête du fichier). La suppression du premier chiffre entraînera la confusion du premier Cb avec un Y, et le Cr avec un Cb, ce qui produira un effet domino, modifiant toutes les couleurs de l'image.
La spécification JPEG ne vous oblige pas à utiliser YCbCr. Mais dans la plupart des fichiers, il est utilisé car il fournit des images de meilleure qualité après sous-échantillonnage par rapport à RGB. Mais vous n'êtes pas obligé de me croire sur parole. Regardez vous-même dans le tableau ci-dessous comment le sous-échantillonnage de chaque composant apparaît à la fois en RGB et en YCbCr.
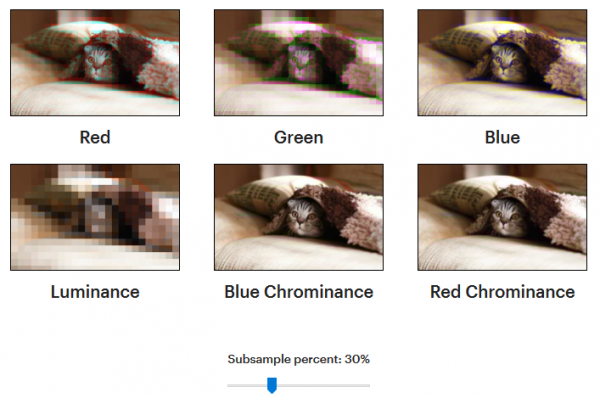
(Version interactive – dans l' articles).
L'élimination du bleu n'est pas aussi visible que celle du rouge ou du vert. Tout cela parce que sur les six millions de cônes dans vos yeux, environ 64 % sont sensibles au rouge, 32 % au vert et 2 % au bleu.
Le sous-échantillonnage du composant Y (en bas à gauche) est le plus visible. Même un léger changement se remarque.
La conversion d'une image de RGB à YCbCr ne réduit pas la taille du fichier, mais facilite la recherche de détails moins visibles qui peuvent être supprimés. La compression avec perte se produit à la deuxième étape. Elle repose sur l'idée de présenter les données de manière plus compressible.
2. Transformation en cosinus discrète et sous-échantillonnage
Ce niveau de compression définit principalement l'essence de JPEG. Après la conversion des couleurs en YCbCr, les composants sont compressés séparément, donc ensuite nous pouvons nous concentrer uniquement sur le composant Y. Voici à quoi ressemblent les octets du composant Y après l'application de ce niveau.
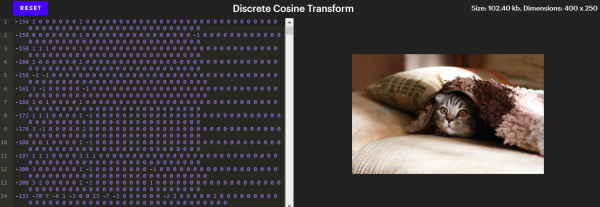
(Version interactive – dans l' articles). Dans la version interactive, un clic sur un pixel fait défiler l'éditeur à la ligne qui le représente. Essayez de supprimer des chiffres à la fin ou d'ajouter quelques zéros à un certain nombre.
À première vue, cela ressemble à une compression très mauvaise. Dans une image de 100 000 pixels, pour désigner leur luminosité (composant Y), il faut 102 400 nombres — c'est pire que si rien n'était compressé !
Cependant, notez que la plupart de ces nombres sont égaux à zéro. De plus, tous ces zéros à la fin des lignes peuvent être supprimés sans changer l'image. Il reste environ 26 000 nombres, ce qui est déjà presque quatre fois moins !
À ce niveau se trouve le secret des motifs en damier. Contrairement à d'autres effets que nous avons observés, l'apparition de ces motifs n'est pas un glitch. Ce sont les éléments constitutifs de l'image entière. Chaque ligne de l'éditeur contient exactement 64 nombres, les coefficients de la transformation en cosinus discrète (DCT), correspondant aux intensités de 64 motifs uniques.
Ces motifs sont formés sur la base du graphique du cosinus. Voici à quoi ressemblent certains d'entre eux :
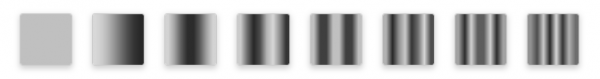
8 sur 64 coefficients
Ci-dessous se trouve une image montrant les 64 motifs.
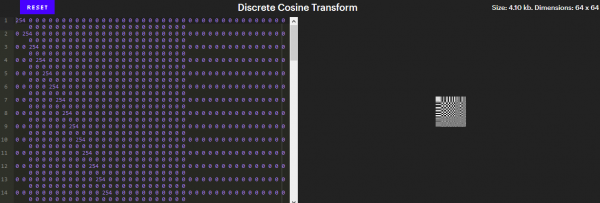
(Version interactive – dans l' articles).
Ces motifs sont particulièrement importants car ils forment la base des images de taille 8x8. Si vous n'êtes pas familier avec l'algèbre linéaire, cela signifie que n'importe quelle image de taille 8x8 peut être obtenue à partir de ces 64 motifs. La DCT est le processus de découpage des images en blocs de 8x8 et de transformation de chaque bloc en combinaison de ces 64 coefficients.
Le fait que n'importe quelle image puisse être composée de 64 motifs spécifiques semble magique. Cependant, c'est comme dire que n'importe quel endroit sur Terre peut être décrit par deux nombres – la latitude et la longitude [en précisant les hémisphères / note du traducteur]. Nous considérons souvent la surface de la Terre comme bidimensionnelle, donc nous avons besoin de seulement deux nombres. Une image 8x8 a 64 dimensions, donc nous avons besoin de 64 nombres.
Il n'est pas encore clair comment cela nous aide en termes de compression. Si nous avons besoin de 64 nombres pour représenter une image de 8x8, pourquoi cette méthode serait-elle préférable à simplement stocker 64 composants de luminosité ? Nous le faisons pour la même raison pour laquelle nous avons transformé trois nombres RGB en trois nombres YCbCr : cela nous permet d'éliminer des détails invisibles.
Il est difficile de voir quels détails sont éliminés à ce stade, car le JPEG applique la DCT aux blocs de 8x8. Cependant, rien ne nous empêche de l'appliquer à une image entière. Voici à quoi ressemble la DCT sur le composant Y appliqué à une image entière :
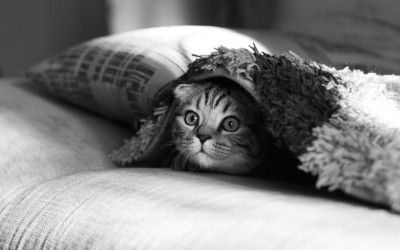
Il est possible de supprimer plus de 60 000 nombres presque sans changements visibles sur la photo.
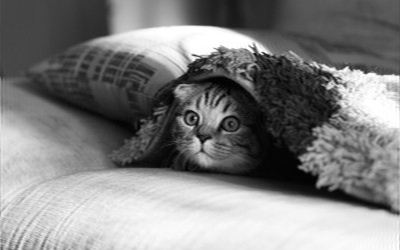
Cependant, notez que si nous annulons les cinq premiers nombres, la différence sera évidente.
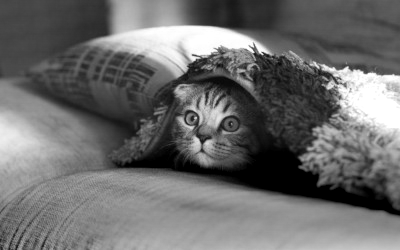
Les nombres au début représentent des changements de basse fréquence dans l'image, et nos yeux les détectent le mieux. Les nombres plus loin vers la fin représentent des changements de haute fréquence, qui sont plus difficiles à percevoir. Pour « voir ce que l'œil ne voit pas », nous pouvons isoler ces détails de haute fréquence en supprimant les 5000 premiers nombres.
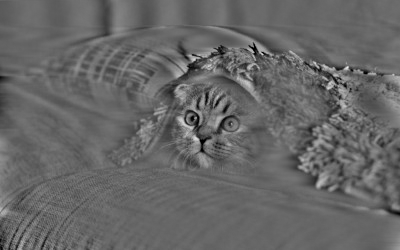
Nous voyons toutes les zones de l'image où il y a le plus de changement de pixel à pixel. Les yeux du chat, ses moustaches, la couverture en peluche et les ombres dans le coin inférieur gauche se distinguent. Nous pouvons aller encore plus loin en annulant les 10 000 premiers nombres :
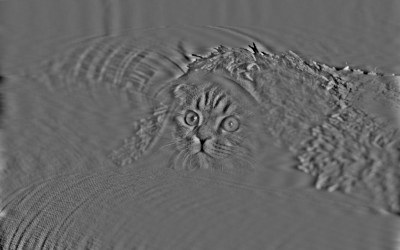
20 000:
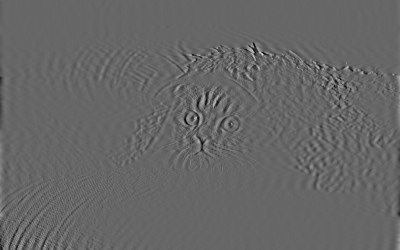
40 000:
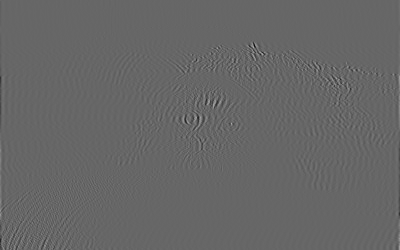
60 000:
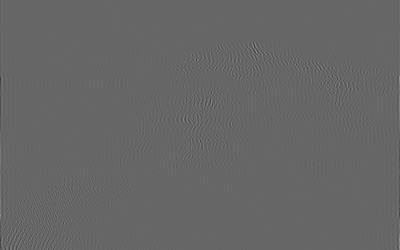
Ces détails haute fréquence sont supprimés lors de la compression JPEG. La transformation des couleurs en coefficients DCT est sans perte. Les pertes surviennent lors de l'étape de discrétisation, où les valeurs de haute fréquence ou proches de zéro sont éliminées. Lorsque vous réduisez la qualité de l'enregistrement JPEG, le programme augmente le seuil du nombre de valeurs supprimées, ce qui réduit la taille du fichier, mais rend l'image plus pixellisée. C'est pourquoi l'image de la première section, qui était 57 fois plus petite, avait cet aspect. Chaque bloc de 8x8 était représenté par un nombre beaucoup plus faible de coefficients DCT par rapport à une version de meilleure qualité.
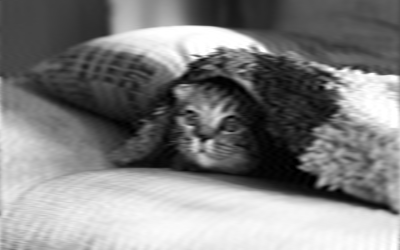
On peut obtenir un effet vraiment cool, comme le streaming progressif des images. On peut afficher une image floue qui devient de plus en plus détaillée à mesure que de plus en plus de coefficients sont téléchargés.
Voici, juste par curiosité, ce que l'on obtient en utilisant seulement 24 000 chiffres :
Ou seulement 5000 :
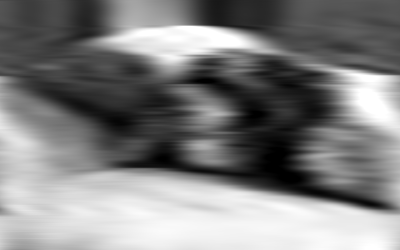
Très flou, mais presque reconnaissable !
3. Codage des longueurs de séries, delta et Huffman
Jusqu'à présent, toutes les étapes de compression ont été avec perte. La dernière étape, en revanche, se fait sans perte. Elle ne supprime pas d'information, mais réduit considérablement la taille du fichier.
Comment peut-on compresser quoi que ce soit sans jeter d'information ? Imaginez comment nous pourrions décrire un simple rectangle noir de 700 x 437.
Le JPEG utilise 5000 chiffres pour cela, mais on peut obtenir un bien meilleur résultat. Pouvez-vous imaginer un schéma de codage qui décrirait une telle image avec le moins de bytes possible ?
Le schéma minimal que j'ai pu imaginer utilise quatre : trois pour désigner la couleur, et le quatrième pour indiquer combien de pixels ont cette couleur. L'idée de représenter des valeurs répétées de cette manière compressée est appelée codage des longueurs de séries. Elle est sans perte, car nous pouvons restaurer les données codées dans leur forme originale.
La taille d'un fichier JPEG avec un rectangle noir est bien supérieure à 4 octets – rappelez-vous que le niveau DCT applique la compression sur des blocs de 8x8 pixels. Par conséquent, nous avons besoin d'au moins un coefficient DCT pour chaque 64 pixels. Nous en avons besoin d'un, car au lieu de stocker un coefficient DCT suivi de 63 zéros, le codage de longueur de série nous permet de stocker un seul nombre et d'indiquer que « tous les autres sont des zéros ».
Le codage delta est une technique où chaque octet contient la différence par rapport à une certaine valeur, plutôt qu'une magnitude absolue. Par conséquent, modifier certains octets change la couleur de tous les autres pixels. Par exemple, au lieu de stocker
12 13 14 14 14 13 13 14
Nous pourrions commencer par 12, puis simplement indiquer combien ajouter ou soustraire pour obtenir le prochain nombre. Et cette séquence en codage delta prend la forme :
12 1 1 0 0 -1 0 1
Les données transformées ne deviennent pas plus petites que les originales, mais il est plus facile de les compresser. L'utilisation du codage delta avant le codage de longueur de série peut grandement aider, tout en restant sans perte.
Le codage delta est l'une des rares techniques appliquées en dehors des blocs de 8x8. Sur 64 coefficients DCT, un est simplement une fonction d'onde constante (couleur uniforme). Il représente la luminosité moyenne de chaque bloc pour les composants de luminosité, ou le bleu moyen pour les composants Cb, et ainsi de suite. La première valeur de chaque bloc DCT est appelée valeur DC, et chaque valeur DC est codée en delta par rapport aux précédentes. Ainsi, modifier la luminosité du premier bloc influencera tous les blocs.
Il reste une dernière énigme : comment un changement d'un seul nombre peut-il complètement dégrader l'image ? Jusqu'à présent, ce type de propriété n'existait pas dans les niveaux de compression. La réponse réside dans l'en-tête JPEG. Les 500 premiers octets contiennent des métadonnées sur l'image – largeur, hauteur, etc., et tant que nous n'avons pas travaillé avec elles.
Sans en-tête, il est pratiquement impossible (ou très difficile) de décoder un JPEG. Cela ressemblerait à ce que j'essaie de vous décrire une peinture, et je commence à inventer des mots pour transmettre mon impression. La description serait probablement très concise, car je peux inventer des mots avec exactement la signification que je veux transmettre, mais pour tous les autres, ils n'auront pas de sens.
Cela peut sembler idiot, mais c'est exactement comme ça que cela se passe. Chaque image JPEG est compressée avec des codes spécifiques à celle-ci. Le dictionnaire de codes est stocké dans l'en-tête. Cette technique s'appelle « code de Huffman », et le dictionnaire est la table de Huffman. Dans l'en-tête, la table est marquée par deux octets – 255, puis 196. Chaque composant couleur peut avoir sa propre table.
Les modifications des tables auront un impact radical sur n'importe quelle image. Un bon exemple est de changer le 1 de la ligne 15 en 12.
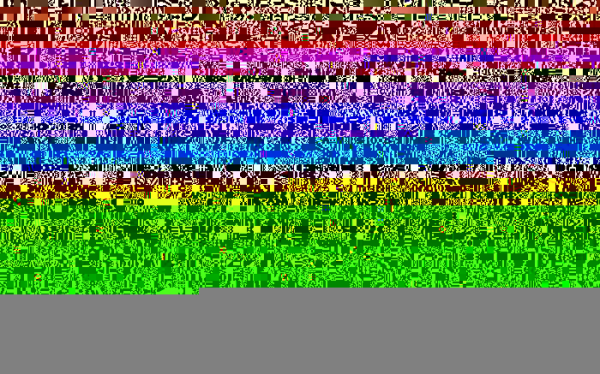
Cela se produit parce que les tables indiquent comment lire les bits individuels. Jusqu'à présent, nous avons travaillé uniquement avec des nombres binaires en notation décimale. Mais cela nous cache le fait que si vous voulez stocker le nombre 1 dans un octet, il apparaîtra comme 00000001, car chaque octet doit avoir exactement huit bits, même si seul un est nécessaire.
Potentiellement, c'est un énorme gaspillage d'espace si vous avez beaucoup de petits nombres. Le code de Huffman est une technique qui nous permet d'assouplir cette exigence selon laquelle chaque nombre doit occuper huit bits. Cela signifie que si vous voyez deux octets :
234 115
Alors, en fonction de la table de Huffman, cela peut représenter trois nombres. Pour les extraire, vous devez d'abord les diviser en bits individuels :
11101010 01110011
Ensuite, vous consultez la table pour comprendre comment les regrouper. Par exemple, cela peut être les six premiers bits, (111010), ou 58 en notation décimale, suivis de cinq bits (10011), ou 19, et enfin les quatre derniers bits (0011), ou 3.
C'est pourquoi il est très difficile de comprendre les octets à ce stade de la compression. Les octets ne montrent pas ce qu'ils semblent. Je ne vais pas approfondir les détails du travail avec la table dans cet article, mais à ce sujet sur Internet .
Un des trucs intéressants que vous pouvez faire en sachant cela est de séparer l'en-tête du JPEG et de le stocker séparément. En fait, cela signifie que seul vous pourrez lire le fichier. Facebook le fait pour réduire encore plus les fichiers.
Ce que vous pouvez également faire est de modifier légèrement la table de Huffman. Pour les autres, cela apparaîtra comme une image corrompue. Et vous serez le seul à connaître la version magique pour la réparer.
Pour résumer : de quoi avez-vous besoin pour décoder un JPEG ? Il vous faut :
- Extraire la table (les tables) de Huffman de l'en-tête et décoder les bits.
- Extraire les coefficients de transformation en cosinus discret pour chaque composant de couleur et de luminosité pour chaque bloc 8x8, en effectuant les transformations inverses du codage de longueurs de séries et des deltas.
- Combiner les cosinus basés sur les coefficients pour obtenir les valeurs des pixels pour chaque bloc 8x8.
- Échelonner les composants de couleur s'il y a eu une sous-échantillonnage (cette information est dans l'en-tête).
- Convertir les valeurs YCbCr obtenues pour chaque pixel en RGB.
- Afficher l'image à l'écran !
Un travail sérieux pour simplement voir une photo de chat ! Cependant, ce que j'apprécie dans cela - c'est que l'on voit à quel point la technologie JPEG est centrée sur l'homme. Elle est basée sur les caractéristiques de notre perception, permettant d'atteindre une compression bien meilleure que les technologies ordinaires. Et maintenant, en comprenant comment fonctionne JPEG, on peut imaginer comment ces technologies peuvent être transférées à d'autres domaines. Par exemple, le codage des deltas dans la vidéo peut entraîner une réduction significative de la taille du fichier, car il y a souvent de grandes zones qui ne changent pas d'une image à l'autre (par exemple, l'arrière-plan).
, est ouvert et contient des instructions pour remplacer les images par les vôtres.
Source : habr.com
