

La haute performance est l'une des exigences clés lors du travail avec de grandes données. Chez Sber, nous nous occupons de la gestion des charges de données et nous traitons presque toutes les transactions dans notre Cloud de Données basé sur Hadoop, ce qui signifie que nous faisons face à des flux d'informations vraiment importants. Naturellement, nous cherchons constamment des moyens d'améliorer la performance, et nous souhaitons maintenant expliquer comment nous avons réussi à patcher le RegionServer HBase et le client HDFS, ce qui a considérablement augmenté la vitesse des opérations de lecture.
Cependant, avant d'entrer dans le vif du sujet, il convient de discuter des limitations qui ne peuvent pas être contournées si l'on utilise des HDD.
Pourquoi les HDD et les lectures aléatoires rapides sont incompatibles
Comme on le sait, HBase, ainsi que de nombreux autres SGBD, stockent les données par blocs, généralement dans une taille d'environ quelques dizaines de kilobytes. Par défaut, cela représente environ 64 Ko. Imaginons maintenant que nous devons récupérer seulement 100 octets et que nous demandons à HBase de nous fournir ces données par clé. Étant donné que la taille des blocs dans les HFiles est de 64 Ko, nous demanderons en réalité 640 fois plus (rappelons-le !) que nécessaire.
Ensuite, comme la demande passera par HDFS et son mécanisme de mise en cache des métadonnées ShortCircuitCache (qui permet un accès direct aux fichiers), cela entraîne une lecture de 1 Mo depuis le disque. Cela peut néanmoins être ajusté par le paramètre dfs.client.read.shortcircuit.buffer.size et dans de nombreux cas, il est judicieux de réduire cette valeur, par exemple à 126 Ko.
Supposons que nous fassions cela, mais également, lorsque nous commencerons à lire des données via l'API Java, avec des fonctions comme FileChannel.read et que nous demandons au système d'exploitation de lire une certaine quantité de données, il lira par précaution deux fois plus, soit 256 Ko dans notre cas. Cela se produit car il n'y a pas de moyen simple en Java d'exercer le drapeau FADV_RANDOM, qui préviendrait ce comportement.
En fin de compte, pour obtenir nos 100 octets, la lecture en arrière-plan consomme 2600 fois plus. Il semblerait donc évident de réduire la taille du bloc à 1 Ko, d’exercer ce drapeau et d'acquérir un grand temps d'accélération. Mais le problème est que réduire la taille du bloc de moitié diminue également le nombre d'octets lus par unité de temps de la même manière.
On peut obtenir un certain avantage en définissant le drapeau FADV_RANDOM, mais seulement dans des conditions de forte multithreading et avec une taille de bloc d'au moins 128 Ko, ce qui représente au maximum quelques dizaines de pour cent.
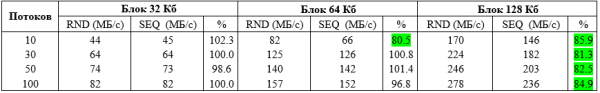
Les tests ont été réalisés sur 100 fichiers, chacun d'une taille de 1 Go et répartis sur 10 disques HDD.
Voyons ce que nous pouvons raisonnablement attendre à cette vitesse :
Supposons que nous lisons depuis 10 disques à une vitesse de 280 Mo/s, soit 3 millions de fois 100 octets. Mais comme nous le savons, les données dont nous avons besoin apparaissent 2600 fois moins souvent que ce qui a été lu. Ainsi, nous divisons 3 millions par 2600, ce qui donne 1100 enregistrements par seconde.
Décevant, n'est-ce pas ? C'est la nature de l'accès aléatoire aux données sur HDD — peu importe la taille du bloc. C'est la limite physique de l'accès aléatoire, et aucune base de données ne pourra en tirer plus dans de telles conditions.
Comment les bases atteignent-elles alors des vitesses beaucoup plus élevées ? Pour répondre à cette question, examinons ce qui se passe sur l'image suivante :
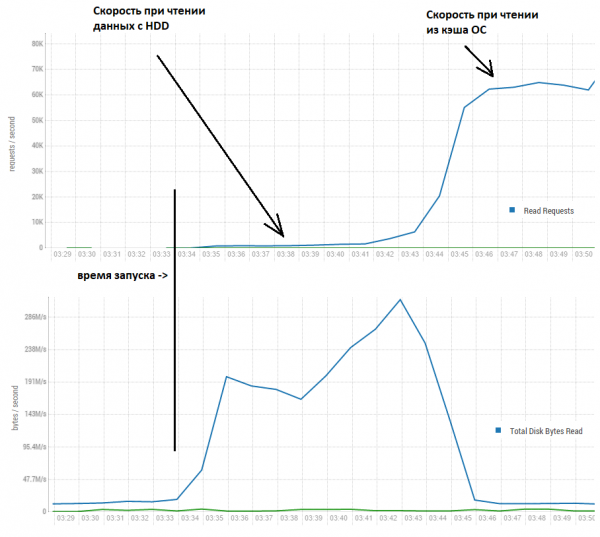
Ici, nous voyons que pendant les premières minutes, la vitesse est effectivement d'environ mille enregistrements par seconde. Cependant, par la suite, en raison du fait que beaucoup plus de données sont lues que ce qui a été demandé, ces données se retrouvent dans le buff/cache du système d'exploitation (Linux) et la vitesse augmente jusqu'à un respectable 60 000 par seconde.
Ainsi, par la suite, nous allons nous concentrer sur l'accélération de l'accès uniquement aux données qui sont dans le cache de l'OS ou situées dans des stockages ayant une vitesse d'accès comparable, tels que les SSD/NVMe.
Dans notre cas, nous réaliserons des tests sur une configuration de 4 serveurs, chacun étant équipé comme suit :
CPU : Xeon E5-2680 v4 @ 2.40GHz 64 threads.
Mémoire : 730 Go.
version de java : 1.8.0_111
Et ici, en fait, le point clé est le volume de données dans les tables qui doivent être lues. En effet, si l'on lit les données d'une table qui peut être entièrement contenue dans le cache HBase, on n'atteindra même pas la lecture du buff/cache du système d'exploitation. Cela est dû au fait qu'HBase alloue par défaut 40 % de la mémoire pour une structure appelée BlockCache. En fait, c'est un ConcurrentHashMap, où la clé est le nom du fichier + l'offset du bloc, et la valeur est les données à ce décalage.
Ainsi, lorsque la lecture se fait uniquement à partir de cette structure, nous , d'environ un million de requêtes par seconde. Mais imaginons que nous ne pouvons pas allouer des centaines de gigaoctets de mémoire uniquement pour les besoins de la base de données, car sur ces serveurs, beaucoup d'autres applications utiles fonctionnent.
Par exemple, dans notre cas, le volume de BlockCache sur un RS est d'environ 12 Go. Nous avons déployé deux RS sur une seule nœud, c'est-à-dire que 96 Go sont alloués à BlockCache sur tous les nœuds. Et il y a beaucoup plus de données, imaginons qu'il s'agit de 4 tables, avec 130 régions, contenant des fichiers de 800 Mo, compressés avec FAST_DIFF, soit un total de 410 Go (ceci étant des données brutes, c'est-à-dire sans prendre en compte le facteur de réplique).
Ainsi, BlockCache ne représente qu'environ 23 % du volume total de données, et cela est beaucoup plus proche des conditions réelles de ce que l'on appelle BigData. Et c'est là que les choses deviennent intéressantes — il est évident que moins il y a de hits dans le cache, plus la performance en souffre. En cas de cache miss, il faut effectuer un tas de travaux — c'est-à-dire descendre jusqu'à l'appel de fonctions système. Cependant, cela est inévitable et examinons donc un tout autre aspect — que se passe-t-il avec les données à l'intérieur du cache ?
Simplifions la situation et supposons que nous avons un cache qui ne peut contenir qu'un seul objet. Voici un exemple de ce qui se produira lors de la tentative de travail avec un volume de données trois fois supérieur à celui du cache, nous aurons à :
1. Placer le bloc 1 dans le cache
2. Supprimer le bloc 1 du cache
3. Placer le bloc 2 dans le cache
4. Supprimer le bloc 2 du cache
5. Placer le bloc 3 dans le cache
Cinq actions effectuées ! Cependant, cette situation ne peut en aucun cas être qualifiée de normale, en réalité, nous forçons HBase à effectuer un tas de travaux complètement inutiles. Il lit constamment les données depuis le cache du système d'exploitation, les place dans BlockCache, pour presque immédiatement les rejeter, car un nouvel ensemble de données arrive. L'animation au début du post illustre le problème — le Garbage Collector est surchargé, l'atmosphère se réchauffe, la petite Greta, dans un lointain et chaud pays scandinave, est contrariée. Et nous, les informaticiens, n'aimons pas du tout voir des enfants tristes, donc nous commençons à réfléchir à ce que nous pourrions faire.
Et si nous plaçons dans le cache non pas tous les blocs, mais seulement un certain pourcentage d'entre eux, afin que le cache ne déborde pas ? Commençons simplement par ajouter quelques lignes de code au début de la fonction de placement des données dans BlockCache :
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
L'idée ici est la suivante : l'offset est la position du bloc dans le fichier et les derniers chiffres sont répartis aléatoirement et uniformément de 00 à 99. Par conséquent, nous ne passerons que ceux qui se situent dans la plage dont nous avons besoin.
Par exemple, fixons cacheDataBlockPercent à 20 et voyons ce qui se passe :
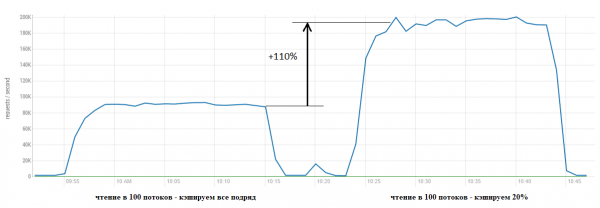
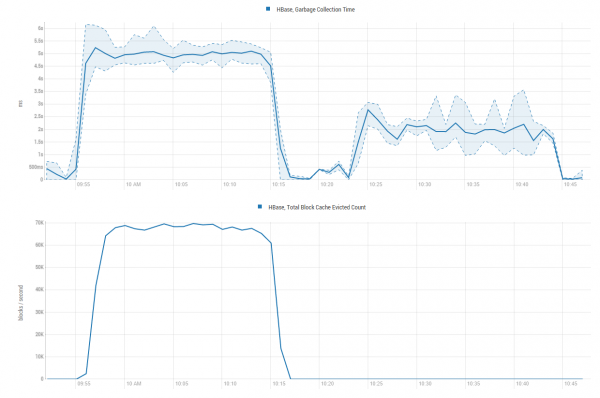
Le résultat est évident. Sur les graphes ci-dessous, il devient clair que cette accélération a été obtenue en économisant beaucoup de ressources GC, sans avoir à faire le travail de Sisyphe consistant à placer des données dans le cache uniquement pour les rejeter immédiatement sous le nez des chiens martiens :
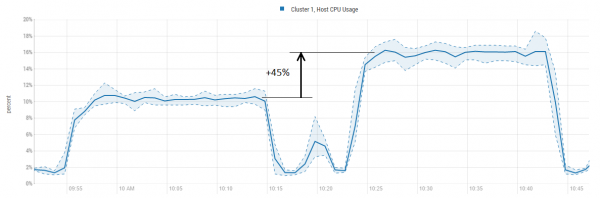
L'utilisation du CPU augmente, mais beaucoup moins que la performance :
Il convient également de noter que les blocs stockés dans BlockCache varient. La majorité, environ 95%, concerne en fait des données. Et le reste concerne des métadonnées, comme des filtres Bloom ou LEAF_INDEX et . Ces données sont peu nombreuses, mais très utiles, car avant de s'adresser directement aux données, HBase consulte les métadonnées pour comprendre s'il faut chercher plus loin et, si oui, où se trouve le bloc qui l'intéresse.
C'est pourquoi dans le code, nous voyons une condition vérifiant buf.getBlockType().isData() et grâce à cette métadonnée, nous laisserons quoi qu'il en soit dans le cache.
Maintenant, augmentons la charge et améliorons légèrement la fonction. Dans le premier test, nous avons fixé le pourcentage de seuil à 20 et BlockCache était légèrement sous-chargé. Maintenant, plaçons-le à 23% et ajoutons 100 threads toutes les 5 minutes pour voir à quel moment la saturation se produit :
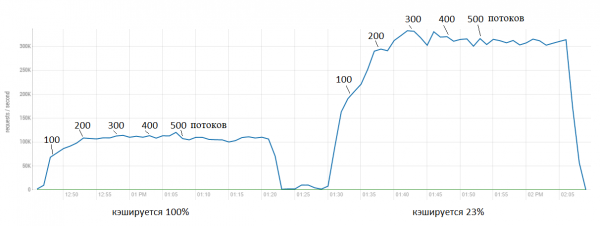
Ici, nous voyons que la version initiale atteint pratiquement immédiatement un plafond d'environ 100 000 requêtes par seconde. Alors que le patch permet d'augmenter jusqu'à 300 000. Il est clair que toute augmentation supplémentaire n'est plus si « gratuite », l'utilisation du CPU augmente également.
Cependant, ce n'est pas une solution très élégante, car nous ne savons pas à l'avance quel pourcentage de blocs doit être mis en cache, cela dépend du profil de charge. Par conséquent, un mécanisme d'ajustement automatique de ce paramètre a été implémenté en fonction de l'activité des opérations de lecture.
Pour gérer cela, trois paramètres ont été ajoutés :
hbase.lru.cache.heavy.eviction.count.limit — définit combien de fois le processus d'expulsion des données du cache doit être lancé avant que nous commencions à utiliser l'optimisation (c'est-à-dire à ignorer les blocs). Par défaut, il est égal à MAX_INT = 2147483647 et signifie en réalité que la fonctionnalité ne commencera jamais à fonctionner à cette valeur. Parce que le processus d'expulsion se lance toutes les 5 à 10 secondes (cela dépend de la charge) et 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 ans. Cependant, nous pouvons définir ce paramètre à 0 et faire en sorte que la fonctionnalité fonctionne immédiatement après le démarrage.
Cependant, il y a aussi une charge utile dans ce paramètre. Si nous avons une caractéristique de charge où les lectures à court terme (disons le jour) et à long terme (la nuit) se mélangent constamment, nous pouvons faire en sorte que la fonctionnalité ne s'active que lors d'opérations de lecture prolongées.
Par exemple, nous savons que les lectures à court terme durent généralement environ 1 minute. Il n'est pas nécessaire de commencer à expulser des blocs, le cache ne sera pas obsolète et nous pouvons définir ce paramètre à par exemple 10. Cela entraînera le fait que l'optimisation ne commencera à fonctionner que lorsque les lectures actives prolongées commencent, c'est-à-dire après 100 secondes. Ainsi, si nous avons des lectures à court terme, tous les blocs iront dans le cache et seront disponibles (à l'exception de ceux qui seront expulsés par l'algorithme standard). Et lorsque nous faisons des lectures à long terme, la fonctionnalité s'active et nous avons une performance beaucoup plus élevée.
hbase.lru.cache.heavy.eviction.mb.size.limit — définit combien de mégaoctets nous aimerions placer dans le cache (et donc expulser) en 10 secondes. La fonctionnalité essaiera d'atteindre cette valeur et de la maintenir. L'idée est la suivante, si nous insérons des gigaoctets dans le cache, nous devrons aussi expulser des gigaoctets, ce qui, comme nous l'avons vu ci-dessus, est très coûteux. Cependant, il ne faut pas essayer de le définir trop petit, car cela conduira à une sortie prématurée du mode d'ignorance des blocs. Pour des serveurs puissants (environ 20-40 cœurs physiques), il est optimal de définir environ 300-400 Mo. Pour une classe moyenne (~10 cœurs) 200-300 Mo. Pour des systèmes faibles (2-5 cœurs), 50-100 Mo peut être acceptable (cela n'a pas été testé sur de tels systèmes).
Considérons comment cela fonctionne : supposons que nous ayons défini hbase.lru.cache.heavy.eviction.mb.size.limit = 500, il y a un certain charge (lecture) et alors toutes les ~10 secondes, nous calculons combien d'octets ont été libérés selon la formule :
Surcharge = Somme des octets libérés (Mo) * 100 / Limite (Mo) — 100;
Si en fait 2000 Mo ont été libérés, alors la surcharge est :
2000 * 100 / 500 — 100 = 300%
Les algorithmes essaient de maintenir à moins de quelques dizaines de pourcents, donc la fonctionnalité diminuera le pourcentage des blocs mis en cache, réalisant ainsi un mécanisme d'auto-optimisation.
Cependant, si la charge a diminué, par exemple, seulement 200 Mo ont été libérés et la surcharge est devenue négative (ce qu'on appelle un overshooting) :
200 * 100 / 500 — 100 = -60%
Dans ce cas, la fonctionnalité augmentera au contraire le pourcentage des blocs mis en cache jusqu'à ce que la surcharge soit positive.
Voici un exemple de ce à quoi cela ressemble avec des données réelles. Il n'est pas nécessaire d'essayer d'atteindre 0%, c'est impossible. C'est assez bon lorsque l'on est autour de 30 — 100%, cela aide à éviter une sortie prématurée du mode d'optimisation lors des pics à court terme.
hbase.lru.cache.heavy.eviction.overhead.coefficient — détermine à quelle vitesse nous aimerions obtenir le résultat. Si nous savons de manière certaine que nos lectures sont principalement longues et que nous ne voulons pas attendre, nous pouvons augmenter ce coefficient et obtenir une haute performance plus rapidement.
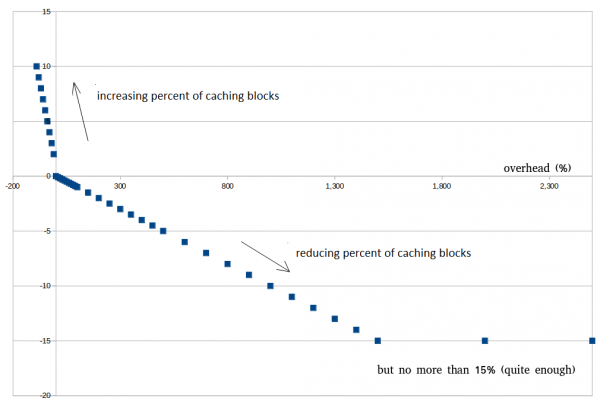
Par exemple, nous avons défini ce coefficient = 0.01. Cela signifie que la surcharge (voir ci-dessus) sera multipliée par ce nombre et le pourcentage des blocs mis en cache sera réduit. Supposons que la surcharge = 300%, et que le coefficient = 0.01, alors le pourcentage des blocs mis en cache sera réduit de 3%.
Une logique similaire de « Backpressure » est mise en œuvre également pour les valeurs négatives de la surcharge (overshooting). Étant donné qu'il peut toujours y avoir des fluctuations à court terme dans le volume de lectures-libérations, ce mécanisme permet d'éviter une sortie prématurée du mode d'optimisation. La Backpressure a une logique inversée : plus l'overshooting est fort, plus de blocs sont mis en cache.
Code de mise en œuvre
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict()/1024/1024;
        /*
        * Parfois, nous lisons plus de données que ce qui peut tenir dans BlockCache
        * et cela est la cause d'un taux d'évictions élevé.
        * Cela entraîne à son tour une forte charge de travail pour le Garbage Collector.
        * Ainsi, de nombreux blocs sont placés dans BlockCache mais jamais lus,
        * dépensant beaucoup de ressources CPU.
        * Ici, nous allons analyser combien d'octets ont été libérés et décider
        * si le moment est venu de réduire le nombre de blocs mis en cache.
        * Cela aide à éviter de trop mettre de blocs dans BlockCache
        * lorsque evict() fonctionne très activement et économise du CPU pour d'autres tâches.
        * Plus de détails : https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Tout d'abord, nous devons contrôler combien de temps
        // s'est écoulé depuis que le précédent evict() a été lancé
        // Cela devrait être presque le même temps (+/- 10s)
        // car nous obtenons des volumes comparables d'octets libérés à chaque fois.
        // 10s car c'est la période par défaut pour exécuter evict() (voir ci-dessus this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Ici nous devons calculer la situation dans laquelle nous nous trouvons.
          // Nous avons la limite "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // et pouvons calculer la surcharge par rapport à cela.
          // Nous allons utiliser cette information pour décider,
          // comment changer le pourcentage de blocs en cache.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Maintenant nous sommes dans une situation où nous sommes au-dessus de la limite
            // Mais peut-être que nous allons l'ignorer car cela prendra fin assez bientôt
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Cela dure depuis longtemps et nous devons réduire le nombre de blocs mis en cache
              // Donc, nous calculons ici combien de blocs nous voulons sauter.
              // Cela dépend de :
             // 1. Surcharge - si la surcharge est importante, nous pourrions être plus agressifs
              // dans la réduction du nombre de blocs mis en cache.
              // 2. À quelle vitesse nous voulons obtenir le résultat. Si nous savons que notre
              // lecture lourde dure longtemps, nous ne voulons pas attendre et pouvons
              // augmenter le coefficient et obtenir une bonne performance assez rapidement.
              // Mais si nous ne sommes pas sûrs, nous pouvons le faire lentement et cela pourrait éviter
              // une sortie prématurée de ce mode. Donc, lorsque le coefficient est
              // plus élevé, nous pouvons obtenir de meilleures performances lorsque la lecture lourde est stable.
              // Mais lorsque la lecture change, nous pouvons nous ajuster et définir
              // le coefficient à une valeur inférieure.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Mais la pratique montre qu'une réduction de 15% est largement suffisante.
              // Nous ne sommes pas gourmands (cela pourrait mener à une sortie prématurée).
              change = Math.min(15, change);
              change = Math.max(0, change); // Je pense que cela n'arrivera jamais mais vérifions pour être sûrs
              // Donc c'est le point clé, ici nous réduisons % de blocs mis en cache
              cache.cacheDataBlockPercent -= change;
              // Si nous descendons trop bas, nous devons nous arrêter ici, 1% au minimum doit être.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Eh bien, nous avons obtenu un dépassement.
            // Peut-être est-ce juste une fluctuation à court terme et nous pouvons rester dans ce mode.
            // Cela aide à éviter une sortie prématurée lors de fluctuations à court terme.
            // Si le dépassement est inférieur à 90%, nous allons essayer d'augmenter le pourcentage de
            // blocs mis en cache et espérer que cela soit suffisant.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Logique simple : plus de dépassement - plus de blocs en cache (pression de retour)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Mais cela ne peut pas être plus de 100%, donc vérifions-le.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // On dirait que la lecture lourde est terminée.
              // Il suffit de sortir de ce mode.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache évacué (MB) : {}, surcharge (%) : {}, " +
            "compteur d'évictions lourdes : {}, " +
            "pourcentage actuel de blocs de données en cache (%) : {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Examinons maintenant tout cela à l'aide d'un exemple réel. Nous avons le scénario de test suivant :
- Nous commençons à faire un Scan (25 threads, batch = 100)
- Après 5 minutes, nous ajoutons des multi-gets (25 threads, batch = 100)
- Après 5 minutes, nous désactivons les multi-gets (il reste uniquement le scan)
Nous exécutons deux passes, d'abord hbase.lru.cache.heavy.eviction.count.limit = 10000 (ce qui désactive en fait la fonctionnalité), puis nous mettons le limit = 0 (ce qui l'active).
Dans les journaux ci-dessous, nous voyons comment la fonctionnalité s'active, réinitialisant l'Overshooting à 14-71 %. De temps en temps, la charge diminue, ce qui active le Backpressure et HBase met à nouveau en cache plus de blocs.
Journal du RegionServer
évacué (Mo) : 0, ratio 0.0, surcoût (%) : -100, compteur d'éviction lourde : 0, DataBlock en cache actuel (%) : 100
évacué (Mo) : 0, ratio 0.0, surcoût (%) : -100, compteur d'éviction lourde : 0, DataBlock en cache actuel (%) : 100
évacué (Mo) : 2170, ratio 1.09, surcoût (%) : 985, compteur d'éviction lourde : 1, DataBlock en cache actuel (%) : 91 < start
évacué (Mo) : 3763, ratio 1.08, surcoût (%) : 1781, compteur d'éviction lourde : 2, DataBlock en cache actuel (%) : 76
évacué (Mo) : 3306, ratio 1.07, surcoût (%) : 1553, compteur d'éviction lourde : 3, DataBlock en cache actuel (%) : 61
évacué (Mo) : 2508, ratio 1.06, surcoût (%) : 1154, compteur d'éviction lourde : 4, DataBlock en cache actuel (%) : 50
évacué (Mo) : 1824, ratio 1.04, surcoût (%) : 812, compteur d'éviction lourde : 5, DataBlock en cache actuel (%) : 42
évacué (Mo) : 1482, ratio 1.03, surcoût (%) : 641, compteur d'éviction lourde : 6, DataBlock en cache actuel (%) : 36
évacué (Mo) : 1140, ratio 1.01, surcoût (%) : 470, compteur d'éviction lourde : 7, DataBlock en cache actuel (%) : 32
évacué (Mo) : 913, ratio 1.0, surcoût (%) : 356, compteur d'éviction lourde : 8, DataBlock en cache actuel (%) : 29
évacué (Mo) : 912, ratio 0.89, surcoût (%) : 356, compteur d'éviction lourde : 9, DataBlock en cache actuel (%) : 26
évacué (Mo) : 684, ratio 0.76, surcoût (%) : 242, compteur d'éviction lourde : 10, DataBlock en cache actuel (%) : 24
évacué (Mo) : 684, ratio 0.61, surcoût (%) : 242, compteur d'éviction lourde : 11, DataBlock en cache actuel (%) : 22
évacué (Mo) : 456, ratio 0.51, surcoût (%) : 128, compteur d'éviction lourde : 12, DataBlock en cache actuel (%) : 21
évacué (Mo) : 456, ratio 0.42, surcoût (%) : 128, compteur d'éviction lourde : 13, DataBlock en cache actuel (%) : 20
évacué (Mo) : 456, ratio 0.33, surcoût (%) : 128, compteur d'éviction lourde : 14, DataBlock en cache actuel (%) : 19
évacué (Mo) : 342, ratio 0.33, surcoût (%) : 71, compteur d'éviction lourde : 15, DataBlock en cache actuel (%) : 19
évacué (Mo) : 342, ratio 0.32, surcoût (%) : 71, compteur d'éviction lourde : 16, DataBlock en cache actuel (%) : 19
évacué (Mo) : 342, ratio 0.31, surcoût (%) : 71, compteur d'éviction lourde : 17, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.3, surcoût (%) : 14, compteur d'éviction lourde : 18, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.29, surcoût (%) : 14, compteur d'éviction lourde : 19, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.27, surcoût (%) : 14, compteur d'éviction lourde : 20, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.25, surcoût (%) : 14, compteur d'éviction lourde : 21, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.24, surcoût (%) : 14, compteur d'éviction lourde : 22, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.22, surcoût (%) : 14, compteur d'éviction lourde : 23, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.21, surcoût (%) : 14, compteur d'éviction lourde : 24, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.2, surcoût (%) : 14, compteur d'éviction lourde : 25, DataBlock en cache actuel (%) : 19
évacué (Mo) : 228, ratio 0.17, surcoût (%) : 14, compteur d'éviction lourde : 26, DataBlock en cache actuel (%) : 19
évincé (Mo) : 456, ratio 0,17, surcharge (%) : 128, compteur d'éviction élevé : 27, bloc de données de mise en cache actuel (%) : 18 < ajouts réalisés (mais la table reste la même)
évincé (Mo) : 456, ratio 0,15, surcharge (%) : 128, compteur d'éviction élevé : 28, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 342, ratio 0,13, surcharge (%) : 71, compteur d'éviction élevé : 29, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 342, ratio 0,11, surcharge (%) : 71, compteur d'éviction élevé : 30, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 342, ratio 0,09, surcharge (%) : 71, compteur d'éviction élevé : 31, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 228, ratio 0,08, surcharge (%) : 14, compteur d'éviction élevé : 32, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 228, ratio 0,07, surcharge (%) : 14, compteur d'éviction élevé : 33, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 228, ratio 0,06, surcharge (%) : 14, compteur d'éviction élevé : 34, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 228, ratio 0,05, surcharge (%) : 14, compteur d'éviction élevé : 35, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 228, ratio 0,05, surcharge (%) : 14, compteur d'éviction élevé : 36, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 228, ratio 0,04, surcharge (%) : 14, compteur d'éviction élevé : 37, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 109, ratio 0,04, surcharge (%) : -46, compteur d'éviction élevé : 37, bloc de données de mise en cache actuel (%) : 22 < pression arrière
évincé (Mo) : 798, ratio 0,24, surcharge (%) : 299, compteur d'éviction élevé : 38, bloc de données de mise en cache actuel (%) : 20
évincé (Mo) : 798, ratio 0,29, surcharge (%) : 299, compteur d'éviction élevé : 39, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 570, ratio 0,27, surcharge (%) : 185, compteur d'éviction élevé : 40, bloc de données de mise en cache actuel (%) : 17
évincé (Mo) : 456, ratio 0,22, surcharge (%) : 128, compteur d'éviction élevé : 41, bloc de données de mise en cache actuel (%) : 16
évincé (Mo) : 342, ratio 0,16, surcharge (%) : 71, compteur d'éviction élevé : 42, bloc de données de mise en cache actuel (%) : 16
évincé (Mo) : 342, ratio 0,11, surcharge (%) : 71, compteur d'éviction élevé : 43, bloc de données de mise en cache actuel (%) : 16
évincé (Mo) : 228, ratio 0,09, surcharge (%) : 14, compteur d'éviction élevé : 44, bloc de données de mise en cache actuel (%) : 16
évincé (Mo) : 228, ratio 0,07, surcharge (%) : 14, compteur d'éviction élevé : 45, bloc de données de mise en cache actuel (%) : 16
évincé (Mo) : 228, ratio 0,05, surcharge (%) : 14, compteur d'éviction élevé : 46, bloc de données de mise en cache actuel (%) : 16
évincé (Mo) : 222, ratio 0,04, surcharge (%) : 11, compteur d'éviction élevé : 47, bloc de données de mise en cache actuel (%) : 16
évincé (Mo) : 104, ratio 0,03, surcharge (%) : -48, compteur d'éviction élevé : 47, bloc de données de mise en cache actuel (%) : 21 < obtentions d'interruption
évincé (Mo) : 684, ratio 0,2, surcharge (%) : 242, compteur d'éviction élevé : 48, bloc de données de mise en cache actuel (%) : 19
évincé (Mo) : 570, ratio 0,23, surcharge (%) : 185, compteur d'éviction élevé : 49, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 342, ratio 0,22, surcharge (%) : 71, compteur d'éviction élevé : 50, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 228, ratio 0,21, surcharge (%) : 14, compteur d'éviction élevé : 51, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 228, ratio 0,2, surcharge (%) : 14, compteur d'éviction élevé : 52, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 228, ratio 0,18, surcharge (%) : 14, compteur d'éviction élevé : 53, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 228, ratio 0,16, surcharge (%) : 14, compteur d'éviction élevé : 54, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 228, ratio 0,14, surcharge (%) : 14, compteur d'éviction élevé : 55, bloc de données de mise en cache actuel (%) : 18
évincé (Mo) : 112, ratio 0,14, surcharge (%) : -44, compteur d'éviction élevé : 55, bloc de données de mise en cache actuel (%) : 23 < pression arrière
évincé (Mo) : 456, ratio 0,26, surcharge (%) : 128, compteur d'éviction élevé : 56, bloc de données de mise en cache actuel (%) : 22
évincé (Mo) : 342, ratio 0,31, surcharge (%) : 71, compteur d'éviction élevé : 57, bloc de données de mise en cache actuel (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 58, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 59, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 60, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 61, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 62, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 63, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.32, surcharge (%) : 71, compteur d'évictions lourdes : 64, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 65, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 66, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.32, surcharge (%) : 71, compteur d'évictions lourdes : 67, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 68, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.32, surcharge (%) : 71, compteur d'évictions lourdes : 69, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.32, surcharge (%) : 71, compteur d'évictions lourdes : 70, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 71, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 72, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 73, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 74, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 75, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 342, ratio 0.33, surcharge (%) : 71, compteur d'évictions lourdes : 76, données mises en cache actuellement DataBlock (%) : 22
évincé (Mo) : 21, ratio 0.33, surcharge (%) : -90, compteur d'évictions lourdes : 76, données mises en cache actuellement DataBlock (%) : 32
évacué (Mo) : 0, ratio 0.0, surcoût (%) : -100, compteur d'éviction lourde : 0, DataBlock en cache actuel (%) : 100
évacué (Mo) : 0, ratio 0.0, surcoût (%) : -100, compteur d'éviction lourde : 0, DataBlock en cache actuel (%) : 100
Les scans étaient nécessaires pour montrer ce même processus sous forme de graphique du ratio entre deux sections de cache — single (où se trouvent les blocs que personne n'a encore demandés) et multi (où sont stockées les données « demandées » au moins une fois) :
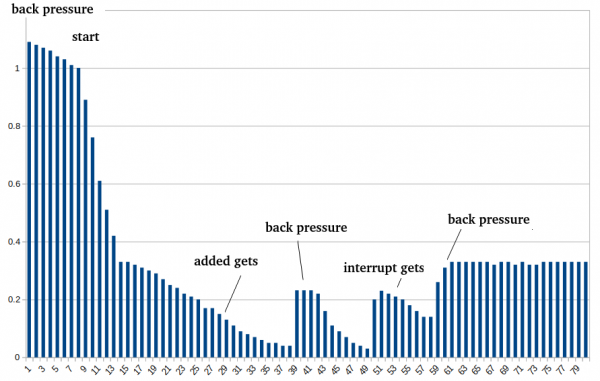
Enfin, voici comment les paramètres fonctionnent sous forme de graphique. Pour comparer, le cache était complètement désactivé au départ, puis HBase a été lancé avec mise en cache et un délai avant le début de l'optimisation de 5 minutes (30 cycles d'éviction).
Le code complet peut être trouvé dans la Pull Request github.
Cependant, 300 000 lectures par seconde ne représente pas tout ce qu'il est possible d'extraire de ce matériel dans ces conditions. En effet, lorsque vous devez accéder aux données via HDFS, un mécanisme appelé ShortCircuitCache (SSC) est utilisé, permettant d'accéder directement aux données sans interactions réseau.
Le profilage a montré que ce mécanisme, bien qu'il offre un grand gain, devient également à un moment donné un goulet d'étranglement, car presque toutes les opérations lourdes se produisent à l'intérieur d'un verrou, ce qui entraîne des blocages la majeure partie du temps.
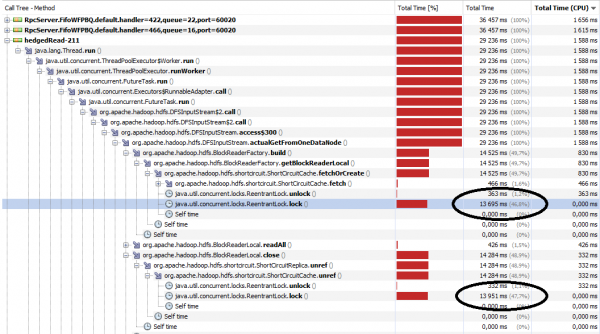
En prenant cela en compte, nous avons compris que le problème pouvait être contourné en créant un tableau de SSC indépendants :
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
Et ensuite travailler avec eux, en excluant les intersections également par le dernier chiffre de l'index :
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Nous pouvons maintenant procéder aux tests. Pour cela, nous allons lire des fichiers depuis HDFS avec une application multithread simple. Nous définissons les paramètres :
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // par défaut = 1 Mo et cela ralentit considérablement la lecture, il est donc préférable de l'adapter aux besoins réels
conf.set("dfs.client.short.circuit.num", num); // de 1 à 10
Et nous lisons simplement des fichiers :
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Ce code s'exécute dans des threads séparés et nous allons augmenter le nombre de fichiers lus simultanément (de 10 à 200 — axe horizontal) et le nombre de caches (de 1 à 10 — graphiques). L'axe vertical montre l'accélération obtenue par l'augmentation de SSC par rapport au cas où il n'y a qu'un seul cache.
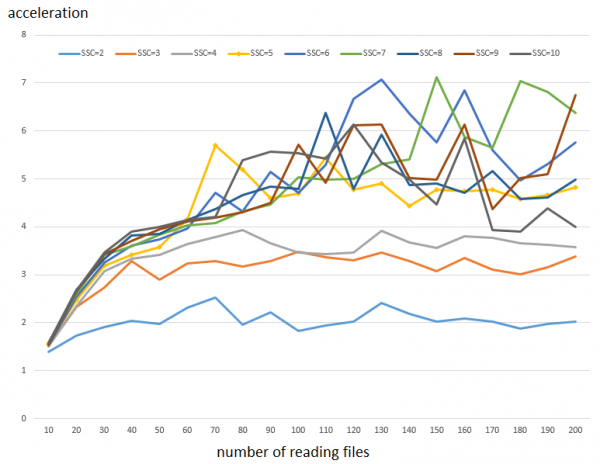
Comment lire le graphique : le temps d'exécution de 100 000 lectures par blocs de 64 Ko avec un seul cache prend 78 secondes. Tandis qu'avec 5 caches, cela s'effectue en 16 secondes. Autrement dit, cela représente un gain d'environ 5 fois. Comme le montre le graphique, avec un petit nombre de lectures parallèles, l'effet n'est pas très perceptible, cela commence à jouer un rôle significatif lorsque le nombre de lectures en parallèle dépasse 50. Il est également évident que l'augmentation du nombre de SSC au-delà de 6 apporte une amélioration de performance beaucoup moins significative.
Remarque 1 : comme les résultats des tests sont assez volatils (voir ci-dessous), trois exécutions ont été réalisées et les valeurs obtenues ont été moyennées.
Remarque 2 : Le gain de performance des réglages pour l'accès aléatoire est le même, bien que l'accès lui-même soit légèrement plus lent.
Cependant, il est important de préciser qu'à la différence du cas d'HBase, cette accélération n'est pas toujours gratuite. Ici, nous 'déverrouillons' davantage les capacités du CPU pour effectuer le travail, au lieu de rester bloqués sur les verrous.
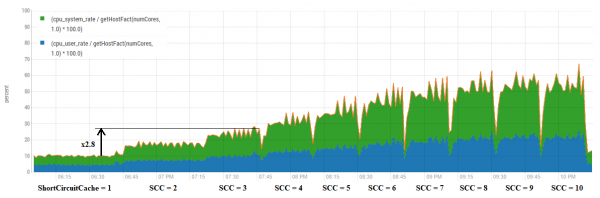
Ici, on peut observer qu'en général, l'augmentation du nombre de caches génère une augmentation proportionnelle de l'utilisation du CPU. Cependant, il existe quelques combinaisons plus avantageuses.
Par exemple, examinons de plus près la configuration SSC = 3. L'augmentation des performances dans cette plage est d'environ 3,3 fois. Ci-dessous, les résultats de trois lancers distincts.
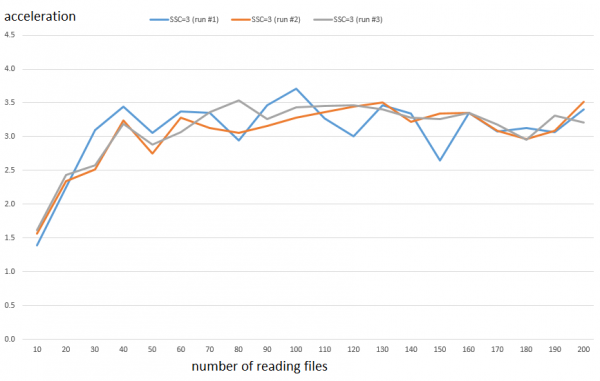
Tandis que la consommation du CPU augmente d'environ 2,8 fois. La différence n'est pas très grande, mais cela fait déjà plaisir à la petite Greta et cela pourrait lui laisser du temps pour aller à l'école et aux cours.
Ainsi, cela aura un effet positif pour tout outil utilisant l'accès massif à HDFS (comme Spark, etc.), à condition que le code applicatif soit léger (c'est-à-dire que le goulet d'étranglement se situe du côté du client HDFS) et qu'il y ait des capacités CPU libres. Pour vérifier, testons quel effet aura l'application conjointe de l'optimisation BlockCache et du réglage SSC pour la lecture depuis HBase.
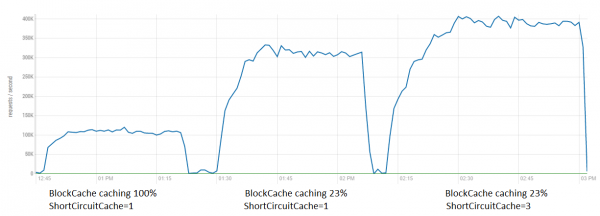
On constate ici que dans ces conditions, l'effet n'est pas aussi important que dans les tests raffinés (lecture sans aucun traitement), cependant, il est tout à fait possible d'extraire des 80K supplémentaires. En combinant, les deux optimisations permettent d'accélérer jusqu'à 4 fois.
Un PR a également été fait pour cette optimisation. , qui a été intégré et cette fonctionnalité sera disponible dans les prochaines versions.
Enfin, il était intéressant de comparer les performances de lecture d'une base de données à colonnes larges similaire, Cassandra, et HBase.
Pour cela, des instances de l'outil de test de charge standard YCSB ont été lancées depuis deux hôtes (800 threads au total). Du côté serveur, il y avait 4 instances de RegionServer et Cassandra sur 4 hôtes (différents de ceux où les clients sont lancés, pour éviter leur influence). Les lectures provenaient de tables de taille :
HBase — 300 Go sur HDFS (100 Go de données brutes)
Cassandra — 250 Go (facteur de réplication = 3)
C'est-à-dire que le volume était à peu près identique (HBase étant légèrement plus important).
Paramètres HBase :
dfs.client.short.circuit.num = 5 (optimisation du client HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 — cela signifie que le patch commencera à fonctionner après 30 évictions (~5 minutes)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — volume cible de mise en cache et d'éviction
Les journaux YCSB ont été analysés et résumés sous forme de graphiques Excel :
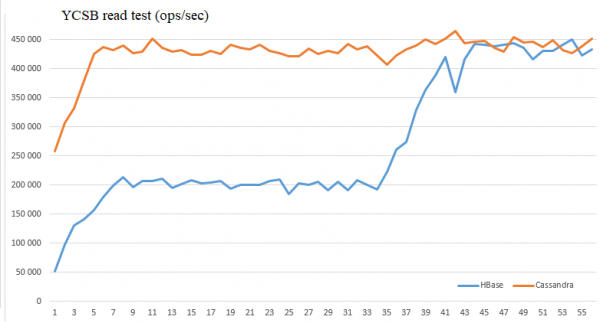
Comme on peut le voir, les données d'optimisation permettent d'égaliser la performance de ces bases de données dans ces conditions et d'atteindre 450 000 lectures par seconde.
Nous espérons que ces informations pourront être utiles à quelqu'un dans la fascinante lutte pour la performance.
Source : habr.com
