

Introduction
Il est temps d'acheter un système de stockage. Lequel choisir, qui écouter ? Le fournisseur A parle du fournisseur B, et il y a aussi l'intégrateur C, qui dit le contraire et recommande le fournisseur D. Dans une telle situation, même un architecte expérimenté en systèmes de stockage peut être perdu, surtout avec tous ces nouveaux fournisseurs et les tendances modernes comme le SDS et l'hyper-convergence.
Alors, comment s'y retrouver et ne pas se retrouver dans une impasse ? Nous ( Anton Zhbankov et Evgeny Elizarov) allons essayer d'expliquer tout cela en termes simples.
L'article fait largement écho et constitue en fait une extension de “” en ce qui concerne le choix des systèmes de stockage de données et l'examen des technologies de stockage. Nous allons brièvement examiner la théorie générale, mais nous vous recommandons également de consulter l'article mentionné.
Pourquoi
On peut souvent observer comment une nouvelle personne arrive sur un forum ou dans un chat spécialisé, comme par exemple Storage Discussions, et pose la question : “On me propose deux options de systèmes de stockage — ABC SuperStorage S600 et XYZ HyperOcean 666v4, que conseillez-vous ?”
Et commence le décompte des caractéristiques d'implémentation terrifiantes et incompréhensibles, qui pour une personne non préparée ressemble à de l'hébreu.
La clé et la première question à se poser bien avant de comparer les spécifications dans les offres commerciales est — POURQUOI ? Pourquoi ce système de stockage est-il nécessaire ?
La réponse peut être surprenante, et très dans le style de Tony Robbins — pour stocker des données. Merci, capitaine ! Pourtant, parfois nous nous plongeons tellement dans la comparaison des détails que nous oublions pourquoi nous faisons tout cela.
Ainsi, la tâche d'un système de stockage de données est de stocker et de fournir l'accès aux DONNÉES avec les performances requises. C'est à partir de ces données que nous allons commencer.
Données
Type de données
Quelles données prévoyons-nous de stocker ? C'est une question très importante qui peut écarter de nombreux systèmes de stockage de considérations. Par exemple, si le stockage de vidéos et de photos est prévu. Nous pouvons immédiatement écarter les systèmes conçus pour un accès aléatoire par petits blocs, ou les systèmes avec des fonctionnalités propriétaires en compression / dé-duplication. Ce peuvent être d'excellents systèmes, nous ne voulons rien dire de mauvais à leur sujet. Mais dans ce cas, leurs points forts pourraient en réalité devenir des faiblesses (les vidéos et les photos ne sont pas compressibles), ou augmenter considérablement le coût du système.
Inversement, si l'utilisation ciblée est une base de données transactionnelle lourde, alors d'excellents systèmes de flux multimédia capables de fournir des gigaoctets par seconde seront un mauvais choix.
Volume des données
Combien de données prévoyons-nous de stocker ? La quantité se transforme toujours en qualité, il ne faut jamais l'oublier, surtout en cette époque de croissance exponentielle du volume des données. Les systèmes de classe péta-octet ne sont déjà plus rares, mais plus le volume en péta-octets est important, plus le système devient spécifique, et moins la fonctionnalité habituelle des systèmes avec un accès aléatoire de petit et moyen volume sera disponible. Simplement parce que les seules tables de statistiques d'accès par blocs deviennent plus grandes que la mémoire vive disponible sur les contrôleurs. Sans parler de la compression / tiering. Supposons que nous souhaitions changer l'algorithme de compression pour un plus puissant et compresser 20 péta-octets de données. Combien de temps cela prendra-t-il : six mois, un an ?
D'un autre côté, pourquoi compliquer les choses si nous devons stocker et traiter 500 Go de données ? Seulement 500. Des SSD grand public (avec un faible DWPD) de ce volume coûtent une bouchée. Pourquoi construire une usine Fiber Channel et acheter un système de stockage externe haut de gamme coûtant le prix d'un pont en fonte ?
Quel pourcentage du volume total représentent les données chaudes ? Quelle est l'uniformité de la charge en fonction du volume des données ? C'est ici que la technologie de stockage hiérarchique ou le Flash Cache peut vraiment aider, si le volume des données chaudes est minime par rapport à l'ensemble. À l'inverse, dans le cas d'une charge uniforme sur l'ensemble du volume, souvent rencontré dans les systèmes de streaming (vidéosurveillance, certains systèmes d'analyse), ces technologies ne fourniront rien et n'augmenteront que le coût / la complexité du système.
SI
L'autre face des données est le système d'information qui utilise ces données. Le SI a un ensemble d'exigences qui sont héritées des données. Pour en savoir plus sur le SI, voir « Conception d'un centre de données virtualisé ».
Exigences en matière de tolérance aux pannes / disponibilité
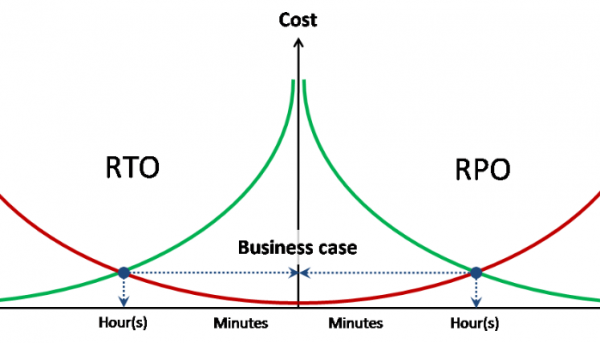
Les exigences de tolérance aux pannes / disponibilité des données sont héritées du SI qui les utilise et s'expriment en trois chiffres — RPO, RTO, disponibilité.
Disponibilité — la fraction d'un intervalle de temps donné pendant lequel les données sont accessibles pour un traitement. Cela s'exprime généralement en nombre de 9. Par exemple, deux neuf dans l'année signifie que la disponibilité est de 99 %, ou que 95 heures d'indisponibilité par an sont acceptables. Trois neuf — 9,5 heures par an.
RPO / RTO — ce sont des indicateurs non cumulés, mais relatifs à chaque incident (panne), contrairement à la disponibilité.
RPO — le volume de données perdues lors d'un incident (en heures). Par exemple, si une sauvegarde est effectuée une fois par jour, alors RPO = 24 heures. C'est-à-dire qu'en cas de panne et de perte totale du stockage, des données d'un volume allant jusqu'à 24 heures (depuis la dernière sauvegarde) peuvent être perdues. Selon le RPO défini pour le SI, une réglementation pour les sauvegardes est établie. De plus, en fonction du RPO, on peut comprendre dans quelle mesure une réplication des données synchrones / asynchrones est nécessaire.
RTO — le temps de restauration du service (accès aux données) après une panne. En fonction de la valeur RTO définie, nous pouvons comprendre si un metrocluster est nécessaire, ou si une réplication unidirectionnelle suffit. Est-ce qu'un système de stockage hi-end à contrôleurs multiples est également nécessaire ?
Exigences en matière de performance
Bien que cela semble être une question évidente, c'est ici que la plupart des difficultés surgissent. En fonction de la présence ou non d'une infrastructure existante, des chemins de collecte des statistiques nécessaires seront construits.
Vous avez déjà un stockage SAN et vous envisagez de le remplacer ou d'en acquérir un autre pour l'extension. Ici, c'est simple. Vous comprenez quels services vous avez déjà et quels services vous prévoyez de mettre en œuvre dans un avenir proche. En vous basant sur les services actuels, vous avez la possibilité de recueillir des statistiques sur les performances. Déterminez le nombre actuel d'IOPS et les latences actuelles - quels sont ces indicateurs et sont-ils suffisants pour vos tâches ? Cela peut être fait tant sur le système de stockage que du côté des hôtes qui y sont connectés.
Il est important de ne pas regarder uniquement la charge actuelle, mais sur une période donnée (de préférence un mois). Vérifiez les pics maximaux pendant la journée, quelle charge génère la sauvegarde, etc. Si votre stockage SAN ou son logiciel ne vous fournit pas l'ensemble complet de ces données, vous pouvez utiliser le RRDtool gratuit, qui sait travailler avec la plupart des systèmes de stockage et des commutateurs les plus populaires et pourra vous fournir des statistiques détaillées sur les performances. Il est également utile d'examiner la charge sur les hôtes qui travaillent avec ce stockage SAN, par machine virtuelle spécifique ou ce qui fonctionne précisément sur cet hôte.
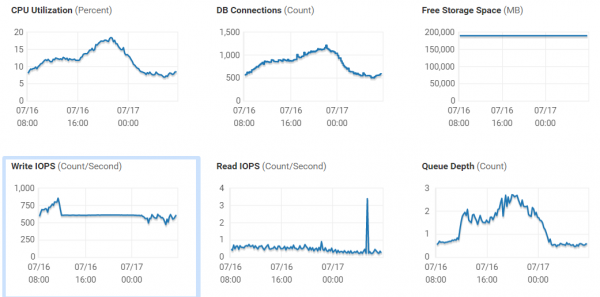
Il convient de noter séparément que si les latences sur le volume et le datastore, qui se trouve sur ce volume, diffèrent considérablement, il est nécessaire de prêter attention à votre réseau SAN, car il y a une forte probabilité qu'il y ait des problèmes. Avant d'acquérir un nouveau système, il vaut la peine de clarifier cette question, car il y a de grandes chances d'augmenter les performances du système actuel.
Vous construisez une infrastructure depuis le début ou vous acquérez un système pour un nouveau service dont vous n'êtes pas au courant des charges. Ici, il existe plusieurs options : discuter avec des collègues sur des ressources spécialisées pour essayer d'estimer et de prévoir la charge, contacter un intégrateur ayant de l'expérience dans la mise en œuvre de services similaires et capable de calculer la charge pour vous. Et la troisième option (généralement la plus difficile, surtout s'il s'agit d'applications propriétaires ou rares) consiste à essayer de déterminer les exigences de performance auprès des développeurs du système.
Et, attention, la meilleure option en termes d'application pratique est un pilote sur l'équipement actuel ou sur l'équipement fourni pour les tests par le fournisseur / intégrateur.
Exigences spécifiques
Les exigences spécifiques sont tout ce qui ne correspond pas aux exigences de performance, de disponibilité et de fonctionnalité concernant le traitement direct et la fourniture des données.
L'une des exigences spécifiques les plus simples pour un système de stockage de données est celle des "supports d'information transférables". Il devient immédiatement évident que ce système de stockage doit inclure une bibliothèque de bandes ou simplement un streamer, où une sauvegarde est stockée. Ensuite, une personne spécialement formée signe la bande et l'emporte fièrement dans un coffre-fort spécial.
Un autre exemple d'exigence spécifique est la protection contre les chocs.
Où
Le deuxième élément clé dans le choix d'une solution de stockage est l'information sur l'emplacement où cette solution sera installée. Cela va de la géographie ou des conditions climatiques jusqu'au personnel.
Client
Pour qui cette solution de stockage est-elle prévue ? Cette question est justifiée par les raisons suivantes :
Client gouvernemental / commercial.
Le client commercial n'a aucune restriction et n'est même pas obligé de lancer des appels d'offres, sauf selon ses propres règlements internes.
Le client gouvernemental est une autre affaire. La loi 44-FZ et d'autres subtilités concernant les appels d'offres et les spécifications qui peuvent être contestées.
Client sous sanctions
Ici, la question est très simple : le choix est limité aux offres disponibles pour ce client.
Règlements internes / fournisseurs autorisés à acheter / modèles
Cette question est également très simple, mais elle doit être gardée à l'esprit.
Où physiquement
Dans cette section, nous examinons toutes les questions concernant la géographie, les canaux de communication, et le microclimat dans la salle d'installation.
Personnel
Qui travaillera avec cette solution de stockage ? Cela est tout aussi important que les capacités du système de stockage lui-même.
Peu importe à quel point la solution de stockage du fournisseur A est prometteuse, géniale et admirable, il n'y a probablement pas de sens à la mettre en place si le personnel ne sait travailler qu'avec le fournisseur B et qu'aucune autre commande ou coopération continue avec A n'est prévue.
Et bien sûr, l'autre côté de la question est de savoir à quel point le personnel qualifié est accessible dans cette zone géographique, tant au sein de l'entreprise que sur le marché du travail. Pour certaines régions, il peut être significatif de choisir un système de stockage avec des interfaces simples ou une gestion centralisée à distance. Sinon, à un moment donné, cela pourrait devenir un véritable casse-tête. Internet regorge d'histoires sur des employés récents, des étudiants d'hier, qui ont configuré des systèmes de manière à paralyser toute l'entreprise.
L'environnement
Bien entendu, une question tout aussi importante est de savoir dans quel environnement ce système de stockage fonctionnera.
- Qu'en est-il de l'alimentation / du refroidissement ?
- Quel type de connexion
- Où sera-t-il installé
- Et cetera.
Souvent, ces questions sont considérées comme allant de soi et ne reçoivent pas une attention particulière, mais parfois, ce sont précisément elles qui peuvent complètement inverser la situation.
Quoi
Nombre de blocs/enregistrements
À ce jour (mi-2019), le marché russe des systèmes de stockage peut être divisé en cinq catégories conditionnelles :
- Premier niveau — entreprises éprouvées avec une large gamme, des étagères de disques les plus simples aux modèles haut de gamme (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Deuxième niveau — entreprises avec une gamme limitée, acteurs de niche, fournisseurs SDS sérieux ou nouveaux venus prometteurs (Fujitsu, Datacore, Infinidat, Huawei, Pure, etc.)
- Troisième niveau — solutions de niche au niveau bas de gamme, SDS bon marché, produits bricolés basés sur Ceph et d'autres projets open source (Infortrend, Starwind, etc.)
- Segment SOHO — petits et très petits systèmes de stockage pour domicile / petit bureau (Synology, QNAP, etc.)
- Systèmes de stockage importés — cela inclut à la fois le matériel de premier niveau avec des étiquettes rebrandées et quelques rares représentants du deuxième niveau (RAIDIX, on leur accorde un préjugé favorable, deuxième niveau), mais surtout le troisième niveau (Aerodisk, Baum, Depo, etc.)
Cette classification est assez conditionnelle et ne signifie pas du tout que le troisième ou le segment SOHO est mauvais et ne peut pas être utilisé. Dans des projets spécifiques avec un ensemble de données clairement défini et un profil de charge, ils peuvent performer très bien, surpassant largement le premier niveau en termes de rapport qualité/prix. Il est essentiel de définir d'abord les tâches, les perspectives de croissance, les fonctionnalités requises — et alors Synology vous servira fidèlement, et vos cheveux deviendront doux et soyeux.
Un des facteurs importants dans le choix d'un fournisseur est l'environnement actuel. Combien et quels systèmes de stockage vous avez déjà, avec quels systèmes de stockage les ingénieurs savent-ils travailler. Avez-vous besoin d'un autre fournisseur, d'un autre point de contact, allez-vous migrer progressivement toute la charge de travail du fournisseur A vers le fournisseur B ?
Il ne faut pas multiplier les entités au-delà du nécessaire.
iSCSI / FC / File
Il n'y a pas de consensus parmi les ingénieurs sur les protocoles d'accès, et les débats ressemblent plus à des discussions théologiques qu'à des discussions d'ingénierie. Mais on peut généralement noter les points suivants :
FCoE est plutôt mort que vivant.
FC vs iSCSI. Un des avantages clés de FC en 2019 par rapport aux systèmes de stockage IP, une usine dédiée pour l'accès aux données, est atténué par un réseau IP dédié. Il n'y a pas d'avantages globaux de FC par rapport aux réseaux IP et on peut construire des systèmes de stockage de tout niveau de charge sur IP, y compris des systèmes pour des bases de données lourdes pour les systèmes bancaires d'une grande banque. D'un autre côté, la mort de FC est prédite depuis plusieurs années, mais quelque chose semble toujours l'empêcher. Aujourd'hui, par exemple, certains acteurs du marché du stockage développent activement le standard NVMEoF. Le séparera-t-il du sort de FCoE ? Le temps nous le dira.
L'accès fichier n'est pas non plus quelque chose de négligeable. NFS / CIFS se comportent très bien dans des environnements productifs et, lorsqu'ils sont bien conçus, ne souffrent pas de plus de plaintes que les protocoles de blocs.
Hybrides / All Flash Array
Les systèmes de stockage classiques se divisent en 2 types :
- AFA (All Flash Array) — systèmes optimisés pour l'utilisation des SSD.
- Hybrides — permettant d'utiliser à la fois des HDD et des SSD ou une combinaison des deux.
La principale différence réside dans les technologies de stockage prises en charge et le niveau de performance maximal (hauts IOPS et faible latence). Les deux types de systèmes (dans la plupart de leurs modèles, à l'exception du segment low-end) peuvent fonctionner à la fois comme des dispositifs de blocs et comme des dispositifs de fichiers. Le niveau du système détermine les fonctionnalités prises en charge, et pour les modèles inférieurs, celles-ci sont généralement réduites au minimum. Il est important de prêter attention à cela lorsque vous étudiez les caractéristiques d'un modèle spécifique, plutôt que de vous baser uniquement sur les capacités de l'ensemble de la gamme. De plus, le niveau du système impacte également ses caractéristiques techniques, telles que le processeur, la mémoire, la taille du cache, le nombre et les types de ports, etc. En ce qui concerne la gestion, les AFA se distinguent uniquement des systèmes hybrides (à disque) en ce qui concerne la mise en œuvre des mécanismes de travail avec les SSD, et même si vous utilisez des SSD dans un système hybride, cela ne signifie pas que vous obtiendrez un niveau de performance équivalent à celui d'un système AFA. Dans de nombreux cas, les mécanismes de stockage efficaces en ligne dans les systèmes hybrides sont désactivés, et leur activation entraîne une perte de performance.
Systèmes de stockage spécialisés
En plus des systèmes de stockage généralistes, axés principalement sur le traitement opérationnel des données, il existe des systèmes de stockage spécialisés avec des principes clés fondamentalement différents de ceux habituels (faible latence, nombreux IOPS) :
Média.
Ces systèmes sont conçus pour le stockage et le traitement de fichiers multimédias, qui se distinguent par leur grande taille. La latence devient pratiquement insignifiante, tandis que la capacité à transférer et recevoir des données à large bande en plusieurs flux parallèles prend le devant.
Systèmes de stockage dédupliqués pour sauvegardes.
Puisque les sauvegardes diffèrent rarement dans des conditions normales (en moyenne, une sauvegarde varie de 1 à 2 % par rapport à celle d'hier), cette classe de systèmes emballe extrêmement efficacement les données enregistrées sur un nombre relativement restreint de supports physiques. Par exemple, dans certains cas, les coefficients de compression des données peuvent atteindre 200 pour 1.
Systèmes de stockage objet.
Ces SDC n'ont pas les volumes familiers avec accès en bloc et les partages de fichiers, mais ressemblent plutôt à une énorme base de données. L'accès à un objet stocké dans un tel système se fait par un identifiant unique ou par des métadonnées (par exemple, tous les objets au format JPEG, avec une date de création entre XX-XX-XXXX et YY-YY-YYYY).
Systèmes de conformité.
Ils sont encore assez rares en Russie aujourd'hui, mais il convient de les mentionner. La fonction de ces SDC est de garantir le stockage des données pour se conformer aux politiques de sécurité ou aux exigences des régulateurs. Dans certains systèmes (comme EMC Centera), une fonctionnalité d'interdiction de suppression des données a été mise en œuvre : une fois la clé tournée et le système passé dans ce mode, ni l'administrateur ni quiconque d'autre ne peut physiquement supprimer les données déjà enregistrées.
Technologies propriétaires
Cache Flash
Le Cache Flash est un terme général pour toutes les technologies propriétaires utilisant la mémoire flash comme cache de deuxième niveau. En utilisant le cache flash, les SDC sont généralement calculés pour gérer la charge établie des disques magnétiques, tandis que la charge de pointe est gérée par le cache.
Il est également nécessaire de comprendre le profil de charge et le degré de localisation des accès aux blocs des volumes de stockage. Le cache flash est une technologie pour les charges avec une haute localisation des requêtes, et pratiquement inapplicable pour les volumes avec une charge uniforme (comme par exemple pour les systèmes d'analyse).
Il existe deux implementations de cache flash sur le marché :
- Lecture seule. Dans ce cas, seules les données en lecture sont mises en cache, et l'écriture se fait directement sur les disques. Certains fabricants, comme NetApp, estiment que l'écriture sur leurs SDC se fait déjà de manière optimale et que le cache n'apporte aucune aide.
- Lecture/écriture. Non seulement la lecture, mais aussi l'écriture est mise en cache, ce qui permet de tamponner le flux et de réduire l'impact de la pénalité RAID, et par conséquent d'augmenter la performance globale des SDC avec un mécanisme d'écriture moins optimal.
Tiering
Le stockage multi-niveaux (tiering) est une technologie qui regroupe en un seul pool de disques des niveaux de performances différents, comme les SSD et les HDD. En cas de fortes disparités dans les accès aux blocs de données, le système sera capable de rééquilibrer automatiquement les blocs de données, déplaçant les chargés vers un niveau de haute performance, et les froids, au contraire, vers un niveau plus lent.
Les systèmes hybrides de classe inférieure et intermédiaire utilisent un stockage à plusieurs niveaux avec un déplacement des données entre les niveaux selon un calendrier. Dans ce cas, la taille de bloc de stockage à plusieurs niveaux des meilleurs modèles atteint 256 Mo. Ces caractéristiques ne permettent pas de considérer la technologie de stockage à plusieurs niveaux comme une technologie d'amélioration des performances, comme beaucoup l'estiment à tort. Le stockage à plusieurs niveaux dans les systèmes de classe inférieure et intermédiaire est une technologie d'optimisation des coûts de stockage pour des systèmes présentant une charge inégale.
Instantané
Peu importe combien nous parlons de la fiabilité des systèmes de stockage, il existe de nombreuses possibilités de perdre des données qui ne dépendent pas de problèmes matériels. Cela peut être dû à des virus, des hackers ou toute autre suppression/altération involontaire des données. Pour cette raison, la sauvegarde des données opérationnelles est une partie intégrante du travail d'un ingénieur.
Un instantané est une photo d'un volume à un moment donné. Lors de l'utilisation de la plupart des systèmes, tels que la virtualisation, les bases de données, etc., nous devons capturer un tel instantané à partir duquel nous copierons les données dans une sauvegarde, tout en permettant à nos systèmes d'information de continuer à travailler avec ce volume. Mais il faut se rappeler que tous les instantanés ne sont pas également utiles. Les différentes vendors ont des approches différentes pour créer des instantanés, liées à leur architecture.
CoW (Copy-On-Write). Lorsqu'une tentative d'écriture sur un bloc de données est effectuée, son contenu d'origine est copié dans une zone spéciale, après quoi l'écriture se fait normalement. Cela empêche ainsi d'endommager les données dans l'instantané. Naturellement, toutes ces manipulations "parasitaires" des données entraînent une charge supplémentaire sur le système de stockage, et pour cette raison, les fournisseurs avec une telle réalisation ne recommandent pas d'utiliser plus d'une dizaine d'instantanés, et de ne pas les utiliser du tout sur des volumes à forte charge.
RoW (Redirect-on-Write). Dans ce cas, le volume original est naturellement gelé, et lors d'une tentative d'écriture sur un bloc de données, le système de stockage écrit les données dans une zone spéciale de l'espace libre, modifiant l'emplacement de ce bloc dans la table de métadonnées. Cela permet de réduire le nombre d'opérations de réécriture, ce qui finit par atténuer la baisse de performance et lève les limitations sur les instantanés et leur nombre.
Les instantanés peuvent également être de deux types en ce qui concerne les applications :
Consistance d'application. Au moment de la création de l'instantané, le stockage à réseau (SNC) interroge un agent dans le système d'exploitation du consommateur, qui force la vidange des caches disque de la mémoire vers le disque et oblige l'application à le faire. Dans ce cas, lors de la restauration à partir de l'instantané, les données seront cohérentes.
Consistance en cas de crash. Dans ce cas, rien de tel ne se produit et l'instantané est créé tel quel. Lors de la restauration à partir d'un tel instantané, la situation est identique à celle d'une coupure de courant soudaine et il est possible qu'il y ait une certaine perte de données qui restaient en cache et n'avaient pas encore été écrites sur le disque. Ces instantanés sont plus simples à mettre en œuvre et ne provoquent pas de baisse de performance dans les applications, mais sont moins fiables.
Pourquoi les instantanés sont-ils nécessaires dans les systèmes de stockage de données ?
- Sauvegarde sans agent directement à partir du SNC
- Création d'environnements de test basés sur des données réelles
- Dans le cas de SNC de fichiers, cela peut être utilisé pour créer des environnements VDI en utilisant des instantanés de SNC au lieu d'hyperviseurs
- Assurer de faibles RPO en créant des instantanés selon un calendrier avec une fréquence nettement supérieure à celle des sauvegardes
Clonage
Le clonage de volume fonctionne sur un principe similaire à celui des instantanés, mais sert non seulement à lire des données, mais aussi à travailler pleinement avec elles. Nous avons la possibilité d'obtenir une copie exacte de notre volume, avec toutes ses données, sans faire de copie physique, ce qui permet d'économiser de l'espace. Généralement, le clonage de volumes est utilisé soit dans le cadre de Test & Dev soit si vous souhaitez tester le fonctionnement de certaines mises à jour sur votre système d'information. Le clonage permettra de le faire aussi rapidement et économiquement que possible du point de vue des ressources disque, car seules les blocs de données modifiés seront écrits.
Réplique / journalisation
La réplication est un mécanisme de création d'une copie des données sur un autre SNC physique. En général, chaque fournisseur dispose de sa propre technologie qui ne fonctionne qu'à l'intérieur de sa propre gamme. Mais il existe également des solutions tierces, y compris celles qui fonctionnent au niveau de l'hyperviseur, comme par exemple la réplication VMware vSphere.
La fonctionnalité des technologies propriétaires et la facilité de leur utilisation dépassent généralement de loin celles des solutions universelles, mais elles ne s'appliquent pas lorsque, par exemple, il est nécessaire de faire une réplication de NetApp sur HP MSA.
La réplication se divise en deux sous-catégories :
Synchronisée. Dans le cas de la réplication synchronisée, l'opération d'écriture est immédiatement transmise au second système de stockage et n'est pas confirmée tant que le système de stockage distant n'a pas donné son accord. Cela augmente la latence d'accès, mais nous avons une copie miroir exacte des données. Autrement dit, RPO = 0 en cas de perte du système de stockage principal.
Asynchrone. Les opérations d'écriture sont exécutées uniquement sur le système de stockage principal et sont confirmées immédiatement, tout en étant stockées dans un tampon pour un transfert par lots vers le système de stockage distant. Ce type de réplication est pertinent pour des données moins critiques, ou pour des canaux à faible débit ou à latence élevée (caractéristique des distances supérieures à 100 km). Ainsi, RPO est égal à la fréquence des envois par lots.
Souvent, en plus de la réplication, il existe un mécanisme de journalisation des opérations disque. Dans ce cas, une zone spéciale est dédiée à la journalisation et les opérations d'écriture sont conservées à une certaine profondeur dans le temps, ou limitées par la taille du journal. Pour certaines technologies propriétaires, comme EMC RecoverPoint, il existe une intégration avec le logiciel système, permettant de lier certains marqueurs à des enregistrements spécifiques dans le journal. Grâce à cela, il est possible de restaurer l'état d'un volume (ou de créer un clone) non pas simplement au 23 avril à 11 heures 59 minutes 13 millisecondes, mais à un moment précédant le "DROP ALL TABLES; COMMIT".
Metro cluster
Le metro cluster est une technologie qui permet de créer une réplication synchrone bidirectionnelle entre deux systèmes de stockage, de sorte que cette paire apparaît comme un seul système de stockage. Elle est utilisée pour créer des clusters avec des bras géographiquement séparés sur des distances de métro (moins de 100 km).
Par exemple, dans un environnement de virtualisation, le metro cluster permet de créer un datastore avec des machines virtuelles, accessible en écriture immédiatement depuis deux centres de données. Dans ce cas, un cluster est créé au niveau des hyperviseurs, composé d'hôtes situés dans différents centres de données physiques, connectés à ce datastore. Cela permet de réaliser ce qui suit :
- Automatisation complète du processus de récupération après la défaillance d'un des centres de données. Sans aucun moyen supplémentaire, toutes les VM fonctionnant dans le centre de données défaillant seront automatiquement redémarrées dans celui restant. RTO = délai d'expiration du cluster de haute disponibilité (15 secondes pour VMware) + temps de démarrage du système d'exploitation et lancement des services.
- Évitement des catastrophes. Si des travaux d'alimentation sont prévus dans le centre de données 1, nous avons la possibilité de migrer toute la charge importante vers le centre de données 2 sans interruption avant le début des travaux.
Virtualisation
La virtualisation des systèmes de stockage est techniquement l'utilisation de volumes d'un autre système de stockage en tant que disques. Un virtualiseur de système de stockage peut simplement rediriger un volume d'un tiers vers le consommateur comme s'il était le sien, tout en le miroirant sur un autre système de stockage ou même en créant un RAID à partir de volumes externes.
Les représentants classiques de la virtualisation des systèmes de stockage sont EMC VPLEX et IBM SVC. Évidemment, les systèmes de stockage avec des fonctions de virtualisation tels que NetApp, Hitachi, IBM / Lenovo Storwize.
Pourquoi cela peut-il être nécessaire?
- Miroitage au niveau du système de stockage. Un miroir est créé entre des volumes, dont une moitié peut être sur HP 3Par et l'autre sur NetApp, avec un virtualiseur d'EMC.
- Migration des données avec un temps d'arrêt minimal entre des systèmes de stockage de différents fabricants. Supposons que les données doivent être migrées d'un ancien 3Par, qui sera mis hors service, vers un nouveau Dell. Dans ce cas, les consommateurs sont déconnectés du 3Par, et les volumes sont redirigés sous VPLEX et présentés aux consommateurs de nouveau. Étant donné qu'aucun bit sur le volume n'a été modifié, l'activité se poursuit. En arrière-plan, le processus de miroir des volumes sur le nouveau Dell commence, et une fois terminé, le miroir est divisé et le 3Par est déconnecté.
- Organisation de métropullules.
Compression / déduplication.
La compression et la déduplication sont des technologies qui vous permettent d'économiser de l'espace disque sur votre système de stockage. Il convient de mentionner tout de suite que toutes les données ne peuvent pas être compressées et/ou dédupliquées en général, certaines d'entre elles se compressent et se dédupliquent mieux que d'autres.
La compression et la déduplication sont de deux types:
Inline La compression et la déduplication des blocs de données se produisent avant l'écriture de ces données sur le disque. Ainsi, le système ne calcule que le hachage du bloc et le compare à la table déjà existante. D'une part, cela s'effectue plus rapidement que de simplement écrire sur le disque, d'autre part, nous ne gaspillons pas d'espace disque supplémentaire.
Post Lorsque ces opérations sont effectuées sur des données déjà enregistrées sur les disques. Par conséquent, les données sont d'abord écrites sur le disque, puis le hachage est calculé et les blocs superflus sont supprimés, libérant ainsi des ressources disque.
Il convient de mentionner que la plupart des vendeurs utilisent les deux types, ce qui permet d'optimiser ces processus et donc d'augmenter leur efficacité. La plupart des vendeurs de systèmes de stockage disposent d'utilitaires qui permettent d'analyser vos jeux de données. Ces utilitaires fonctionnent selon la même logique que celle mise en œuvre dans les systèmes de stockage, de sorte que le niveau d'efficacité estimé sera le même. Il ne faut pas non plus oublier que de nombreux vendeurs proposent des programmes de garantie d'efficacité, qui promettent un niveau d'efficacité au moins égal à celui annoncé pour un type de données donné (ou tous). Et il ne faut pas négliger ce programme, car en adaptant le système à vos besoins, en tenant compte du coefficient d'efficacité du système en question, vous pouvez économiser sur le volume. Il convient également de noter que ces programmes sont conçus pour les systèmes AFA, mais grâce à l'achat d'un volume moindre de SSD par rapport aux HDD dans les systèmes classiques, cela permettra de réduire leur coût, et même si cela ne parvient pas à égaler le coût du système de disque, cela s'en rapprochera considérablement.
Modèle
Et c'est ici que nous arrivons à la question bien posée.
« On me propose deux options de systèmes de stockage — ABC SuperStorage S600 et XYZ HyperOcean 666v4, que recommandez-vous ? »
Se transforme en « On me propose deux options de systèmes de stockage — ABC SuperStorage S600 et XYZ HyperOcean 666v4, que recommandez-vous ? »
Charge cible pour des machines virtuelles VMware mixtes avec des environnements de production / test / développement. Test = production. 150 To pour chacun avec une performance de pointe de 80 000 IOPS sur des blocs de 8 Ko avec 50 % d'accès aléatoire, 80/20 lecture-écriture. 300 To pour le développement, 50 000 IOPS suffisent, 80 % aléatoire, 80 % écriture.
Production supposée dans un métro-cluster RPO = 15 minutes RTO = 1 heure, développement en réplication asynchrone RPO = 3 heures, test sur un seul site.
Il y aura 50 To de SGBD, ce serait bien d'avoir une journalisation pour eux.
Nous avons des serveurs Dell partout, des systèmes de stockage Hitachi anciens qui peinent à suivre, nous planifions une augmentation de 50 % de la charge en volume et en performance.
Comme on dit, dans une question bien formulée se trouve 80 % de la réponse.
Informations supplémentaires
Qu'est-ce qu'il vaut la peine d'explorer en plus selon les auteurs.
Livres
- Olivier et Olivier 'Réseaux Informatiques'. Ce livre aidera à systématiser et peut-être mieux comprendre comment fonctionne l'environnement de transmission de données pour les systèmes de stockage IP / Ethernet.
- 'EMC Information Storage and Management'. Un excellent livre sur les bases des systèmes de stockage, pourquoi, comment et pourquoi.
Forums et discussions
Recommandations générales
Prix
Maintenant, en ce qui concerne les prix — généralement pour les systèmes de stockage, s'il y a des prix, ce sont souvent des prix de liste, à partir desquels chaque client obtient une remise individuelle. Le montant de la remise dépend de nombreux paramètres, il est donc impossible de prédire le prix final que votre entreprise obtiendra sans demande auprès du distributeur. Cependant, dernièrement, des modèles bas de gamme ont commencé à apparaître dans des magasins d'informatique ordinaires, tels que ou . Vous pouvez y acheter immédiatement le système qui vous intéresse à un prix fixe, comme n'importe quel composant informatique.
Mais il convient de noter immédiatement que la comparaison directe en TB/$ n'est pas correcte. Si l'on aborde cela de cette manière, la solution la moins chère serait un simple JBOD + serveur, qui ne donnera ni la flexibilité ni la fiabilité qu'offre un système de stockage complet à deux contrôleurs. Cela ne signifie surtout pas que le JBOD est quelque chose de mauvais, il faut encore une fois très bien comprendre comment et à quelles fins vous allez utiliser cette solution. On entend souvent dire que dans un JBOD, il n'y a rien de cassé, car il y a un seul backplane. Cependant, même les backplanes peuvent tomber en panne. Tout casse tôt ou tard.
Au total
Comparer les systèmes entre eux ne doit pas se faire uniquement sur le prix, ou uniquement sur la performance, mais sur l'ensemble de tous les indicateurs.
Achetez des disques durs uniquement si vous êtes sûr d’en avoir besoin. Pour les charges légères et les types de données non compressibles, il est préférable de se tourner vers des solutions de garantie d'efficacité du stockage sur SSD, qui sont désormais proposées par la majorité des fournisseurs (et elles fonctionnent réellement, même en Russie), mais cela dépend des applications et des données qui seront stockées sur ce système de stockage.
Ne recherchez pas la moindre dépense. Parfois, cela cache de nombreux problèmes, dont Eugène Elizarov a parlé dans ses articles sur . Et au final, cette économie peut vous coûter cher. N'oubliez pas : « l'avare paie deux fois ».
Source : habr.com
