

Plateforme permet d'industrialiser la création , y compris dans l'infrastructure des fournisseurs de services cloud, sur des plateformes de virtualisation ou dans des systèmes bare-metal. Pour créer une véritable plateforme cloud, nous avons dû prendre sous un contrôle strict tous les éléments utilisés, augmentant ainsi la fiabilité de ce processus complexe d'automatisation.
La solution évidente a été d'utiliser Red Hat Enterprise Linux CoreOS (une variante de Red Hat Enterprise Linux) et CRI-O comme standard, et voici pourquoi…
Étant donné que le thème de la navigation est un bon moyen de trouver des analogies pour expliquer le fonctionnement de Kubernetes et des conteneurs, essayons d’expliquer les problèmes commerciaux que résolvent CoreOS et CRI-O à travers l'exemple . En 1803, Marc Brunel avait pour mission de produire 100 000 blocs de gréement pour les besoins de la flotte maritime croissante du Royaume-Uni. Un bloc de gréement est un type d'accessoire utilisé pour attacher des cordes aux voiles. Jusqu'au début du 19ème siècle, ces blocs étaient fabriqués à la main, mais Brunel a réussi à automatiser la production et à commencer à fabriquer des blocs standardisés à l'aide de machines. L'automatisation de ce processus signifiait que tous les blocs obtenus étaient pratiquement identiques, pouvaient être facilement remplacés en cas de défaillance et pouvaient être fabriqués en grande quantité.
Et maintenant, imaginez que Brunel aurait dû réaliser ce travail pour 20 modèles de navires différents (versions de Kubernetes) et pour cinq planètes différentes avec des courants marins et des vents totalement différents (fournisseurs cloud). De plus, il était nécessaire que tous les navires (clusters OpenShift), indépendamment des planètes sur lesquelles ils naviguent, se comportent de manière uniforme aux yeux des capitaines (opérateurs gérant le fonctionnement des clusters). Pour rester dans l'analogie maritime, les capitaines des navires ne se soucient absolument pas des blocs de gréement (CRI-O) utilisés sur leurs navires – pour eux, le plus important est que ces blocs soient solides et fiables.
Avant OpenShift 4, une tâche commerciale très similaire se pose avec la plateforme cloud. De nouveaux nœuds doivent être créés lors de la création du cluster, en cas de défaillance d'un des nœuds ou lors de l'extension du cluster. Lors de la création et de l'initialisation d'un nouveau nœud, les composants critiques de l'hôte, y compris CRI-O, doivent être configurés en conséquence. Comme dans toute autre production, il est d'abord nécessaire de fournir la "matière première". Dans le cas des navires, le métal et le bois font office de matière première. Cependant, pour créer un hôte pour le déploiement de conteneurs dans le cluster OpenShift 4, il faut disposer de fichiers de configuration et des serveurs API fournis. Par la suite, OpenShift assurera le niveau d'automatisation nécessaire tout au long du cycle de vie, offrant le support produit nécessaire pour les utilisateurs finaux et rentabilisant ainsi les investissements dans la plateforme.
OpenShift 4 a été conçu de manière à garantir la possibilité de mettre à jour facilement le système tout au long du cycle de vie de la plateforme (pour les versions 4.X) pour tous les principaux fournisseurs de cloud computing, les plateformes de virtualisation et même les systèmes bare metal. Pour cela, les nœuds doivent être créés sur la base d'éléments interchangeables. Lorsque le cluster nécessite une nouvelle version de Kubernetes, il reçoit également la version correspondante de CRI-O sur CoreOS. Comme la version de CRI-O est directement liée à Kubernetes, tout cela simplifie largement toute réorganisation visant à tester, dépanner ou supporter. De plus, cette approche permet de réduire les coûts pour les utilisateurs finaux et Red Hat.
C'est une perspective fondamentalement nouvelle sur les clusters Kubernetes, qui établit une base pour la planification de nouvelles fonctionnalités très utiles et attrayantes. CRI-O (projet de l'interface de runtime de conteneur ouverte — Open Container Initiative, abrégé CRI-OCI) s'est révélé être le choix idéal pour la création à grande échelle de nœuds, qui est nécessaire pour travailler avec OpenShift. CRI-O remplacera le moteur Docker utilisé auparavant, en offrant aux utilisateurs d'OpenShift – oui, vous ne rêvez pas – un moteur de conteneurs ennuyeux, conçu spécialement pour fonctionner avec Kubernetes.
Le monde des conteneurs ouverts
Le monde se dirige depuis longtemps vers des conteneurs ouverts. Que ce soit dans Kubernetes ou à des niveaux plus bas, entraîne la création d'un écosystème d'innovations à chaque niveau.
Tout a commencé par la création de l'initiative Open Containers Initiative À ce stade précoce, des spécifications pour les images de conteneurs et ont été élaborées. Cela a permis de garantir que les outils peuvent utiliser une norme unique et un format unique pour les manipuler. Plus tard, des spécifications ont été ajoutées, ce qui a facilité l'échange entre utilisateurs d'images de conteneurs. .
Container Runtime Interface (CRI) Les ingénieurs de Red Hat et Google ont identifié un besoin sur le marché pour un moteur de conteneurs capable de traiter les requêtes de Kubelet via le protocole CRI et ont présenté des conteneurs compatibles avec les spécifications OCI mentionnées ci-dessus. Ainsi,
OCID est né. la version 1.0, Innovations avec CRI-O et CoreOS
Fig. 1.
Avec le lancement de la plateforme OpenShift 4, le moteur de conteneurs
utilisé par défaut sur la plateforme a été modifié, et CRI-O a remplacé Docker, offrant un environnement économique, stable, simple et monotone pour lancer des conteneurs qui évolue parallèlement à Kubernetes. Cela simplifie considérablement la gestion et la configuration des clusters. La configuration du moteur de conteneurs et de l'hôte, ainsi que leur gestion deviennent automatisées dans le cadre d'OpenShift 4. C'est exactement ça, avec l'arrivée d'OpenShift 4, il n'est plus nécessaire de se connecter à des hôtes séparés et d'installer le moteur de conteneurs, de configurer le stockage, de paramétrer des serveurs pour la recherche ou de configurer le réseau. La plateforme OpenShift 4 a été entièrement repensée pour utiliser le
Attendez, comment ça ?
Oui, c'est ça ! Avec l'arrivée d'OpenShift 4, il n'est plus nécessaire de se connecter à des hôtes séparés, d'installer un moteur de conteneurs, de configurer le stockage, d'ajuster les serveurs pour la recherche ou de configurer le réseau. La plateforme OpenShift 4 a été complètement refaite pour utiliser le non seulement du point de vue des applications des utilisateurs finaux, mais aussi du point de vue des opérations de base au niveau de la plate-forme, telles que le déploiement d'images, la configuration du système ou l'installation de mises à jour.
Kubernetes a toujours permis aux utilisateurs de gérer des applications en définissant l'état souhaité et en utilisant , afin de garantir que l'état réel correspond au mieux à l'état défini. Cette ouvre de grandes opportunités tant du point de vue du développement que des opérations. Les développeurs peuvent définir l'état requis, à l'opérateur sous forme de fichier YAML ou JSON, puis l'opérateur peut créer dans l'environnement d'exploitation l'instance d'application nécessaire, l'état de fonctionnement de cette instance étant entièrement conforme à l'état défini.
En utilisant des opérateurs (Operators) sur la plate-forme, OpenShift 4 introduit cette nouvelle paradigme (en utilisant le concept d'état souhaité et d'état réel) dans la gestion de RHEL CoreOS et de CRI-O. Les tâches de configuration et de gestion des versions du système d'exploitation et du moteur de conteneurs sont automatisées à l'aide du . Le MCO simplifie considérablement le travail de l'administrateur de cluster, automatisant en effet les dernières étapes de l'installation, ainsi que les opérations post-installation (day two operations). Tout cela fait d'OpenShift 4 une véritable plate-forme cloud. Nous reviendrons sur cet aspect un peu plus tard.
Lancement de conteneurs
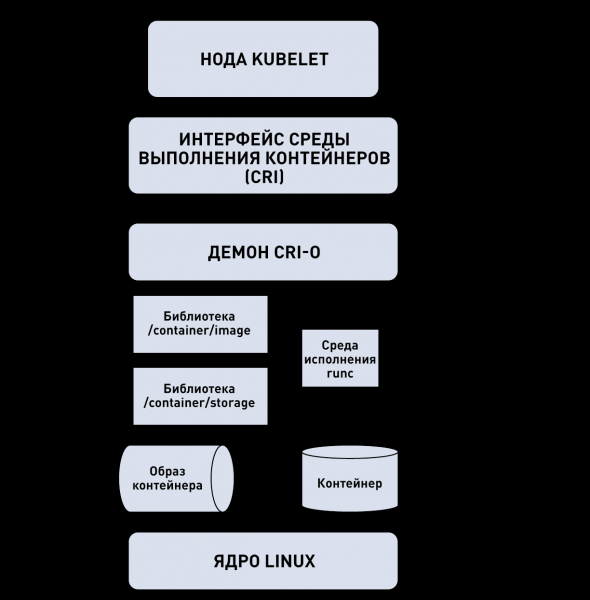
Les utilisateurs ont pu utiliser le moteur CRI-O sur la plate-forme OpenShift à partir de la version 3.7 en statut Tech Preview et à partir de la version 3.9 en statut Generally Available (actuellement pris en charge). De plus, Red Hat utilise massivement sur OpenShift Online à partir de la version 3.10. Tout cela a permis à l'équipe travaillant sur CRI-O d'acquérir une énorme expérience dans le lancement massif de conteneurs sur de grands clusters Kubernetes. Pour obtenir une compréhension de base de la manière dont Kubernetes utilise CRI-O, examinons l'illustration suivante qui montre le principe de fonctionnement de l'architecture.
Fig. 2. Comment fonctionnent les conteneurs dans un cluster Kubernetes
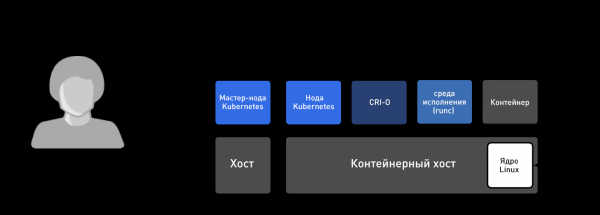
CRI-O simplifie la création de nouveaux hôtes de conteneurs en synchronisant l'intégralité du niveau supérieur lors de l'initialisation de nouveaux nœuds, ainsi qu'au moment du déploiement des nouvelles versions de la plateforme OpenShift. La révision de l'ensemble de la plateforme permet d'effectuer des mises à jour / retours transactionnels, tout en évitant les blocages mutuels dans les dépendances entre le noyau de l'hôte de conteneurs, le moteur de conteneurs, les nœuds (Kubelets) et le nœud maître Kubernetes. Avec une gestion centralisée de tous les composants de la plateforme, le contrôle et la gestion des versions permettent toujours de suivre un chemin clair de l'état A à l'état B. Cela simplifie le processus de mise à jour, renforce la sécurité, améliore la tenue des rapports de performance et contribue à réduire les coûts de mise à jour et d'installation des nouvelles versions.
Démonstration de la puissance des éléments interchangeables
Comme mentionné précédemment, l'utilisation de Machine Config Operator pour gérer l'hôte de conteneur et le moteur de conteneurs dans OpenShift 4 offre un nouveau niveau d'automatisation qui n'était pas possible sur la plateforme Kubernetes auparavant. Pour démontrer ces nouvelles capacités, nous allons montrer comment vous pourriez apporter des modifications au fichier crio.conf. Pour ne pas vous perdre dans la terminologie, essayez de vous concentrer sur les résultats.
Tout d'abord, créons ce qu'on appelle la configuration de l'environnement d'exécution des conteneurs – Container Runtime Config. Considérez cela comme une ressource Kubernetes qui représente la configuration pour CRI-O. En réalité, c'est une version spécialisée de ce qu'on appelle MachineConfig, qui représente toute configuration déployée sur une machine RHEL CoreOS dans le cadre d'un cluster OpenShift.
Cette ressource personnalisée, appelée ContainerRuntimeConfig, a été conçue pour faciliter la tâche des administrateurs de cluster dans la configuration de CRI-O. C'est un outil suffisamment puissant pour être appliqué uniquement à certains nœuds selon les paramètres MachineConfigPool. Considérez cela comme un groupe de machines qui servent le même objectif.
Faites attention aux deux dernières lignes que nous allons modifier dans le fichier /etc/crio/crio.conf. Ces deux lignes sont très similaires aux lignes du fichier crio.conf, ce sont :
vi ContainerRuntimeConfig.yaml
Conclusion :
apiVersion: machineconfiguration.openshift.io/v1
kind: ContainerRuntimeConfig
metadata:
 name: set-log-and-pid
spec:
 machineConfigPoolSelector:
   matchLabels:
     debug-crio: config-log-and-pid
 containerRuntimeConfig:
   pidsLimit: 2048
   logLevel: debug
Nous allons maintenant envoyer ce fichier au cluster Kubernetes et vérifier qu'il a bien été créé. Notez que le processus se déroule exactement comme pour toute autre ressource Kubernetes :
oc create -f ContainerRuntimeConfig.yaml
oc get ContainerRuntimeConfig
Conclusion :
NOM              ÂGE
set-log-and-pid   22h
Après avoir créé le ContainerRuntimeConfig, nous devons modifier l'un des MachineConfigPools pour signaler à Kubernetes que nous souhaitons appliquer cette configuration à un groupe spécifique de machines dans le cluster. Dans ce cas, nous allons modifier le MachineConfigPool pour les nœuds maîtres :
oc edit MachineConfigPool/master
Sortie (le fond principal est conservé pour plus de clarté) :
...
metadata:
 creationTimestamp: 2019-04-10T23:42:28Z
 generation: 1
 labels:
   debug-crio: config-log-and-pid
   operator.machineconfiguration.openshift.io/required-for-upgrade: ""
...
À ce moment, MCO commence à créer un nouveau fichier crio.conf pour le cluster. Le fichier de configuration complet peut être consulté via l'API Kubernetes. Rappelez-vous, le ContainerRuntimeConfig n'est qu'une version spécialisée de MachineConfig, donc nous pouvons voir le résultat en consultant les lignes nécessaires dans les MachineConfigs :
oc get MachineConfigs | grep rendered
Conclusion :
rendered-master-c923f24f01a0e38c77a05acfd631910b                  4.0.22-201904011459-dirty 2.2.0 16h
rendered-master-f722b027a98ac5b8e0b41d71e992f626                  4.0.22-201904011459-dirty 2.2.0 4m
rendered-worker-9777325797fe7e74c3f2dd11d359bc62                  4.0.22-201904011459-dirty 2.2.0 16h
Notez que le fichier de configurations obtenu pour les nœuds maîtres est une version plus récente que les configurations d'origine. Pour le visualiser, exécutez la commande suivante. En passant, nous notons que c'est peut-être l'un des meilleurs scripts d'une seule ligne de l'histoire de Kubernetes :
python3 -c "import sys, urllib.parse; print(urllib.parse.unquote(sys.argv[1]))" $(oc get MachineConfig/rendered-master-f722b027a98ac5b8e0b41d71e992f626 -o YAML | grep -B4 crio.conf | grep source | tail -n 1 | cut -d, -f2) | grep pid
Conclusion :
pids_limit = 2048
Nous allons maintenant nous assurer que la configuration a été appliquée à tous les nœuds maîtres. Commençons par obtenir la liste des nœuds dans le cluster :
oc get node | grep master

Sortie :

ip-10-0-135-153.us-east-2.compute.internal   Prêt maître 23h v1.12.4+509916ce1

ip-10-0-154-0.us-east-2.compute.internal     Prêt maître 23h v1.12.4+509916ce1

ip-10-0-166-79.us-east-2.compute.internal    Prêt maître 23h v1.12.4+509916ce1
Examinons maintenant le fichier installé. Vous verrez que le fichier a été mis à jour avec les nouvelles valeurs des directives pid et debug que nous avons spécifiées dans la ressource ContainerRuntimeConfig. C'est là toute l'élégance :
oc debug node/ip-10-0-135-153.us-east-2.compute.internal — cat /host/etc/crio/crio.conf | egrep 'debug||pid'
Conclusion :
...
pids_limit = 2048
...
log_level = "debug"
...
Tous ces changements dans le cluster ont été réalisés sans démarrer SSH. Tout le travail a été effectué en s'adressant au nœud maître de Kubernetes. Cela signifie que ces nouveaux paramètres ont été configurés uniquement sur les nœuds maîtres. Les nœuds de travail, quant à eux, n'ont pas été modifiés, ce qui démontre les avantages de la méthodologie Kubernetes en utilisant des états désirés et actuels en ce qui concerne les hôtes de conteneurs et les moteurs de conteneurs avec des éléments interchangeables.
L'exemple ci-dessus montre la possibilité d'apporter des modifications dans un petit cluster OpenShift Container Platform 4 avec trois nœuds de travail ou dans un énorme cluster de production avec 3000 nœuds. Dans tous les cas, l'ampleur des travaux sera la même – et très limitée – il suffit de configurer le fichier ContainerRuntimeConfig et de modifier une étiquette dans MachineConfigPool. Et vous pouvez faire cela avec n'importe quelle version de la plateforme Kubernetes OpenShift Container Platform 4.X tout au long de son cycle de vie.
Souvent, les entreprises technologiques se développent si rapidement que nous ne pouvons pas expliquer pourquoi nous choisissons certaines technologies pour les composants fondamentaux. Les moteurs de conteneurs ont historiquement été le composant avec lequel les utilisateurs interagissent directement. Étant donné que la popularité des conteneurs a logiquement commencé avec l'émergence des moteurs de conteneurs, les utilisateurs montrent souvent de l'intérêt pour eux. C'est une autre raison pour laquelle Red Hat a choisi CRI-O. Les conteneurs évoluent, et aujourd'hui, l'accent est mis sur l'orchestration, et nous en sommes venus à la conclusion que CRI-O offre la meilleure expérience avec OpenShift 4.
Source : habr.com
