

De plus en plus de clients demandent : « Nous voulons quelque chose comme Amazon RDS, mais moins cher » ; « Nous voulons quelque chose comme RDS, mais partout, dans n'importe quelle infrastructure ». Pour réaliser une telle solution gérée sur Kubernetes, nous avons examiné l'état actuel des opérateurs les plus populaires pour PostgreSQL (Stolon, opérateurs de Crunchy Data et Zalando) et avons fait notre choix.
Cet article est le fruit de notre expérience, à la fois d'un point de vue théorique (aperçu des solutions) et pratique (ce qui a été choisi et ce qui en est résulté). Mais d'abord, déterminons quelles sont les exigences qui s'appliquent à un éventuel remplacement de RDS…
Qu'est-ce que RDS ?
Lorsque les gens parlent de RDS, de notre expérience, ils font référence à un service géré (managed) de SGBD qui :
- est facilement configurable ;
- permet le travail avec des snapshots et de se restaurer à partir d'eux (idéalement — avec le support de );
- permet de créer des topologies master-esclaves ;
- dispose d'une riche liste d'extensions ;
- offre des fonctionnalités d'audit et de gestion des utilisateurs / des accès.
En général, les approches pour réaliser la tâche formulée peuvent être très variées, cependant, la voie de l'Ansible conditionnel ne nous convient pas. (Les collègues de 2GIS ont également abouti à une conclusion similaire à la suite de leur tentative Les opérateurs — sont l'approche généralement acceptée pour résoudre de telles tâches dans l'écosystème Kubernetes. Plus de détails sur ceux-ci concernant les bases de données exécutées à l'intérieur de Kubernetes ont déjà été abordés par le directeur technique de Flant,
dans l'une de ses présentations , sur .
NB. En l'utilisant, cela peut être fait sans connaissances en Go, mais de manière plus familière pour les administrateurs systèmes : en Bash, Python, etc. Il existe plusieurs opérateurs K8s populaires pour PostgreSQL :
Stolon ;
- Opérateur PostgreSQL de Crunchy Data ;
- Opérateur Postgres de Zalando.
- Regardons-les de plus près.
Choix de l'opérateur
Au-delà des importantes capacités déjà mentionnées ci-dessus, nous — en tant qu'ingénieurs d'exploitation de l'infrastructure dans Kubernetes — attendions également des opérateurs les éléments suivants :
déploiement depuis Git et avec
- ressources personnalisées ; ;
- installation de l'affinité ou du sélecteur de nœuds ;
- installation des tolerations ;
- possibilité de tuning ;
- technologies compréhensibles et même commandes.
- des technologies compréhensibles et même des équipes.
Sans entrer dans les détails de chaque point (n'hésitez pas à poser des questions dans les commentaires si vous en avez après avoir lu l'article complet), je souhaite souligner que ces paramètres sont nécessaires pour décrire plus précisément la spécialisation des nœuds du cluster afin de les commander pour des applications spécifiques. Cela nous permet d'obtenir un équilibre optimal entre performance et coût.
Passons maintenant aux opérateurs PostgreSQL.
1. Stolon
de l'entreprise italienne Sorint.lab dans était considéré comme un certain standard parmi les opérateurs pour SGBD. C'est un projet assez ancien : sa première version publique a été publiée en novembre 2015 (!), et le dépôt GitHub peut se vanter de près de 3000 étoiles et de plus de 40 contributeurs.
Et en effet, Stolon est un excellent exemple d'une architecture bien pensée :
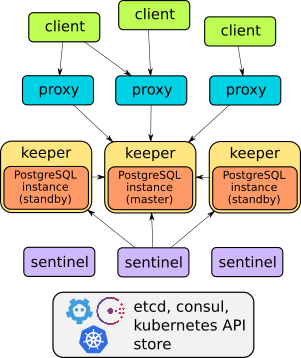
Les détails de la mise en œuvre de cet opérateur peuvent être consultés dans le rapport ou . D'une manière générale, il suffit de dire qu'il fait tout ce qui a été décrit : basculement, proxy pour l'accès transparent des clients, sauvegardes... De plus, les proxies fournissent un accès via un seul point de service — contrairement aux deux autres solutions examinées plus loin (qui ont deux services pour accéder à la base).
Cependant, Stolon , ce qui empêche de le déployer simplement et rapidement — «comme des petits pains» — pour créer des instances de SGBD dans Kubernetes. La gestion se fait via l'outil stolonctl, le déploiement via un chart Helm, et les personnalisations sont définies dans ConfigMap.
D'une part, on pourrait dire que l'opérateur n'est pas vraiment un opérateur (puisqu'il n'utilise pas de CRD). Mais d'autre part, c'est un système flexible qui permet de configurer les ressources dans K8s comme cela vous convient.
Pour résumer, il ne nous a pas semblé optimal de créer un chart séparé pour chaque base de données. Nous avons donc commencé à chercher des alternatives.
2. Crunchy Data PostgreSQL Operator
, une jeune startup américaine, semblait être une alternative logique. Son histoire publique commence avec la première version en mars 2017 ; depuis lors, le dépôt GitHub a reçu un peu moins de 1300 étoiles et plus de 50 contributeurs. La dernière version de septembre a été testée pour fonctionner avec Kubernetes 1.15—1.18, OpenShift 3.11+ et 4.4+, GKE et VMware Enterprise PKS 1.3+.
L'architecture de Crunchy Data PostgreSQL Operator répond également aux exigences déclarées :
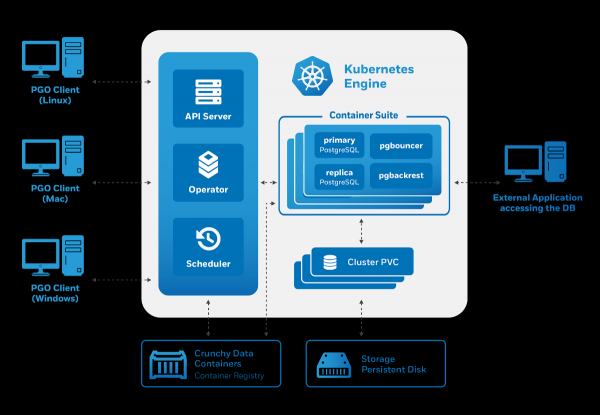
La gestion se fait via l'outil pgo, cependant, il génère des ressources personnalisées pour Kubernetes. Ainsi, nous, en tant qu'utilisateurs potentiels, avons été ravis par l'opérateur :
- la gestion via CRD ;
- une gestion pratique des utilisateurs (également via CRD) ;
- intégration avec d'autres composants — une collection spécialisée d'images de conteneurs pour PostgreSQL et les utilitaires associés (y compris pgBackRest, pgAudit, des extensions de contrib, etc.).
Cependant, les tentatives d'utilisation de l'opérateur de Crunchy Data ont révélé quelques problèmes :
- Il n'y avait pas de possibilité de tolerations — seul nodeSelector était prévu.
- Les pods créés faisaient partie d'un déploiement, même si nous déployions une application stateful. Contrairement à StatefulSet, les déploiements ne permettent pas de créer des disques.
Ce dernier inconvénient a conduit à des moments amusants : dans l'environnement de test, il a été possible de lancer 3 répliques avec un seul disque stockage local, ce qui a conduit l'opérateur à indiquer que 3 répliques fonctionnaient (bien que ce ne fût pas le cas).
Une autre caractéristique de cet opérateur est son intégration prête à l'emploi avec divers systèmes auxiliaires. Par exemple, il est facile d'installer pgAdmin et pgBounce, et des Grafana et Prometheus préconfigurés sont également envisagés. Dans la récente une meilleure intégration avec le projet , grâce à laquelle l'opérateur propose une visualisation claire des métriques PgSQL « prêtes à l'emploi ».
Néanmoins, le choix étrange des ressources Kubernetes générées nous a conduits à devoir trouver une autre solution.
3. Zalando Postgres Operator
Nous connaissons les produits Zalando depuis longtemps : nous avons de l'expérience avec Zalenium et, bien sûr, nous avons essayé — leur solution HA populaire pour PostgreSQL. L'approche de l'entreprise pour créer a été présentée par l'un de ses auteurs — Alexey Klyukin — lors du , et nous l'avons apprécié.
C'est la solution la plus jeune parmi celles examinées dans l'article : le premier lancement a eu lieu en août 2018. Cependant, malgré le nombre limité de lancements formels, le projet a parcouru un long chemin, surpassant déjà en popularité la solution de Crunchy Data avec plus de 1300 étoiles sur GitHub et le nombre maximum de contributeurs (plus de 70).
« Sous le capot », cet opérateur utilise des solutions éprouvées :
- Patroni et pour la gestion,
- — pour les sauvegardes,
- — comme pool de connexions.
Voici comment est présentée l'architecture de l'opérateur de Zalando :
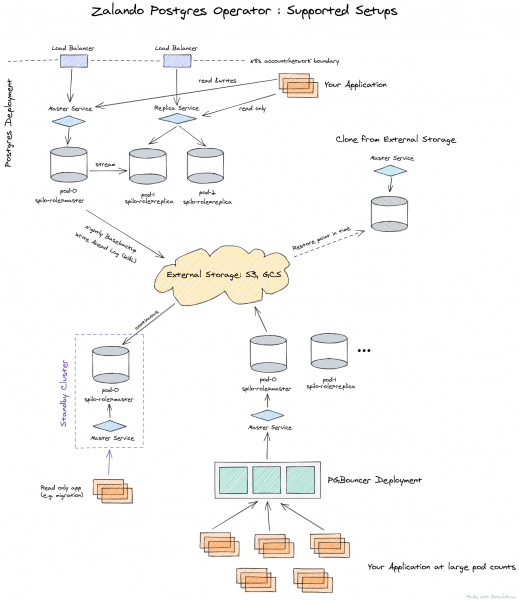
L'opérateur est entièrement géré via les Custom Resources, créant automatiquement un StatefulSet à partir de conteneurs, qui peuvent ensuite être personnalisés en ajoutant différents sidecars dans les pods. Tout cela constitue un avantage considérable par rapport à l'opérateur de Crunchy Data.
Puisque nous avons choisi la solution de Zalando parmi 3 options examinées, la description de ses fonctionnalités sera présentée ci-dessous, immédiatement avec des exemples d'application.
Pratique avec Postgres Operator de Zalando
Le déploiement de l'opérateur est très simple : il suffit de télécharger la version actuelle depuis GitHub et d'appliquer les fichiers YAML à partir du répertoire. . En variante, vous pouvez également utiliser .
Après l'installation, il convient de se préoccuper de la configuration . Cela se fait via ConfigMap postgres-operator dans l'espace de noms où vous avez installé l'opérateur. Une fois les stockages configurés, vous pouvez déployer le premier cluster PostgreSQL.
Par exemple, le déploiement standard que nous avons est le suivant :
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Ce manifeste déploie un cluster de 3 instances avec un sidecar pour , à partir duquel nous collectons les métriques de l'application. Comme vous pouvez le voir, tout est très simple et si vous le souhaitez, vous pouvez créer littéralement un nombre illimité de clusters.
Il convient également de prêter attention à le panneau web pour l'administration — . Il est fourni avec l'opérateur et permet de créer et de supprimer des clusters, ainsi que de travailler avec les sauvegardes réalisées par l'opérateur.
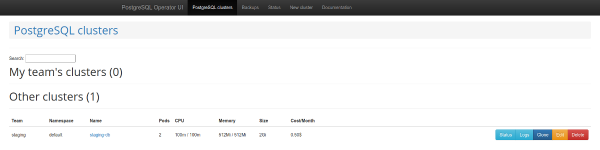
Liste des clusters PostgreSQL
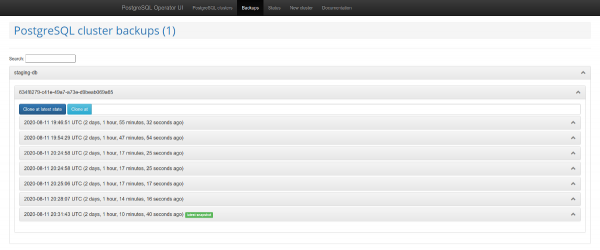
Gestion des sauvegardes
Une autre caractéristique intéressante est la prise en charge de . Ce mécanisme crée automatiquement des rôles dans PostgreSQL, en fonction de la liste des noms d'utilisateurs fournie. Après cela, l'API permet de renvoyer la liste des utilisateurs pour lesquels des rôles sont créés automatiquement.
Problèmes et leurs solutions
Cependant, l'utilisation de l'opérateur a rapidement révélé plusieurs inconvénients significatifs :
- absence de support pour nodeSelector;
- impossibilité de désactiver les sauvegardes;
- lors de l'utilisation de la fonction de création de bases, les privilèges par défaut ne sont pas appliqués;
- il manque parfois de la documentation ou celle-ci est obsolète.
Heureusement, beaucoup d'entre eux peuvent être résolus. Commençons par la fin — les problèmes avec de la documentation.
Vous rencontrerez probablement des difficultés pour spécifier une sauvegarde et comment connecter le bucket de sauvegarde à l'Interface Utilisateur de l'Opérateur. Cela est brièvement mentionné dans la documentation, mais une description réelle se trouve dans :
- il faut créer un secret;
- le transmettre à l'opérateur dans le paramètre
pod_environment_secret_namedans le CRD avec les paramètres de l'opérateur ou dans le ConfigMap (selon la manière dont vous avez choisi d'installer l'opérateur).
Cependant, il s'avère qu'actuellement, cela n'est pas possible. C'est pourquoi nous avons rassemblé avec quelques développements supplémentaires externes. Plus de détails à ce sujet — voir ci-dessous.
Si vous transmettez des paramètres à l'opérateur pour la sauvegarde, à savoir — wal_s3_bucket et les clés d'accès dans AWS S3, alors il sauvegardera tout: non seulement les bases en production, mais aussi le staging. Cela ne nous convenait pas.
Dans la description des paramètres de Spilo, qui est l'enveloppe Docker de base pour PgSQL lors de l'utilisation de l'opérateur, il a été révélé : vous pouvez transmettre le paramètre WAL_S3_BUCKET vide, désactivant ainsi les sauvegardes. De plus, à notre grand plaisir, un , que nous avons immédiatement intégré dans notre fork. Il suffit maintenant d'ajouter enableWALArchiving: false au ressourcement du cluster PostgreSQL.
Oui, il y avait la possibilité de faire autrement, en lançant 2 opérateurs : un pour le staging (sans sauvegardes), et un autre — pour la production. Mais nous avons pu nous contenter d'un seul.
D'accord, nous avons appris à donner accès aux bases pour S3 et les sauvegardes ont commencé à être stockées. Comment faire fonctionner les pages de sauvegarde dans l'Interface Utilisateur de l'Opérateur ?
Dans l'Interface Utilisateur de l'Opérateur, il sera nécessaire d'ajouter 3 variables :
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Après cela, la gestion des sauvegardes deviendra accessible, ce qui, dans notre cas, facilitera le travail avec le staging, permettant d'y envoyer des copies de production sans scripts supplémentaires.
Comme un autre avantage, on a mentionné le travail avec l'API Teams et des larges possibilités pour créer des bases et des rôles au moyens de l'opérateur. Cependant, les rôles créés n'avaient pas de privilèges par défaut. En conséquence, l'utilisateur avec des droits en lecture ne pouvait pas lire les nouvelles tables.
Pourquoi cela ? Bien que dans le code les nécessaires GRANT, elles ne sont pas toujours appliquées. Il existe 2 méthodes : syncPreparedDatabases et syncDatabases. Il y a syncPreparedDatabases — bien que dans la section preparedDatabases il y ait une condition defaultRoles et defaultUsers pour la création des rôles, — les droits par défaut ne s'appliquent pas. Nous sommes en train de préparer un patch pour que ces droits s'appliquent automatiquement.
Et dernier point dans les améliorations qui nous concernent — , ajoutant la Node Affinity au StatefulSet créé. Nos clients préfèrent souvent réduire leurs coûts en utilisant des instances spot, et il est clairement risqué d'y déployer des services de base de données. Ce problème pourrait also être résolu via des tolerations, mais la Node Affinity fournit une plus grande assurance.
Qu'est-ce qui en est sorti ?
À la suite de la résolution des problèmes évoqués, nous avons forké le Postgres Operator de Zalando dans , où il est assemblé avec des patches aussi utiles. Pour plus de commodité, nous avons également .
Liste des PR acceptées dans le fork :
- ;
- ;
- ;
- .
Ce serait formidable si la communauté soutenait ces PR afin qu'elles puissent être intégrées dans l'upstream avec la prochaine version de l'opérateur (1.6).
Bonus ! Histoire de succès avec la migration de production
Si vous utilisez Patroni, vous pouvez migrer la production en direct vers l'opérateur avec un minimum de temps d'arrêt.
Spilo permet de créer des clusters standby via des stockages S3 avec , lorsque le log binaire PgSQL est d'abord sauvegardé dans S3, puis récupéré par la réplique. Mais que faire si vous avez ne utilisé Wal-E dans une ancienne infrastructure ? La solution à ce problème a déjà été sur Habré.
La réplication logique de PostgreSQL vient à la rescousse. Cependant, nous n'allons pas entrer dans les détails, comme la création de publications et d'abonnements, car… notre plan a échoué.
Le fait est qu'il y avait plusieurs tables très chargées dans la BDD avec des millions de lignes, qui, de plus, étaient constamment ajoutées et supprimées. avec copy_data, lorsque la nouvelle réplique copie tout le contenu du maître, ne parvenait tout simplement pas à suivre le maître. La copie du contenu a duré une semaine, mais n'a jamais rattrapé le maître. Au final, nous avons pu résoudre le problème grâce à un collègue d'Avito : il est possible de transférer les données en utilisant pg_dump. Je vais décrire notre (un peu modifié) version de cet algorithme.
L'idée est de créer une souscription désactivée liée à un slot de réplication spécifique, puis de corriger le numéro de transaction. Des répliques étaient disponibles pour le fonctionnement de la production. C'est important, car la réplique aide à créer un dump cohérent et à continuer à recevoir les changements du maître.
Dans les commandes suivantes décrivant le processus de migration, les notations suivantes seront utilisées pour les hôtes :
- master — serveur source ;
- replica1 — réplique en streaming sur l'ancienne production ;
- replica2 — nouvelle réplique logique.
Plan de migration
1. Créons sur le maître une souscription à toutes les tables dans le schéma public de la base dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Créons un slot de réplication sur le maître :
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Arrêtons la réplication sur l'ancienne réplique :
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Obtenons le numéro de transaction du maître :
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Réalisons un dump de l'ancienne réplique. Nous le ferons en plusieurs flux, ce qui aidera à accélérer le processus :
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Chargeons le dump sur le nouveau serveur :
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Après le chargement du dump, nous pouvons relancer la réplication sur la réplique en streaming :
psql -h replica1 -c "select pg_wal_replay_resume();"
8. Créons une souscription sur la nouvelle réplique logique :
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
9. Obtenons oid de la souscription :
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
10. Supposons que nous avons obtenu oid=1000. Appliquons le numéro de transaction à la souscription :
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
11. Lancez la réplication :
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
12. Vérifions le statut de la souscription, la réplication doit être opérationnelle :
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
13. Une fois la réplication lancée et les bases synchronisées, il est possible d'effectuer le basculement.
14. Après la désactivation de la réplication, il faut corriger les séquences. Cela est bien décrit .
Grâce à ce plan, le basculement s'est effectué avec un minimum de retards.
Conclusion
Les opérateurs Kubernetes simplifient diverses actions en les réduisant à la création de ressources K8s. Cependant, après avoir atteint une automatisation impressionnante grâce à eux, il est important de se rappeler qu'elle peut également apporter son lot de nuances inattendues, c'est pourquoi il faut choisir les opérateurs avec discernement.
Après avoir examiné les trois opérateurs Kubernetes les plus populaires pour PostgreSQL, nous avons choisi le projet de Zalando. Nous avons dû surmonter certaines difficultés, mais le résultat a vraiment été satisfaisant, ce qui nous incite à étendre cette expérience à d'autres installations PgSQL. Si vous avez une expérience avec des solutions similaires, nous serions ravis de voir les détails dans les commentaires !
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «».
Source : habr.com
