

Bonjour encore ! Le titre de l'article parle de lui-même. En prévision du lancement du cours , nous vous proposons de comprendre qui sont réellement les ingénieurs en données. L'article contient de nombreux liens utiles. Bonne lecture.
Un guide simple sur la façon de surfer sur la vague du Data Engineering sans se laisser entraîner dans le courant.
On a l'impression qu'aujourd'hui tout le monde veut devenir data scientist. Mais qu'en est-il de l'engineering des données ? En gros, c'est une sorte d'hybride entre un analyste de données et un data scientist ; l'ingénieur en données est généralement responsable de la gestion des flux de travail, des pipelines de traitement et des processus ETL.En raison de l'importance de ces fonctions, c'est actuellement un jargon professionnel populaire qui prend de l'ampleur.
Un salaire élevé et une demande énorme ne sont qu'une petite partie de ce qui rend ce travail extrêmement attractif ! Si vous souhaitez rejoindre les rangs des héros, il n'est jamais trop tard pour commencer à apprendre. Dans cet article, j'ai compilé toutes les informations nécessaires pour vous aider à faire vos premiers pas.
Alors, commençons !
Qu'est-ce que l'ingénierie des données ?
Honnêtement, il n'y a pas de meilleure explication que celle-ci :
«Un scientifique peut découvrir une nouvelle étoile, mais ne peut pas la créer. Il devra demander à un ingénieur de le faire pour lui.»
–Gordon Lindsay Glegg
Ainsi, le rôle de l'ingénieur en données est assez important.
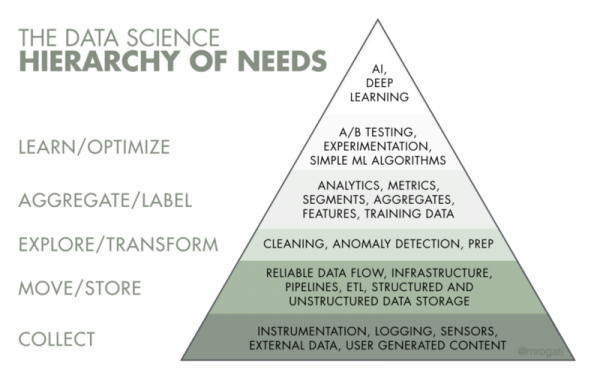
Comme son nom l'indique, l'ingénierie des données concerne les données, notamment leur livraison, leur stockage et leur traitement. Par conséquent, la principale tâche des ingénieurs est de garantir une infrastructure fiable pour les données. Si nous regardons la hiérarchie des besoins en IA, l'ingénierie des données occupe les 2 à 3 premières étapes : collecte, déplacement et stockage, préparation des données.
Que fait un ingénieur en données ?
Avec l'émergence des grandes données, le domaine de responsabilité a considérablement évolué. Autrefois, ces experts écrivaient de grandes requêtes SQL et transféraient des données à l'aide d'outils tels qu'Informatica ETL, Pentaho ETL, Talend, mais désormais les exigences pour les ingénieurs en données ont augmenté.
La plupart des entreprises qui recrutent des ingénieurs en données exigent les éléments suivants :
- Excellente maîtrise de SQL et Python.
- Expérience avec les plateformes cloud, notamment Amazon Web Services.
- Connaissance de Java/Scala souhaitable.
- Une bonne compréhension des bases de données SQL et NoSQL (modélisation des données, stockage des données).
Gardez à l'esprit que ce n'est que le strict nécessaire. De cette liste, on peut supposer que les ingénieurs de données sont des spécialistes en développement logiciel et en backend.
Par exemple, si une entreprise commence à générer de gros volumes de données à partir de différentes sources, votre tâche en tant qu'ingénieur de données consiste à organiser la collecte d'informations, leur traitement et leur stockage.
La liste des outils utilisés dans ce cas peut varier, tout dépend du volume de ces données, de la rapidité avec laquelle elles sont collectées et de leur hétérogénéité. La plupart des entreprises ne rencontrent pas de grandes quantités de données, c'est pourquoi une base de données SQL (PostgreSQL, MySQL, etc.) avec un petit ensemble de scripts pour diriger les données vers le stockage peut être utilisée comme un entrepôt de données centralisé.
Les géants de l'IT, tels que Google, Amazon, Facebook ou Dropbox, ont des exigences plus élevées : connaissance de Python, Java ou Scala.
- Expérience avec de grandes données : Hadoop, Spark, Kafka.
- Connaissance des algorithmes et des structures de données.
- Compréhension des bases des systèmes distribués.
- Une expérience avec des outils de visualisation des données, tels que Tableau ou ElasticSearch, sera un grand plus.
Il y a donc un certain glissement évident vers les grandes données, en particulier dans leur traitement sous des charges élevées. Ces entreprises ont des exigences accrues en matière de résilience des systèmes.
Ingénieurs de données Vs. data scientists
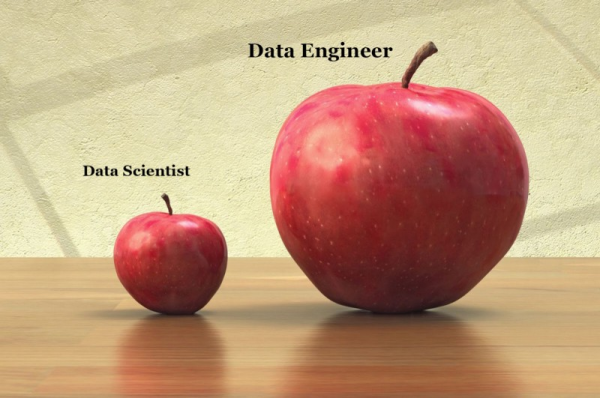
D'accord, c'était une comparaison simple et drôle (rien de personnel), mais en réalité, tout est beaucoup plus complexe.
Tout d'abord, vous devez savoir qu'il existe une certaine ambiguïté dans la distinction entre les rôles et les compétences des data scientists et des ingénieurs de données. Cela signifie que vous pouvez facilement être confus quant aux compétences nécessaires pour être un ingénieur de données réussi. Bien sûr, certaines compétences se chevauchent entre les deux rôles. Mais il existe également un certain nombre de compétences diamétralement opposées.
La science des données est une affaire sérieuse, mais nous nous dirigeons vers un monde avec une science des données fonctionnelle, où les praticiens sont capables de faire leur propre analyse. Pour engager des pipelines de données et des structures de données intégrées, vous avez besoin d'ingénieurs de données, et non de scientifiques.
Est-ce qu'un ingénieur de données est plus demandé qu'un data scientist ?
— Oui, parce qu'avant de pouvoir préparer un gâteau aux carottes, vous devez d'abord récolter, nettoyer et stocker des carottes !
L'ingénieur de données comprend mieux la programmation que n'importe quel data scientist, mais quand il s'agit de statistiques, c'est tout le contraire.
Mais voici l'avantage de l'ingénieur de données :
sans lui/elle, la valeur du modèle prototype, souvent composé d'un extrait de code de mauvaise qualité dans un fichier Python, obtenu d'un data scientist et qui, d'une manière ou d'une autre, produit un résultat, tend vers zéro.
Sans l'ingénieur de données, ce code ne deviendra jamais un projet, et aucun problème commercial ne sera résolu efficacement. L'ingénieur de données s'efforce de transformer tout cela en produit.
Les connaissances de base qu'un ingénieur de données doit avoir
Ainsi, si ce travail éveille en vous une passion et que vous êtes plein d'enthousiasme — vous êtes capable d'apprendre cela, vous pouvez acquérir toutes les compétences nécessaires et devenir une véritable rock star dans le domaine du développement de données. Et oui, vous pouvez le faire même sans compétences en programmation ou autres connaissances techniques. C'est difficile, mais possible !
Quelles sont les premières étapes ?
Vous devez avoir une compréhension générale de ce qui est quoi.
Tout d'abord, l'ingénierie des données concerne l'informatique. Plus précisément — vous devez comprendre les algorithmes efficaces et les structures de données. Deuxièmement, puisque les ingénieurs de données travaillent avec des données, il est nécessaire de comprendre les principes de fonctionnement des bases de données et des structures qui les sous-tendent.
Par exemple, les bases de données SQL utilisant des B-arbres sont basées sur la structure de données B-Tree, ainsi que, dans les dépôts distribués modernes, LSM-Tree et d'autres modifications de tables de hachage.
* Ces étapes sont basées sur un article remarquable . Alors, si vous parlez russe, soutenez cet auteur et lisez .
1. Algorithmes et structures de données
Utiliser la bonne structure de données peut considérablement améliorer la performance d'un algorithme. Idéalement, nous devrions tous étudier les structures de données et les algorithmes à l'école, mais cela est rarement abordé. Quoi qu'il en soit, il n'est jamais trop tard pour s'informer.
Voici donc mes cours gratuits préférés pour apprendre les structures de données et les algorithmes :
N'oubliez pas non plus l'œuvre classique sur les algorithmes de Thomas Cormen — . C'est le guide parfait quand vous avez besoin de rafraîchir votre mémoire.
- Pour améliorer vos compétences, utilisez .
Vous pouvez également plonger dans le monde des bases de données avec les superbes vidéos de l'Université Carnegie Mellon sur Youtube :
- .
- .
2. Apprendre SQL
Toute notre vie est faite de données. Et pour extraire ces données d'une base, vous devez « parler » avec elles dans un langage commun.
SQL (Structured Query Language — Langage de requête structuré) est le langage de communication dans le domaine des données. Peu importe ce que quelqu'un dit, SQL a vécu, vit et continuera de vivre encore très longtemps.
Si vous êtes longtemps resté dans le développement, vous avez probablement remarqué que des rumeurs sur la mort imminente de SQL apparaissent de temps en temps. Le langage a été développé au début des années 70 et continue d’être très populaire parmi les analystes, développeurs et juste passionnés.
Sans connaissance de SQL dans l'ingénierie des données, il n'y a rien à faire, car vous devrez inévitablement créer des requêtes pour extraire des données. Tous les entrepôts modernes de grandes données prennent en charge SQL :
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… et de nombreux autres.
Pour analyser de vastes ensembles de données stockées dans des systèmes distribués comme HDFS, des mécanismes SQL ont été inventés : Apache Hive, Impala, etc. Vous voyez, il n'a pas l'intention de disparaître.
Comment apprendre SQL ? Il suffit de le pratiquer.
Pour cela, je vous recommande de consulter un excellent manuel, qui, soit dit en passant, est gratuit, de .
La caractéristique distinctive de ces cours est la présence d'un environnement interactif où vous pouvez écrire et exécuter des requêtes SQL directement dans votre navigateur. La ressource ne sera pas superflue. Et vous pouvez appliquer ces connaissances dans dans la section Bases de données.
3. Programmation en Python et Java/Scala
Pourquoi apprendre le langage de programmation Python, j'en ai déjà parlé dans l'article . En ce qui concerne Java et Scala, la plupart des outils pour stocker et traiter d’immenses volumes de données sont écrits dans ces langages. Par exemple :
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Pour comprendre comment ces outils fonctionnent, vous devez connaître les langages dans lesquels ils sont écrits. L'approche fonctionnelle de Scala permet de résoudre efficacement des problèmes de traitement parallèle des données. Python, malheureusement, ne peut pas se vanter de sa rapidité et de son traitement parallèle. En général, connaître plusieurs langages et paradigmes de programmation améliore la diversité des approches de résolution des problèmes.
Pour plonger dans le langage Scala, vous pouvez lire de l'auteur du langage. De plus, Twitter a publié un bon guide d'introduction — .
En ce qui concerne Python, je pense que est le meilleur livre de niveau intermédiaire.
4. Outils pour le Big Data
Voici une liste des outils les plus populaires dans le monde du Big Data :
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Vous pouvez trouver plus d'informations sur la construction de grands ensembles de données dans cet incroyable . Les outils les plus populaires sont Spark et Kafka. Ils valent vraiment la peine d'être étudiés, idéalement pour comprendre comment ils fonctionnent de l'intérieur. Jay Kreps (co-auteur de Kafka) a publié en 2013 un travail monumental , d'ailleurs, les idées principales de ce talmud ont été utilisées pour créer Apache Kafka.
- Une introduction à Hadoop peut être .
- Le guide le plus complet sur Apache Spark pour moi est — .
5. Plateformes Cloud
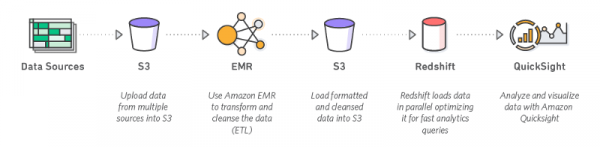
Connaître au moins une plateforme cloud est l'un des critères de base exigés par les employeurs pour les candidats au poste d'ingénieur en données. Les employeurs privilégient Amazon Web Services, la plateforme cloud de Google arrive en deuxième position, et Microsoft Azure complète le trio de tête.
Vous devez bien maîtriser Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Systèmes distribués
Travailler avec de grandes quantités de données implique d'avoir des clusters de calculateurs fonctionnant indépendamment, dont la communication s'effectue par réseau. Plus le cluster est grand, plus la probabilité de panne de ses nœuds est élevée. Pour devenir un expert en données, vous devez approfondir les problèmes et les solutions existantes pour les systèmes distribués. Ce domaine est ancien et complexe.
Andrew Tanenbaum est considéré comme un pionnier dans ce domaine. Pour ceux qui n'ont pas peur de la théorie, je recommande son livre , il peut sembler complexe pour les débutants, mais cela vous aidera vraiment à perfectionner vos compétences.
Je pense que est le meilleur livre d'introduction. À propos, Martin a un excellent . Son travail aidera à systématiser vos connaissances sur la construction de l'infrastructure moderne pour le stockage et le traitement des Big Data.
Pour ceux qui aiment regarder des vidéos, il existe un cours sur Youtube .
7. Pipelines de données
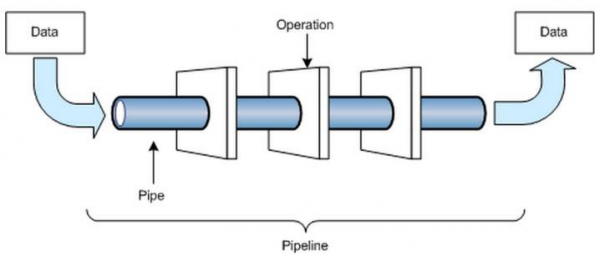
Les pipelines de données sont essentiels pour un ingénieur de données.
La plupart du temps, un ingénieur de données construit ce qu'on appelle un pipeline de données, c'est-à-dire qu'il crée un processus de livraison de données d'un endroit à un autre. Cela peut inclure des scénarios d'utilisateur qui interagissent avec l'API d'un service externe ou effectuent des requêtes SQL, enrichissant les données et les plaçant dans un entrepôt centralisé (entrepôt de données) ou un stockage de données non structurées (lacs de données).
En résumé : la liste de contrôle principale d'un ingénieur de données
Résumé — il est nécessaire d'avoir une bonne compréhension des éléments suivants :
- Systèmes d'information ;
- Développement logiciel (Agile, DevOps, Techniques de conception, SOA) ;
- Systèmes distribués et programmation parallèle ;
- Fondamentaux des bases de données — planification, conception, exploitation et dépannages ;
- Conception d'expériences — tests A/B pour prouver des concepts, évaluer la fiabilité, la performance des systèmes, ainsi que pour développer des voies fiables pour fournir des solutions de manière opérationnelle.
Ce ne sont là que quelques exigences pour devenir ingénieur de données, alors étudiez et familiarisez-vous avec les systèmes de données, les systèmes d'information, la livraison continue/déploiement/intégration, les langages de programmation et d'autres sujets en informatique (pas dans tous les domaines de spécialité).
Et enfin, la dernière chose mais non des moindres que je tiens à dire.
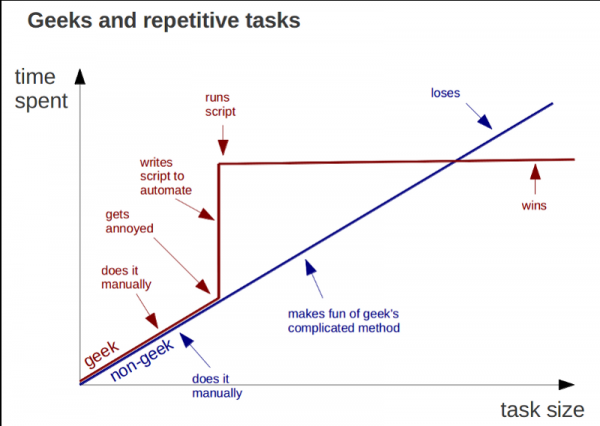
Le parcours pour devenir Data Engineer n'est pas aussi simple qu'il y paraît. Il ne fait pas de cadeaux, il est frustrant, et vous devez être prêt à cela. Certains moments de ce voyage peuvent vous pousser à tout abandonner. Mais c'est un véritable travail et un processus d'apprentissage.
Ne commencez pas par embellir la réalité. Tout l'intérêt de ce voyage est d'apprendre le plus possible et d'être prêt à relever de nouveaux défis.
Voici une excellente image que j'ai rencontrée, qui illustre bien ce point :
Et oui, n'oubliez pas d'éviter le burn-out et de prendre du temps pour vous reposer. C'est également très important. Bonne chance !
Qu'avez-vous pensé de l'article, les amis ? Nous vous invitons à , qui aura lieu aujourd'hui à 20h00. Au cours du webinaire, nous discuterons de la façon de construire un système de traitement des données efficace et évolutif pour une petite entreprise ou une start-up avec un minimum de coûts. En pratique, nous nous familiariserons avec les outils de traitement des données de Google Cloud. À bientôt !
Source : habr.com
