

Aujourd'hui, mercredi, une nouvelle version de Kubernetes — 1.16. Comme le veut la tradition de notre blog, nous vous présentons pour la dixième fois les changements les plus significatifs de cette nouvelle version.
Les informations utilisées pour préparer ce matériel proviennent de , et des problèmes, demandes d'extraction, ainsi que des propositions d'amélioration de Kubernetes (KEP) correspondantes. Alors, c'est parti !..
Nœuds
Un grand nombre de nouvelles fonctionnalités notables (en version alpha) sont présentées du côté des nœuds des clusters K8s (Kubelet).
Tout d'abord, nous avons les «» (Ephemeral Containers), destinés à simplifier les processus de débogage dans les pod’ s. Le nouveau mécanisme permet de lancer des conteneurs spéciaux, qui démarrent dans l'espace de noms des pod’ s existants et vivent pendant une courte durée. Leur but est d'interagir avec d'autres pod’ s et conteneurs pour résoudre des problèmes et effectuer des débogages. Pour cela, une nouvelle commande a été mise en place : kubectl debug, similaire à kubectl exec: seulement au lieu de lancer un processus dans un conteneur (comme dans le cas de exec) elle démarre un conteneur dans un pod. Par exemple, cette commande connectera un nouveau conteneur à un pod :
kubectl debug -c debug-shell --image=debian target-pod -- bashDes détails sur les conteneurs éphémères (et des exemples de leur utilisation) peuvent être trouvés dans . L'implémentation actuelle (dans K8s 1.16) est en version alpha, et parmi les critères pour son passage en version bêta se trouve "le test de l'API des conteneurs éphémères sur une période d'au moins 2 versions [Kubernetes]".
NBEn substance et même par son nom, la fonctionnalité rappelle déjà un plugin existant , dont nous . Il est prévu qu'avec l'arrivée des conteneurs éphémères, le développement d'un plugin externe distinct sera interrompu.
Une autre nouveauté — — vise à fournir un mécanisme de calcul des frais généraux liés aux pod’ s, qui peuvent varier considérablement en fonction de l'environnement d'exécution (runtime) utilisé. Par exemple, les auteurs mentionnent Kata Containers, qui nécessitent le démarrage d'un noyau invité, d'un agent kata, d'un système d'init, etc. Lorsque les frais généraux deviennent si importants, ils ne peuvent pas être ignorés, ce qui signifie qu'un moyen de les prendre en compte pour le quota, la planification, etc. est nécessaire. Pour cela, un champ a été ajouté à PodSpec . Surcharge *ResourceList (correspond à des données dans RuntimeClass, si utilisé).
Une autre innovation notable est le gestionnaire de topologie de nœud (Node Topology Manager), conçu pour unifier l'approche de l'optimisation de la distribution des ressources matérielles pour différents composants dans Kubernetes. Cette initiative est motivée par la demande croissante de divers systèmes modernes (dans le domaine des télécommunications, apprentissage automatique, services financiers, etc.) pour des calculs parallèles haute performance et la minimisation des délais d'exécution, utilisant pour cela les capacités avancées des CPU et l'accélération matérielle. Ces optimisations dans Kubernetes ont jusqu'à présent été réalisées grâce à des composants disparates (gestionnaire de CPU, gestionnaire de périphériques, CNI), et maintenant, un interface interne unifiée va être ajoutée, qui unifie l'approche et simplifie le branchement de nouveaux composants similaires - dits topology-aware - du côté de Kubelet. Les détails sont dans .
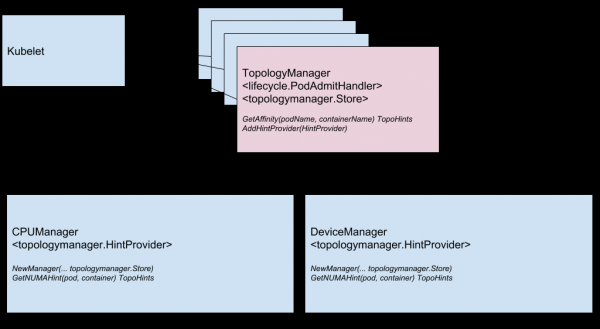
Le schéma des composants du Topology Manager
La prochaine fonctionnalité est la vérification des conteneurs lors de leur démarrage (). Comme il est connu, pour les conteneurs qui mettent longtemps à démarrer, il est difficile d'obtenir un statut actuel : soit ils sont 'tués' avant de commencer réellement à fonctionner, soit ils se retrouvent longtemps coincés dans un deadlock. La nouvelle vérification (activée via une porte de fonctionnalités appelée StartupProbeEnabled) annule - ou plutôt, retarde - l'action de toutes les autres vérifications jusqu'à ce que le pod ait terminé son démarrage. Pour cette raison, la fonctionnalité a été initialement appelée . Pour les pods qui démarrent lentement, il est possible de procéder à des sondages d'état à des intervalles de temps relativement courts.
De plus, dès sa version bêta, une amélioration pour RuntimeClass a été présentée, ajoutant le support des 'clusters hétérogènes'. Avec , il n'est désormais plus nécessaire que chaque nœud prenne en charge chaque RuntimeClass : pour les pods, il est possible de choisir RuntimeClass sans se soucier de la topologie du cluster. Auparavant, pour atteindre cet objectif - afin que les pods se retrouvent sur des nœuds avec le support de tout ce dont ils ont besoin - il fallait assigner des règles correspondant à NodeSelector et tolerations. Dans des exemples d'utilisation sont décrits, ainsi que, bien sûr, des détails sur l'implémentation.
Réseau
Deux fonctionnalités réseau significatives, qui sont apparues pour la première fois (en version alpha) dans Kubernetes 1.16 - sont :
- la double pile réseau - IPv4\/IPv6 — et sa «compréhension» au niveau des pods, des nœuds et des services. Cela inclut l'interaction IPv4 à IPv4 et IPv6 à IPv6 entre les pods, des pods vers des services externes, des mises en œuvre de référence (dans le cadre des plugins Bridge CNI, PTP CNI et Host-Local IPAM), ainsi qu'une compatibilité descendante avec les clusters Kubernetes fonctionnant uniquement sur IPv4 ou IPv6. Les détails de la mise en œuvre se trouvent dans .
Un exemple d'affichage d'adresses IP de deux types (IPv4 et IPv6) dans la liste des pods :
kube-master# kubectl get pods -o wide NOM PRÊT ÉTAT REDÉMARRAGES ÂGE IP NŒUD nginx-controller 1/1 Fonctionnement 0 20m fd00:db8:1::2,192.168.1.3 kube-minion-1 kube-master# - Une nouvelle API pour Endpoint — . Elle résout les problèmes de performance/évolutivité de l'API Endpoint existante qui affectent divers composants dans le plan de contrôle (apiserver, etcd, endpoints-controller, kube-proxy). La nouvelle API sera ajoutée au groupe API Discovery et pourra gérer des dizaines de milliers de points de terminaison backend sur chaque service dans un cluster composé de milliers de nœuds. Pour cela, chaque service est mappé à N objets
EndpointSlice, chacun d'eux ayant par défaut pas plus de 100 points de terminaison (valeur configurable). L'API EndpointSlice prévoit également des possibilités pour son futur développement : le support de plusieurs adresses IP pour chaque pod, de nouveaux états pour les points de terminaison (non seulementPrêtetNotReady), le sous-ensemencement dynamique pour les points de terminaison.
La version bêta a progressé concernant le "finalizer" présenté dans la dernière version , appelé service.kubernetes.io/load-balancer-cleanup et attaché à chaque service de type LoadBalancer. Lors de la suppression de ce type de service, il empêche la suppression réelle de la ressource tant que le nettoyage de toutes les ressources correspondant au balancer n'est pas terminé.
API Machinery
Un véritable "jalon de stabilisation" a été enregistré dans le domaine de l’API server de Kubernetes et son interaction. En grande partie, cela s'est produit grâce à le passage au statut stable de ceux qui n'ont pas besoin d'une présentation spéciale (CRD), qui avaient le statut bêta depuis l'époque lointaine de Kubernetes 1.7 (ce qui était en juin 2017 !). Une telle stabilisation a également été observée pour les fonctionnalités qui leur sont associées :
- avec
/statuset/scaletransformation - les valeurs par défaut récemment présentées (dans K8s 1.15)
- l'application du schéma OpenAPI v3 pour créer et publier la documentation OpenAPI utilisée pour la validation des ressources CRD côté serveur. (par défaut) et suppression automatique des champs (élagage) transformation
- application du schéma OpenAPI v3 pour la création et la publication de la documentation OpenAPI, utilisée pour la validation des ressources CRD côté serveur.
Un autre mécanisme, devenu familier pour les administrateurs Kubernetes : — a également longtemps été en version bêta (depuis K8s 1.9) et est maintenant déclaré stable.
Deux autres fonctionnalités ont atteint la version bêta : et .
Et la seule nouveauté significative de la version alpha a été à partir de SelfLink — un URI spécial représentant l'objet spécifié et faisant partie de ObjectMeta et ListMeta (c’est-à-dire faisant partie de tout objet dans Kubernetes). Pourquoi s’en débarrasse-t-on ? La motivation « simplement » comme l'absence de raisons réelles (insurmontables) pour que ce champ continue d'exister. Des raisons plus formelles incluent l'optimisation des performances (en supprimant un champ inutile) et la simplification du travail du generic-apiserver, qui doit traiter ce champ d'une manière particulière (c'est le seul champ qui est défini juste avant la sérialisation de l'objet). Le véritable « dépréciation » (dans le cadre de la version bêta) SelfLink interviendra dans la version Kubernetes 1.20, et la finale — 1.21.
Stockage des données
Le travail principal dans le domaine du stockage, comme dans les versions précédentes, est observé dans le domaine . Les principales modifications ici sont :
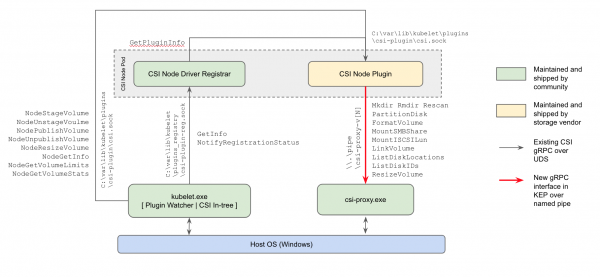
- pour la première fois (dans la version alpha) prise en charge des plugins CSI pour les nœuds de travail sous Windows: une méthode actuelle de travail avec les stockages qui remplacera les plugins in-tree dans le noyau Kubernetes et les plugins FlexVolume de Microsoft basés sur Powershell ;

Le schéma de mise en œuvre des plugins CSI dans Kubernetes pour Windows - la possibilité , présentée encore dans K8s 1.12, a atteint la version bêta ;
- une « montée en version » similaire (de alpha à bêta) a été atteinte avec la possibilité d'utiliser CSI pour créer des volumes éphémères locaux ().
Apparue dans la dernière version de Kubernetes (utiliser des PVC existants comme DataSource pour créer de nouveaux PVC) a également maintenant le statut de version bêta.
Planificateur
Deux modifications notables dans la planification (les deux en version alpha) :
- — la possibilité d'utiliser des pods pour une « distribution équitable » des charges au lieu d'unités logiques d'application (comme Deployment et ReplicaSet) et de réguler cette distribution (comme une exigence stricte ou comme une condition souple, c’est-à-dire une priorité). La fonctionnalité élargira les capacités existantes de distribution des pods planifiés, actuellement limitées aux options
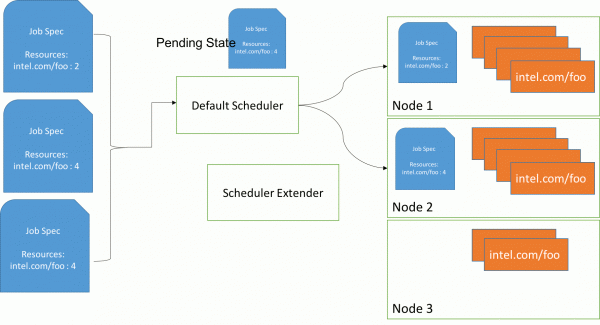
PodAffinityetPodAntiAffinity, fournissant aux administrateurs un contrôle plus fin sur cette question, et par conséquent — une meilleure disponibilité élevée et une consommation de ressources optimisée. Plus de détails dans . - Utilisation Politique BestFit dans Fonction de priorité RequestedToCapacityRatio lors de la planification des pods, permettant à des répertoires contenant les fichiers correspondants, mais dans le cas d'autres systèmes de fichiers, cela peut ne pas être le cas. (« emballage en conteneurs ») tant pour les ressources principales (processeur, mémoire) que pour les ressources avancées (comme le GPU). Pour plus de détails, consultez .

Planification des pods : avant d'utiliser la politique best fit (directement via le planificateur par défaut) et en l'utilisant (via le scheduler extender)
De plus, la possibilité de créer des plug-ins pour le planificateur en dehors de l'arbre principal de développement de Kubernetes (out-of-tree).
Autres changements
De plus, dans la version Kubernetes 1.16, on peut noter l'initiative visant à les métriques existantes de manière cohérente, en d'autres termes — conformément aux concernant l'instrumentation de K8s. Elles reposent essentiellement sur la documentation appropriée de Les incohérences ont été causées pour diverses raisons (par exemple, certaines métriques ont été créées avant que les instructions actuelles n'apparaissent), et les développeurs ont décidé qu'il était temps de mettre tout cela au même standard, « en conformité avec le reste de l'écosystème Prometheus ». La mise en œuvre actuelle de cette initiative est en version alpha, qui sera progressivement élevée dans les futures versions de Kubernetes jusqu'à la bêta (1.17) et à la stable (1.18).
De plus, on peut noter les changements suivants :
- Développement du support de Windows avec de l'outil Kubeadm pour ce système d'exploitation (version alpha),
Une publication sur la plateforme d'orchestration des conteneurs a été publiée.pour les conteneurs Windows (version alpha), le support du Group Managed Service Account (gMSA) jusqu'à la version bêta, mount/attach pour les volumes vSphere. - de compression des données dans les réponses API. Auparavant, pour cela, un filtre HTTP était utilisé, ce qui imposait de nombreuses limitations empêchant son activation par défaut. Maintenant, il existe une « compression transparente des requêtes » : les clients envoyant
Accept-Encoding: gzipdans l'en-tête reçoivent une réponse compressée en GZIP si sa taille dépasse 128 Ko. Les clients en Go prennent automatiquement en charge la compression (envoient l'en-tête nécessaire), donc ils remarqueront immédiatement une réduction du trafic. (D'autres langages peuvent nécessiter de petites modifications.) - de scaler HPA de zéro pods à partir de métriques externes.Si le dimensionnement est effectué sur la base d'objets / de métriques externes, il est possible de réduire automatiquement à 0 répliques lorsque les charges de travail sont inactives, afin d'économiser des ressources. Cette fonctionnalité devrait être particulièrement utile dans les cas où les workers demandent des ressources GPU, et où le nombre de différents types de workers inactifs dépasse le nombre de GPU disponibles.
- Nouveau client — — pour un accès « générique » aux objets. Il est conçu pour faciliter l’obtention des métadonnées (c’est-à-dire la subdivision
métadonnées) des ressources du cluster et d'effectuer des opérations telles que le nettoyage et la quotisation. - La collecte de Kubernetes sans les fournisseurs de cloud obsolètes (« intégrés » dans in-tree) (version alpha).
- Dans l'outil kubeadm la possibilité expérimentale (version alpha) d'appliquer des correctifs kustomize lors des opérations
init,joindreetde mise à niveau. Pour plus d'informations sur l'utilisation du drapeau--experimental-kustomize, consultez . - Nouveau point de terminaison pour apiserver — , — permettant d'exporter des informations sur sa disponibilité. De plus, le serveur API a maintenant un drapeau
--maximum-startup-sequence-duration, qui permet de réguler ses redémarrages. - Deux fonctionnalités pour Azure ont été déclarées stables : prise en charge (Availability Zones) et (RG). De plus, Azure a ajouté :
- AAD et ADFS ;
-
service.beta.kubernetes.io/azure-pip-namepour indiquer l'IP publique du load balancer ; - des paramètres
LoadBalancerNameetLoadBalancerResourceGroup.
- AWS a reçu pour EBS sur Windows et les appels API EC2
DescribeInstances. - Kubeadm migre désormais automatiquement Les binaires
- dans l'image Docker correspondante etcd sont exécutables dans le monde, ce qui permet de lancer cette image sans nécessité de droits root. De plus, l'image de migration etcd a cessé Cluster Autoscaler 1.16.0
- Dans Mises à jour des logiciels utilisés / dépendants : Go 1.12.9, etcd 3.3.15, CoreDNS 1.6.2.
- Kubernetes 1.15 : aperçu des principales nouveautés
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «».
Source : habr.com
