

Note de traduction.: Cet article, écrit par Galo Navarro, qui occupe le poste d'ingénieur logiciel principal dans l'entreprise européenne Adevinta, est une enquête fascinante et instructive sur l'exploitation des infrastructures. Son titre original a été légèrement ajusté dans la traduction pour une raison que l'auteur explique au début.
Note de l'auteur: Il semble que cette publication beaucoup plus d'attention que prévu. Je continue de recevoir des commentaires en colère sur le fait que le titre de l'article est trompeur et que certains lecteurs sont déçus. Je comprends les raisons de cette réaction, donc, malgré le risque de ruiner toute l'intrigue, je veux tout de suite expliquer de quoi cet article parle. En observant les équipes passer à Kubernetes, j'ai remarqué une chose curieuse : chaque fois qu'un problème survient (comme une augmentation des latences après la migration), la première chose à blâmer est Kubernetes, mais on réalise finalement que l'orchestrateur n'est généralement pas en cause. Cet article raconte l'un de ces cas. Son titre reprend l'exclamation de l'un de nos développeurs (vous verrez que Kubernetes n'est en réalité pas en cause). Vous n'y trouverez pas de révélations inattendues sur Kubernetes, mais vous pouvez vous attendre à quelques bonnes leçons sur les systèmes complexes.
Il y a quelques semaines, mon équipe travaillait sur la migration d'un microservice vers la plateforme principale, incluant CI/CD, une environnement basé sur Kubernetes, des métriques et d'autres fonctionnalités utiles. Le déménagement était un essai : nous avions prévu de prendre cela comme base et de transférer environ 150 autres services dans les mois à venir. Tous ont la responsabilité de faire fonctionner certaines des plus grandes plateformes en ligne d'Espagne (Infojobs, Fotocasa, etc.).
Après avoir déployé l'application sur Kubernetes et redirigé une partie du trafic vers elle, une surprise inquiétante nous attendait. La latence (latence) des requêtes dans Kubernetes était dix fois plus élevée que dans EC2. En somme, il fallait soit trouver une solution à ce problème, soit abandonner la migration du microservice (et, peut-être, l'ensemble du projet).
Pourquoi la latence dans Kubernetes est-elle si élevée par rapport à EC2 ?
Pour identifier le goulet d'étranglement, nous avons collecté des métriques sur tout le parcours de la requête. Notre architecture est simple : un API Gateway (Zuul) proxy les requêtes vers les instances du microservice dans EC2 ou Kubernetes. Dans Kubernetes, nous utilisons NGINX Ingress Controller, et les backends sont de simples objets de type avec une application JVM sur la plateforme Spring.
                                  EC2
                            +---------------+
                            |  +---------+  |
                            |  |         |  |
                       +-------> BACKEND |  |
                       |    |  |         |  |
                       |    |  +---------+  |
                       |    +---------------+
             +------+  |
Public       |      |  |
      -------> ZUUL +--+
traffic      |      |  |              Kubernetes
             +------+  |    +-----------------------------+
                       |    |  +-------+      +---------+ |
                       |    |  |       |  xx  |         | |
                       +-------> NGINX +------> BACKEND | |
                            |  |       |  xx  |         | |
                            |  +-------+      +---------+ |
                            +-----------------------------+
Il semblait que le problème était lié à un délai au début du traitement côté backend (j'ai marqué la zone problématique sur le graphique comme «xx»). Dans EC2, le temps de réponse de l'application était d'environ 20 ms. Dans Kubernetes, le délai augmentait à 100-200 ms.
Nous avons rapidement écarté les suspects potentiels liés à un changement d'environnement d'exécution. La version de la JVM était restée la même. Les problèmes de conteneurisation n’étaient pas en cause non plus : l'application fonctionnait déjà correctement dans des conteneurs dans EC2. La charge ? Mais nous observions de forts délais même avec 1 requête par seconde. Les pauses pour la collecte des ordures pouvaient également être négligées.
L'un de nos administrateurs Kubernetes s'est demandé s'il y avait des dépendances externes pour l'application, car par le passé, les requêtes DNS avaient causé des problèmes similaires.
Hypothèse 1 : résolution de noms DNS
À chaque requête, notre application interroge entre une et trois fois une instance AWS Elasticsearch dans un domaine tel que elastic.spain.adevinta.com. À l'intérieur des conteneurs, nous avons , donc nous pouvons vérifier si la recherche de domaine prend effectivement beaucoup de temps.
Requêtes DNS depuis le conteneur :
[root@be-851c76f696-alf8z \/]# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 22 msec
;; Query time: 22 msec
;; Query time: 29 msec
;; Query time: 21 msec
;; Query time: 28 msec
;; Query time: 43 msec
;; Query time: 39 msec
Requêtes similaires depuis une des instances EC2 où l'application fonctionne :
bash-4.4# while true; do dig "elastic.spain.adevinta.com" | grep time; sleep 2; done
;; Query time: 77 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
;; Query time: 0 msec
Étant donné que la recherche prend environ 30 ms, il est devenu clair que la résolution DNS lors de l'accès à Elasticsearch contribue effectivement à l'augmentation du délai.
Cependant, c'était étrange pour deux raisons :
- Nous avons déjà de nombreuses applications dans Kubernetes qui interagissent avec les ressources AWS sans subir de grandes latences. Quelle qu'en soit la raison, elle est spécifiquement liée à ce cas.
- Nous savons que la JVM effectue un cache DNS en mémoire. Dans nos images, la valeur TTL est spécifiée dans
$JAVA_HOME/jre/lib/security/java.securityet est fixée à 10 secondes :networkaddress.cache.ttl = 10. En d'autres termes, la JVM doit mettre en cache toutes les requêtes DNS pendant 10 secondes.
Pour confirmer notre première hypothèse, nous avons décidé de renoncer temporairement aux appels DNS et de voir si le problème disparaîtrait. Nous avons d'abord décidé de reconfigurer l'application pour qu'elle se connecte directement à Elasticsearch par adresse IP, plutôt que par nom de domaine. Cela aurait nécessité des modifications de code et un nouveau déploiement, nous avons donc simplement mis en correspondance le domaine avec son adresse IP dans /etc/hosts:
34.55.5.111 elastic.spain.adevinta.comLe conteneur recevait maintenant l'IP presque instantanément. Cela a conduit à une certaine amélioration, mais nous n'avons encore que légèrement rapproché du niveau de latence attendu. Bien que la résolution DNS ait pris beaucoup de temps, la véritable raison nous échappait toujours.
Diagnostics réseau
Nous avons décidé d'analyser le trafic depuis le conteneur à l'aide de tcpdump, pour suivre ce qui se passe exactement dans le réseau :
[root@be-851c76f696-alf8z /]# tcpdump -leni any -w capture.pcap Ensuite, nous avons envoyé quelques requêtes et téléchargé leur capture (kubectl cp my-service:/capture.pcap capture.pcap) pour une analyse plus approfondie dans .
Il n'y avait rien de suspect dans les requêtes DNS (excepté un petit détail que je mentionnerai plus tard). Mais il y avait certaines étrangetés dans la manière dont notre service traitait chaque requête. Voici un extrait de la capture montrant la réception de la requête avant le début de la réponse :
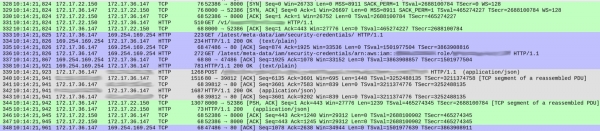
Les numéros de paquet sont indiqués dans la première colonne. Pour plus de clarté, j'ai coloré les différents flux TCP.
Le flux vert, commençant avec le paquet 328, montre comment le client (172.17.22.150) a établi une connexion TCP avec le conteneur (172.17.36.147). Après l'initialisation de la connexion (328-330), le paquet 331 a apporté HTTP GET /v1/.. — une requête entrante vers notre service. L'ensemble du processus a pris 1 ms.
Le flux gris (depuis le paquet 339) montre que notre service a envoyé une requête HTTP à l'instance Elasticsearch (l'initialisation TCP est absente car la connexion était déjà établie). Cela a pris 18 ms.
Jusqu'ici tout va bien, et les temps sont à peu près conformes aux latences attendues (20-30 ms lors des mesures côté client).
Cependant, la section bleue prend 86 ms. Que se passe-t-il ? Avec le paquet 333, notre service a envoyé une requête HTTP GET à /latest/meta-data/iam/security-credentials, et juste après, par la même connexion TCP, une autre requête GET à /latest/meta-data/iam/security-credentials/arn:...
Nous avons constaté que cela se répétait à chaque requête dans tout le traçage. La résolution DNS est effectivement légèrement plus lente dans nos conteneurs (l'explication de ce phénomène est très intéressante, mais je la garderai pour un article séparé). Il s'est avéré que la cause des grands délais est liée aux appels au service AWS Instance Metadata à chaque requête.
Hypothèse 2 : appels excessifs à AWS
Les deux points de terminaison appartiennent à . Notre microservice utilise ce service lors du travail avec Elasticsearch. Les deux appels font partie du processus d'autorisation de base. Le point de terminaison auquel la première requête accède délivre le rôle IAM associé à l'instance.
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/
arn:aws:iam::<account_id>:role/some_role
La seconde requête accède au second point de terminaison pour obtenir des privilèges temporaires pour cette instance :
/ # curl http://169.254.169.254/latest/meta-data/iam/security-credentials/arn:aws:iam::<account_id>:role/some_role`
{
    "Code" : "Success",
    "LastUpdated" : "2012-04-26T16:39:16Z",
    "Type" : "AWS-HMAC",
    "AccessKeyId" : "ASIAIOSFODNN7EXAMPLE",
    "SecretAccessKey" : "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY",
    "Token" : "token",
    "Expiration" : "2017-05-17T15:09:54Z"
}
Le client peut les utiliser pendant une courte période et doit périodiquement obtenir de nouveaux certificats (jusqu'à leur Expiration). Le modèle est simple : AWS procède à une rotation fréquente des clés temporaires pour des raisons de sécurité, mais les clients peuvent les mettre en cache pendant quelques minutes, compensant la diminution de performance liée à l'obtention de nouveaux certificats.
AWS Java SDK doit s'occuper d'organiser ce processus, mais pour une raison quelconque, cela ne se produit pas.
Après avoir recherché des problèmes sur GitHub, nous sommes tombés sur le problème . Cela nous a aidés à déterminer la direction dans laquelle continuer à "creuser".
Le SDK AWS met à jour les certificats lorsque l'une des conditions suivantes est remplie :
- La date d'expiration de ceux-ci (
Expiration) tombe dansEXPIRATION_THRESHOLD, durement codé dans le code à 15 minutes. - Il est écoulé plus de temps depuis la dernière tentative de mise à jour des certificats que
REFRESH_THRESHOLD, difficilement codé à 60 minutes.
Pour voir la durée réelle d'expiration de nos certificats obtenus, nous avons exécuté les commandes cURL ci-dessus depuis le conteneur et depuis une instance EC2. La durée de validité du certificat obtenu depuis le conteneur s'est révélée beaucoup plus courte : exactement 15 minutes.
Tout est maintenant clair : pour la première demande, notre service recevait des certificats temporaires. Comme leur durée de validité ne dépassait pas 15 minutes, lors de la demande suivante, l'AWS SDK décidait de les mettre à jour. Cela se produisait à chaque demande.
Pourquoi la durée de validité des certificats a-t-elle diminué ?
Le service AWS Instance Metadata est conçu pour fonctionner avec des instances EC2, et non avec Kubernetes. D'un autre côté, nous ne voulions pas modifier l'interface des applications. Pour cela, nous avons utilisé — un outil qui permet, grâce à des agents sur chaque nœud Kubernetes, aux utilisateurs (ingénieurs déployant des applications dans le cluster) d'attribuer des rôles IAM aux conteneurs dans les pods comme s'ils étaient des instances EC2. KIAM intercepte les appels au service AWS Instance Metadata et les traite à partir de son cache, après les avoir obtenus d'AWS. Du point de vue de l'application, rien ne change.
KIAM fournit des certificats à court terme aux pods. C'est logique, étant donné que la durée de vie moyenne d'un pod est inférieure à celle d'une instance EC2. Par défaut, la durée de validité des certificats .
En fin de compte, si l'on superpose les deux valeurs par défaut, un problème surgit. Chaque certificat fourni à l'application expire après 15 minutes. De plus, l'AWS Java SDK met à jour de force tout certificat dont la date d'expiration est inférieure à 15 minutes.
En conséquence, le certificat temporaire est mis à jour à chaque demande, ce qui entraîne plusieurs appels à l'API AWS et provoque une augmentation significative de la latence. Dans l'AWS Java SDK, nous avons découvert , qui mentionne un problème similaire.
La solution était simple. Nous avons simplement reconfiguré KIAM pour demander des certificats avec une durée de validité plus longue. Dès que cela a été fait, les demandes ont commencé à passer sans faire appel au service AWS Metadata, et la latence est tombée même à un niveau inférieur à celui d'EC2.
Conclusions
D'après notre expérience des migrations, nous pouvons dire que l'une des sources les plus fréquentes de problèmes ne provient pas d'erreurs dans Kubernetes ou d'autres éléments de la plateforme. Elle n'est également pas liée à des défauts fondamentaux dans les microservices que nous transférons. Les problèmes surviennent souvent simplement parce que nous combinons différents éléments.
Nous mélangeons des systèmes complexes qui n'ont jamais interagi ensemble auparavant, espérant qu'ils formeront un tout unique et plus vaste. Hélas, plus il y a d'éléments, plus il y a de place pour les erreurs, plus l'entropie est élevée.
Dans notre cas, la latence élevée n'était pas le résultat d'erreurs ou de mauvaises décisions dans Kubernetes, KIAM, AWS Java SDK ou notre microservice. Elle résulte de la combinaison de deux paramètres indépendants définis par défaut : l'un dans KIAM, l'autre dans AWS Java SDK. Chacun a du sens pris séparément : la politique active de mise à jour des certificats dans AWS Java SDK et la courte durée de validité des certificats dans KIAM. Mais lorsqu'on les assemble, les résultats deviennent imprévisibles. Deux décisions indépendantes et logiques ne doivent pas nécessairement avoir du sens lorsqu'elles sont combinées.
P.S. de l'auteur
Pour en savoir plus sur l'architecture de l'outil KIAM pour l'intégration d'AWS IAM avec Kubernetes, vous pouvez consulter les créateurs de celui-ci.
Dans notre blog, vous pouvez également lire :
- «»;
- «»;
- «»;
- «».
Source : habr.com
