

Nous avons déjà parlé de , qui permet de développer des applications distribuées et de les empaqueter. Il ne reste plus qu'à apprendre à déployer ces applications et à les gérer. Ne vous inquiétez pas, nous avons tout prévu ! Nous avons rassemblé toutes les meilleures pratiques pour travailler avec Tarantool Cartridge et avons écrit , qui déploiera le paquet sur les serveurs, lancera les instances, les regroupera en cluster, configurera l'autorisation, initialisera vshard, activera le basculement automatique et mettra à jour la configuration du cluster.
Intéressé ? Alors suivez-nous, nous vous raconterons et montrerons tout.
Commençons par un exemple
Nous allons examiner seulement une partie des fonctionnalités de notre rôle. Vous pouvez toujours trouver une description complète de toutes ses capacités et paramètres d'entrée dans . Mais mieux vaut essayer une fois que de voir cent fois, alors déployons une petite application.
Tarantool Cartridge offre la création d'une petite application Cartridge qui stocke des informations sur les clients d'une banque et leurs comptes, tout en proposant une API pour gérer les données via HTTP. Pour ce faire, l'application décrit deux rôles possibles : api et storage, qui peuvent être attribués aux instances.
Le Cartridge lui-même ne dit rien sur la façon de lancer les processus, il offre seulement la possibilité de configurer les instances déjà lancées. Le reste doit être fait par l'utilisateur : placer les fichiers de configuration, lancer les services et configurer la topologie. Mais nous n'allons pas nous occuper de tout cela, Ansible s'en chargera pour nous.
Passons aux actes
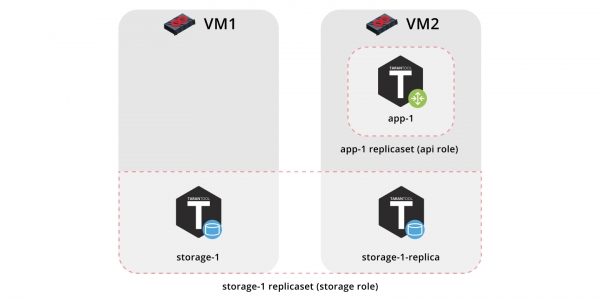
Alors, déployons notre application sur deux machines virtuelles et configurons une topologie simple :
- Replica set
app-1mettra en œuvre le rôleapi, qui inclut le rôlevshard-router. Il n'y aura qu'une seule instance ici. - Replica set
storage-1met en œuvre le rôlestorage(et en même tempsvshard-storage), nous ajouterons deux instances provenant de machines différentes.
Pour lancer l'exemple, nous aurons besoin de et (version 2.8 ou supérieure).
Le rôle se trouve sur . C'est un stockage qui permet de partager ses réalisations et d'utiliser des rôles prêts à l'emploi.
Clonons le dépôt avec l'exemple :
$ git clone https://github.com/dokshina/deploy-tarantool-cartridge-app.git
$ cd deploy-tarantool-cartridge-app && git checkout 1.0.0
Lançons les machines virtuelles :
$ vagrant upInstallons le rôle ansible de Tarantool Cartridge :
$ ansible-galaxy install tarantool.cartridge,1.0.1Lançons le rôle installé :
$ ansible-playbook -i hosts.yml playbook.ymlEn attendant que l'exécution du playbook soit terminée, passons à et profitons du résultat :
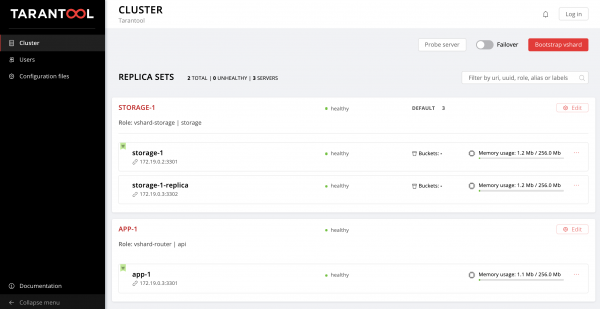
Nous pouvons maintenant injecter des données. C'est génial, n'est-ce pas ?
Et maintenant, comprenons comment travailler avec cela et ajoutons un autre replica set à la topologie.
Commençons à examiner
Alors, que s'est-il passé ?
Nous avons levé deux machines virtuelles et exécuté un playbook ansible qui a configuré notre cluster. Voyons le contenu du fichier playbook.yml:
---
- name: Déployer mon application Tarantool Cartridge
  hosts: all
  become: true
  become_user: root
  tasks:
  - name: Importer le rôle Tarantool Cartridge
    import_role:
      name: tarantool.cartridge
Il ne se passe rien d'intéressant ici, nous exécutons le rôle ansible qui s'appelle tarantool.cartridge.
Tout ce qui est important (c'est-à-dire, la configuration du cluster) se trouve dans -fichier hosts.yml:
---
all:
  vars:
    # variables communes au cluster
    cartridge_app_name: getting-started-app
    cartridge_package_path: .\/getting-started-app-1.0.0-0.rpm  # chemin vers le package

    cartridge_cluster_cookie: app-default-cookie  # cookie du cluster

    # options SSH communes
    ansible_ssh_private_key_file: ~\/..vagrant.d\/insecure_private_key
    ansible_ssh_common_args: '-o IdentitiesOnly=yes -o UserKnownHostsFile=\/dev\/null -o StrictHostKeyChecking=no'

  # INSTANCES
  hosts:
    storage-1:
      config:
        advertise_uri: '172.19.0.2:3301'
        http_port: 8181

    app-1:
      config:
        advertise_uri: '172.19.0.3:3301'
        http_port: 8182

    storage-1-replica:
      config:
        advertise_uri: '172.19.0.3:3302'
        http_port: 8183

  children:
    # GROUPEZ LES INSTANCES PAR MACHINE
    host1:
      vars:
        # options de connexion à la première machine
        ansible_host: 172.19.0.2
        ansible_user: vagrant

      hosts:  # instances à démarrer sur la première machine
        storage-1:

    host2:
      vars:
        # options de connexion à la seconde machine
        ansible_host: 172.19.0.3
        ansible_user: vagrant

      hosts:  # instances à démarrer sur la seconde machine
        app-1:
        storage-1-replica:

    # GROUPEZ LES INSTANCES PAR REPLICA SETS
    replicaset_app_1:
      vars:  # configuration du replica set
        replicaset_alias: app-1
        failover_priority:
          - app-1  # leader
        roles:
          - 'api'

      hosts:  # instances du replica set
        app-1:

    replicaset_storage_1:
      vars:  # configuration du replica set
        replicaset_alias: storage-1
        weight: 3
        failover_priority:
          - storage-1  # leader
          - storage-1-replica
        roles:
          - 'storage'

      hosts:   # instances du replica set
        storage-1:
        storage-1-replica:
Tout ce dont nous avons besoin, c'est d'apprendre à gérer les instances et les replica sets en modifiant le contenu de ce fichier. Par la suite, nous allons y ajouter de nouvelles sections. Pour ne pas vous perdre, vous pouvez jeter un œil à la version finale de ce fichier, hosts.updated.yml, qui se trouve dans le dépôt d'exemple.
Gestion des instances
En termes d'Ansible, chaque instance est un hôte (à ne pas confondre avec un serveur physique), c'est-à-dire un nœud d'infrastructure que Ansible gérera. Pour chaque hôte, nous pouvons spécifier les paramètres de connexion (tels que ansible_host et ansible_user), ainsi que la configuration de l'instance. La description des instances se trouve dans la section hosts.
Examinons la configuration de l'instance storage-1:
all:
  vars:
    ...

  # INSTANCES
  hosts:
    storage-1:
      config:
        advertise_uri: '172.19.0.2:3301'
        http_port: 8181

  ...
Dans la variable fichier config nous avons spécifié les paramètres de l'instance — URI de publicité et port HTTP.
Ci-dessous se trouvent les paramètres des instances app-1 et storage-1-replica.
Nous devons informer Ansible des paramètres de connexion pour chaque instance. Il semble logique de regrouper les instances par machines virtuelles. Pour cela, les instances sont regroupées en groupes host1 et host2, et dans chaque groupe, dans la section vars sont indiquées les valeurs ansible_host et ansible_user pour une machine virtuelle. Et dans la section hosts — les hôtes (qui sont également les instances) entrant dans ce groupe :
all:
  vars:
    ...
  hosts:
    ...
  children:
    # GROUPEZ LES INSTANCES PAR MACHINES
    host1:
      vars:
        # options de connexion de la première machine
        ansible_host: 172.19.0.2
        ansible_user: vagrant
       hosts:  # instances à démarrer sur la première machine
        storage-1:

     host2:
      vars:
        # options de connexion de la seconde machine
        ansible_host: 172.19.0.3
        ansible_user: vagrant
       hosts:  # instances à démarrer sur la seconde machine
        app-1:
        storage-1-replica:
Nous commençons à modifier hosts.yml. Ajoutons deux nouvelles instances, storage-2-replica sur la première machine virtuelle et storage-2 sur la seconde :
all:
  vars:
    ...

  # INSTANCES
  hosts:
    ...
    storage-2:  # <==
      config:
        advertise_uri: '172.19.0.3:3303'
        http_port: 8184

    storage-2-replica:  # <==
      config:
        advertise_uri: '172.19.0.2:3302'
        http_port: 8185

  children:
    # GROUPEZ LES INSTANCES PAR MACHINES
    host1:
      vars:
        ...
      hosts:  # instances à démarrer sur la première machine
        storage-1:
        storage-2-replica:  # <==

    host2:
      vars:
        ...
      hosts:  # instances à démarrer sur la seconde machine
        app-1:
        storage-1-replica:
        storage-2:  # <==
  ...
Lançons le playbook ansible :
$ ansible-playbook -i hosts.yml
                   --limit storage-2,storage-2-replica
                   playbook.yml
Notez l'option --limit. Comme chaque instance de cluster est un hôte en termes d'Ansible, nous pouvons indiquer explicitement quelles instances doivent être configurées lors de l'exécution du playbook.
Reconnectons-nous à l'interface Web et observons nos nouvelles instances :
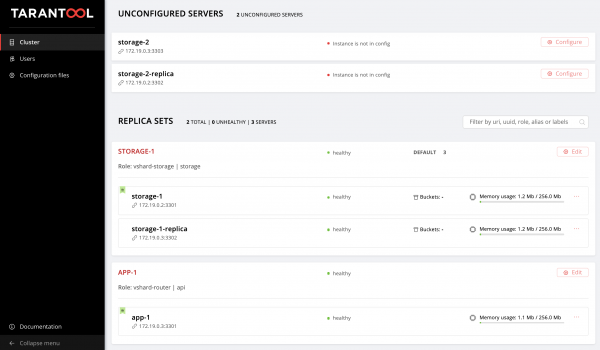
Ne restons pas sur nos lauriers et maîtrisons la gestion de la topologie.
Gestion de la topologie
Regroupons nos nouvelles instances dans un ensemble de réplicas storage-2. Ajoutons un nouveau groupe replicaset_storage_2 et décrivons dans ses variables les paramètres de l'ensemble de réplicas par analogie avec replicaset_storage_1. Dans la section hosts indiquons quelles instances entreront dans ce groupe (c'est-à-dire notre ensemble de réplicas) :
---
all:
  vars:
    ...
  hosts:
    ...
  children:
    ...
    # GROUPEZ LES INSTANCES PAR ÉQUIPEMENTS DE REPLIQUE
    ...
    replicaset_storage_2:  # <==
      vars:  # configuration de l'équipement de réplique
        replicaset_alias: stockage-2
        weight: 2
        failover_priority:
          - stockage-2
          - stockage-2-replica
        roles:
          - 'stockage'

      hosts:   # instances de l'équipement de réplique
        stockage-2:
        stockage-2-replica:
Nous relançons le playbook :
$ ansible-playbook -i hosts.yml
                   --limit replicaset_storage_2
                   --tags cartridge-replicasets
                   playbook.yml
Dans le paramètre --limit nous avons cette fois transmis le nom du groupe qui correspond à notre réplique.
Examinons l’option tags.
Notre rôle exécute successivement différentes tâches, qui sont marquées par les balises suivantes :
cartridge-instances: gestion des instances (configuration, connexion au membership);cartridge-replicasets: gestion de la topologie (gestion des répliques et suppression irréversible (expulser) des instances du cluster);cartridge-config: gestion des autres paramètres du cluster (vshard bootstrapping, mode de failover automatique, paramètres d'authentification et configuration de l'application).
Nous pouvons indiquer explicitement quelle partie du travail nous souhaitons effectuer, alors le rôle ignorera l'exécution des autres tâches. Dans notre cas, nous voulons travailler uniquement avec la topologie, donc nous avons indiqué cartridge-replicasets.
Évaluons le résultat de nos efforts. Trouvons la nouvelle réplique sur .
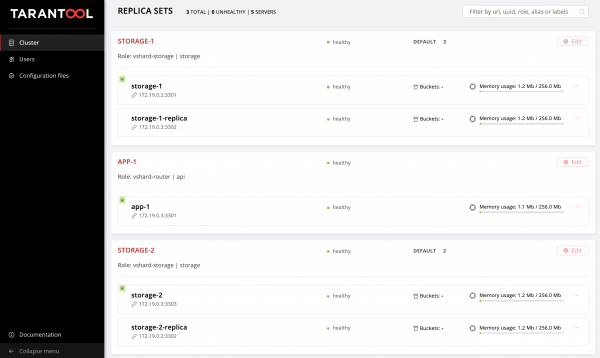
Hourra !
Expérimentez avec la modification de la configuration des instances et des répliques et observez comment la topologie du cluster change. Vous pouvez essayer différents scénarios, par exemple, ou augmentation de memtx_memory. Le rôle essaiera de le faire sans redémarrer l'instance, afin de minimiser le temps d'arrêt potentiel de votre application.
N'oubliez pas de lancer vagrant halt, pour arrêter les machines virtuelles lorsque vous avez fini de travailler avec elles.
Et qu'en est-il en coulisses ?
Ici, je vais expliquer plus en détail ce qui se passait sous le capot du rôle ansible pendant nos expérimentations.
Déployons une application Cartridge étape par étape.
Installation du paquet et démarrage des instances
Tout d'abord, il faut délivrer le paquet sur le serveur et l'installer. Actuellement, le rôle peut travailler avec des paquets RPM et DEB.
Ensuite, nous lançons les instances. C'est très simple : chaque instance est un service distinct. J'illustre avec un exemple : systemd$ systemctl start myapp@storage-1
Cette commande démarrera l'instance. L'instance lancée cherchera son storage-1 applications myapp. Les journaux de l'instance pourront être consultés avec dans /etc/tarantool/conf.d/Le fichier Unit journald.
pour le service systemd sera livré avec le paquet. /etc/systemd/system/myapp@.sevice le service systemd sera livré avec le paquet.
Ansible dispose de modules intégrés pour l'installation de packages et la gestion des services systemd, ici nous n'avons rien réinventé.
Configuration de la topologie du cluster
C'est ici que les choses deviennent vraiment intéressantes. Admettons qu'il serait étrange de se compliquer la vie avec un rôle ansible spécial pour l'installation de packages et le démarrage systemd-des services.
Vous pouvez configurer le cluster manuellement :
- Première option : ouvrez l'interface Web et cliquez sur des boutons. Pour un démarrage unique de plusieurs instances, cela conviendra parfaitement.
- Deuxième option : vous pouvez utiliser l'API GraphQl. Ici, vous pouvez automatiser quelque chose, par exemple, écrire un script en Python.
- Troisième option (pour les courageux) : connectez-vous au serveur, connectez-vous à l'une des instances via
tarantoolctl connectet effectuez toutes les manipulations nécessaires avec le module Luacartridge.
La principale tâche de notre invention est de réaliser pour vous cette partie du travail, la plus difficile.
Ansible vous permet d'écrire votre propre module et de l'utiliser dans un rôle. Notre rôle utilise de tels modules pour gérer différents composants du cluster.
Comment cela fonctionne-t-il ? Vous décrivez l'état souhaité du cluster dans une configuration déclarative, et le rôle fournit à chaque module sa section de configuration. Le module obtient l'état actuel du cluster et le compare à ce qu'il a reçu en entrée. Ensuite, via le socket de l'une des instances, un code est exécuté pour amener le cluster à l'état souhaité.
Résultats
Aujourd'hui, nous avons expliqué et montré comment déployer votre application sur Tarantool Cartridge et configurer une simple topologie. Pour cela, nous avons utilisé Ansible - un outil puissant, qui se distingue par sa simplicité d'utilisation et permet de configurer simultanément de nombreux nœuds d'infrastructure (dans notre cas, ce sont des instances de cluster).
Nous avons examiné ci-dessus l'un des nombreux moyens de décrire la configuration du cluster à l'aide d'Ansible. Une fois que vous serez prêt à aller plus loin, explorez les pour écrire des playbooks. Il se peut que vous trouviez plus pratique de gérer la topologie à l'aide de group_vars et host_vars.
Très bientôt, nous vous expliquerons comment supprimer définitivement (expulser) des instances de la topologie, effectuer un bootstrap vshard, gérer le mode de failover automatique, configurer l'authentification et patcher la configuration du cluster. En attendant, vous pouvez explorer par vous-même. et expérimenter avec les paramètres du cluster.
Si quelque chose ne fonctionne pas, n'hésitez pas à du problème. Nous nous en occuperons rapidement !
Source : habr.com
