

Déchiffrage du rapport de 2015 d'Ilia Kosmodemyansky "Ajustement de Linux pour améliorer les performances de PostgreSQL"
Avertissement : Je remarque que ce rapport date de novembre 2015 — plus de 4 ans se sont écoulés et beaucoup de temps a passé. La version de PostgreSQL mentionnée dans le rapport, la 9.4, n'est déjà plus prise en charge. Au cours des 4 dernières années, 5 nouvelles versions de PostgreSQL ont été publiées ainsi que 15 versions du noyau Linux. Si l'on devait réécrire ces parties, le rapport final serait différent. Cependant, les principes fondamentaux de l'optimisation de Linux pour PostgreSQL présentés ici sont toujours pertinents aujourd'hui.
Je m'appelle Ilia Kosmodemyansky. Je travaille pour l'entreprise PostgreSQL-Consulting. Je vais maintenant parler un peu de ce qu'il faut faire avec Linux concernant les bases de données en général et PostgreSQL en particulier, car les principes sont assez similaires.
De quoi allons-nous parler ? Si vous interagissez avec PostgreSQL, il faut, dans une certaine mesure, être un administrateur UNIX. Qu'est-ce que cela signifie ? Si nous comparons Oracle et PostgreSQL, alors dans Oracle, il faut être à 80 % un DBA de base de données et à 20 % un administrateur Linux.
Avec PostgreSQL, c'est un peu plus complexe. Il est nécessaire de mieux comprendre comment fonctionne Linux. Et en même temps, il faut un peu courir après le train, car dernièrement, il y a eu pas mal de mises à jour. De nouveaux noyaux sont publiés, de nouvelles fonctionnalités apparaissent, la performance s'améliore, etc.
Pourquoi parlons-nous de Linux ? Ce n'est pas seulement parce que nous sommes à la conférence Linux à Saint-Pétersbourg, mais parce que, dans les conditions modernes, l'un des systèmes d'exploitation les plus justifiés pour fonctionner avec des bases de données en général et avec PostgreSQL en particulier est Linux. En effet, FreeBSD, malheureusement, évolue dans une direction assez étrange. Cela entraînera des problèmes tant de performance que d'autres aspects. La performance de PostgreSQL sous Windows est un sujet sérieux en soi, liée au fait que Windows n'a pas de mémoire partagée comme UNIX, alors que PostgreSQL en dépend entièrement, car c'est un système multiprocessus.
Et l'exotisme comme Solaris, je pense, intéresse moins de monde, alors continuons.
Un distribution moderne de Linux dispose de plus de 1 000 paramètres syctl, selon la façon dont le noyau est compilé. De plus, si nous examinons différents réglages, il existe encore de nombreuses manières d'optimiser le système. Il y a des paramètres pour les systèmes de fichiers, comment ils doivent être montés. Si des questions se posent, comme comment démarrer : quels réglages activer dans le BIOS, comment configurer le matériel, etc.
C'est un volume très important dont on peut parler pendant plusieurs jours, et non en une courte présentation. Mais je vais m'arrêter sur des points importants, notamment comment éviter les pièges qui, à coup sûr, ne vous permettront pas de bien exploiter la base de données sous Linux si vous ne les corrigez pas. De plus, un point crucial est que de nombreux paramètres par défaut ne sont pas configurés de manière appropriée pour la base de données. Autrement dit, en mode par défaut, cela fonctionnera mal ou pas du tout.
Quels sont les objectifs d'optimisation traditionnels dans Linux ? Je pense que, puisque vous avez tous à faire à l'administration de Linux, il n'est pas nécessaire d'expliquer ce que sont les objectifs.
On peut optimiser :
- Le CPU.
- La mémoire.
- Le stockage.
- Autres. Nous en parlerons à la fin pour finir en beauté. Même des paramètres tels que la politique d'économie d'énergie peuvent avoir un impact très imprévisible et désagréable sur les performances.
Quelle est la spécificité de PostgreSQL et des bases de données en général ? Le problème est qu'il n'est pas possible d'optimiser un petit élément séparé et de constater que la performance s'est considérablement améliorée.
Oui, il existe de tels éléments, mais une base de données est un système complexe. Elle interagit avec toutes les ressources disponibles sur le serveur et préfère interagir pleinement. Si vous consultez les recommandations modernes d'Oracle sur l'utilisation du système d'exploitation hôte, cela ressemblera à la blague du cosmonaute mongol – il faut nourrir le chien et ne rien toucher. Donnons toutes les ressources à la base, la base de données s'en sortira toute seule.
En principe, la situation avec PostgreSQL est exactement la même à certains égards. La différence est que la base ne sait pas non plus récupérer toutes les ressources, donc il faut parfois gérer cela au niveau de Linux.
L'idée principale est de ne pas choisir un seul objectif et de commencer à l'optimiser, par exemple la mémoire, le CPU ou quelque chose dans ce genre, mais d'analyser la charge de travail et d'essayer d'améliorer au maximum le débit, afin que la charge générée par nos chers programmeurs, y compris nos utilisateurs, puisse passer le plus efficacement possible par notre base de données.
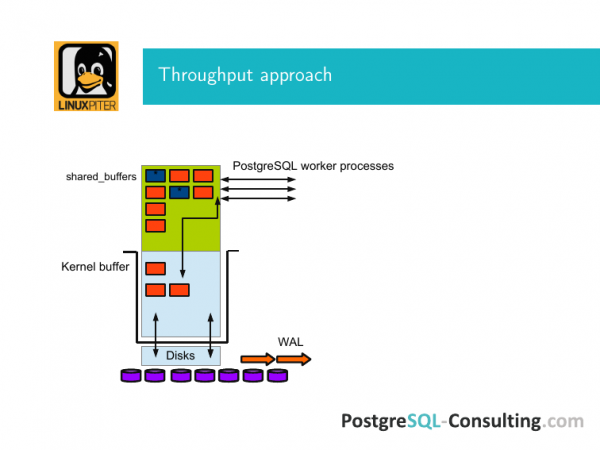
Voici une illustration pour expliquer ce qu'est cela. Il y a un buffer du système d'exploitation Linux, une mémoire partagée et des buffers partagés de PostgreSQL. Contrairement à Oracle, PostgreSQL fonctionne directement uniquement à travers le buffer du noyau, c'est-à-dire que pour qu'une page du disque arrive dans sa mémoire partagée, elle doit passer par le kernel buffer et revenir, c'est exactement la même situation.
Sous ce système se trouvent les disques. Je les ai dessinés comme des disques. En réalité, il peut y avoir un contrôleur RAID, etc.
Et donc cette opération d'entrée-sortie se fait d'une manière ou d'une autre à travers cela.
PostgreSQL est une base de données classique. À l'intérieur, il y a des pages. Toute l'entrée-sortie s'effectue par l'intermédiaire de pages. Nous montons des blocs en mémoire via des pages. Et si rien ne se passe, que nous les avons simplement lues, alors progressivement elles de ce cache, des buffers partagés, coulent et retournent sur le disque.
Si nous avons remplacé quelque chose quelque part, alors toute la page est marquée comme sale. Je les ai ici marquées en bleu. Cela signifie que cette page doit être synchronisée avec le stockage de blocs. Donc, lorsque nous l'avons rendue sale, nous avons écrit dans le WAL. Et à un moment donné, un événement appelé checkpoint s'est produit. Dans ce log, des informations ont été enregistrées indiquant qu'il est arrivé. Cela signifie que toutes les pages sales qui étaient là à ce moment dans ces buffers partagés, elles ont été synchronisées avec le disque de stockage par l'intermédiaire de fsync à travers le kernel buffer.
Pourquoi cela est-il fait ? Si nous perdons l'alimentation électrique, nous n'avons pas la situation où toutes les données sont perdues. La mémoire persistante, dont on nous a tant parlé, c'est encore dans la théorie des bases de données – c'est un avenir prometteur vers lequel nous tendons et que nous aimons, mais pour l'instant, elles vivent encore avec 20 ans de retard. Et bien sûr, il faut surveiller tout cela.
Et l'objectif de maximiser la bande passante est d'optimiser à toutes ces étapes pour que tout cela circule rapidement. La mémoire partagée est principalement un cache de pages. Dans PostgreSQL, nous avons envoyé une requête select quelque chose, il a récupéré ces données depuis le disque. Elles sont passées dans les buffers partagés. Par conséquent, pour que cela fonctionne mieux, il doit y avoir beaucoup de mémoire.
Pour que tout cela fonctionne bien et rapidement, vous devez configurer correctement le système d'exploitation à chaque étape. Et choisir un matériel équilibré, car si vous avez un déséquilibre à un certain endroit, vous pouvez avoir beaucoup de mémoire, mais elle sera desservie à une vitesse insuffisante.
Et nous allons passer en revue chacun de ces points.
Pour que ces pages se déplacent d'un endroit à l'autre plus rapidement, il faut atteindre les objectifs suivants :
- Tout d'abord, il faut travailler de manière plus efficace avec la mémoire.
- Deuxièmement, cette transition, lorsque les pages passent de la mémoire au disque, doit être plus efficace.
- Et troisièmement, il doit y avoir de bons disques.
Si vous avez 512 Go de mémoire vive dans le serveur et que tout cela arrive finalement sur un disque dur SATA sans aucun cache, alors tout le serveur de base de données ne va pas seulement se transformer en citrouille, mais en citrouille avec une interface SATA. Vous allez être directement confronté à cela. Et rien ne pourra vous sauver.
Concernant le premier point sur la mémoire, il y a trois choses qui peuvent sérieusement compliquer la vie.
La première est le NUMA. NUMA est destiné à améliorer les performances. En fonction de la charge de travail, on peut optimiser différentes choses. Et dans sa forme actuelle, elle n'est pas très adaptée à des applications comme les bases de données qui utilisent intensivement le cache de pages et les buffers partagés.
En bref. Comment savoir que quelque chose ne va pas avec le NUMA ? Vous avez une sorte de bruit désagréable, soudain un CPU se retrouve surchargé. Pendant ce temps, vous analysez les requêtes dans PostgreSQL et vous voyez qu'il n'y a rien de similaire. Ces requêtes ne devraient pas consommer autant de CPU. On peut mettre longtemps à le détecter. Il est plus simple de suivre dès le départ les recommandations appropriées pour configurer le NUMA pour PostgreSQL.
Que se passe-t-il réellement ? NUMA signifie Non-Uniform Memory Access. Quel est le principe ? Vous avez un CPU, à côté de lui se trouve sa mémoire locale. Et cette mémoire interconnectée peut récupérer de la mémoire d'autres CPU.
Si vous exécutez numactl --hardware, vous obtiendrez un gros rapport. Entre autres choses, il y aura un champ de distances. Il y aura des chiffres – 10-20, quelque chose dans ce genre. Ces chiffres ne sont rien d'autre que le nombre de sauts pour accéder à cette mémoire distante et l'utiliser localement. En principe, c'est une bonne idée. Cela améliore effectivement les performances dans certaines charges.
Imaginez maintenant qu'un CPU tente d'utiliser d'abord sa mémoire locale, puis essaie d'accéder à d'autres mémoires via interconnect pour des besoins divers. Et sur ce CPU se trouve tout votre cache de pages PostgreSQL – plusieurs gigaoctets. Vous vous trouvez toujours dans le pire des cas, car il y a généralement peu de mémoire directement disponible dans ce module. Et toute la mémoire qui est utilisée passe par ces interconnects. Cela devient lent et problématique. Et vous avez un processeur qui gère ce nœud, constamment surchargé. Et le temps d'accès à cette mémoire est mauvais et lent. C'est une situation à éviter si vous utilisez cela pour une base de données.
Ainsi, une option plus adéquate pour une base de données serait que le système d'exploitation Linux ne sache pas ce qui se passe. Pour qu'il accède à la mémoire de la même manière que d'habitude.
Pourquoi cela ? On pourrait penser que cela devrait être l'inverse. Cela se produit pour une raison simple : nous avons besoin de beaucoup de mémoire pour le cache de pages – des dizaines, des centaines de gigaoctets.
Et si nous avons alloué tout cela et mis nos données dans le cache, le gain à utiliser le cache sera considérablement plus important que le gain d'un accès intelligent à la mémoire. Ainsi, nous serons en mesure de gagner de manière incomparable par rapport à un accès plus efficace à la mémoire en utilisant le NUMA.
Il y a donc deux approches pour le moment, avant qu'un avenir meilleur n'arrive, où la base de données saura elle-même sur quels CPU elle fonctionne et d'où elle doit tirer des informations.
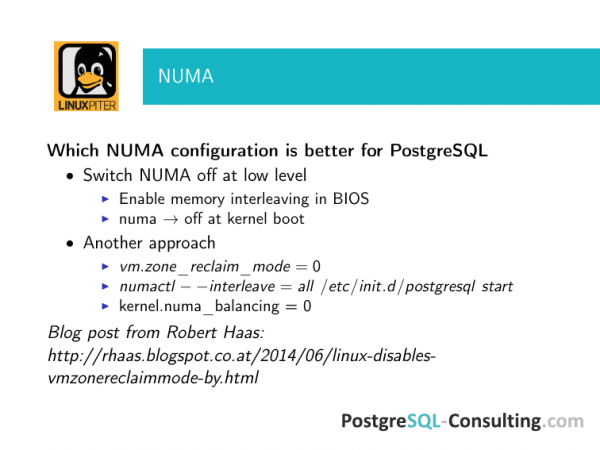
Ainsi, l'approche correcte est de désactiver totalement le NUMA., par exemple, au redémarrage. Dans la plupart des cas, les gains sont si importants qu'il n'y a même pas de question sur la meilleure option.
Il existe une autre option. Nous l'utilisons plus souvent que la première, car lorsque nous assistons un client, redémarrer le serveur est un gros problème pour lui. Son entreprise tourne là-dessus. Il rencontre des problèmes à cause du NUMA. Ainsi, nous essayons de désactiver de manière moins invasive que par un redémarrage, mais il faut être prudent et vérifier que cela a bien été désactivé. Car, comme l'expérience le montre, désactiver le NUMA sur le processus principal de PostgreSQL est une bonne idée, mais il n'est pas du tout certain que cela fonctionnera. Il faut vérifier et s'assurer que cela a bien été désactivé.
Il y a un bon article de Robert Haas. C'est l'un des committers de PostgreSQL. Un des développeurs clés de tous les éléments de bas niveau. Et si vous suivez les liens de cet article, vous y trouverez plusieurs histoires colorées sur la façon dont le NUMA compliquait la vie des gens. Regardez, examinez la checklist pour les administrateurs système sur ce qu'il faut configurer sur le serveur afin que notre base de données fonctionne correctement. Ces paramètres doivent être notés et vérifiés, car sinon, cela ne se passera pas très bien.
Je tiens à souligner que cela concerne tous les paramètres dont je vais parler. Mais généralement, les bases de données sont configurées en mode maître-esclave pour la tolérance aux pannes. N'oubliez pas d'appliquer ces paramètres sur l'esclave, car à un moment donné, vous aurez une panne, et vous passerez en mode esclave, qui deviendra le maître.
Dans une situation d'urgence, lorsque tout va mal, votre téléphone sonne sans cesse et votre supérieur arrive avec un gros bâton, vous n'aurez pas le temps de vérifier. Et les résultats peuvent être assez désastreux.
Le point suivant concerne les huge pages. Il est difficile de tester les huge pages séparément, et cela n'a pas beaucoup de sens, bien qu'il existe des benchmarks qui peuvent le faire. Ils se recherchent facilement sur Internet.
Quel est le but ? Vous avez un serveur pas très cher, avec beaucoup de mémoire vive, par exemple, plus de 30 Go. Vous n'utilisez pas de huge pages. Cela signifie que vous avez certainement un surcoût lié à l'utilisation de la mémoire. Et ce surcoût n'est pas des plus agréables.
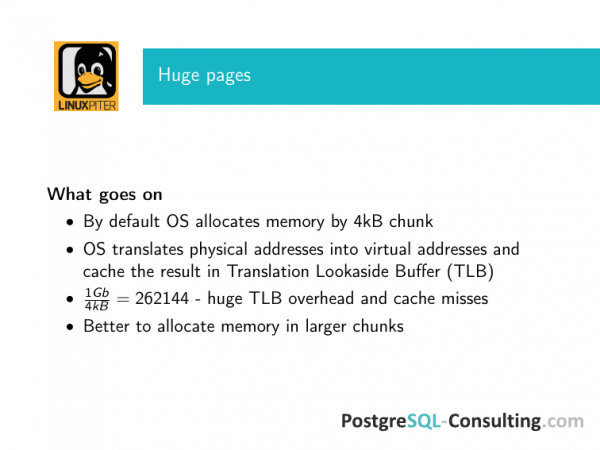
Pourquoi cela ? Que se passe-t-il ? Le système d'exploitation alloue de la mémoire par petits morceaux. C'est pratique, c'est historiquement comme ça. Et si on entre dans les détails, le système d'exploitation doit traduire les adresses virtuelles en adresses physiques. C'est un processus qui n'est pas des plus simples, c'est pourquoi le système d'exploitation met en cache le résultat de cette opération dans le Translation Lookaside Buffer (TLB).
Et puisque le TLB est un cache, des problèmes typiques de cache se posent dans cette situation. Tout d'abord, si vous avez beaucoup de mémoire vive et qu'elle est entièrement allouée par petits morceaux, alors ce tampon devient très grand. Et si le cache est gros, il est plus lent à rechercher. Le surcoût est important et consomme de l'espace, c'est-à-dire que quelque chose de non optimal consomme la mémoire vive. C'est un problème.
Deux – plus le cache s'agrandit dans une telle situation, plus la probabilité de manquer de cache augmente. L'efficacité de ce cache diminue rapidement avec la taille croissante. C'est pourquoi les systèmes d'exploitation ont mis au point une approche simple. Dans Linux, cela est utilisé depuis longtemps. Dans FreeBSD, cela a récemment été introduit. Mais parlons de Linux. Ce sont les huge pages.
Il convient de noter ici que les huge pages, en tant qu'idée, ont été initialement soutenues par des communautés comprenant Oracle et IBM, c'est-à-dire que les producteurs de bases de données ont bien pensé que cela serait utile, notamment pour les bases de données.
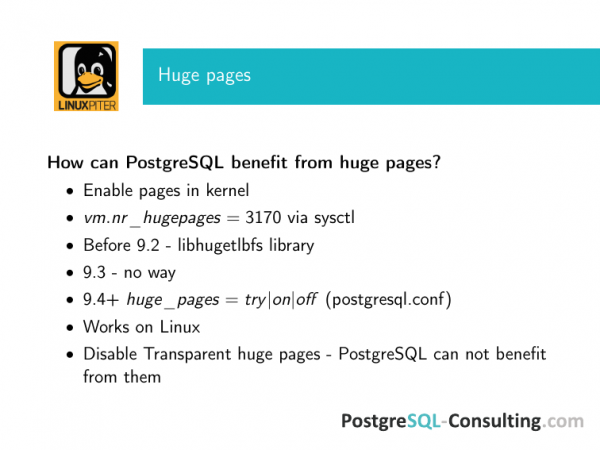
Et comment cela s'intègre-t-il avec PostgreSQL ? Tout d'abord, le noyau Linux doit avoir des huge pages activées.
Deuxièmement, elles doivent être explicitement spécifiées par le paramètre sysctl – combien il y en a. Les chiffres ici proviennent d'un ancien serveur. Vous pouvez estimer combien de buffers partagés vous avez pour que les huge pages puissent y entrer.
Et si vous avez entièrement alloué le serveur à PostgreSQL, un bon point de départ est de consacrer soit 25 % de la mémoire vive aux buffers partagés, soit 75 %, si vous êtes sûr que votre base de données pourra tenir dans ces 75 %. C'est le premier point de départ. Et calculez, si vous avez 256 Go de mémoire vive, alors vous aurez 64 Go de buffers partagés. Estimez à peu près avec une marge – quelle devrait être cette valeur.
Avant la version 9.2 (si je ne me trompe pas, depuis la version 8.2), il était possible d'intégrer PostgreSQL avec les huge pages à l'aide d'une bibliothèque tierce. Et cela doit toujours être fait. Tout d'abord, vous devez vous assurer que le noyau peut allouer correctement les huge pages. Et ensuite, l'application qui travaille avec elles doit pouvoir en profiter. Elle ne pourra pas y accéder simplement. Étant donné que PostgreSQL allouait de la mémoire dans le style de system 5, cela pouvait être fait avec libhugetlbfs – tel est le nom complet de la bibliothèque.
Dans la version 9.3, les performances de PostgreSQL en matière de gestion de la mémoire ont été améliorées, et la méthode d'allocation de mémoire system 5 a été abandonnée. Tout le monde était ravi, car sinon, lorsque vous essayiez de lancer deux instances de PostgreSQL sur une seule machine, il signalait un manque de mémoire partagée. Il disait qu'il fallait modifier sysctl. Et avec ce sysctl, il fallait également redémarrer, et ainsi de suite. En gros, tout le monde était content. Mais l'allocation de mémoire mmap a cassé l'utilisation des huge pages. La plupart de nos clients utilisent de grands buffers partagés. Et nous avons fortement recommandé de ne pas passer à la version 9.3, car cela entraînait un overhead significatif.
Cependant, la communauté a porté une attention particulière à ce problème et a procédé à des modifications importantes dans la version 9.4. De plus, un paramètre a été ajouté dans postgresql.conf, permettant de l'activer, de le mettre sur on ou off.
Le paramètre Try est le plus sûr. Au démarrage de PostgreSQL, lorsqu'il alloue de la mémoire partagée, il essaie de l'obtenir à partir des huge pages. Si cela échoue, il revient à l'allocation classique. Si vous êtes sous FreeBSD ou Solaris, vous pouvez mettre try, c'est toujours sûr.
Si on le met sur on, il ne démarre pas s'il ne parvient pas à allouer des huge pages. C'est une question de préférences personnelles. Mais si vous optez pour try, assurez-vous que les allocations nécessaires ont bien été réalisées, car il y a beaucoup de marges d’erreur. Maintenant, cette fonctionnalité ne fonctionne que sur Linux.
Une petite remarque avant de continuer. Les transparent huge pages ne concernent pas encore PostgreSQL. Actuellement, il ne peut pas vraiment en profiter. Et pour les transparent huge pages, pour une charge de travail nécessitant un grand morceau de mémoire partagée, les avantages n'apparaissent qu'à des volumes très élevés. Si vous avez des téraoctets de mémoire, cela peut être significatif. Cependant, pour des applications plus courantes, où vous disposez de 32, 64, 128 ou 256 Go de mémoire sur une machine, les huge pages normaux sont suffisants, tandis que les transparent huge pages doivent simplement être désactivés.
Enfin, un dernier point concernant la mémoire, qui n'est pas directement lié au débit, mais qui peut causer beaucoup de problèmes. L'ensemble de la bande passante peut être gravement affecté si le serveur swap constamment.
Et cela sera très désagréable à plusieurs moments. Le principal problème est que dans les noyaux modernes, le comportement diffère légèrement de celui des noyaux Linux plus anciens. C'est une situation assez délicate, parce que, lorsque nous parlons de gestion de l'échange, cela se termine souvent par l'arrivée tardive de l'OOM-killer. Et le fait que l'OOM-killer arrive en retard et mette fin à PostgreSQL est désagréable. Tout le monde en sera informé, c'est-à-dire jusqu'au dernier utilisateur.
Que se passe-t-il ? Vous avez beaucoup de mémoire vive, tout fonctionne bien. Mais pour une raison quelconque, le serveur se bloque dans l'échange et s'enlente à cause de cela. On pourrait penser qu'il y a beaucoup de mémoire, mais cela arrive quand même.
Auparavant, nous recommandions de définir vm.swappiness à zéro, c'est-à-dire de désactiver l'échange. On pensait que 32 Go de mémoire vive et des buffers partagés adéquats représentaient une énorme quantité. La principale fonction de l'échange est de disposer d'un espace où jeter le résidu, si nous avons un plantage. Et cela ne s'est pas vraiment produit. Et que ferez-vous ensuite avec ce résidu ? C'est une tâche où il n'est pas très clair pourquoi l'échange est nécessaire, surtout d'une telle taille.
Cependant, dans les versions plus modernes, à savoir la troisième version des noyaux, le comportement a changé. Si vous définissez l'échange à zéro, c'est-à-dire que vous l'éteignez, tôt ou tard, même avec un certain reste de mémoire vive, l'OOM-killer viendra pour éliminer les consommateurs les plus intensifs. Parce qu'il pensera qu'avec cette charge de travail, il nous reste encore un peu et nous allons manquer, c'est-à-dire qu'il ne tuera pas un processus système, mais quelque chose de moins important. Ce moins important sera un consommateur intensif de mémoire partagée, en l'occurrence le postmaster. Et après cela, il vaut mieux ne pas avoir à restaurer la base de données.
Ainsi, maintenant par défaut, autant que je me souvienne, la plupart des distributions sont autour de 6, c'est-à-dire à quel moment commencer à utiliser l'échange en fonction de la quantité de mémoire restante. Nous recommandons actuellement de définir vm.swappiness = 1, car cela le désactive pratiquement, mais ne provoque pas des effets tels que l'arrivée inattendue de l'OOM-killer qui met tout cela fin.
Quoi de neuf ? Lorsque nous parlons de performance des bases de données et que nous nous rapprochons progressivement des disques, tout le monde commence à se rendre compte des difficultés. Car la vérité selon laquelle le disque est lent et la mémoire rapide est bien connue de tous depuis l'enfance. Et tout le monde sait qu'il y aura des problèmes de performance disque dans une base de données.
Le principal problème de performance de PostgreSQL lié aux pics de checkpoints ne vient pas du fait que le disque est lent. C'est plutôt à cause du déséquilibre entre la bande passante de la mémoire et celle du disque. D'ailleurs, cet équilibre peut être rompu à différents niveaux. PostgreSQL n'est pas configuré, le système d'exploitation n'est pas configuré, le matériel n'est pas réglé et le matériel est incorrect. Et ce problème ne se manifeste que si tout fonctionne comme prévu, c'est-à-dire soit en l'absence de charge, soit avec des réglages et du matériel bien choisis.
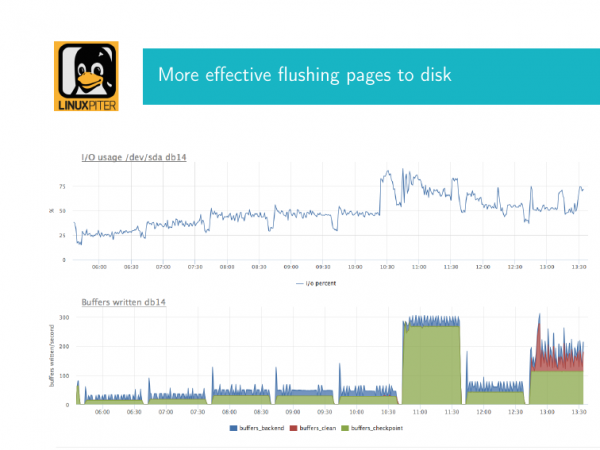
Qu'est-ce que c'est et à quoi ça ressemble ? En général, les personnes qui travaillent avec PostgreSQL ont été confrontées à cela à plusieurs reprises. Je vais expliquer. Comme je l'ai mentionné, PostgreSQL effectue périodiquement des checkpoints pour transférer les pages sales de la mémoire partagée vers le disque. Si nous avons un grand volume de mémoire partagée, le checkpoint commence à impacter intensément le disque, car il transfère ces pages avec fsync. Elles arrivent dans le tampon du noyau et sont écrites sur les disques à l'aide de fsync. Et si ce volume est important, nous pouvons observer un effet désagréable, à savoir une très forte utilisation des disques.
J'ai ici deux images. Je vais maintenant expliquer ce que c'est. Ce sont deux graphiques corrélés dans le temps. Le premier graphique - c'est l'utilisation du disque. Ici, elle atteint presque 90 % à ce moment-là. Si votre base de données est liée à des disques physiques, avec un contrôleur RAID et que l'utilisation atteint 90 %, ce sont de mauvaises nouvelles. Cela signifie qu'un peu plus et nous atteindrons 100, ce qui arrêtera les entrées-sorties.
Si vous avez un ensemble de disques, l'histoire est un peu différente. Cela dépend de la manière dont il est configuré, de la nature de l'ensemble, etc.
Parallèlement, un graphique configuré à partir de la vue interne de Postgres montre comment se déroule le checkpoint. En vert, on indique le nombre de buffers, c'est-à-dire ces pages sales qui ont été transférées à ce moment-là pour la synchronisation lors de ce checkpoint. C'est l'essentiel à savoir ici. Nous voyons qu'il y a beaucoup de pages arrivées, et à un moment donné, nous avons atteint la limite, c'est-à-dire que nous avons beaucoup écrit, et il est évident que le système de disque est très sollicité. Nous constatons que le checkpoint a un impact significatif sur le disque. Idéalement, la situation devrait plutôt ressembler à ceci, c'est-à-dire que nous avons moins d'écritures ici. Nous pouvons résoudre cela par des réglages, afin que cela reste ainsi à l'avenir. Cela signifie que l'utilisation est faible, mais que nous écrivons quand même quelque chose ici.
Que faut-il faire pour résoudre ce problème ? Si vous avez arrêté les IO sous la base de données, cela signifie que tous les utilisateurs qui essaient d'exécuter leurs requêtes devront attendre.
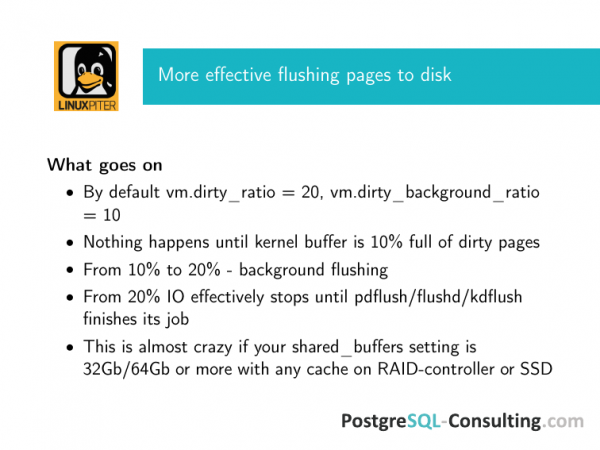
Si l'on examine cela du point de vue de Linux, si vous avez un bon matériel, que vous l'avez correctement configuré, et que vous avez bien réglé PostgreSQL pour qu'il réalise ces checkpoints moins fréquemment, en les répartissant dans le temps, vous tombez sur les paramètres par défaut de Debian. Pour la plupart des distributions Linux, voici les valeurs typiques : vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Qu'est-ce que cela signifie ? À partir du noyau 2.6, un démon de vidage est apparu, appelé pdflush, en fonction de ce qui est utilisé, qui s'occupe de l'éjection des pages sales du buffer du noyau en arrière-plan et de leur vidage, peu importe les circonstances, lorsque le vidage en arrière-plan ne suffit pas.
Quand se produit le vidage en arrière-plan ? Lorsque 10 % de la mémoire vive totale du serveur est occupée par des pages sales dans le buffer du noyau, une fonction spéciale est appelée pour effectuer le vidage en arrière-plan. Pourquoi est-elle en arrière-plan ? Elle prend comme paramètre le nombre de pages à vider. Elle peut, par exemple, vider N pages. Puis, pendant un certain temps, cet élément se met en pause. Ensuite, il revient et vide un certain nombre de pages supplémentaires.
C'est une histoire très simple. C'est comme avec une piscine, lorsque quelque chose entre par un tuyau et sort par un autre. Notre checkpoint est arrivé, et s'il a envoyé peu de pages sales pour le vidage, alors progressivement, le pgflush dans le buffer du noyau s'en débarrassera également.
Si ces pages sales continuent de s'accumuler, elles atteindront 20 %, après quoi le système d'exploitation priorisera l'écriture de ces données sur le disque, car une coupure d'alimentation se produira, et tout ira mal pour nous. Nous perdrons ces données, par exemple.
Quelle est l'astuce ? L'astuce est que ces paramètres dans le monde moderne, 20 et 10 % de toute la mémoire vive de la machine, sont tout simplement monstrueux du point de vue de la bande passante de n'importe quelle système de disque que vous avez.
Imaginez que vous avez 128 Go de mémoire vive. 12,8 Go se retrouvent dans votre système de disque. Peu importe le cache que vous avez ou le tableau que vous utilisez, ils ne supporteront pas cela.
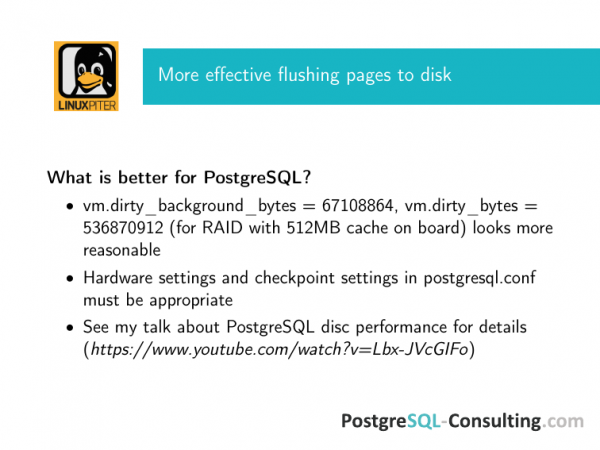
C'est pourquoi nous recommandons de configurer ces chiffres immédiatement en fonction des capacités de votre contrôleur RAID. J'ai ici une recommandation pour un contrôleur disposant de 512 Mo de cache.
Tout est très simple. On peut définir vm.dirty_background en octets. Ces réglages annulent les deux précédents. Soit le ratio par défaut, soit ceux qui sont activés en octets fonctionneront. Mais en tant que consultant DBA travaillant avec différents clients, j'essaie de prendre des précautions, donc si c'est en octets, alors c'est en octets. Personne n'a garanti qu'un bon administrateur ne rajoutera pas de mémoire au serveur, ne le redémarrera pas, et que le chiffre restera le même. Il suffit de calculer ces chiffres pour être sûr que tout y rentre.
Que se passe-t-il si vous ne rentrez pas ? Il est indiqué qu'un quelconque système de flushing est effectivement arrêté, mais en réalité c'est une figure de style. Le système d'exploitation a un gros problème : il a beaucoup de pages sales, donc c'est l'IO généré par vos clients qui est effectivement arrêté, c’est-à-dire qu'une application SQL veut envoyer une requête à la base de données, elle attend. Tout I/O vers celle-ci a la plus basse priorité, car la base est occupée par le checkpoint. Et quand cela se terminera, est totalement incertain. Et quand vous atteignez le flushing non de fond, cela signifie que tout votre IO est occupé par cela. Et tant que ce n'est pas terminé, vous ne pourrez rien faire.
Il y a aussi deux points importants qui sortent du cadre de cette présentation. Ces réglages doivent correspondre aux réglages dans postgresql.conf, c'est-à-dire les réglages de checkpoints. Et votre système de disque doit être correctement configuré. Si vous avez un cache sur RAID, il doit être équipé d'une batterie. Les gens achètent des RAID avec un bon cache sans batterie. Si vous avez des SSD en RAID, ils doivent être serveur, et il doit y avoir des condensateurs. Voici une liste de contrôle détaillée. Ce lien contient mon rapport sur la manière de configurer la performance des disques dans PostgreSQL. Toutes ces listes de contrôle y figurent.
Qu'est-ce qui peut encore compliquer la vie ? Ce sont deux paramètres. Ils sont relativement nouveaux. Ils peuvent être activés par défaut dans différentes applications. Et ils peuvent compliquer la vie tout autant s'ils sont mal configurés.
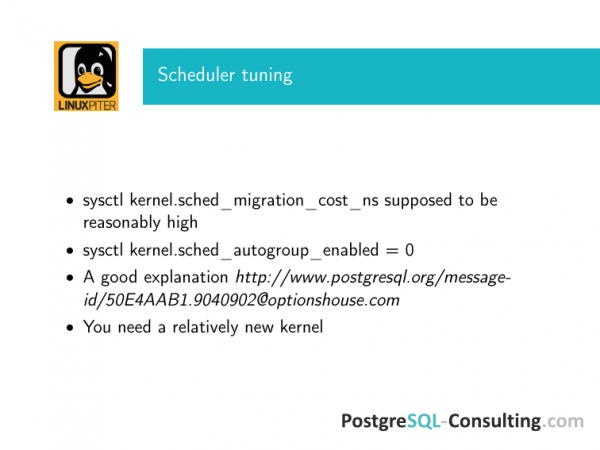
Il y a deux éléments relativement nouveaux. Ils apparaissent déjà dans les trois noyaux. C'est sched_migration_cost en nanosecondes et sched_autogroup_enabled, qui est un.
Et comment cela complique-t-il la vie ? Qu'est-ce que sched_migration_cost ? Le planificateur de Linux peut migrer un processus d'un CPU à un autre. Et pour PostgreSQL, qui exécute des requêtes, la migration vers un autre CPU n'est pas certaine. Du point de vue du système d'exploitation, lorsque vous basculez entre openoffice et le terminal, cela peut être bon, mais pour une base de données, c'est très mauvais. Par conséquent, une politique raisonnable consiste à définir un migration_cost à une valeur élevée, au moins plusieurs milliers de nanosecondes.
Que cela signifiera-t-il pour le planificateur ? Il considèrera qu'au cours de ce temps, ce processus est toujours chaud. C'est-à-dire, si vous avez une longue transaction qui traite quelque chose, le planificateur va le comprendre. Il considérera que tant que ce délai n'est pas écoulé, il n'est pas nécessaire de migrer ce processus. Si le processus effectue une tâche, il ne sera pas migré et continuera à s'exécuter sur le CPU qui lui a été attribué. Et le résultat est excellent.
Le deuxième point concerne autogroup. C'est une bonne idée pour des charges de travail spécifiques qui n'ont rien à voir avec les bases de données modernes - regrouper les processus par terminal virtuel à partir duquel ils ont été lancés. C'est pratique pour certaines tâches. En pratique, PostgreSQL est un système multi-processus avec un mécanisme de pré-allocation, qui se lance à partir d'un terminal unique. Vous avez un verrou d'écriture, un point de contrôle, et toutes vos requêtes clients sont regroupées sur un seul planificateur, sur un seul CPU. Elles attendront alors d'être libérées, s'empêchant mutuellement de le monopoliser trop longtemps. Cette situation est complètement inappropriée en cas de charge élevée, il est donc nécessaire de la désactiver.
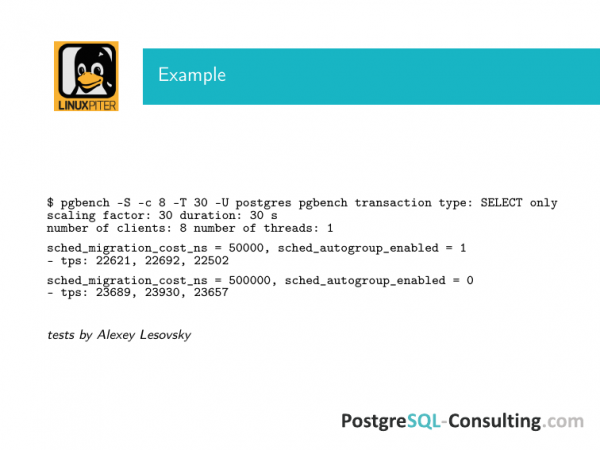
Mon collègue Alexeï Lesovski a effectué des tests avec un simple pgbench, augmentant l'ordre de grandeur du migration_cost et désactivant l'autogroup. La différence sur du matériel de mauvaise qualité a atteint presque 10 %.Il y a une discussion dans la mailing list de Postgres où des utilisateurs partagent les résultats sur la façon dont de tels changements affectent la vitesse des requêtes. Cela a eu un impact sur 50 %.De telles histoires sont assez fréquentes.
Et enfin, parlons de la politique d'économie d'énergie. Heureusement, Linux peut maintenant être utilisé sur un ordinateur portable. Il est censé être efficace en termes de consommation d'énergie. Mais il s'avère soudainement que cela peut également être appliqué sur un serveur.
De plus, si vous louez des serveurs auprès d'un hébergeur, ces derniers ne s'inquiètent pas de vous assurer une meilleure performance. Leur objectif est de faire en sorte que leur matériel soit utilisé de la manière la plus efficace possible. Par conséquent, ils peuvent par défaut activer le mode économie d'énergie sur le système d'exploitation. hébergement Si vous utilisez ce genre de configuration sur un serveur avec une base de données sous une charge intensive, votre choix doit être acpi_cpufreq + performance. Même avec ondemand, vous rencontrerez déjà des problèmes.
Intel_pstate est un peu différent comme pilote. Actuellement, la préférence va à celui-ci, considéré comme plus récent et mieux fonctionnant.
Par conséquent, le gouverneur doit être exclusivement performance. Ondemand, powersave et tout le reste ne vous concernent pas.
Les résultats d'un explain analyze sur PostgreSQL peuvent varier de plusieurs ordres de grandeur si vous activez powersave, car pratiquement, le CPU sera planifié de manière totalement imprévisible sous votre base.
Ces réglages peuvent être activés par défaut. Regardez attentivement si cela n'a pas été activé par défaut. Cela pourrait vraiment poser un gros problème.
Ces paramètres pourraient être activés par défaut. Vérifiez attentivement qu'ils ne sont pas activés par défaut. Cela pourrait réellement être un gros problème.
Et pour terminer, je tiens à remercier les membres de notre équipe DBA de PosgreSQL-Consulting, notamment Max Bogouk et Alexey Lesovsky, qui rencontrent des difficultés chaque jour dans ce domaine. Pour nos clients, nous nous efforçons de faire en sorte que tout fonctionne de manière optimale. C'est un peu comme les consignes de sécurité aérienne. Tout y est écrit avec le sang. Chacun de ces boulons a été découvert au cours de divers problèmes. Je suis heureux de les partager avec vous.
Questions :
Merci ! Par exemple, si une entreprise souhaite économiser et héberger à la fois la base de données et la logique applicative sur un même serveur, ou si elle suit la tendance moderne des architectures microservices, où PostgreSQL est exécuté dans un conteneur. Quel est le truc ? Les paramètres sysctl affectent globalement tout le noyau. Je n'ai jamais entendu dire que sysctl était virtualisé de manière à fonctionner séparément dans un conteneur. Il n'y a que les cgroups et là, il n'y a un contrôle que sur une partie. Comment peut-on vivre avec ça ? Ou si vous souhaitez des performances, lancez PostgreSQL sur un serveur physique distinct et configurez-le ?
Nous avons répondu à votre question de trois manières différentes. S'il ne s'agit pas d'un serveur physique que l'on peut configurer, détendez-vous, tout fonctionnera bien sans ces réglages. Si vous êtes soumis à une telle charge qu'il faille procéder à ces ajustements, vous passerez au serveur physique bien avant d'atteindre ces réglages.
Quel est le problème ? Si c'est une machine virtuelle, vous rencontrerez probablement de nombreux problèmes, comme le fait qu'il y a une latence disque souvent incohérente sur la plupart des machines virtuelles. Même si la bande passante des disques est bonne, une seule transaction d'entrée-sortie qui échoue, n'impactant pas beaucoup la bande passante moyenne, qui se produit au moment d'un checkpoint ou lors de l'écriture dans le WAL, peut gravement affecter la base de données. Et vous remarquerez cela bien avant de vous heurter à ces problèmes.
Si vous avez NGINX hébergé sur le même serveur, vous rencontrerez le même problème. Il se battra pour la mémoire partagée. Et vous n'arriverez pas à ces problèmes décrits ici.
Cependant, d'un autre côté, certains de ces paramètres seront tout de même pertinents pour vous. Par exemple, avec sysctl, définissez dirty_ratio pour qu'il ne soit pas aussi extrême - dans tous les cas, cela aidera. Quoi qu'il en soit, vous aurez des interactions avec le disque. Et cela se fera selon un schéma incorrect. Ces paramètres que j'ai montrés sont par défaut. De toute façon, il vaut mieux les modifier.
Et il peut y avoir des problèmes avec NUMA. VmWare, par exemple, fonctionne bien avec NUMA avec des paramètres exactement opposés. Il faut donc choisir – serveur physique ou non.
J'ai une question concernant Amazon AWS. Ils ont des images préconfigurées. L'une d'elles s'appelle Amazon RDS. Y a-t-il des paramètres personnalisés pour leur système d'exploitation ?
Il y a des paramètres, mais ce sont d'autres réglages. Ici, nous configurons le système d'exploitation en fonction de la manière dont la base de données va l'utiliser. Là-bas, il existe des paramètres qui définissent la direction dans laquelle nous devons aller, un certain shaping. C'est-à-dire que nous avons besoin de ces ressources, nous allons les consommer maintenant. Après cela, Amazon RDS attache ces ressources, et la performance chute. Il y a des récits où des gens commencent à bidouiller cela. Parfois, même avec un certain succès. Mais cela n'a rien à voir avec les réglages du système d'exploitation. C'est un peu du hacking dans le cloud. C'est une autre histoire.
Pourquoi les Transparent huge pages ne donnent-ils pas d'effet par rapport aux Huge TLB ?
Ils n'en donnent pas. Cela peut être expliqué de plusieurs manières. Mais en fait, ils ne le font tout simplement pas. Quelle est l'histoire de PostgreSQL ? Lors de son démarrage, il alloue un grand morceau de mémoire partagée. Qu'ils soient transparents ou non – c'est complètement secondaire. Le fait qu'ils soient alloués au démarrage explique tout. Et si la mémoire est très grande et qu'il faut réorganiser le segment shared_memory, alors Transparent huge pages sera pertinent. Avec PostgreSQL, il est simplement alloué en un grand morceau au démarrage et puis il ne se passe rien de particulier. On peut bien sûr les utiliser, mais il y a un risque d'obtenir une shared_memory corrompue lorsqu'il va réallouer quelque chose. PostgreSQL n'en est pas conscient.
Source : habr.com
