

Nous étions en 2019, et nous n'avions toujours pas de solution standard pour l'agrégation des logs dans Kubernetes. Dans cet article, nous aimerions partager nos recherches, les problèmes rencontrés et leurs solutions, en utilisant des exemples tirés de la pratique réelle.
Cependant, je tiens à préciser que les différents clients comprennent le rassemblement des logs de manières très variées :
- certaines personnes veulent voir les logs de sécurité et d’audit ;
- d'autres souhaitent une journalisation centralisée de toute l'infrastructure ;
- tandis que certains se contentent de rassembler uniquement les logs de l'application, en excluant, par exemple, les équilibreurs de charge.
Sur la manière dont nous avons mis en œuvre divers « souhaits » et les difficultés rencontrées, c'est ci-dessous.
Théorie : outils pour les logs
Contexte sur les composants du système de journalisation
La journalisation a parcouru un long chemin, ce qui a permis d'élaborer des méthodologies pour la collecte et l'analyse des logs, que nous appliquons aujourd'hui. Déjà dans les années 1950, Fortran a introduit un équivalent des flux standards d'entrée-sortie qui aidaient les programmeurs à déboguer leur code. Ce furent les premiers logs informatiques, qui facilitaient la vie des programmeurs de l'époque. Aujourd'hui, nous y voyons le premier composant du système de journalisation — la source ou « producteur » (producer) de logs.
L'informatique n'est pas restée statique : des réseaux informatiques sont apparus, suivis de premiers clusters... Des systèmes complexes, composés de plusieurs ordinateurs, ont commencé à fonctionner. Les administrateurs système ont donc dû commencer à collecter des logs provenant de plusieurs machines, et dans des cas particuliers, ils pouvaient également ajouter des messages du noyau du système d'exploitation pour enquêter éventuellement sur une panne système. Pour décrire les systèmes de collecte centralisée des logs, un document est sorti au début des années 2000, , qui a normalisé remote_syslog. Un autre composant important a ainsi été introduit : le collecteur (système de collecte) de logs et leur stockage.
Avec l'augmentation du volume des logs et l'adoption généralisée des technologies web, la question s'est posée de savoir comment présenter les logs de manière conviviale pour les utilisateurs. Les simples outils en console (awk/sed/grep) ont été remplacés par des visualiseurs de logs — le troisième composant.
Avec l'augmentation du volume des logs, une autre constatation est devenue claire : les logs sont nécessaires, mais pas tous. De plus, différents logs nécessitent différents niveaux de conservation : certains peuvent être perdus après un jour, tandis que d'autres doivent être conservés pendant 5 ans. Ainsi, un composant de filtrage et de routage des flux de données a été ajouté au système de journalisation — appelons-le filtre.
Les stockages ont également fait un bond important : nous sommes passés de fichiers ordinaires à des bases de données relationnelles, puis à des stockages orientés document (comme Elasticsearch). Ainsi, le stockage s'est séparé du collecteur.
En fin de compte, la notion même de log s'est élargie à un certain flux abstrait d'événements que nous souhaitons préserver pour l'histoire. Plus précisément, pour le cas où il serait nécessaire de mener une enquête ou de rédiger un rapport analytique…
Ainsi, en relativement peu de temps, la collecte de logs est devenue un sous-système important, que l'on peut à juste titre considérer comme l'un des sous-domaines du Big Data.
Si autrefois des print ordinaires suffisait pour un « système de journalisation », la situation a maintenant considérablement changé.
Kubernetes et logs
Lorsque Kubernetes est arrivé dans l'infrastructure, le problème existant de collecte des logs ne l'a pas épargné. En un sens, il est même devenu plus aigu : la gestion de la plateforme d'infrastructure a été simplifiée, mais également compliquée. De nombreux anciens services ont commencé à migrer vers des architectures microservices. Dans le contexte des logs, cela s'est exprimé par une augmentation du nombre de sources de logs, leur cycle de vie particulier, et la nécessité de suivre à travers les logs les interrelations de tous les composants du système…
En regardant en avant, je peux constater qu'actuellement, malheureusement, il n'existe pas de variante normalisée de journalisation pour Kubernetes, qui se démarquerait favorablement de toutes les autres. Les schémas les plus populaires dans la communauté se résument aux suivants :
- quelqu'un déploie une pile EFK (Elasticsearch, Fluentd, Kibana);
- quelqu'un — essaie le tout nouveau ou utilise ;
- nous (et peut-être pas seulement nous ?..) en grande partie satisfait par son propre développement — …
En général, nous utilisons ces configurations dans les clusters K8s (pour les solutions auto-hébergées) :
- ;
- .
Cependant, je ne vais pas m'attarder sur les instructions d'installation et de configuration. Au lieu de cela, je me concentrerai sur leurs inconvénients et les conclusions plus globales sur la situation des journaux en général.
Pratique des journaux dans K8s
«Journaux quotidiens», combien êtes-vous?..
La collecte centralisée des journaux d'une infrastructure suffisamment grande nécessite des ressources significatives pour la collecte, le stockage et le traitement des journaux. Au cours de l'exploitation de divers projets, nous avons rencontré différentes exigences et les problèmes qui en découlent.
Essayons ClickHouse
Examinons un stockage centralisé sur un projet avec une application qui génère assez activement des journaux : plus de 5000 lignes par seconde. Commençons à travailler avec ses journaux, en les stockant dans ClickHouse.
Dès qu'un maximum de temps réel est requis, un serveur quadricœur avec ClickHouse sera déjà surchargé au niveau du système de stockage :
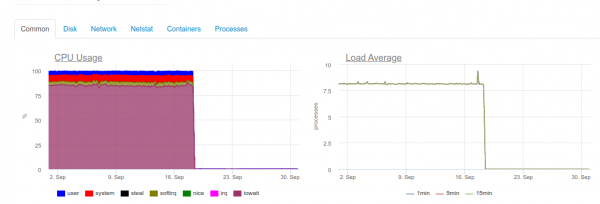
Ce type de charge est lié au fait que nous essayons d'écrire le plus rapidement possible dans ClickHouse. Et la base de données réagit par une charge accrue sur le disque, ce qui peut entraîner des erreurs telles que :
DB::Exception: Trop de parties (300). Les fusions se font beaucoup plus lentement que les insertions
Le fait est que dans ClickHouse (où résident les données des journaux) présentent des complexités lors des opérations d'écriture. Les données insérées génèrent une partition temporaire, qui est ensuite fusionnée avec la table principale. Par conséquent, l'écriture est très exigeante en termes de disque et est soumise à une limite, dont nous avons reçu l'avis précédemment : au plus 300 sous-partitions peuvent être fusionnées par seconde (en fait, cela signifie 300 insertions par seconde).
Pour éviter un tel comportement, aussi gros que possible et pas plus d'une fois toutes les 2 secondes. Cependant, écrire en gros lots suppose que nous devons écrire moins fréquemment dans ClickHouse. Cela peut, à son tour, entraîner un débordement du tampon et une perte des journaux. La solution consiste à augmenter le tampon de Fluentd, mais cela augmentera également la consommation de mémoire.
Remarque: Un autre aspect problématique de notre solution avec ClickHouse était lié au fait que le partitionnement dans notre cas (loghouse) était réalisé via des tables externes, liées . Cela entraîne une consommation excessive de mémoire vive lors de l'extraction de longues plages temporelles, car la méta-table parcourt toutes les partitions, y compris celles qui ne contiennent de toute évidence pas les données nécessaires. Cependant, on peut affirmer que cette approche est désormais obsolète pour les versions actuelles de ClickHouse (c ).
Il apparaît donc clairement que la collecte de journaux en temps réel dans ClickHouse ne dispose pas des ressources de nombreux projets (plus précisément, leur répartition ne sera pas judicieuse). De plus, il sera nécessaire d'utiliser un accumulateur, auquel nous reviendrons plus tard. Le cas décrit ci-dessus est réel. À ce moment-là, nous n'avons pas pu proposer une solution fiable et stable qui convienne au client tout en permettant de collecter les journaux avec un minimum de latence…
Et Elasticsearch ?
Il est bien connu qu'Elasticsearch gère de grandes charges. Essayons-le dans le même projet. Maintenant, la charge ressemble à ceci :
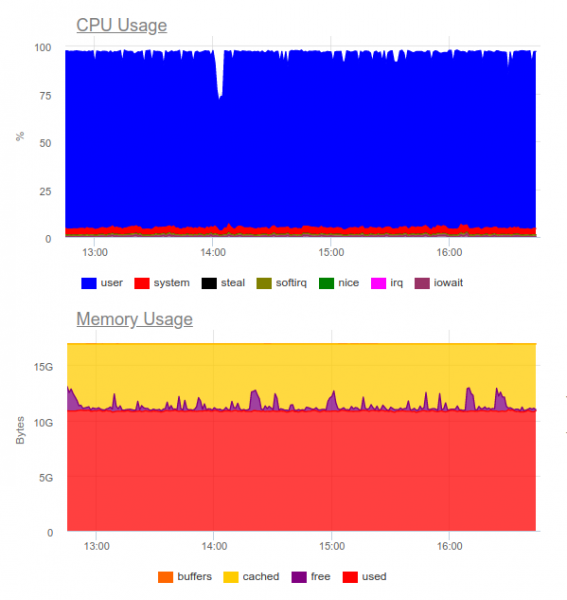
Elasticsearch a pu traiter le flux de données, mais l'écriture de tels volumes consomme beaucoup de CPU. Cela peut être résolu en organisant un cluster. Techniquement, ce n'est pas un problème, mais cela signifie que pour faire fonctionner le système de collecte de journaux, nous utilisons déjà près de 8 cœurs et avons un composant à forte charge supplémentaire dans le système…
En résumé : cette option peut être justifiée, mais uniquement si le projet est important et que sa direction est prête à investir des ressources considérables dans un système de journalisation centralisée.
Alors, la question se pose logiquement :
Quels journaux sont vraiment nécessaires ?
 Essayons de changer notre approche : les journaux doivent être à la fois informatifs et ne pas couvrir chaque événement dans le système.
Supposons que nous ayons une boutique en ligne prospère. Quels journaux sont importants ? Collecter un maximum d’informations, par exemple, depuis la passerelle de paiement, est une excellente idée. Cependant, pour le service de découpage d'images dans le catalogue de produits, tous les journaux ne sont pas critiques : seuls les erreurs et une surveillance approfondie (par exemple, le pourcentage d'erreurs 500 générées par ce composant) nous suffisent.
Nous en arrivons donc à la conclusion que la journalisation centralisée n'est pas toujours justifiée. Très souvent, le client souhaite rassembler tous les journaux au même endroit, alors qu'en réalité, seuls environ 5 % des messages dans tout le journal sont critiques pour les affaires :
- Parfois, il suffit de configurer, disons, uniquement la taille du journal du conteneur et le collecteur d'erreurs (par exemple, Sentry).
- Pour enquêter sur des incidents, une simple alerte d'erreur et un grand journal local peuvent souvent suffire.
- Nous avons eu des projets qui se passaient exclusivement de tests fonctionnels et de systèmes de collecte d'erreurs. Les développeurs n'avaient pas besoin de journaux en tant que tels — ils pouvaient tout voir grâce aux traces d'erreurs.
Illustration tirée de la vie réelle
Un bon exemple peut être une autre histoire. Nous avons reçu une demande de l'équipe de sécurité d'un de nos clients, qui utilisait déjà une solution commerciale développée bien avant l'implémentation de Kubernetes.
Il a fallu "marier" le système de collecte centralisée des journaux avec le capteur de détection de problèmes de l'entreprise — QRadar. Ce système sait recevoir des journaux via le protocole syslog et les récupérer par FTP. Cependant, l'intégrer avec le plugin remote_syslog pour fluentd ne s'est pas fait tout de suite. (comme on s'y attendait, ). Les problèmes de configuration de QRadar étaient du côté de l'équipe de sécurité du client.
En conséquence, une partie des journaux critiques pour les affaires était déposée sur FTP QRadar, tandis qu'une autre était redirigée via remote syslog directement depuis les nœuds. Pour cela, nous avons même écrit — cela pourrait aider quelqu'un à résoudre une tâche similaire… Grâce à ce schéma, le client obtenait et analysait les journaux critiques (avec ses outils préférés), et nous avons pu réduire les coûts du système de journalisation, ne conservant que le dernier mois.
Un autre exemple est assez révélateur de ce qu'il ne faut pas faire. Un de nos clients, pour le traitement chaque d'événements provenant des utilisateurs, produisait une sortie multiligne non structurée d'informations dans le journal. Comme on peut facilement l'imaginer, ces journaux étaient extrêmement difficile à lire et à stocker.
Critères pour les journaux
De tels exemples soulèvent la conclusion qu'en plus de choisir un système de collecte des journaux, il faut également concevoir les journaux eux-mêmes! Quelles sont les exigences ici ?
- Les journaux doivent être au format lisible par machine (par exemple, JSON).
- Les journaux doivent être compacts et permettre une modification du niveau de journalisation pour déboguer d'éventuels problèmes. Dans les environnements de production, il faut exécuter des systèmes avec un niveau de journalisation tel que Avertissement ou Error.
- Les logs doivent être normalisés, c'est-à-dire que dans l'objet log, toutes les chaînes doivent avoir le même type de champ.
Les logs non structurés peuvent entraîner des problèmes lors du chargement des logs dans le stockage et l'arrêt complet de leur traitement. À titre d'illustration, un exemple avec une erreur 400 que beaucoup ont probablement rencontrée dans les logs fluentd :
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejeté par Elasticsearch"
Cette erreur signifie que vous envoyez dans un index avec un mapping prêt un champ dont le type est instable. Le meilleur exemple est un champ dans le log nginx avec la variable $upstream_status. Il peut contenir à la fois un nombre et une chaîne. Par exemple :
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staffs/265.png", "protocol": "HTTP/1.1", "status": "200", "body_size": "906", "referrer": "https://example.com/staff", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staff", "protocol": "HTTP/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
Dans les logs, on peut voir que le serveur 10.100.0.10 a répondu avec une erreur 404 et que la requête a été redirigée vers un autre stockage de contenu. En conséquence, dans les logs, la valeur est devenue comme suit :
"upstream_response_time": "0.001, 0.007"
Cette situation est tellement répandue qu'elle mérite même une mention séparée dans la documentation. .
Il arrive que tous les logs soient nécessaires sans exception. Et cela pose des problèmes aux schémas typiques de collecte de logs pour K8s, suggérés / envisagés ci-dessus.
Par exemple, fluentd ne peut pas collecter les logs des conteneurs à courte durée de vie. Dans l'un de nos projets, le conteneur de migration de bases de données a vécu moins de 4 secondes avant d'être supprimé, conformément à l'annotation correspondante :
"helm.sh/hook-delete-policy": hook-succeeded
À cause de cela, le log d'exécution de la migration n'atteignait pas le stockage. Une politique liée peut aider dans ce cas.
before-hook-creation Un autre exemple est la rotation des logs Docker. Supposons qu'il existe une application qui écrit activement dans les logs. En conditions normales, nous parvenons à traiter tous les logs, mais dès qu'un problème survient — par exemple, comme décrit ci-dessus avec un format incorrect — le traitement s'arrête, et Docker effectue la rotation du fichier. En conséquence, des logs critiques pour l'entreprise peuvent être perdus..
Il est important de séparer les flux de logs
C'est pourquoi , en intégrant l'envoi des messages les plus précieux directement dans l'application pour garantir leur sauvegarde. De plus, il serait utile de créer une sorte de« accumulateur » de logs , qui pourra survivre à une brève indisponibilité du stockage tout en conservant les messages critiques.Enfin, n'oubliez pas que
il est important de surveiller soigneusement tout sous-système . Sinon, il est facile de se retrouver dans une situation où fluentd est en état. CrashLoopBackOff et rien n'est envoyé, ce qui peut entraîner la perte d'informations importantes.
Conclusions
Cet article ne traite pas des solutions SaaS comme Datadog. De nombreux problèmes décrits ici ont déjà été résolus par des entreprises commerciales spécialisées dans la collecte de journaux, mais tout le monde ne peut pas utiliser le SaaS pour diverses raisons. (les principales étant le coût et le respect de la loi 152-FZ).
La collecte centralisée de journaux semble d'abord être une tâche simple, mais ce n'est pas le cas. Il est important de se rappeler que :
- Il est judicieux de consigner en détail uniquement les composants critiques, alors que pour les autres systèmes, vous pouvez configurer la surveillance et la collecte des erreurs.
- Les journaux en production doivent être minimaux afin de ne pas créer une charge supplémentaire.
- Les journaux doivent être lisibles par machine, normalisés et avoir un format strict.
- Les journaux réellement critiques doivent être envoyés par un flux séparé, qui doit être dissocié des journaux principaux.
- Il convient d'envisager un accumulateur de journaux qui peut protéger contre les pics de charge et rendre la charge sur le stockage plus uniforme.
Ces règles simples, si elles sont appliquées partout, permettraient aux systèmes décrits ci-dessus de fonctionner — même si des composants importants (accumulateur) manquent. Ignorer de tels principes peut rapidement mener vous et votre infrastructure à un autre composant système très chargé (et pourtant peu efficace).
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «».
Source : habr.com
