

Il existe de nombreuses ressources d'information sur Internet, mais parfois, les conseils les plus simples s'avèrent être les plus précieux. L'équipe a traduit , que l'auteur de l'article a rassemblés après une année de travail avec Kubernetes. Les conseils ne sont pas classés par ordre d'importance, mais nous pensons que chacun trouvera quelque chose d'utile.
La commande la plus simple pour travailler avec Kubernetes
Pour commencer, probablement l'action la plus simple et utile dans le travail avec Kubernetes. La commande suivante active l'autocomplétion des commandes kubectl dans le shell bash :
echo "source > ~/ .bashrc
L'autocomplétion kubectl sera enregistrée dans le fichier .bashrc et sera automatiquement activée à chaque démarrage du shell. Cela facilite la saisie de longues commandes et paramètres, tels que all-namespaces. En savoir plus dans .
Les limites par défaut sur la mémoire et le CPU dans l'espace de noms
Si une application est mal écrite, par exemple, si elle ouvre une nouvelle connexion à la base de données chaque seconde sans jamais la fermer, cela entraîne une fuite de mémoire dans le cluster. Et si aucune limite de mémoire n'est définie lors du déploiement de l'application, cela peut entraîner un échec du nœud.
Pour éviter cela, Kubernetes permet de définir des limites par défaut pour chaque espace de noms. Elles sont définies dans le fichier yaml pour un espace de noms spécifique. Voici un exemple de fichier :
apiVersion: v1
kind: LimitRange
metadata:
  name: mem-limit-range
spec:
  limits:
  - default:
      memory: 512Mi
    defaultRequest:
      memory: 256Mi
    type: Container
Créez ce yaml et appliquez-le à n'importe quel espace de noms. Par exemple, à l'espace de noms limit-example. Maintenant, pour tout conteneur déployé dans cet espace de noms, une limite de 512Mi sera appliquée, sauf si une autre limite individuelle est spécifiquement définie pour ce conteneur.
Nettoyage des ordures dans les anciennes versions de Kubernetes
Kubelet commence par défaut à nettoyer les ordures lorsque /var/lib/docker occupe 90 % de l'espace disque disponible. C'est très bien, cependant, jusqu'à la version 1.7 de Kubernetes, il n'y avait pas de limite par défaut sur le nombre de descripteurs d'index inode utilisés (inodes), qui correspondent au nombre de fichiers dans le système de fichiers.
Potentiellement, votre conteneur /var/lib/docker ne peut utiliser que 50 % de l'espace disque, mais les inodes peuvent être épuisés, ce qui causera des problèmes de fonctionnement des travailleurs.
Dans les anciennes versions de kubelet de 1.4 à 1.6, il faudra ajouter ce drapeau :
--eviction-hard
=memory.available<100Mi,nodefs.available<10%,nodefs.inodesFree<5%
Dans les versions 1.7 et ultérieures, ce drapeau est activé par défaut. Toutefois, les versions précédentes ne surveillent pas la limite des inodes.
Minikube… un petit mais puissant Kubernetes local
Minikube est le moyen le plus simple de lancer un cluster Kubernetes local. Il se lance avec une simple commande :
minikube start
Suite à l'exécution de cette commande, vous aurez un véritable cluster Kubernetes en cours d'exécution sur votre ordinateur.
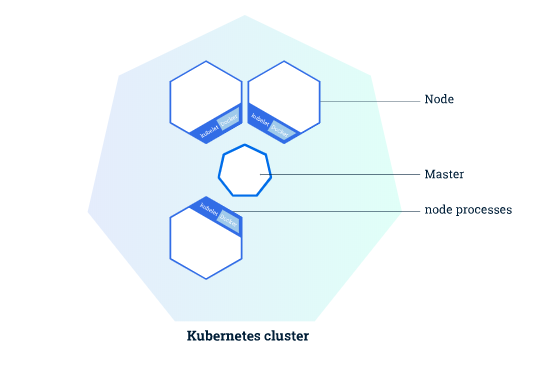
Le défi réside dans la manière de créer une application et de la lancer localement dans ce cluster. À moins de donner des instructions spécifiques, l'image Docker sera créée sur votre ordinateur, et non dans le cluster.
Pour faire en sorte que Docker envoie l'image au cluster Kubernetes local, la machine Docker reçoit la commande suivante :
eval $(minikube docker-env)
Nous pouvons maintenant créer des applications sur le cluster Kubernetes local.
Ne donnez pas d'accès kubectl à tout le monde
Cela peut sembler évident, mais si plusieurs équipes utilisent un même cluster pour leurs applications (c'est en fait l'objectif de Kubernetes), il ne faut pas simplement donner accès à tout le monde. kubectlIl vaut mieux séparer les équipes, en leur attribuant à chacune son propre espace de noms et en limitant les accès par des politiques RBAC.
Il est possible de se compliquer la vie en spécifiant pour chaque pod les droits d'accès, de lecture, de création, de suppression et autres opérations. Mais l'essentiel est de restreindre l'accès aux secrets, en le permettant uniquement aux administrateurs. Ainsi, nous séparerons ceux qui peuvent administrer le cluster et ceux qui peuvent simplement y déployer.
Gérez les budgets des pods
Comment garantir l'absence de temps d'arrêt pour une application dans un cluster Kubernetes ? PodDisruptionBudget et encore une fois PodDisruptionBudget.
Les clusters sont mis à jour périodiquement, et les nœuds sont vidés. Rien ne reste immobile, telle est la réalité. Dans chaque déploiement avec plus d'une instance, il est essentiel d'inclure le PDB (PodDisruptionBudget). Celui-ci est créé dans un simple fichier yaml qui est appliqué au cluster. La portée d'un PDB spécifique est définie par des sélecteurs d'étiquettes.
Remarque : Le budget PDB est pris en compte uniquement lors d'une perturbation budgétaire réversible (). Dans des situations telles que les pannes matérielles, le PDB ne fonctionnera pas.
Exemple de PDB :
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: app-a-pdb
spec:
  minAvailable: 2
  selector:
      matchLabels:
        app: app-a
Les deux paramètres principaux sont matchLabels et minAvailable. Dans le premier paramètre, on indique pour quelles applications le budget s'applique. Par exemple, si j'ai des déploiements avec des balises app: app-a et app: app-b, alors ce PDB ne sera appliqué qu'au premier.
Paramètre minAvailable est pris en compte lors du vidage (nettoyage) du nœud. Par exemple, dans notre exemple, pendant le vidage, toutes les instances app: app-a, sauf deux, sont évincées.
Cela permet de contrôler combien d'exemplaires de l'application doivent être en cours d'exécution à tout moment.
Surveillance de la santé de l'application
Cette surveillance est possible de deux manières : à l'aide de probes Readiness ou Liveness.
La première sonde (readiness) détermine si le conteneur est prêt à recevoir du trafic.
La seconde (liveness) indique si le conteneur fonctionne correctement ou s'il doit être redémarré.
Les configurations correspondantes sont simplement ajoutées au yaml pour le déploiement. On peut y indiquer des délais d'attente, des temps de retard et le nombre de réessais. Pour plus de détails à leur sujet, consultez .
Balises partout
Les balises sont l'un des concepts fondamentaux dans Kubernetes. Elles permettent aux objets de se lier librement les uns aux autres et de créer des requêtes basées sur des balises. Dans Kubernetes, on peut même accéder au client et observer les événements pour des balises spécifiques.
Avec les balises, on peut pratiquement tout faire, mais un bon exemple serait de créer plusieurs environnements pour exécuter des programmes dans un même cluster.
Supposons que vous utilisez le même cluster pour dev et qa. Cela signifie que vous pourriez avoir une application app-a, fonctionnant simultanément dans les deux environnements qa et dev. Dans ce cas, nous pouvons accéder séparément à l'exemplaire de l'application dans un environnement spécifique en indiquant le paramètre approprié environment. Par exemple, app: app-a et environment: dev pour un environnement, et app: app-a et environment: qa pour le second.
Cela permet d'accéder aux deux exemplaires de l'application, par exemple, pour effectuer des tests simultanés.
Organiser
Kubernetes est un système très puissant, mais tout système peut finir par se noyer dans un grand nombre de processus. Kubelet exécute tous les processus et vérifications que vous avez spécifiés, ainsi que ses propres.
Bien sûr, un service orphelin ne ralentira pas le système, et Kubernetes est initialement conçu pour l'évolutivité. Mais si au lieu d'un service il y en a un million, kubelet commence à être submergé.
Si pour une raison quelconque vous supprimez un déploiement (conteneur, image, ou autre), assurez-vous de faire un nettoyage complet.
Faites connaissance avec Go
Nous avons gardé le meilleur conseil pour la fin. Apprenez le langage de programmation Go.
Kubernetes est développé en Go, toutes les extensions sont écrites en Go, et la bibliothèque client officielle client-go est également prise en charge.
Il peut être utilisé pour de nombreuses choses intéressantes. Par exemple, pour personnaliser le système Kubernetes selon vos besoins. Vous pouvez utiliser vos propres programmes pour collecter des données, déployer des applications ou simplement nettoyer des conteneurs.
Apprendre le langage de programmation Go et maîtriser client-go est sans aucun doute le conseil le plus important à donner aux nouveaux utilisateurs de Kubernetes.
Que lire encore:
- .
- ?
- .
Source : habr.com
